Après avoir découpé un document en fragments, l'étape suivante dans un pipeline RAG consiste à trouver quels fragments sont les plus pertinents par rapport à la question d'un utilisateur. Il s'agit fondamentalement d'un problème de recherche - vous devez parcourir tous vos fragments de texte et identifier ceux qui se rapportent à ce que l'utilisateur demande.
Trouver les fragments pertinents
Le défi consiste à déterminer quels fragments sont « liés » à la question d'un utilisateur. Ce n'est pas aussi simple que la correspondance de mots-clés - vous devez comprendre le sens et le contexte à la fois de la question et des fragments.
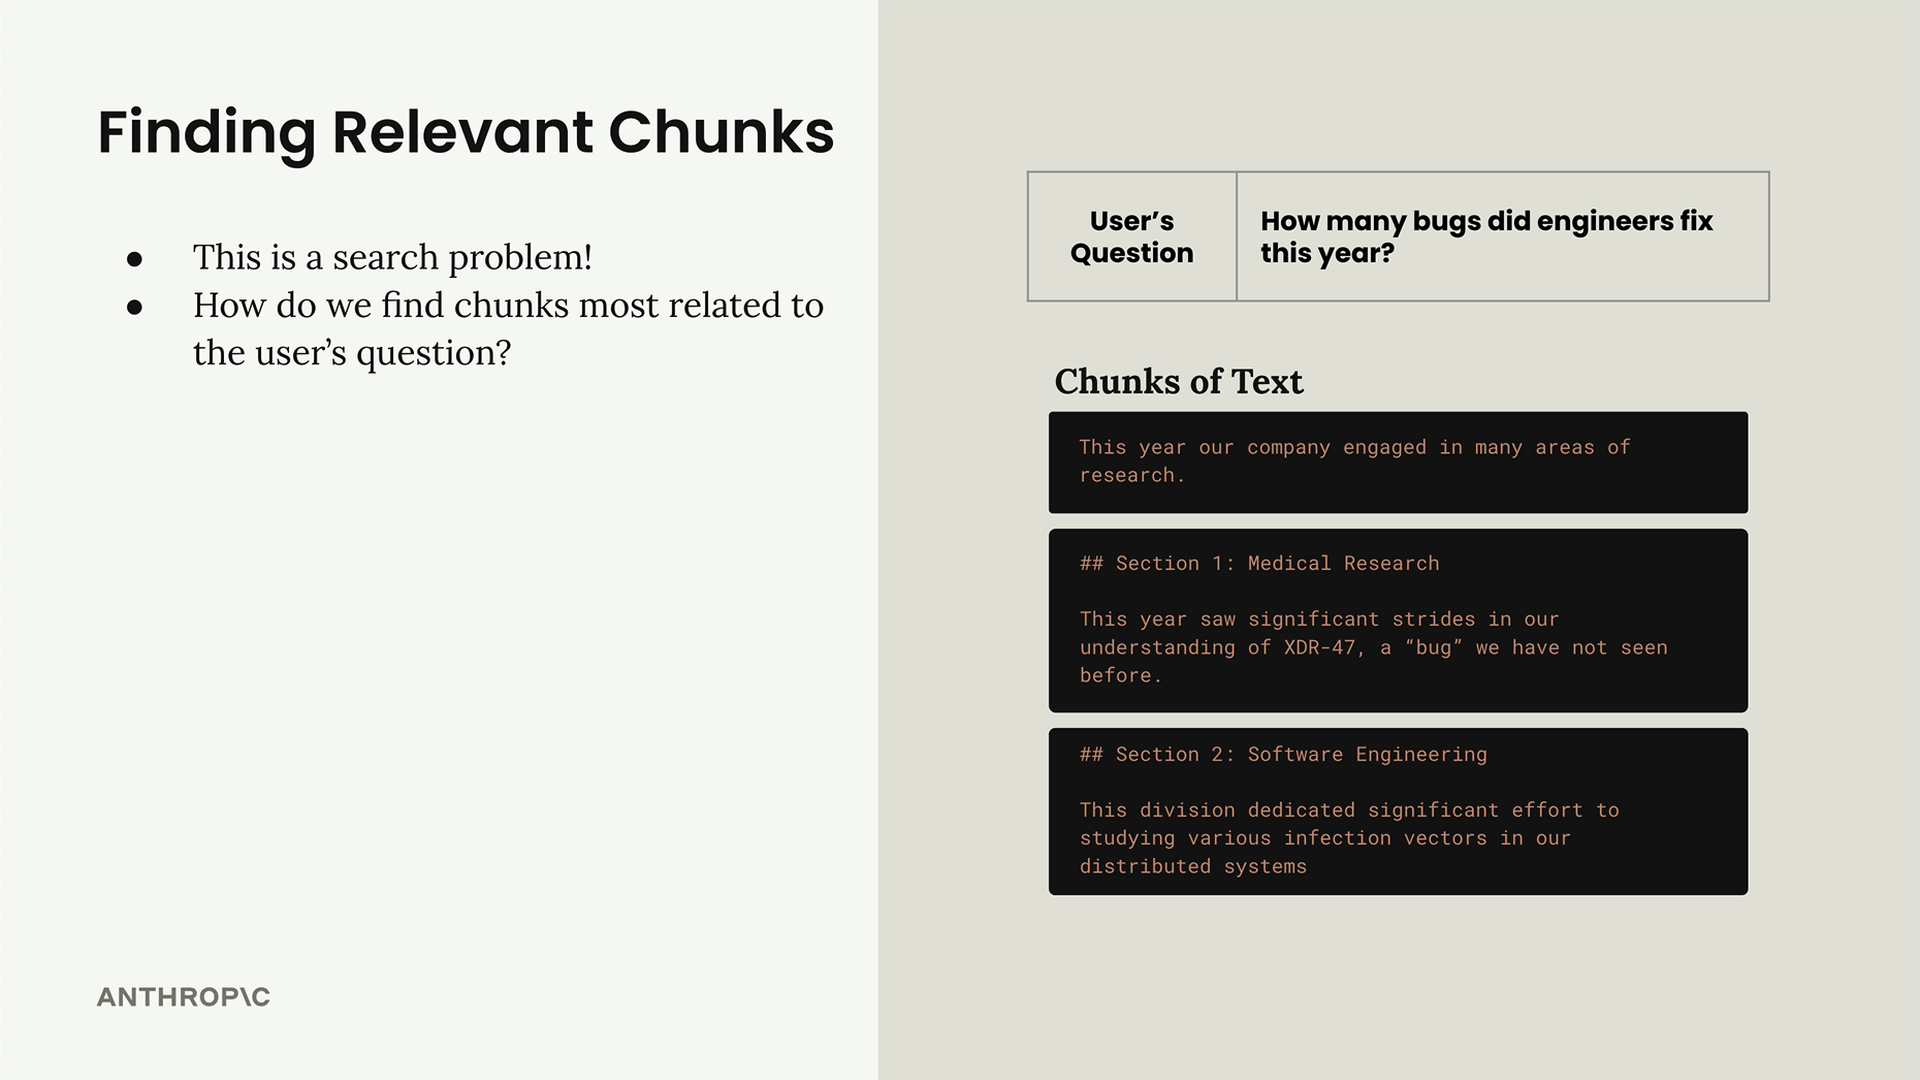
La solution la plus courante est la recherche sémantique, qui utilise des embeddings de texte pour comprendre de quoi parle réellement chaque morceau de texte, plutôt que de simplement rechercher des correspondances exactes de mots.
Que sont les embeddings de texte ?
Un embedding de texte est une représentation numérique du sens contenu dans un texte. Pensez-y comme la conversion de mots et de phrases dans un format avec lequel les ordinateurs peuvent travailler mathématiquement.
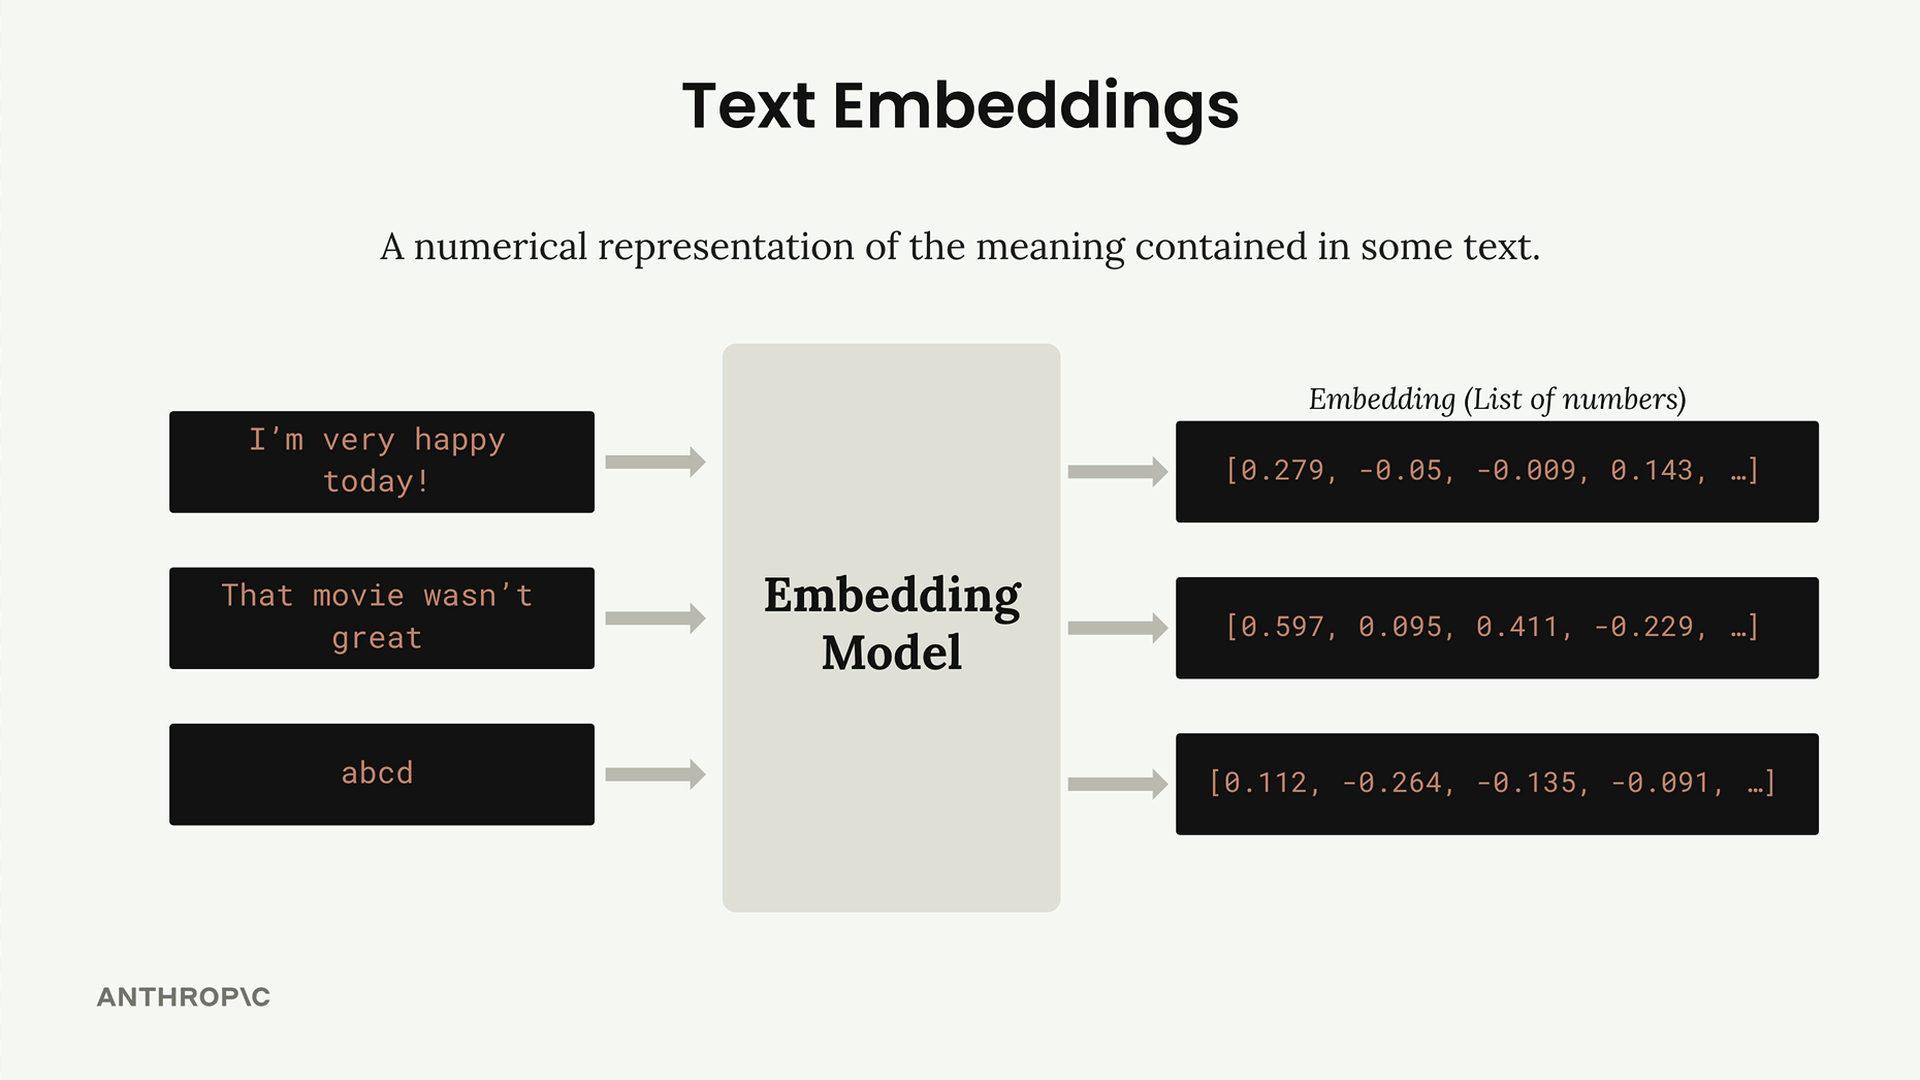
Voici comment cela fonctionne :
- Vous fournissez du texte à un modèle d'embedding
- Le modèle produit une longue liste de nombres (généralement 1024 nombres)
- Chaque nombre représente un « score » pour une certaine qualité du texte d'entrée
- Les nombres vont de -1 à +1
Comprendre les nombres
Chaque nombre dans un embedding est comme un score pour un certain aspect du texte. Bien que nous ne sachions pas exactement ce que chaque position représente, il est utile de les considérer comme mesurant différentes qualités.
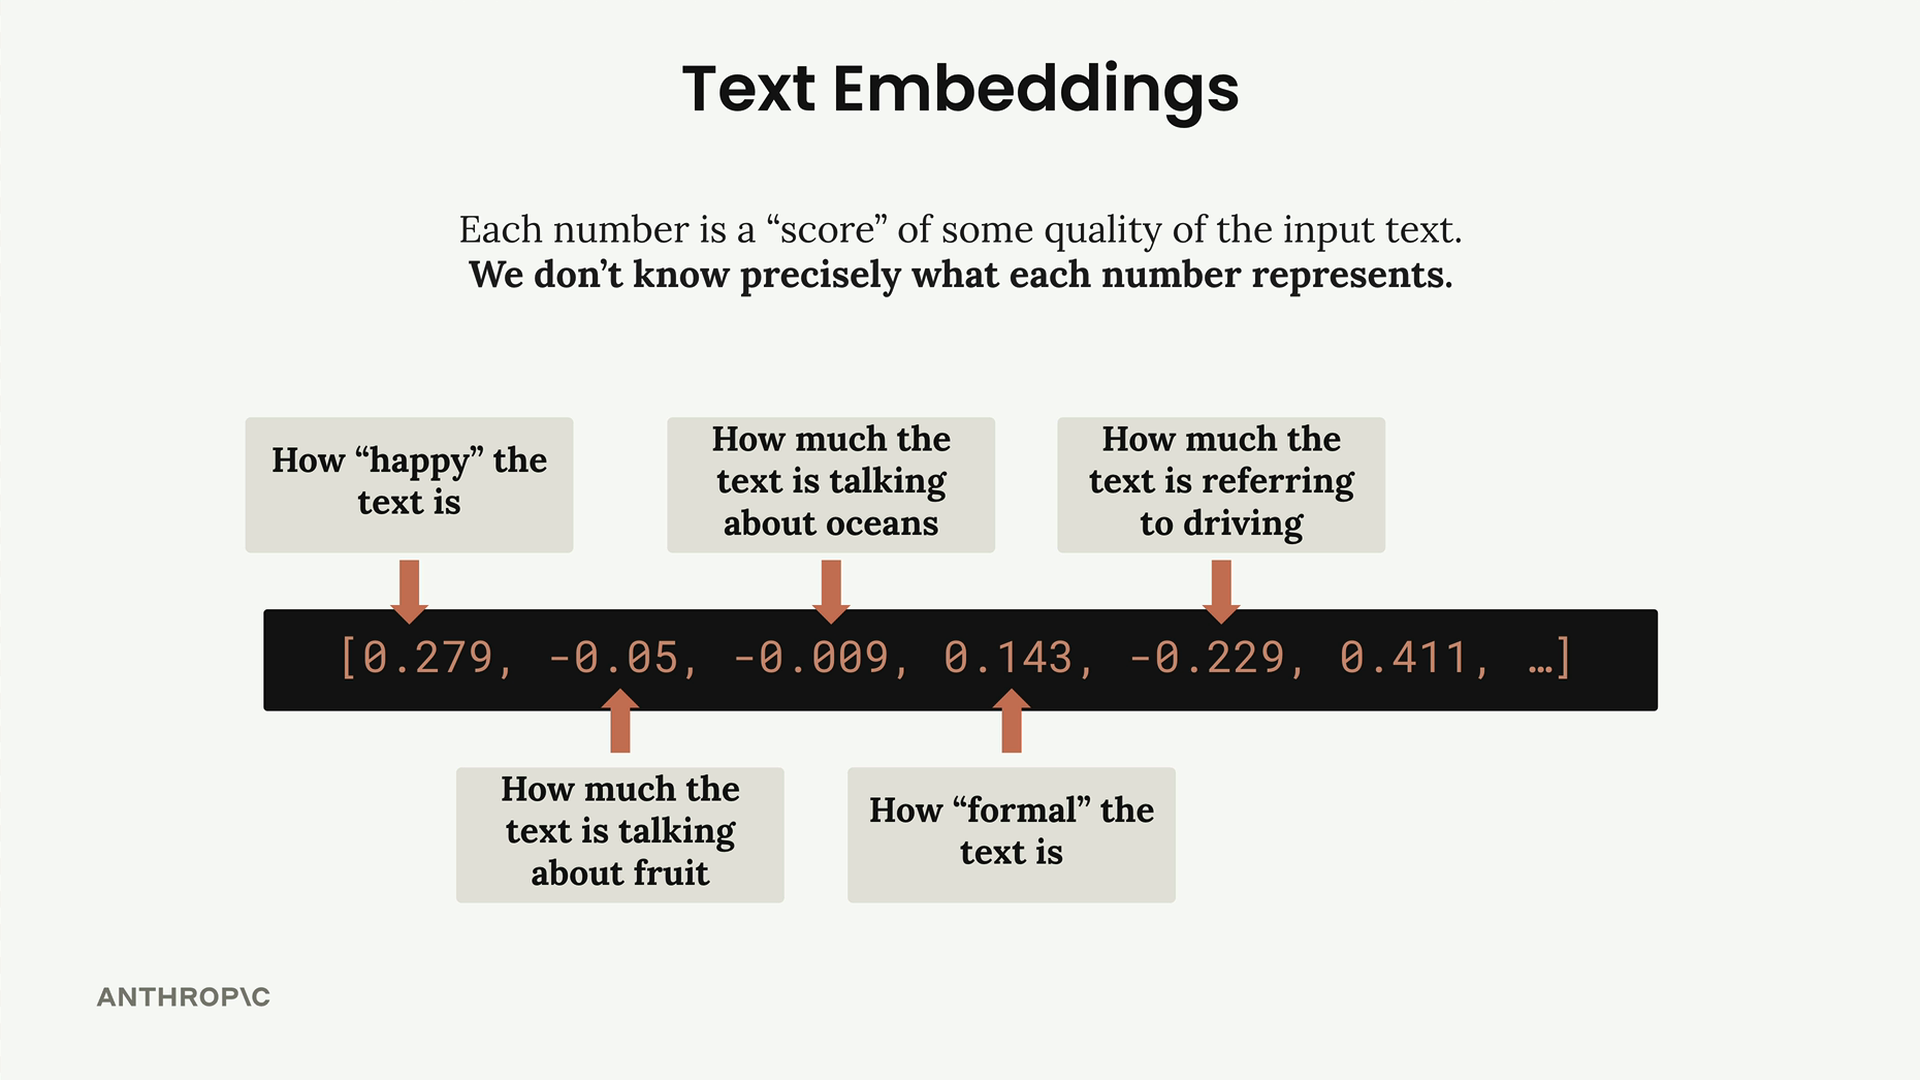
Par exemple, un nombre pourrait évaluer « à quel point le texte est joyeux » tandis qu'un autre pourrait mesurer « à quel point le texte parle des océans ». Le point clé est que nous ne savons pas réellement ce que chaque nombre représente - le modèle d'embedding apprend ces schémas pendant l'entraînement, et ils ne sont pas interprétables par un humain.
Générer des embeddings avec du code
Créer des embeddings est simple. Voici le processus de base :
def generate_embedding(
    text,
    embedding_model_id="amazon.titan-embed-text-v2:0",
    dimensions=1024,
    normalize=True,
):
    request_body = {
        "inputText": text,
        "dimensions": dimensions,
        "normalize": normalize,
    }

    request_json = json.dumps(request_body)
    response = client.invoke_model(
        modelId=embedding_model_id,
        body=request_json,
        accept="application/json",
        contentType="application/json",
    )

    response_body = json.loads(response.get("body").read())
    return response_body["embedding"]
Lorsque vous exécutez cette fonction sur un fragment de texte, vous obtenez en retour une liste de 1024 nombres qui représentent le sens sémantique de ce texte.
Notez que vous devrez peut-être demander l'accès au modèle d'embedding Titan dans la console AWS Bedrock. Si la version 2 n'est pas disponible, la version 1 fonctionne tout aussi bien à des fins d'apprentissage.
Pourquoi les embeddings sont importants pour le RAG
La puissance des embeddings devient évidente lorsque vous réalisez que des textes similaires auront des valeurs d'embedding similaires. Cela signifie que vous pouvez comparer mathématiquement la question d'un utilisateur à vos fragments de document et trouver les plus sémantiquement similaires - même s'ils ne partagent pas exactement les mêmes mots.
Cette représentation numérique est ce qui rend possible la recherche sémantique et la rend beaucoup plus efficace que la simple correspondance de mots-clés pour trouver un contexte pertinent dans les systèmes RAG.