Lorsque vous disposez à la fois d'une recherche sémantique (embeddings vectoriels) et d'une recherche lexicale (BM25) fonctionnant indépendamment, l'étape suivante consiste à les combiner en un pipeline de recherche unifié. Cette approche hybride exploite les forces des deux méthodes pour fournir des résultats plus précis.
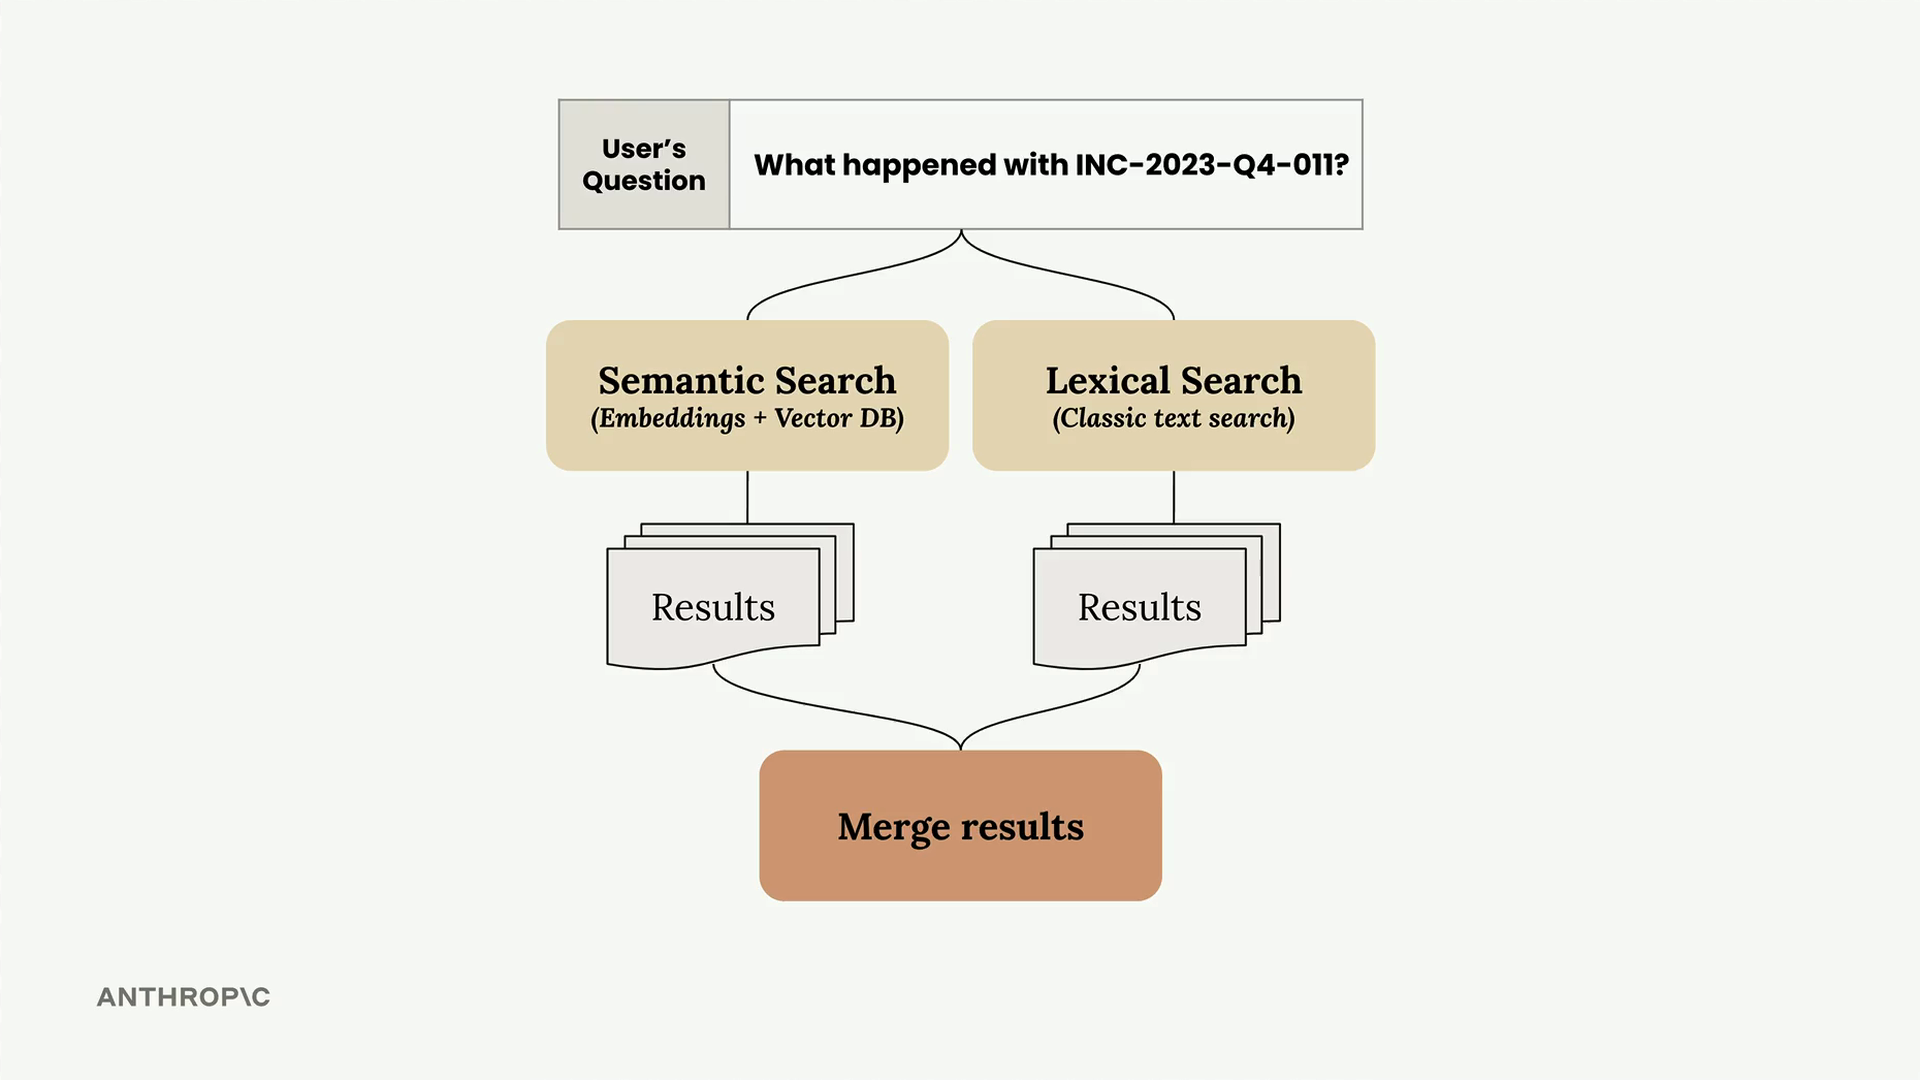
Construire une interface unifiée
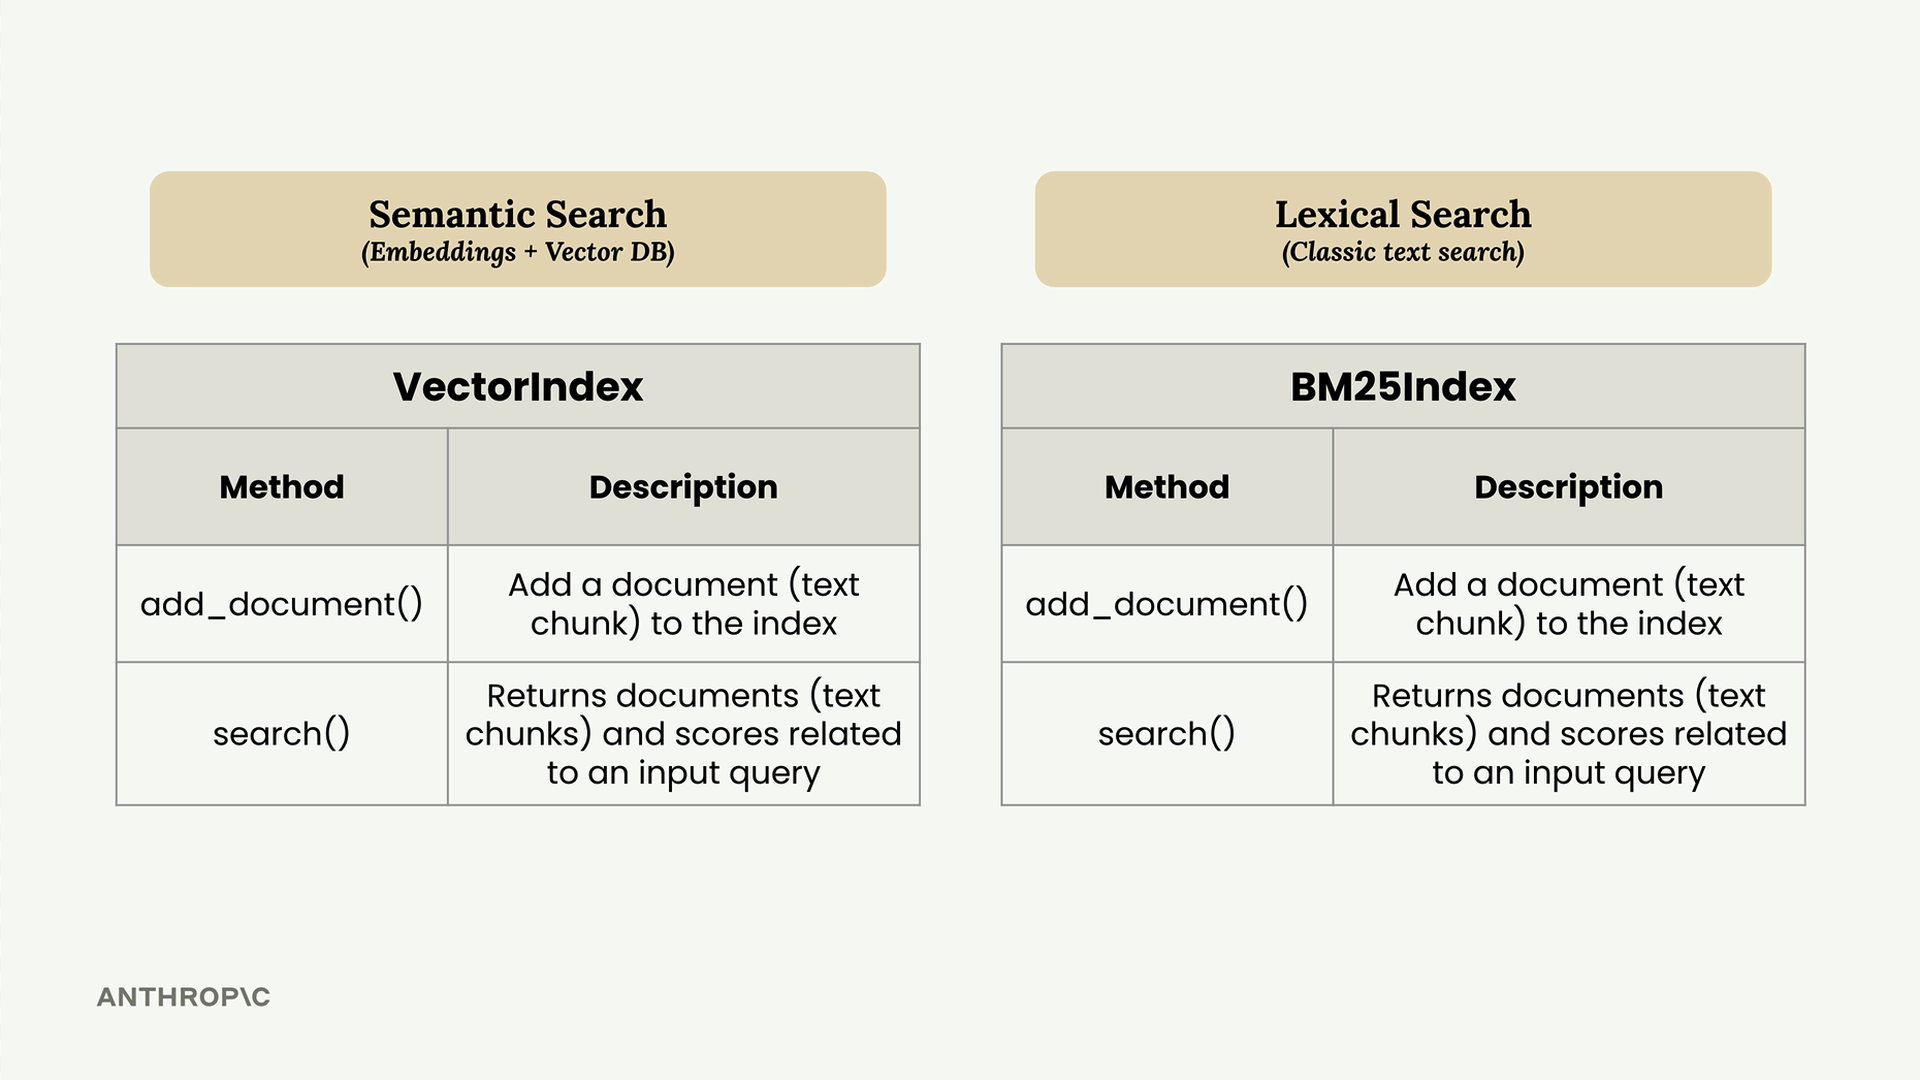
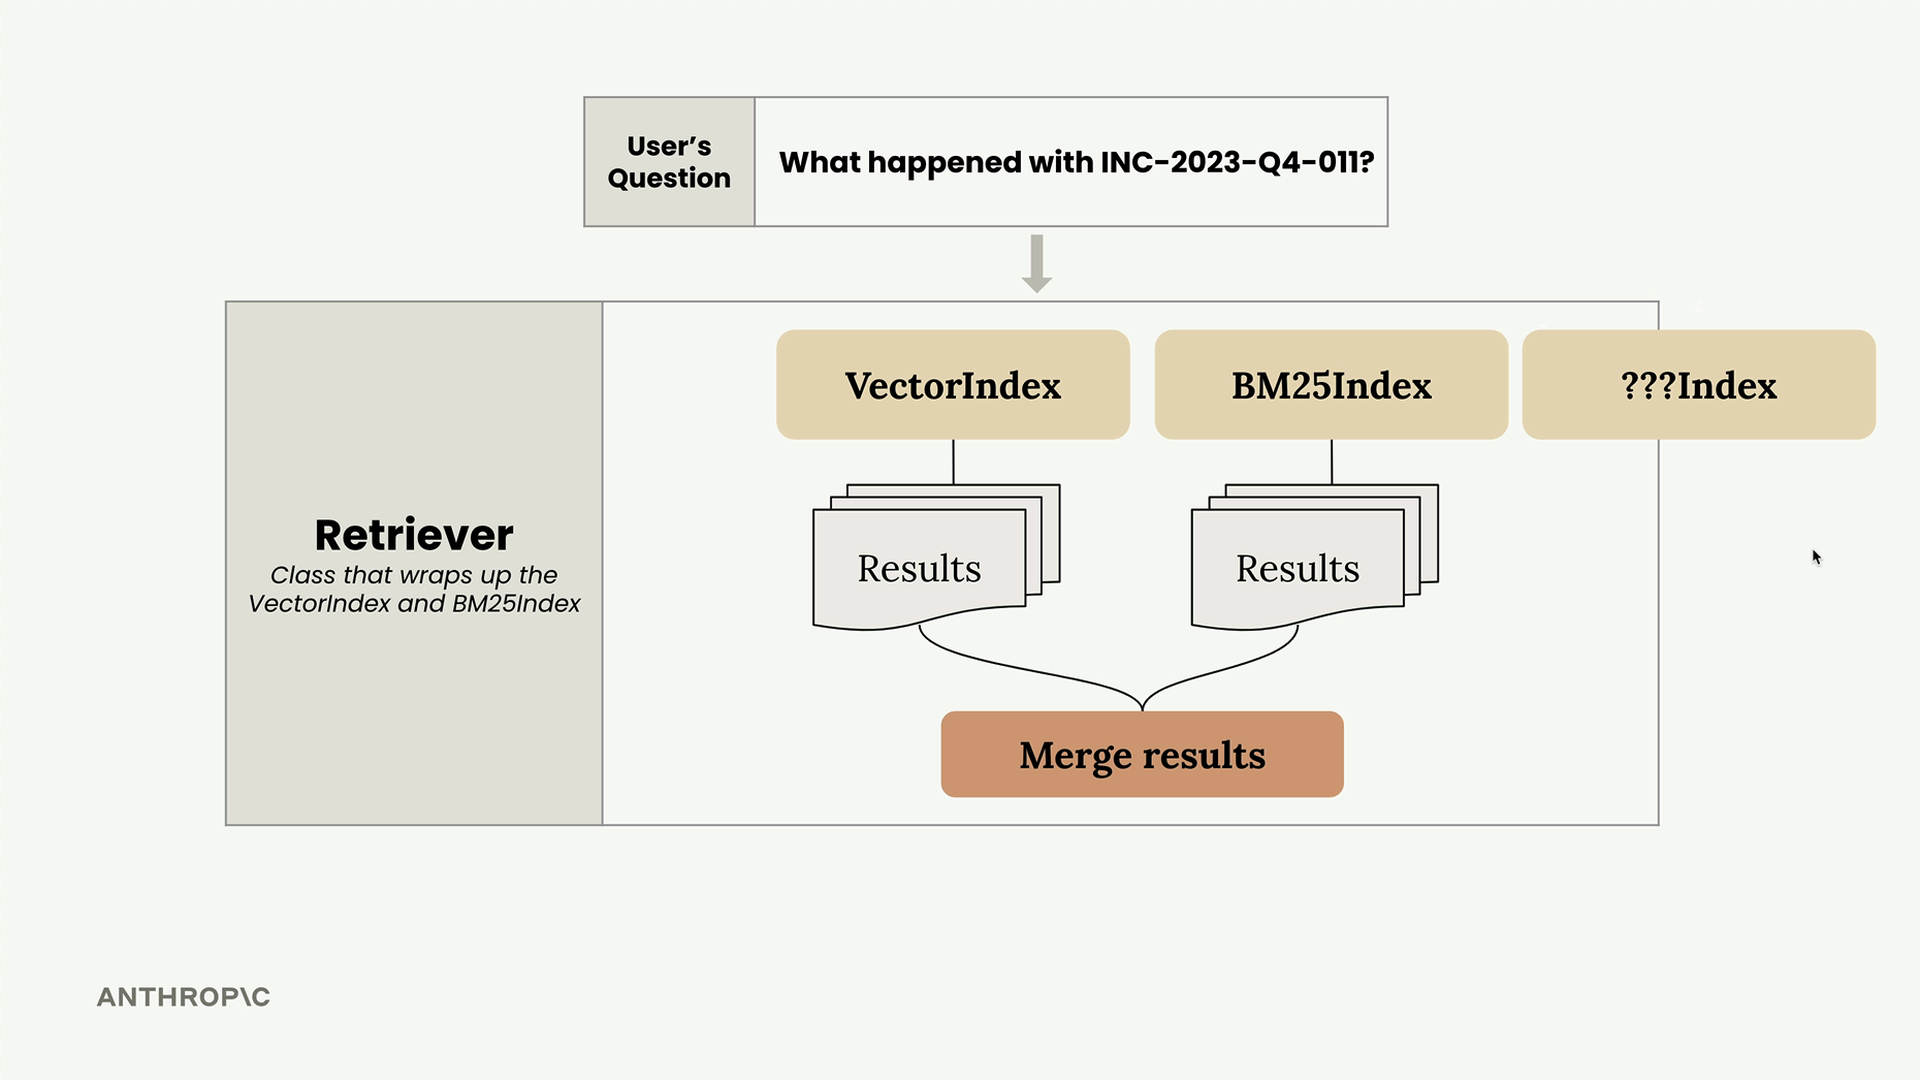
Les deux implémentations de recherche partagent des API presque identiques - elles disposent toutes deux de méthodes add_document() et search(). Cette cohérence permet de les envelopper facilement dans une seule classe Retriever qui coordonne les deux approches.
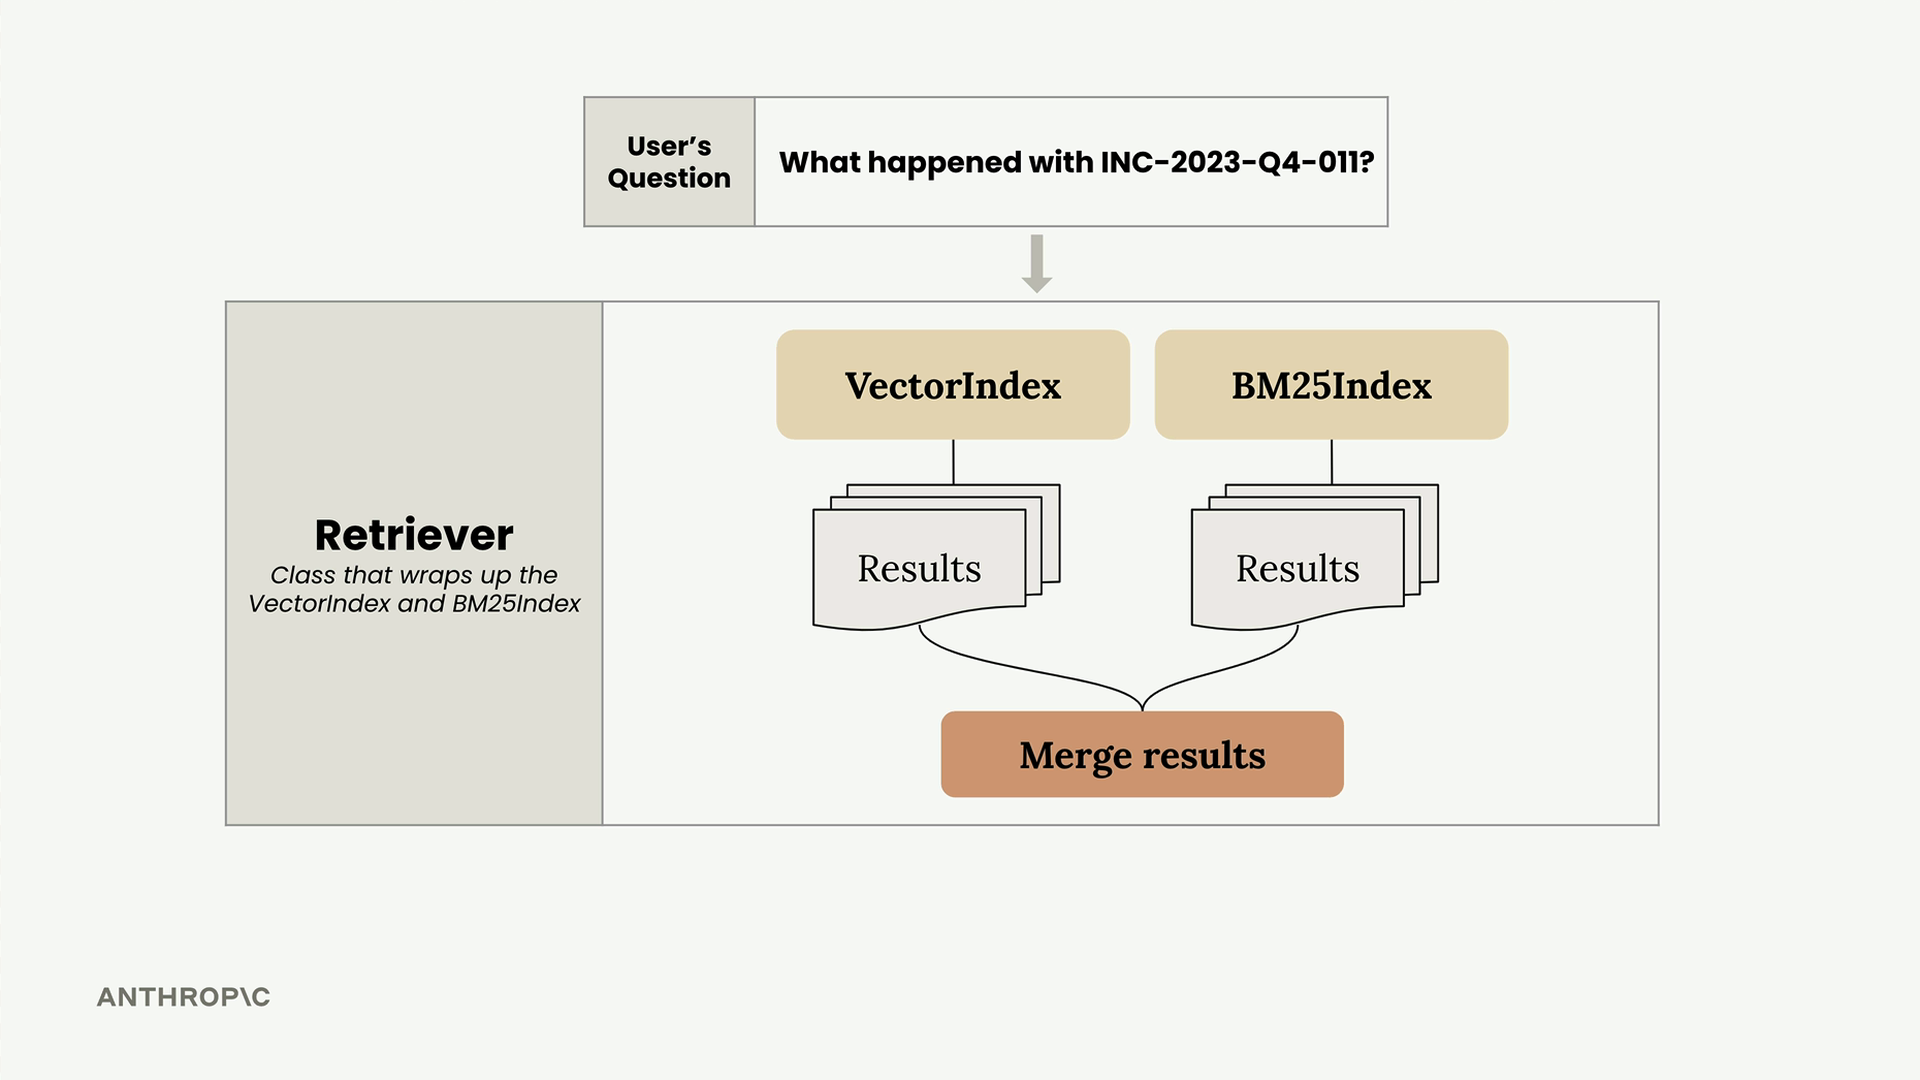
Le Retriever agit comme un coordinateur qui :
- Reçoit la question d'un utilisateur
- La transmet à la fois au VectorIndex et au BM25Index
- Collecte les résultats des deux systèmes
- Fusionne les résultats à l'aide d'un algorithme de classement
Reciprocal Rank Fusion
Le défi réside dans la fusion des résultats provenant de différentes méthodes de recherche. Chaque système renvoie des résultats avec des mécanismes de notation différents, vous ne pouvez donc pas simplement combiner les scores directement. Nous utilisons plutôt une technique appelée Reciprocal Rank Fusion (RRF).
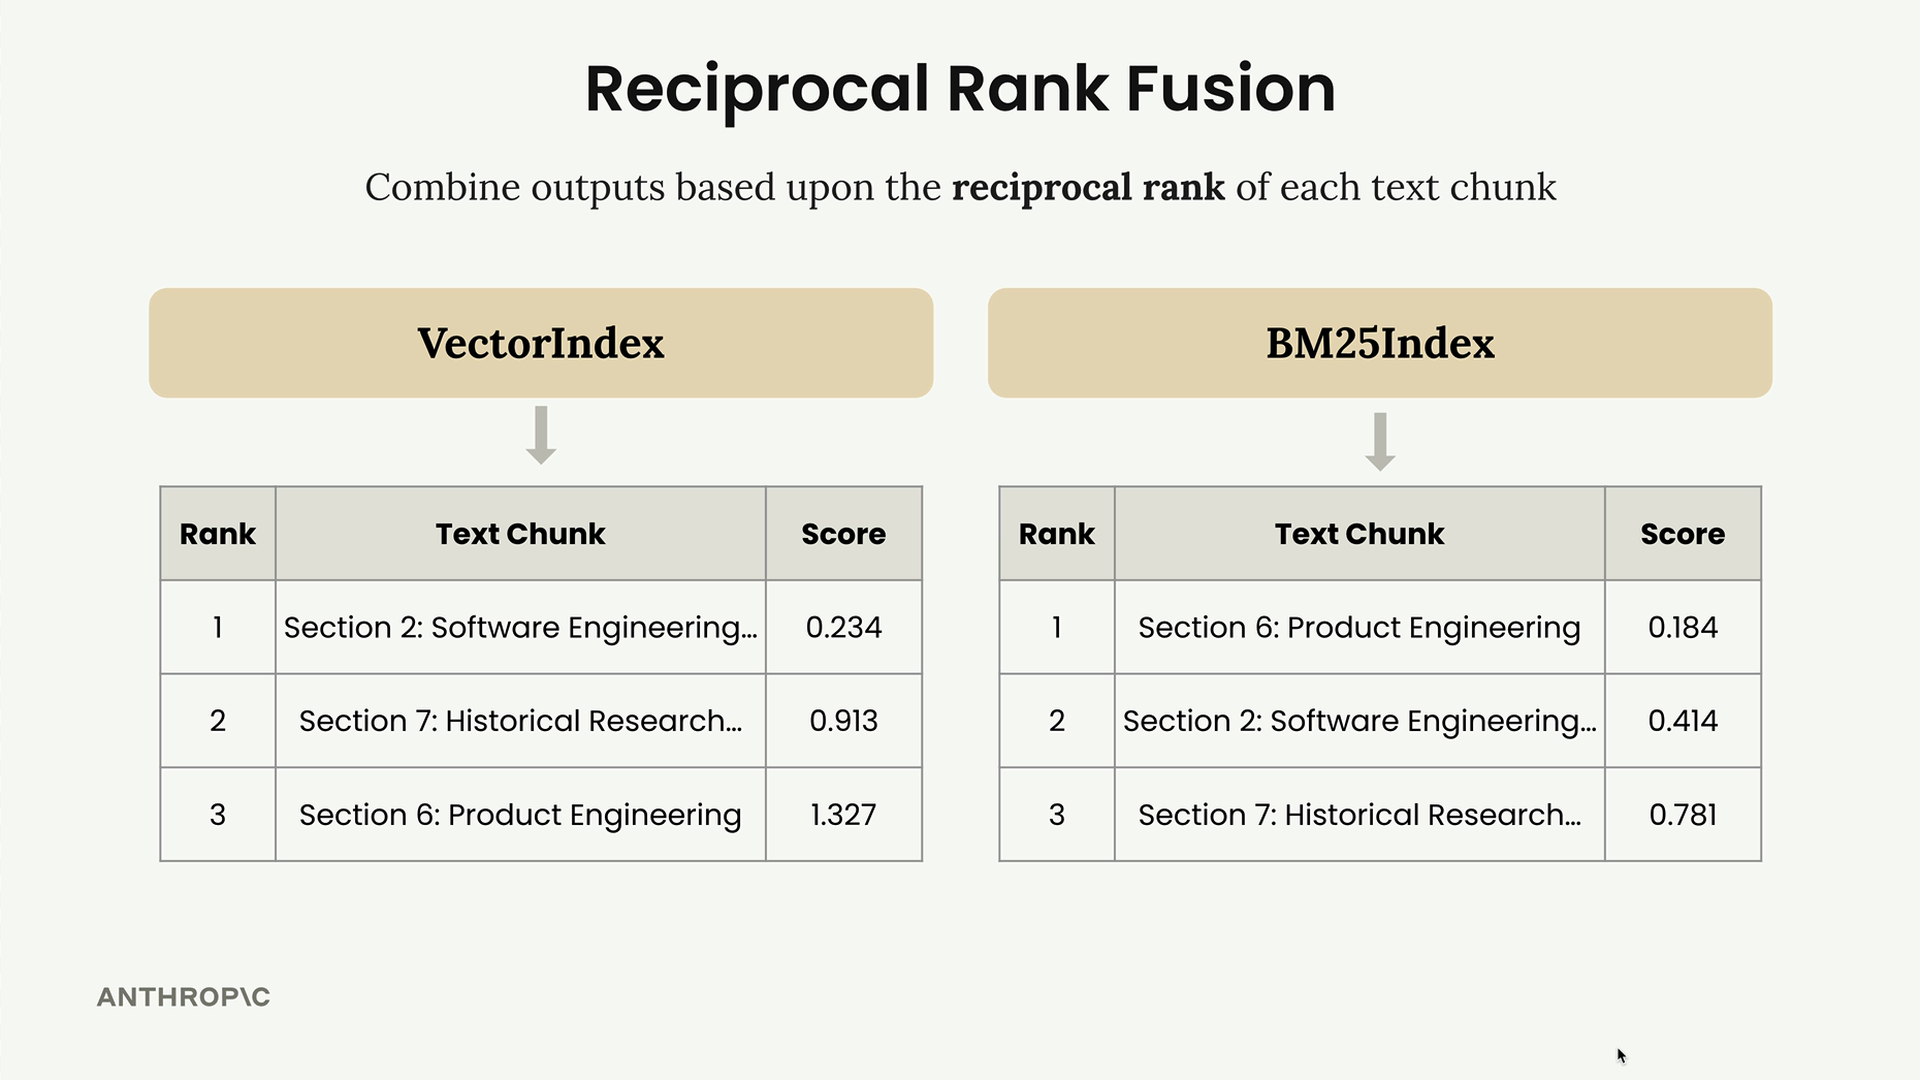
Voici comment fonctionne le RRF avec un exemple pratique. Supposons que votre VectorIndex renvoie des résultats classés ainsi : Section 2, Section 7, Section 6. Pendant ce temps, votre BM25Index renvoie : Section 6, Section 2, Section 7.
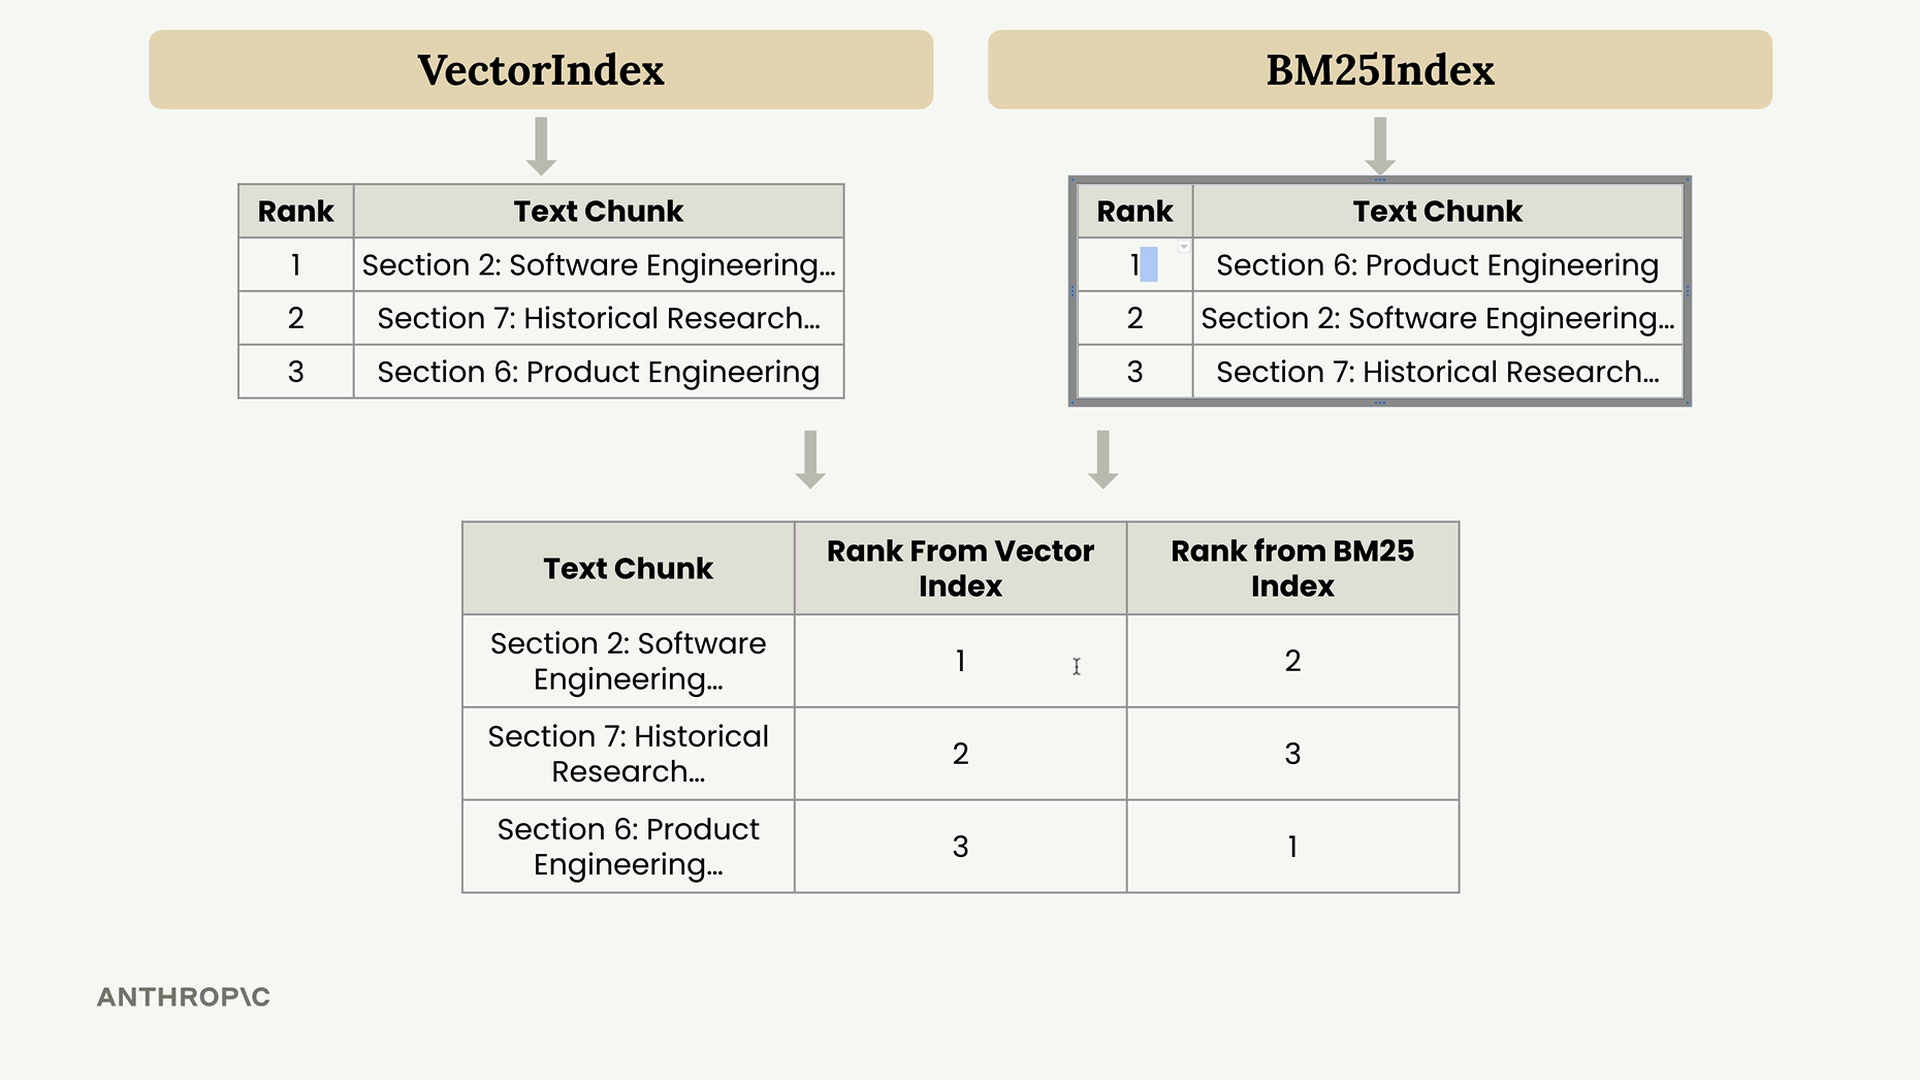
Pour fusionner ces résultats, vous créez un tableau combiné montrant le rang de chaque extrait de texte dans les deux systèmes :
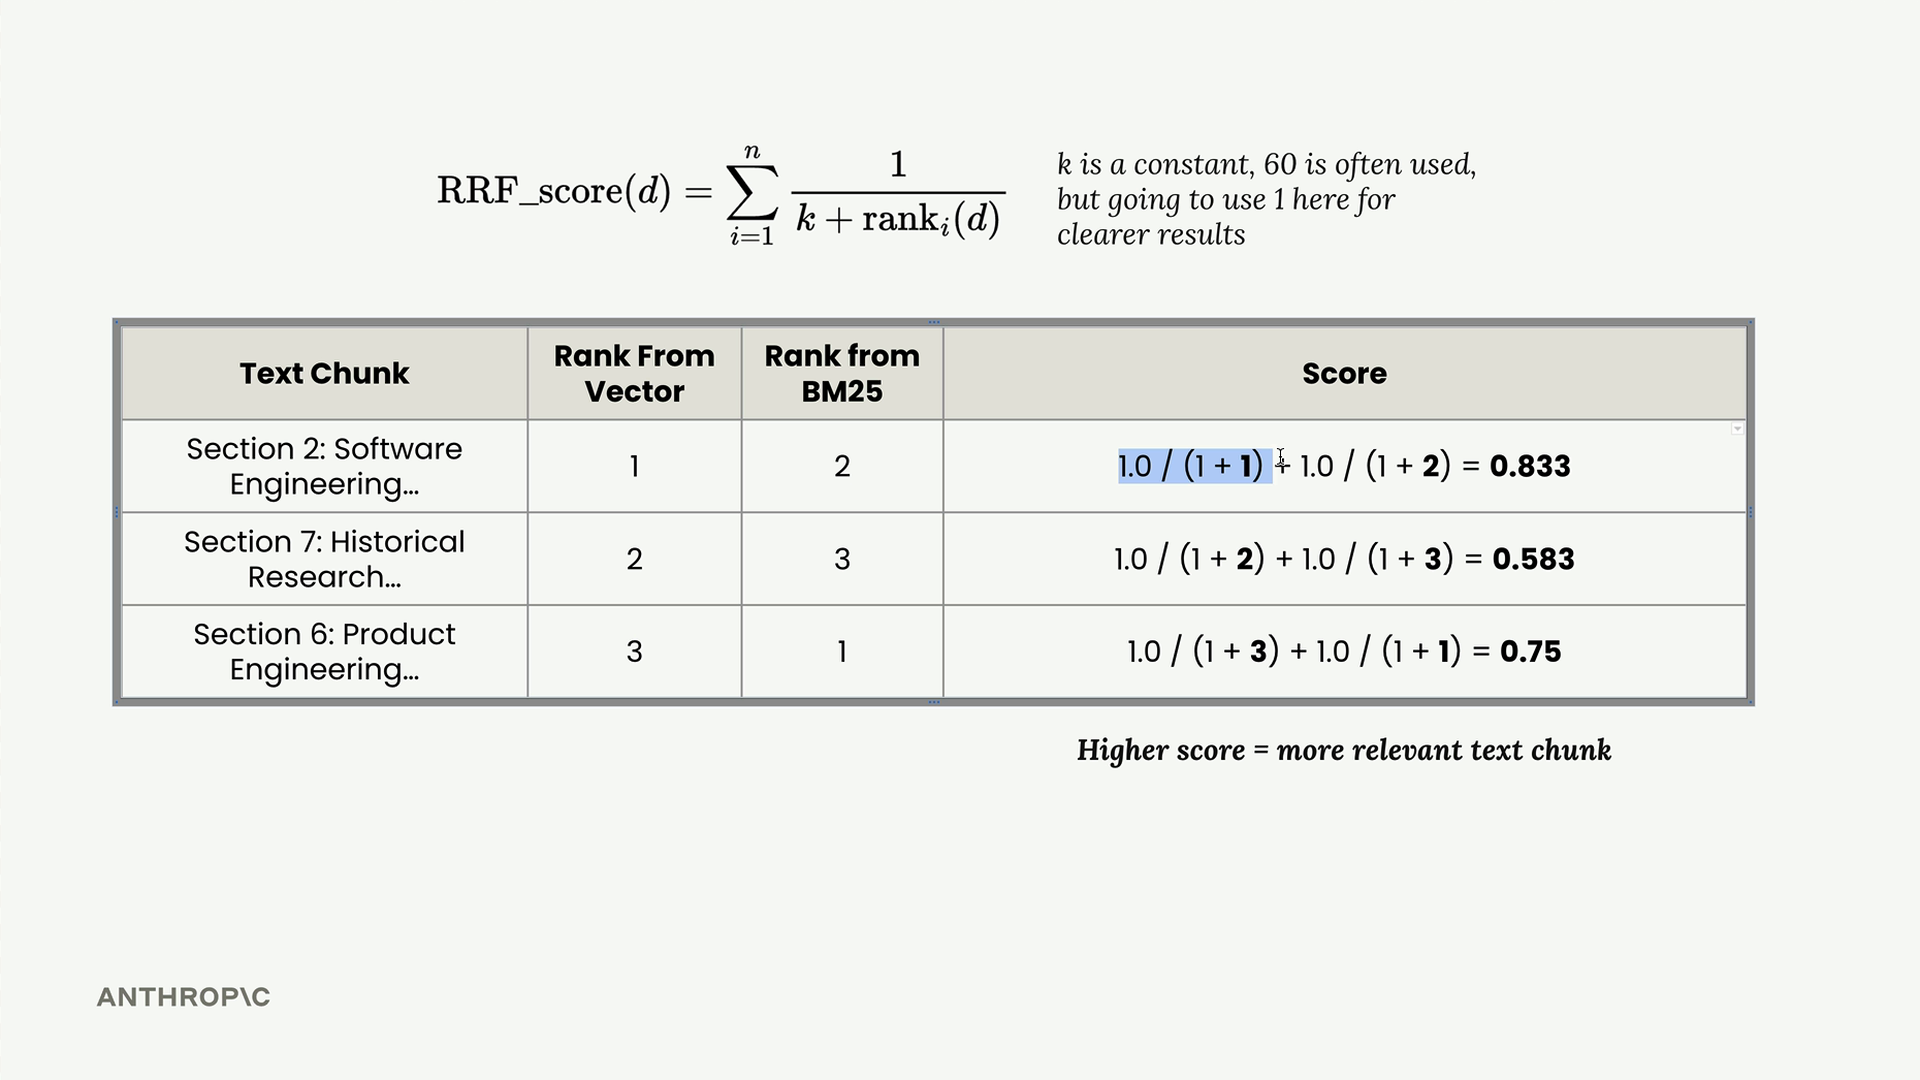
La formule RRF calcule un score pour chaque document :
RRF_score(d) = Σ(1 / (k + rank_i(d)))Où k est une constante (généralement 60, bien que 1 fonctionne bien pour des résultats plus clairs) et rank_i(d) est le rang du document d dans le i-ème système de classement.
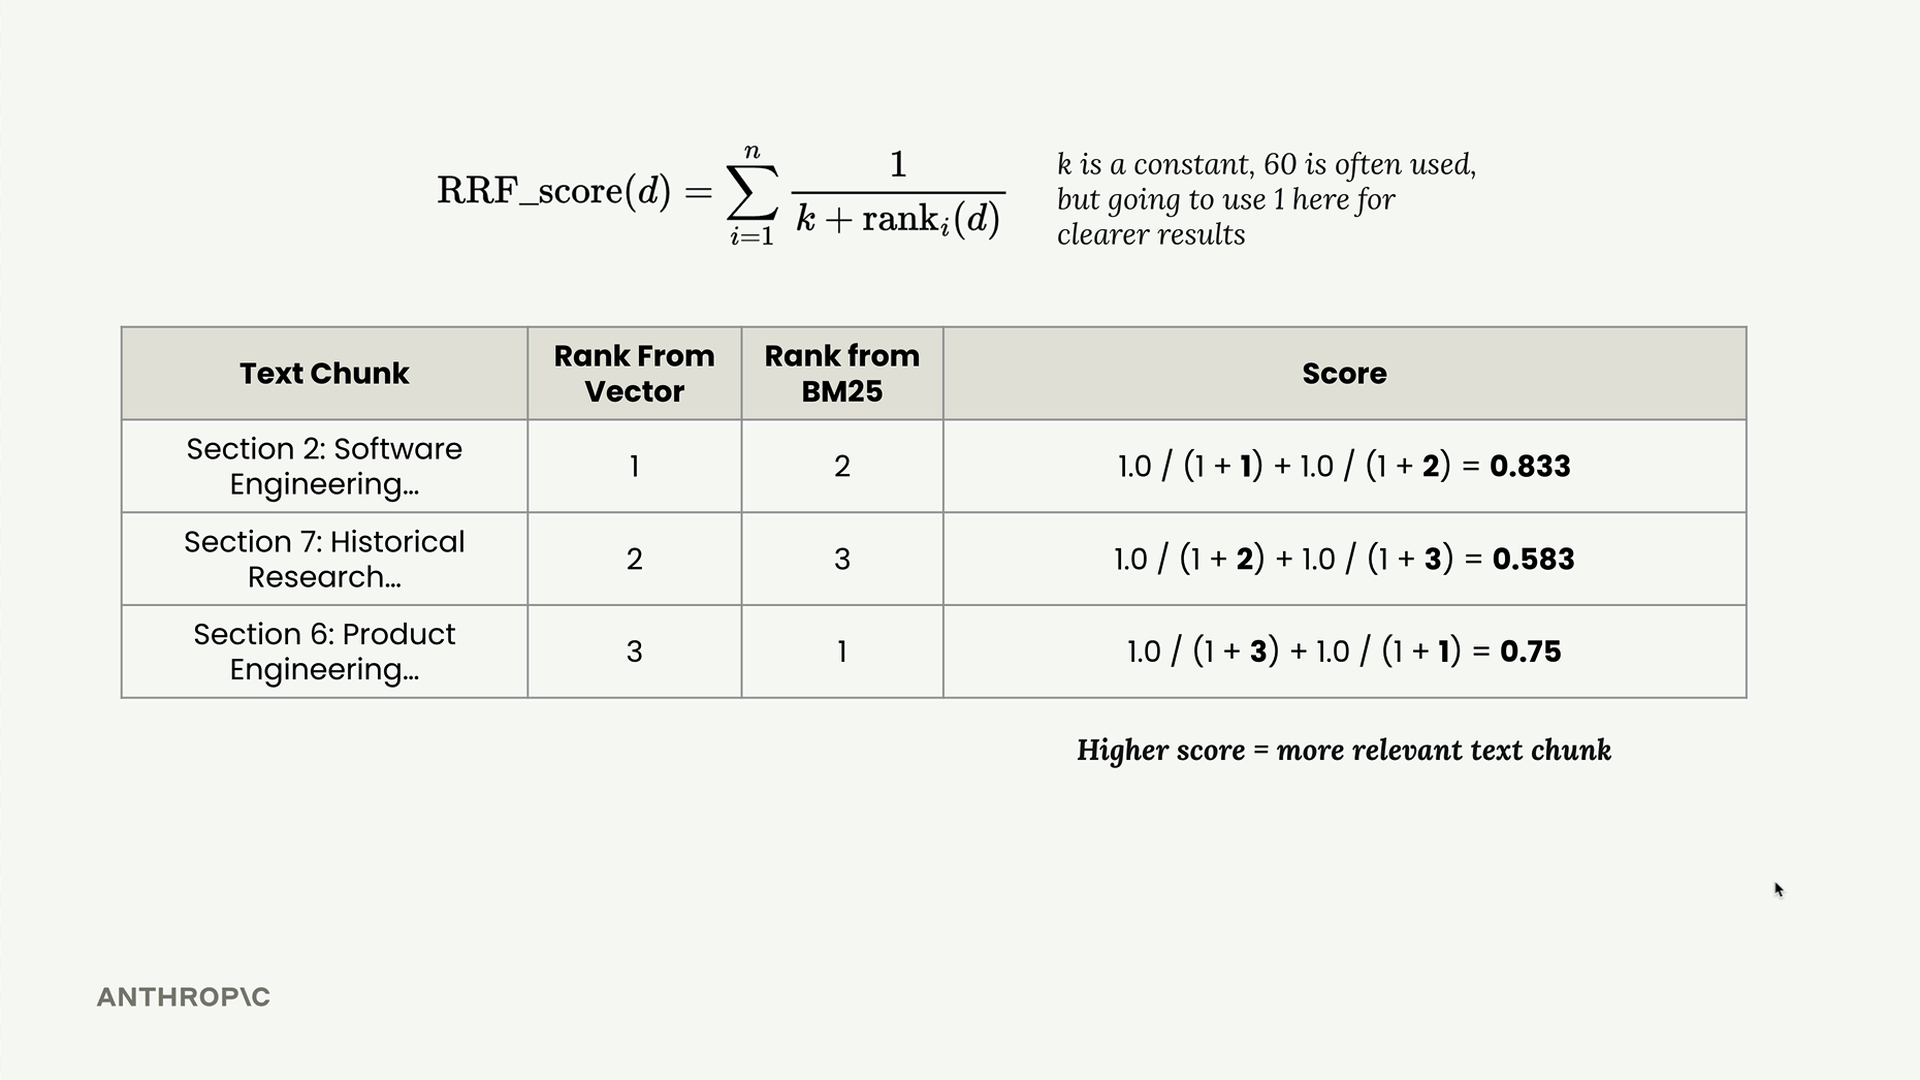
Pour chaque extrait de texte, vous calculez :
- Section 2 : 1.0/(1+1) + 1.0/(1+2) = 0.833
- Section 7 : 1.0/(1+2) + 1.0/(1+3) = 0.583
- Section 6 : 1.0/(1+3) + 1.0/(1+1) = 0.75
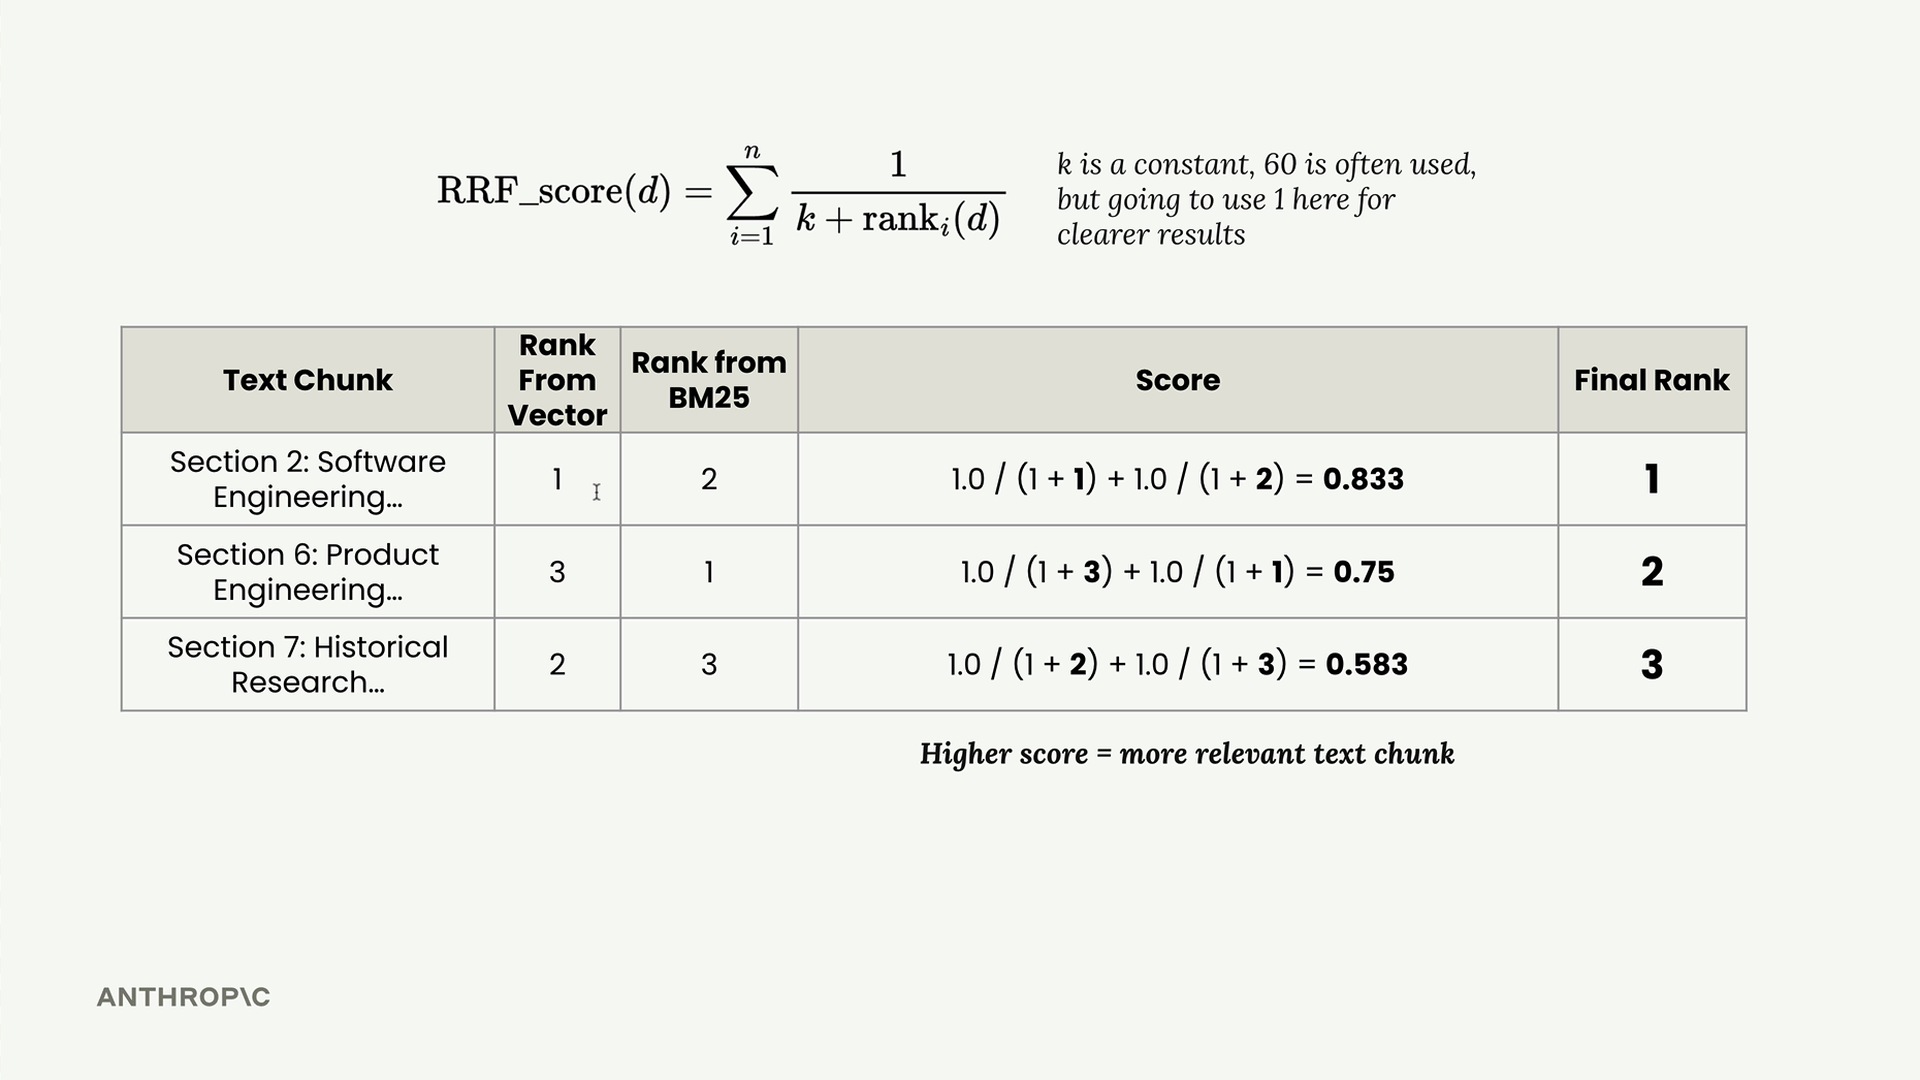
Après tri par score, le classement final devient : Section 2 (première), Section 6 (deuxième), Section 7 (troisième).
Implémentation
L'implémentation de la classe Retriever est simple :
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # Obtenir les résultats de tous les index
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # Suivre les rangs des documents entre les systèmes
                # Appliquer la formule RRF
                # Retourner les résultats fusionnés et triés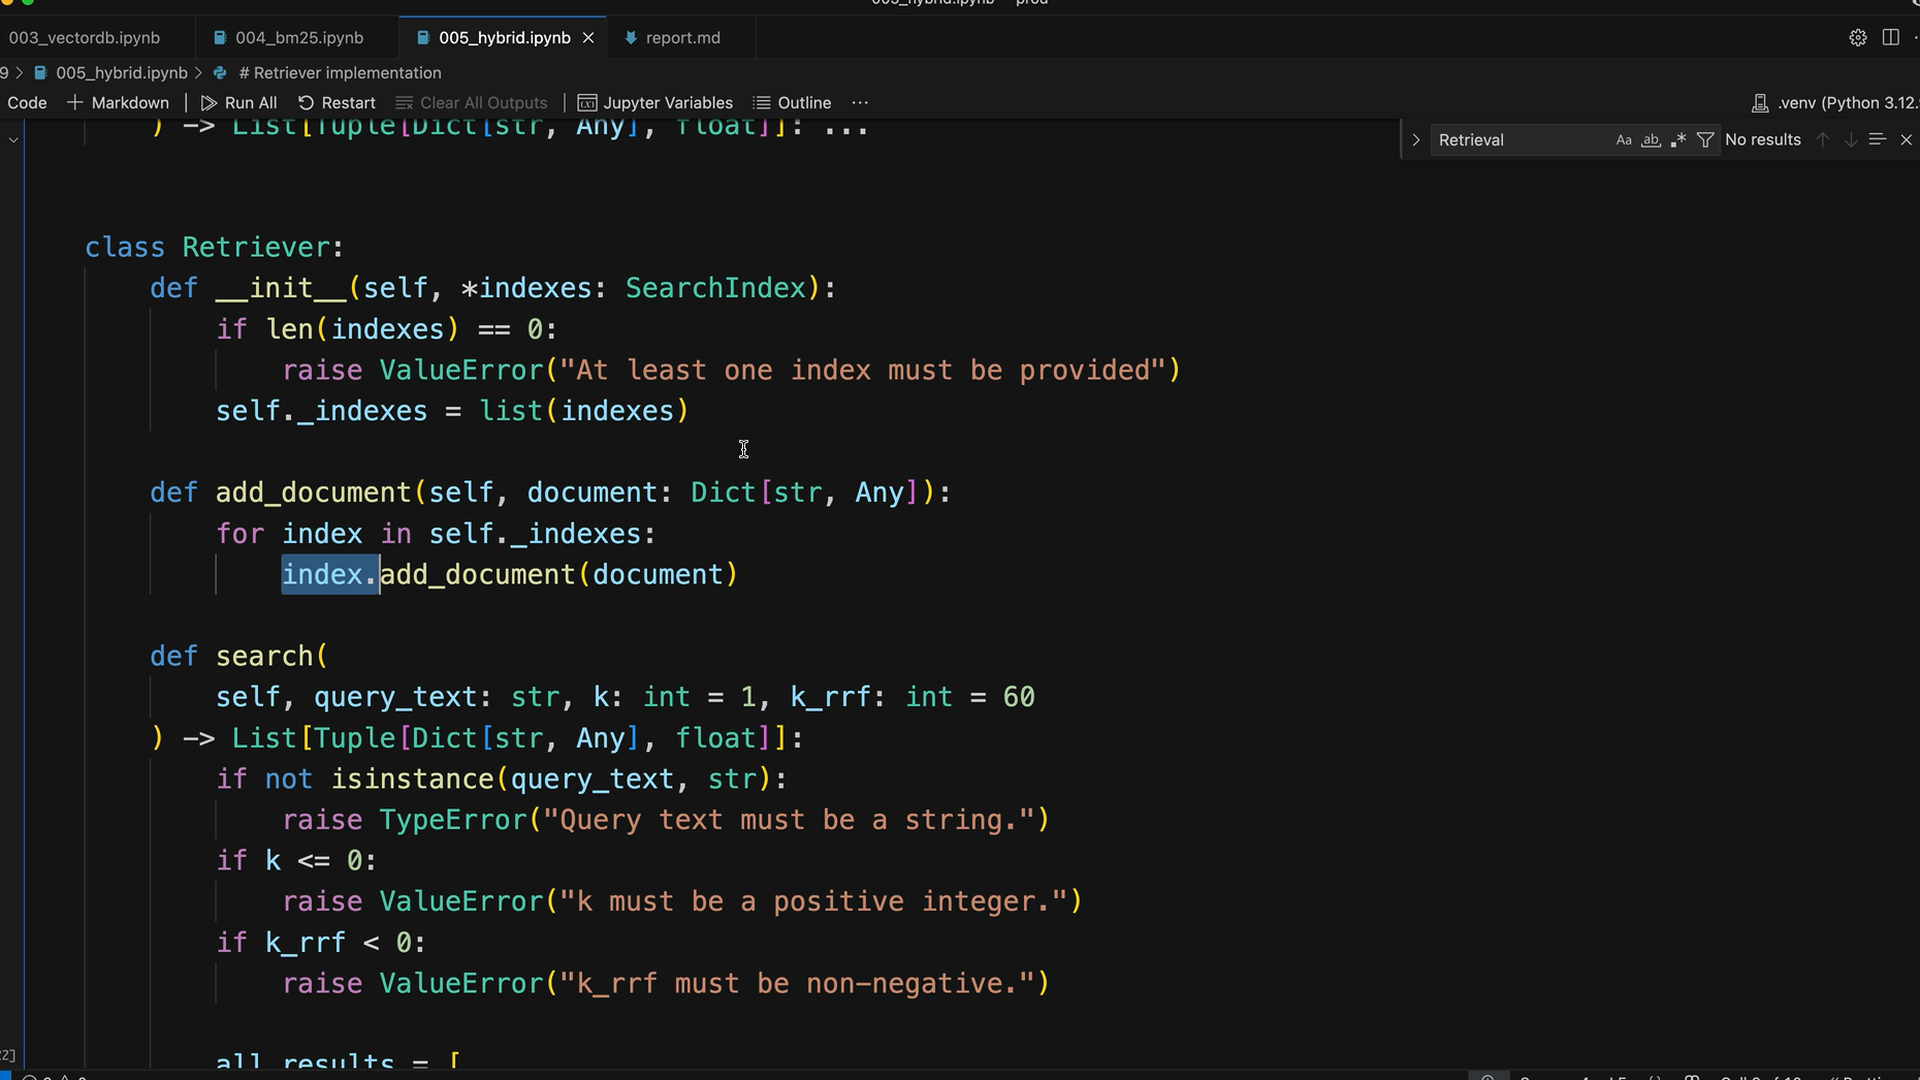
L'idée clé est que l'algorithme RRF crée un classement unifié en tenant compte de la performance de chaque document à travers tous les systèmes de recherche, plutôt que de s'appuyer sur une seule méthode de notation.
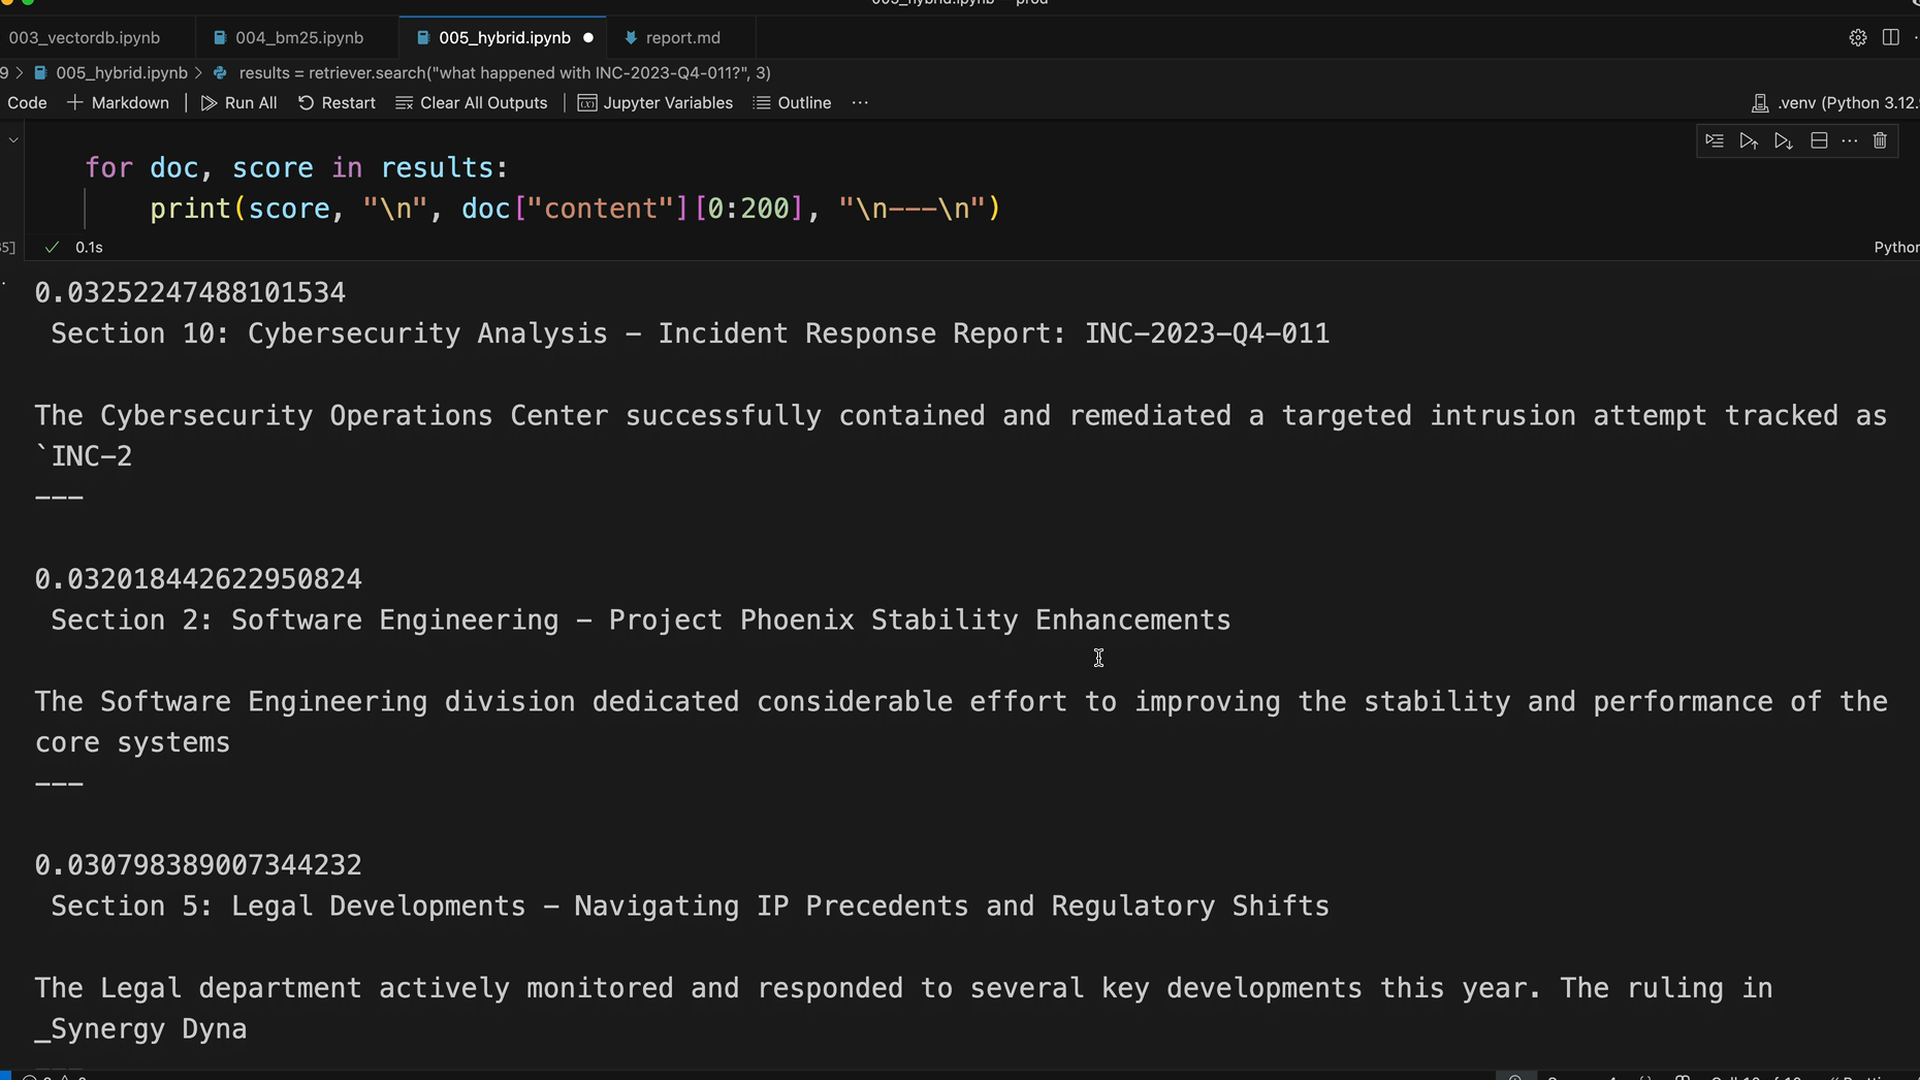
Tester l'approche hybride
Lors des tests avec une requête comme « que s'est-il passé avec INC-2023-Q4-011 ? », l'approche hybride fournit des résultats nettement meilleurs que l'une ou l'autre méthode seule. Au lieu d'obtenir des résultats inattendus avec une recherche vectorielle pure, vous obtenez désormais en premier le rapport d'incident de cybersécurité le plus pertinent, suivi d'un contenu connexe en ingénierie logicielle.
Extensibilité
La beauté de cette conception réside dans sa modularité. Puisque chaque index de recherche implémente la même interface (add_document() et search()), vous pouvez facilement ajouter de nouvelles méthodologies de recherche au système. Qu'il s'agisse d'un modèle d'embedding différent, d'une recherche spécialisée dans un domaine, ou de toute autre technique de récupération, tant qu'elle suit l'API établie, elle s'intègre parfaitement dans le pipeline hybride.
Cette approche de recherche hybride représente une amélioration significative de la précision de récupération en combinant la compréhension sémantique de la recherche vectorielle avec la correspondance précise par mots-clés de la recherche lexicale, tout cela unifié grâce à l'algorithme de classement RRF mathématiquement solide.