La création d'un workflow d'évaluation de prompt personnalisé commence par la définition d'un objectif clair et la génération de données de test. Dans ce cas, nous construisons un prompt qui aide les utilisateurs à écrire du code spécifique à AWS - qu'il s'agisse de fonctions Python, de configurations JSON ou d'expressions régulières - sans explications ni formatage supplémentaires.
Définir l'objectif
Le prompt doit prendre la description de tâche d'un utilisateur et renvoyer l'un des trois types de sortie suivants :
- Code Python
- Configuration JSON
- Expressions régulières
L'exigence clé est que les réponses ne contiennent que le code demandé, sans en-têtes, pieds de page ni explications.
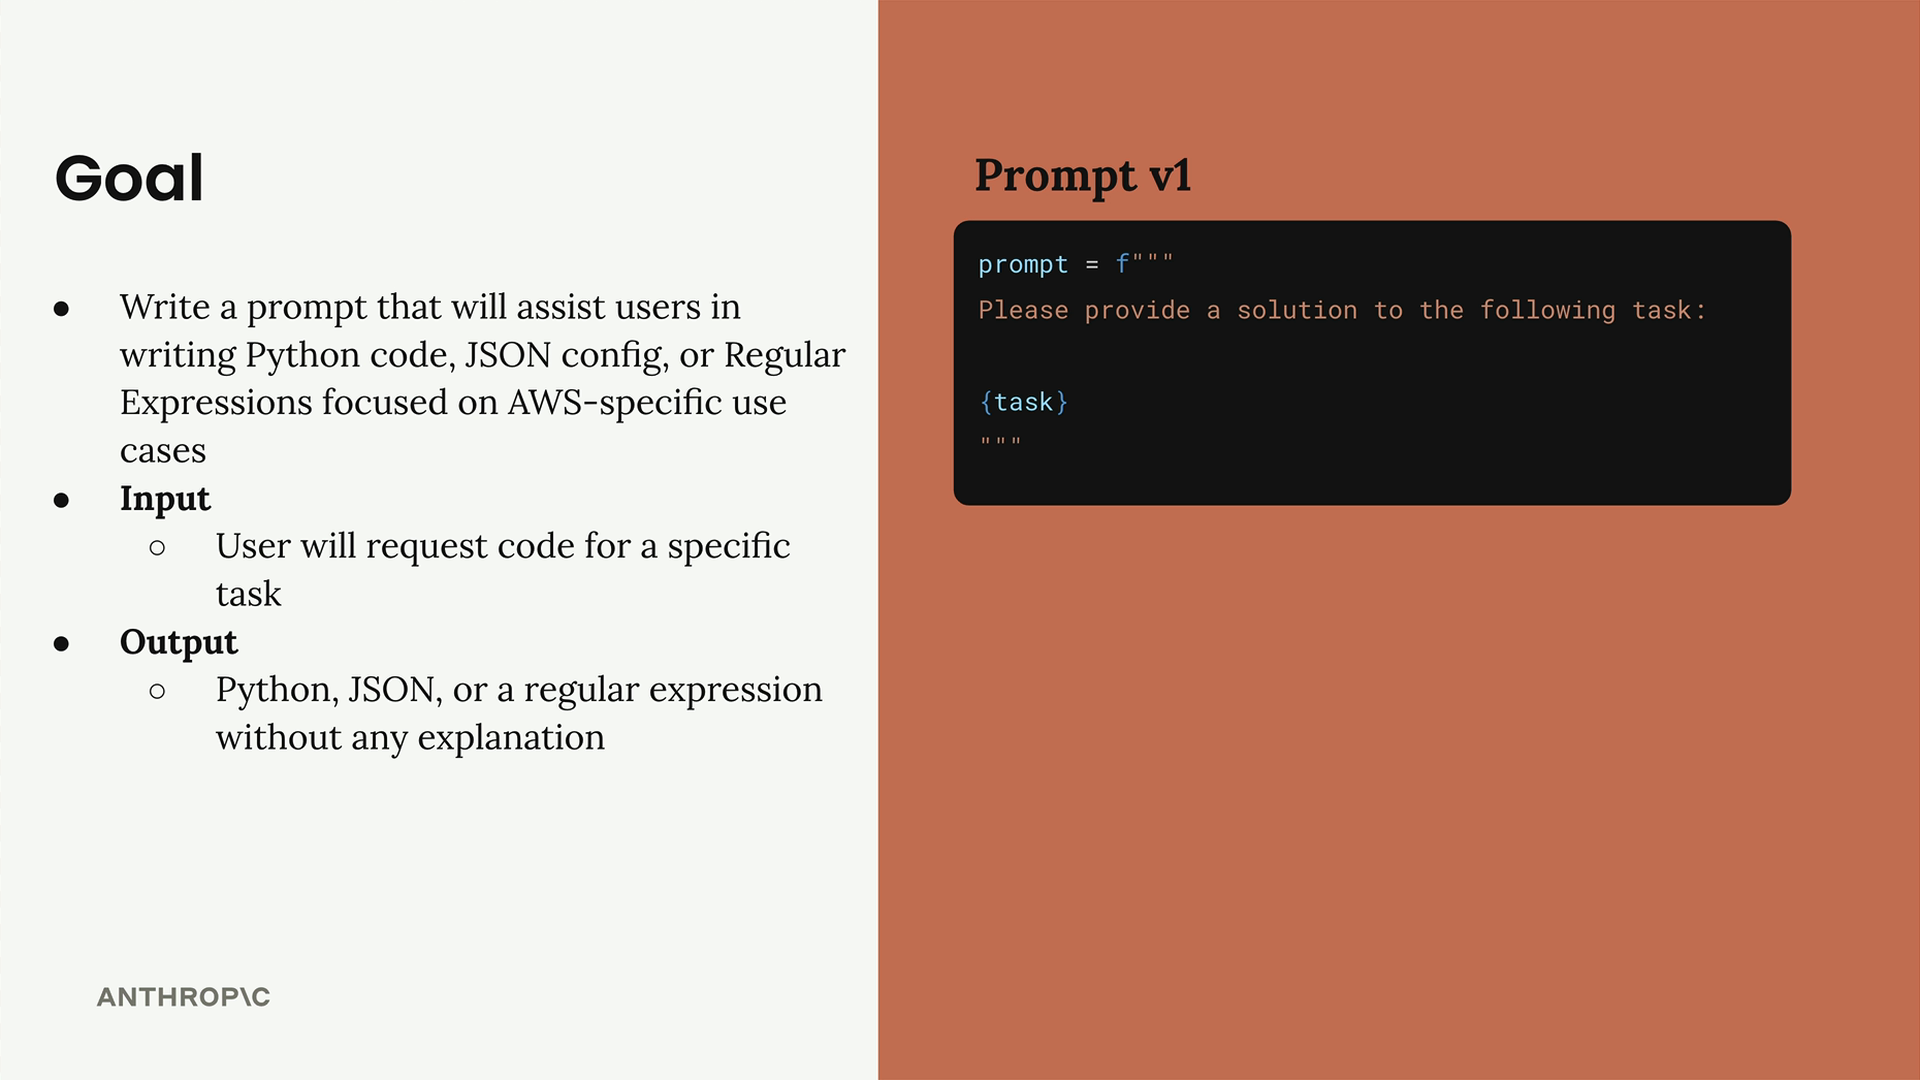
Commencer par une première version simple permet de garder les choses gérables. Le modèle de prompt initial est simple : « Veuillez fournir une solution à la tâche suivante : {task} »
Création de jeux de données d'évaluation
Un jeu de données d'évaluation contient des exemples d'entrée que vous allez injecter dans votre prompt. Chaque cas de test est combiné avec votre prompt et envoyé à Claude, ce qui vous permet de voir dans quelle mesure le prompt fonctionne bien dans différents scénarios.
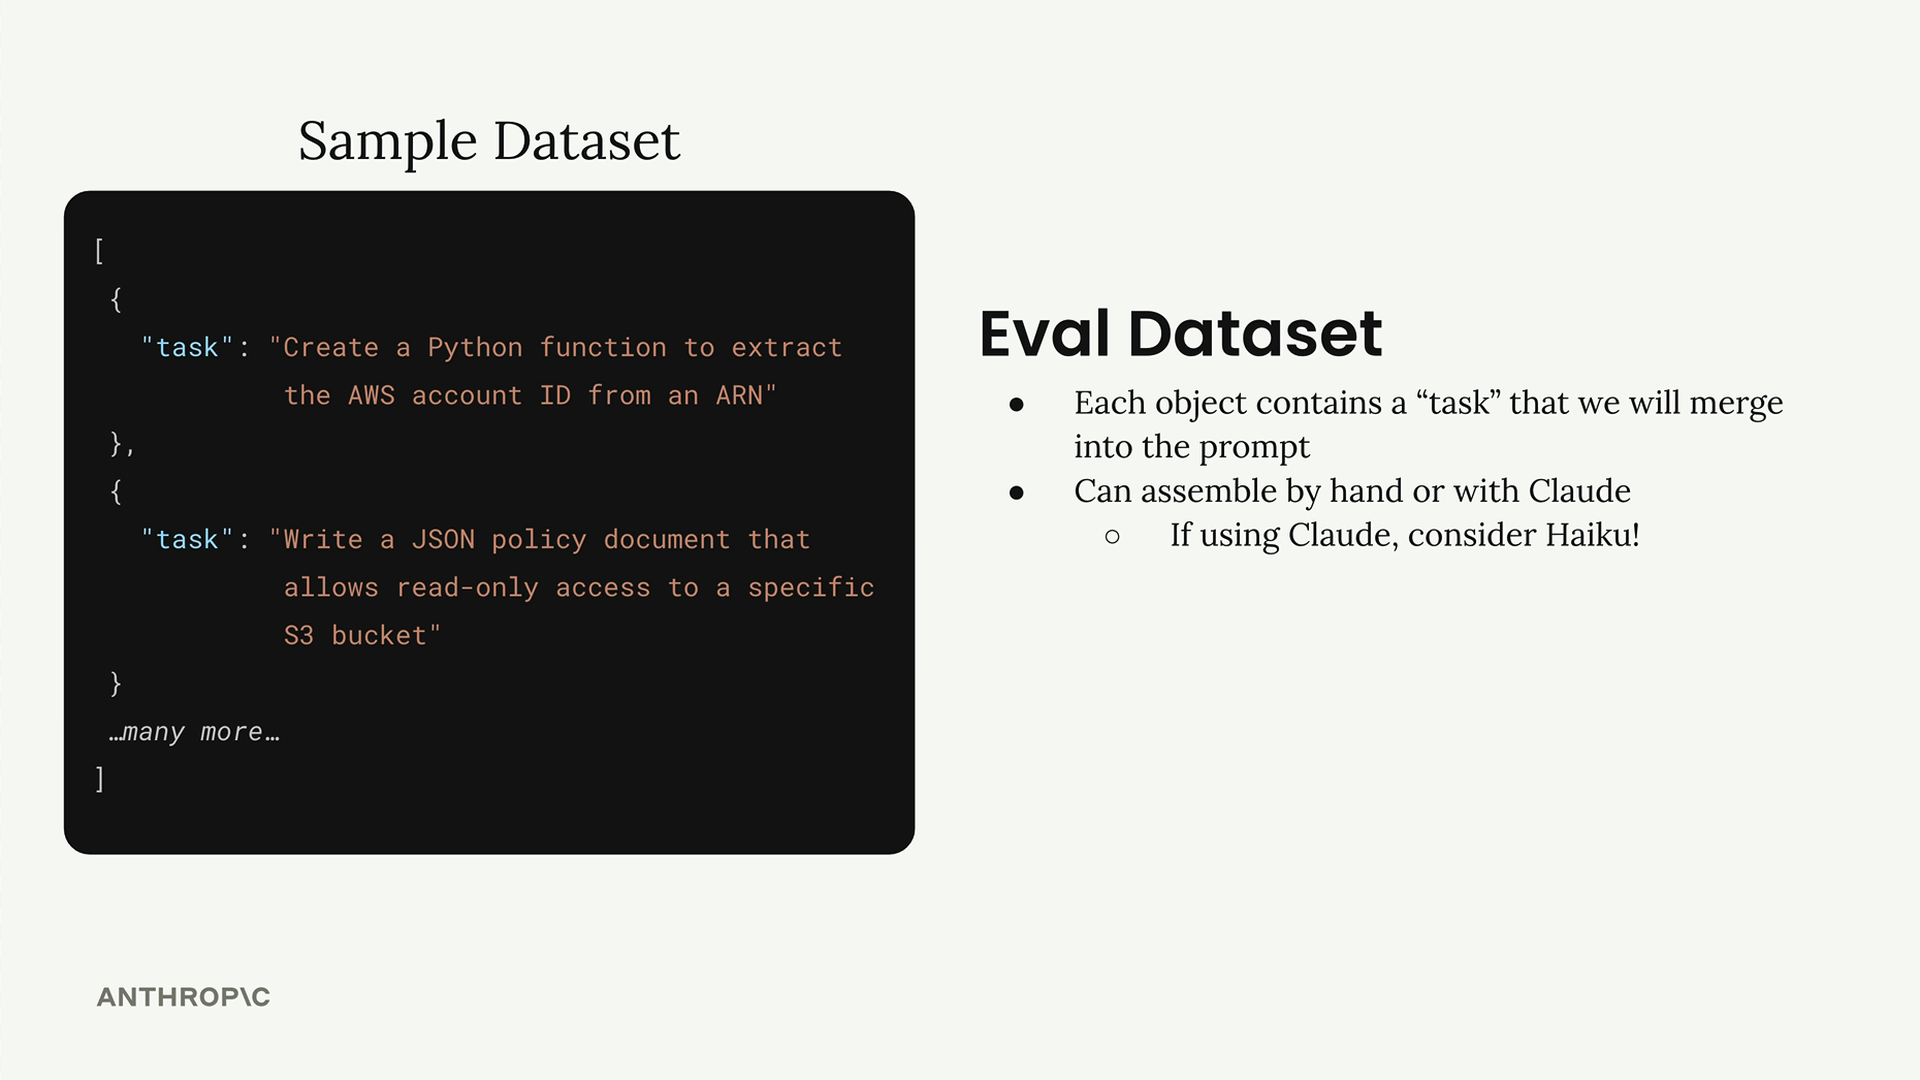
Vous pouvez créer des jeux de données de deux manières :
- Écrire manuellement des cas de test
- Les générer automatiquement à l'aide de Claude
Pour la génération automatique, utiliser un modèle plus rapide comme Haiku est judicieux puisque vous générez plusieurs cas de test.
Génération de données de test avec du code
La fonction de génération de jeu de données utilise Claude pour créer des scénarios de test réalistes. Voici la structure de base :
def generate_dataset():
    prompt = """
    Generate 3 AWS-related tasks that require Python, JSON, or Regex solutions.

    Focus on tasks that can be solved by writing a single Python function,
    a single JSON object, or tasks that do not require writing much code.

    Example output:
    [
        {
            "task": "Description of task"
        },
        ...additional
    ]

    Please generate 3 objects.
    """

    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
Cette approche utilise la technique du message assistant pré-rempli avec des séquences d'arrêt pour extraire des réponses JSON propres. Le message assistant commence par "```json" et s'arrête à la fermeture "```", garantissant que vous obtenez des données correctement formatées. ## Enregistrement de votre jeu de données Une fois généré, enregistrez le jeu de données pour éviter de le régénérer constamment : ``` dataset = generate_dataset() with open("dataset.json", "w") as f: json.dump(dataset, f, indent=2) ``` ` Le jeu de données généré crée des tâches AWS réalistes comme l'extraction d'ID de compte à partir d'ARN, l'écriture de schémas JSON pour les configurations EC2, et la création de motifs regex pour les noms de buckets S3. Bien que trois cas de test fonctionnent pour le développement initial, une évaluation en production nécessiterait beaucoup plus d'exemples avec une plus grande variété. Cette base vous donne un processus reproductible pour créer des jeux de données d'évaluation qui correspondent à votre cas d'usage spécifique, préparant les prochaines étapes consistant à exécuter des évaluations et à mesurer les performances du prompt. `