Maintenant que notre jeu de données d'évaluation est prêt, il est temps de construire le pipeline d'évaluation principal. Cela implique de prendre chaque cas de test, de le fusionner avec notre prompt, de le transmettre à Claude, puis d'évaluer les résultats.
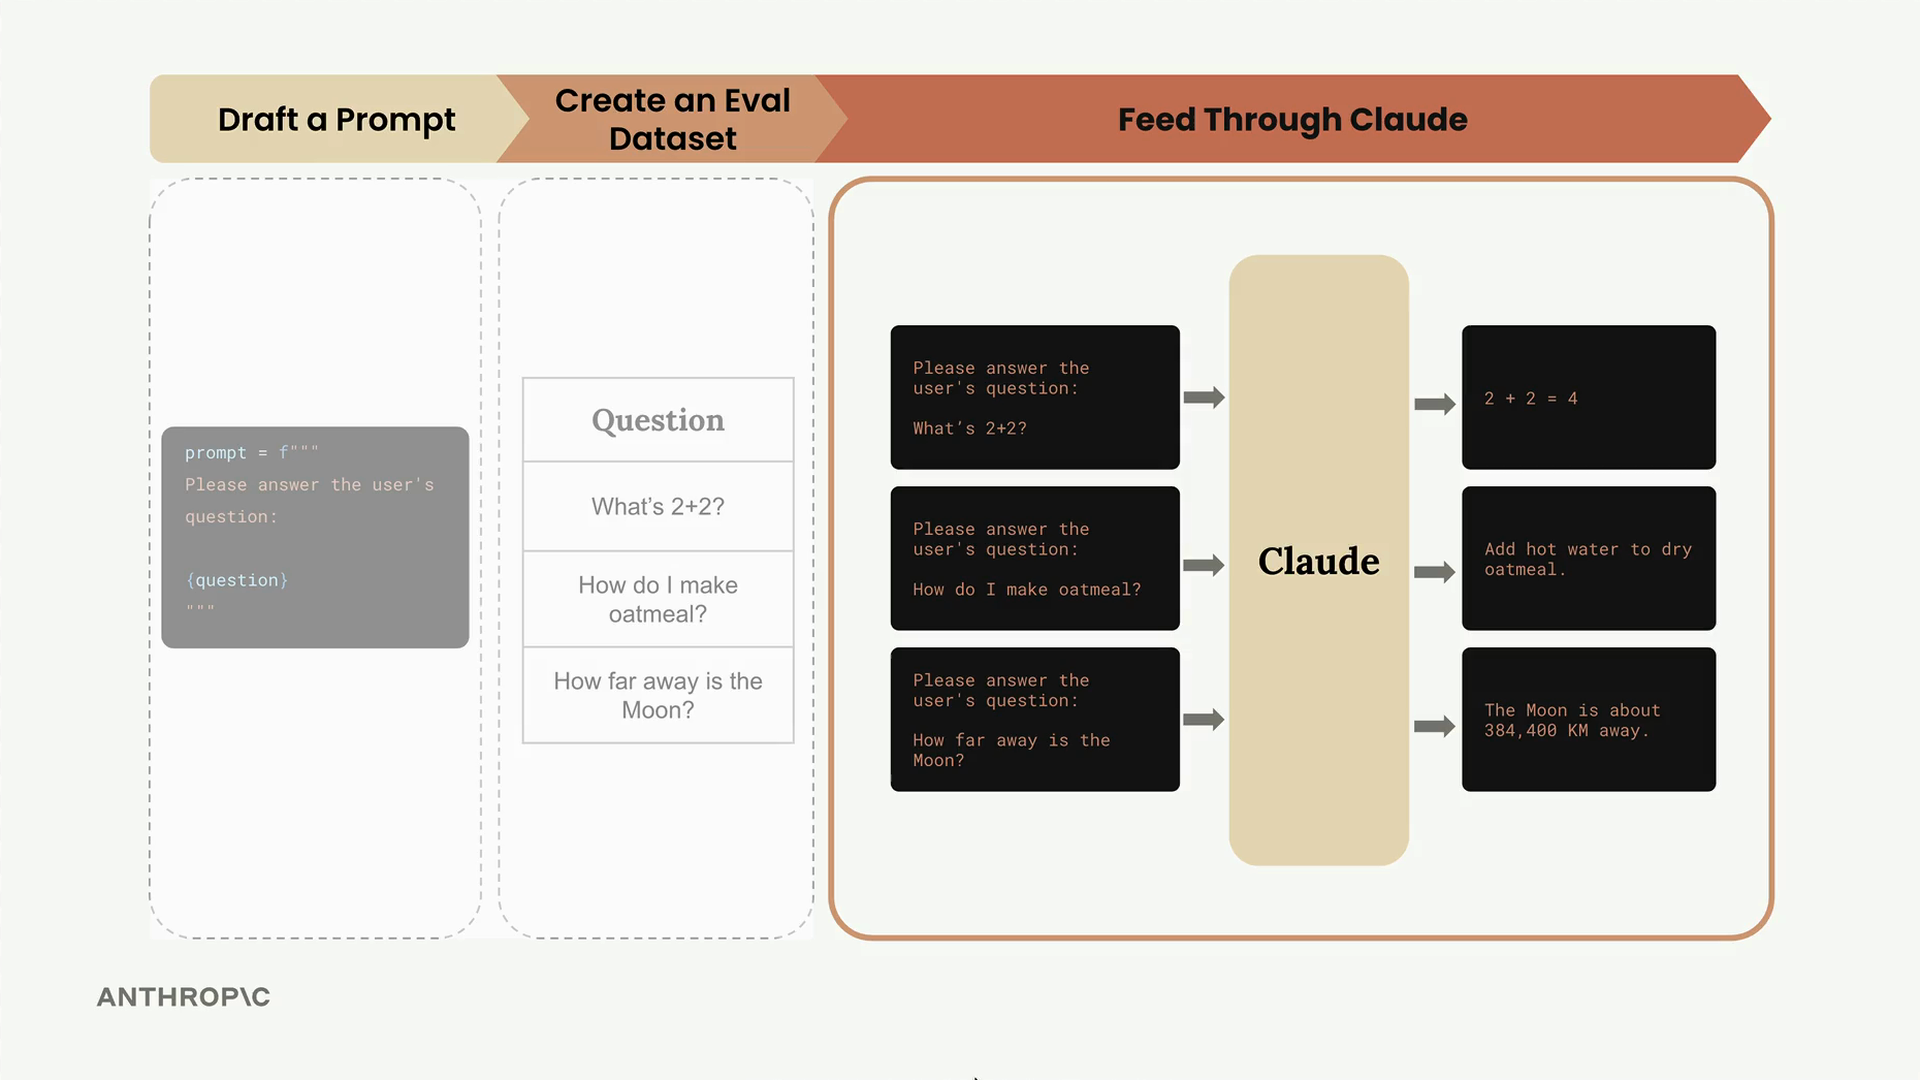
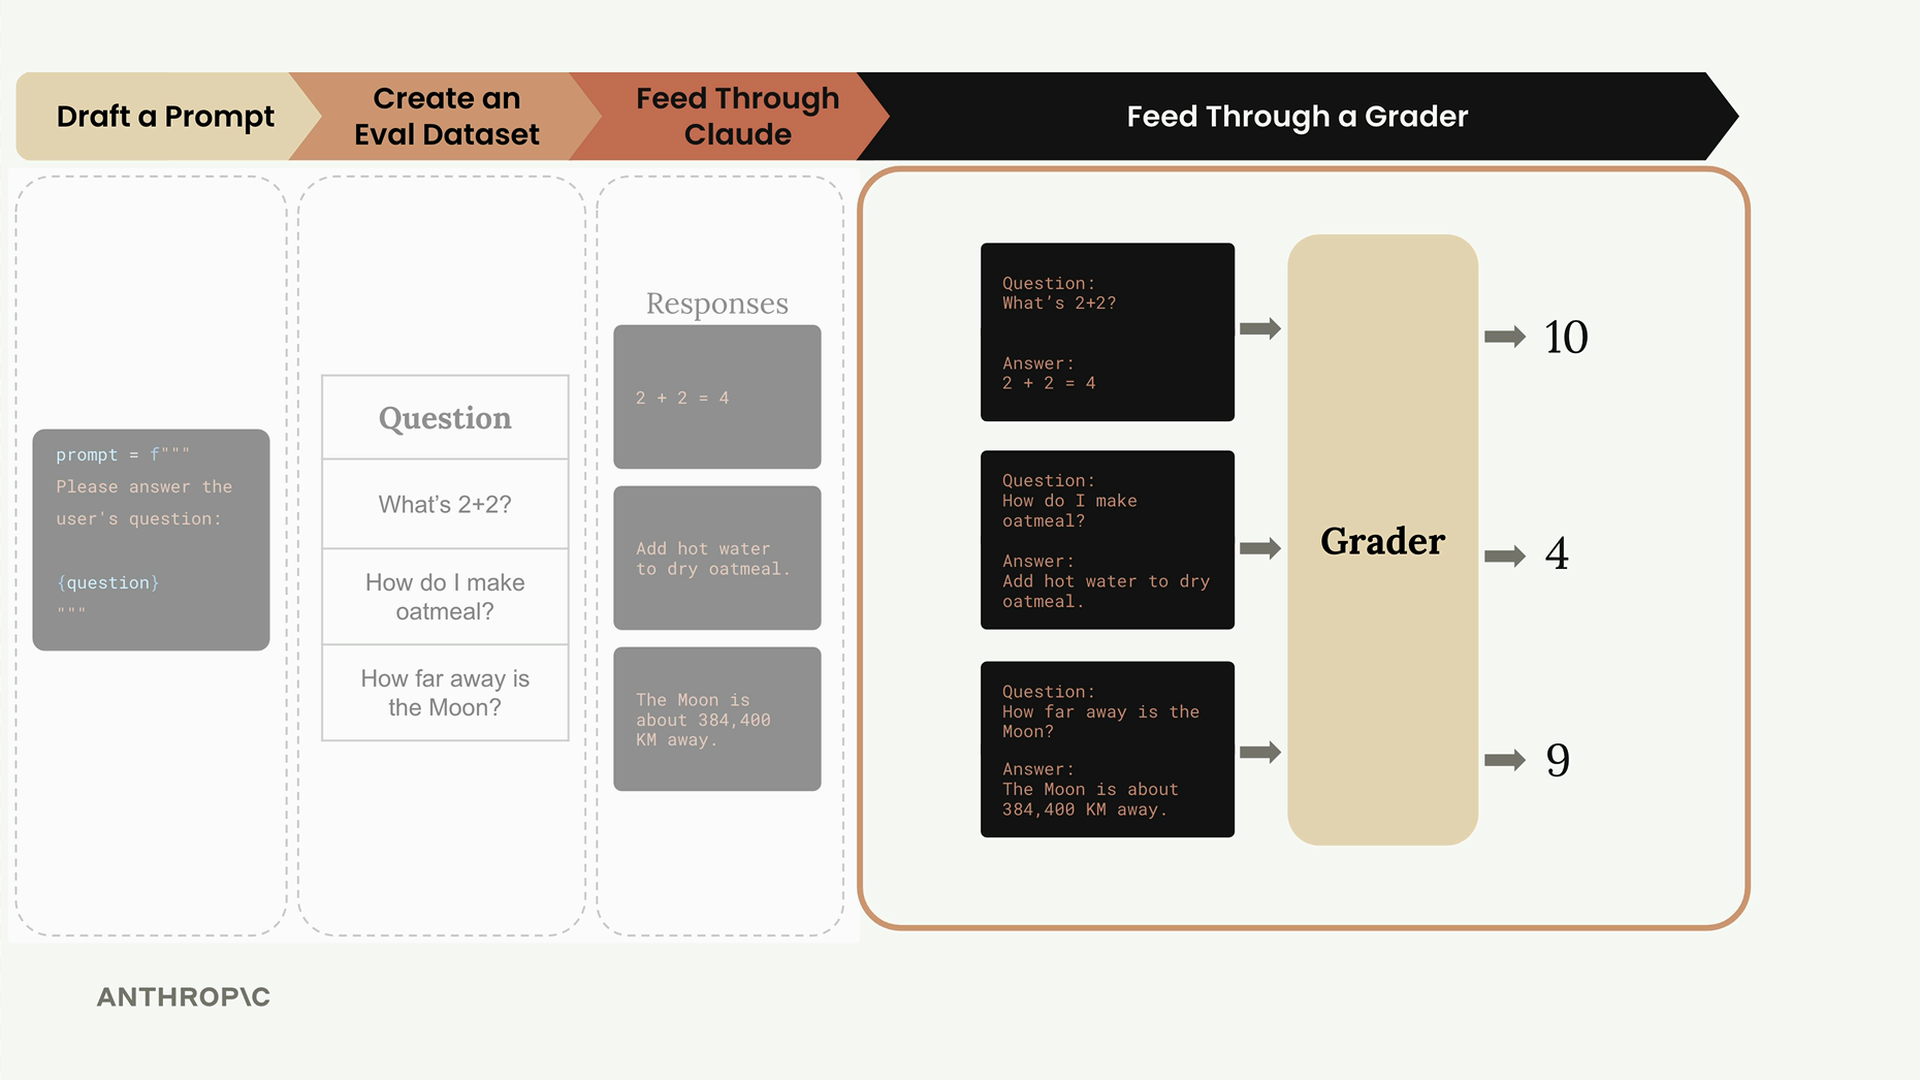
Le processus d'évaluation suit un flux de travail clair : nous prenons notre jeu de données de cas de test, combinons chacun avec notre modèle de prompt, l'envoyons à Claude pour traitement, puis évaluons la sortie à l'aide d'un système de notation.
Construction des fonctions principales
Le pipeline d'évaluation se compose de trois fonctions principales, chacune ayant une responsabilité spécifique. Commençons par la plus simple - la fonction qui gère l'exécution d'un prompt individuel.
La fonction run_prompt
Cette fonction prend un cas de test et le fusionne avec notre modèle de prompt :
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
Pour l'instant, nous gardons le prompt extrêmement simple. Nous n'incluons aucune instruction de formatage, ce qui signifie que Claude renverra probablement une sortie plus verbeuse que nécessaire. Nous affinerons cela plus tard au fur et à mesure que nous itérerons sur notre processus d'évaluation.
La fonction run_test_case
Cette fonction orchestre l'exécution d'un seul cas de test et la notation du résultat :
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - Notation
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
Pour l'instant, nous utilisons un score codé en dur de 10. La logique de notation est l'endroit où nous passerons un temps considérable dans les sections suivantes, mais cet espace réservé nous permet de tester la structure globale du pipeline.
La fonction run_eval
C'est l'orchestrateur principal qui traite l'ensemble du jeu de données :
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
Cette fonction parcourt chaque cas de test de notre jeu de données, traite chacun d'eux, et collecte tous les résultats dans une seule liste.
Exécution de l'évaluation
Pour exécuter notre pipeline d'évaluation, nous chargeons le jeu de données et appelons notre fonction principale :
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
La première fois que vous exécutez ceci, attendez-vous à ce que cela prenne du temps - même avec Claude Haiku, le traitement d'un jeu de données complet peut prendre plus de 30 secondes. Nous aborderons les techniques d'optimisation plus tard, mais pour l'instant, la patience est de mise.
Examen des résultats
Une fois l'évaluation terminée, vous pouvez inspecter les résultats avec une sortie JSON formatée :
print(json.dumps(results, indent=2))
La structure des résultats contient un tableau d'objets, où chaque objet représente l'exécution d'un cas de test. Vous verrez la sortie de Claude (qui tend à être assez verbeuse sans contraintes de formatage), la définition originale du cas de test, et le score.
Ce que nous avons accompli
À ce stade, nous avons réussi à implémenter le pipeline d'évaluation principal. Nous pouvons :
- Prendre des cas de test de notre jeu de données
- Les fusionner avec des modèles de prompt
- Obtenir des réponses de Claude
- Collecter et organiser tous les résultats
L'élément manquant est la notation intelligente - pour l'instant, nous attribuons simplement un score fixe à chaque réponse. La prochaine étape consiste à construire des évaluateurs capables d'évaluer réellement si les sorties de Claude sont correctes, ce qui est là où la véritable sophistication des systèmes d'évaluation entre en jeu.
Cette structure de pipeline peut sembler simple, mais elle représente la base sur laquelle la plupart des systèmes d'évaluation d'IA sont construits. La complexité réside dans la logique de notation et l'optimisation des prompts, pas dans l'orchestration de base de l'exécution des tests.