Lors de la création de workflows d'évaluation des prompts, les évaluateurs (graders) fournissent des signaux objectifs sur la qualité des sorties. Un évaluateur prend la sortie du modèle et renvoie une forme de retour mesurable - généralement un nombre entre 1 et 10, où 10 représente une qualité élevée et 1 représente une qualité médiocre.
Types d'évaluateurs
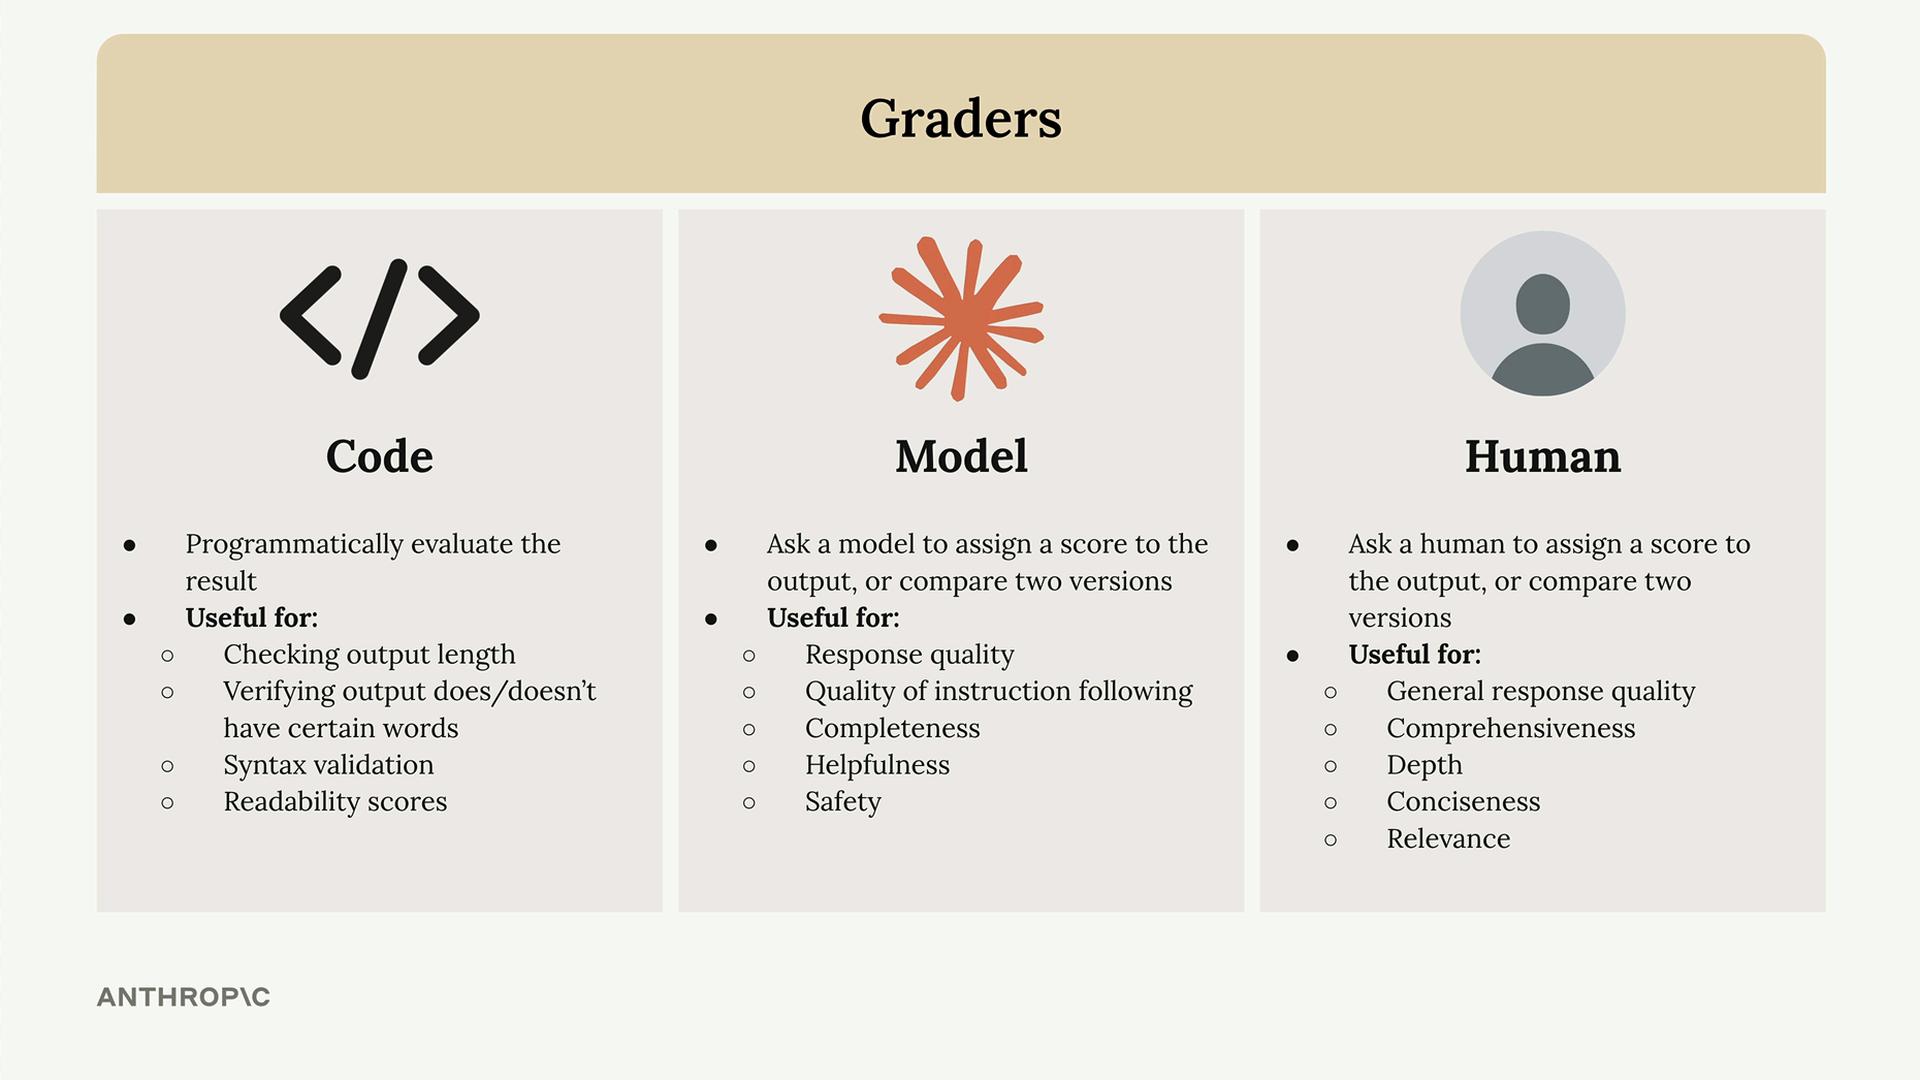
Il existe trois approches principales pour évaluer les sorties des modèles :
- Évaluateurs de code - Évaluent les sorties de manière programmatique à l'aide d'une logique personnalisée
- Évaluateurs basés sur un modèle - Utilisent un autre modèle d'IA pour évaluer la qualité
- Évaluateurs humains - Font appel à des personnes pour examiner et noter manuellement les sorties
Évaluateurs de code
Les évaluateurs de code vous permettent d'implémenter n'importe quelle vérification programmatique que vous pouvez imaginer. Les utilisations courantes incluent :
- Vérifier la longueur de la sortie
- Vérifier que la sortie contient ou ne contient pas certains mots
- Validation de la syntaxe pour JSON, Python ou les expressions régulières
- Scores de lisibilité
La seule exigence est que votre code renvoie un signal mesurable lors de son exécution.
Évaluateurs basés sur un modèle
Les évaluateurs basés sur un modèle effectuent une requête API supplémentaire pour évaluer la sortie originale. Cette approche offre une flexibilité considérable pour évaluer :
- Qualité de la réponse
- Qualité du respect des instructions
- Exhaustivité
- Utilité
- Sécurité
Évaluateurs humains
Les évaluateurs humains offrent la plus grande flexibilité, mais ils sont chronophages et fastidieux. Ils sont utiles pour évaluer :
- Qualité générale de la réponse
- Exhaustivité
- Profondeur
- Concision
- Pertinence
Définir les critères d'évaluation
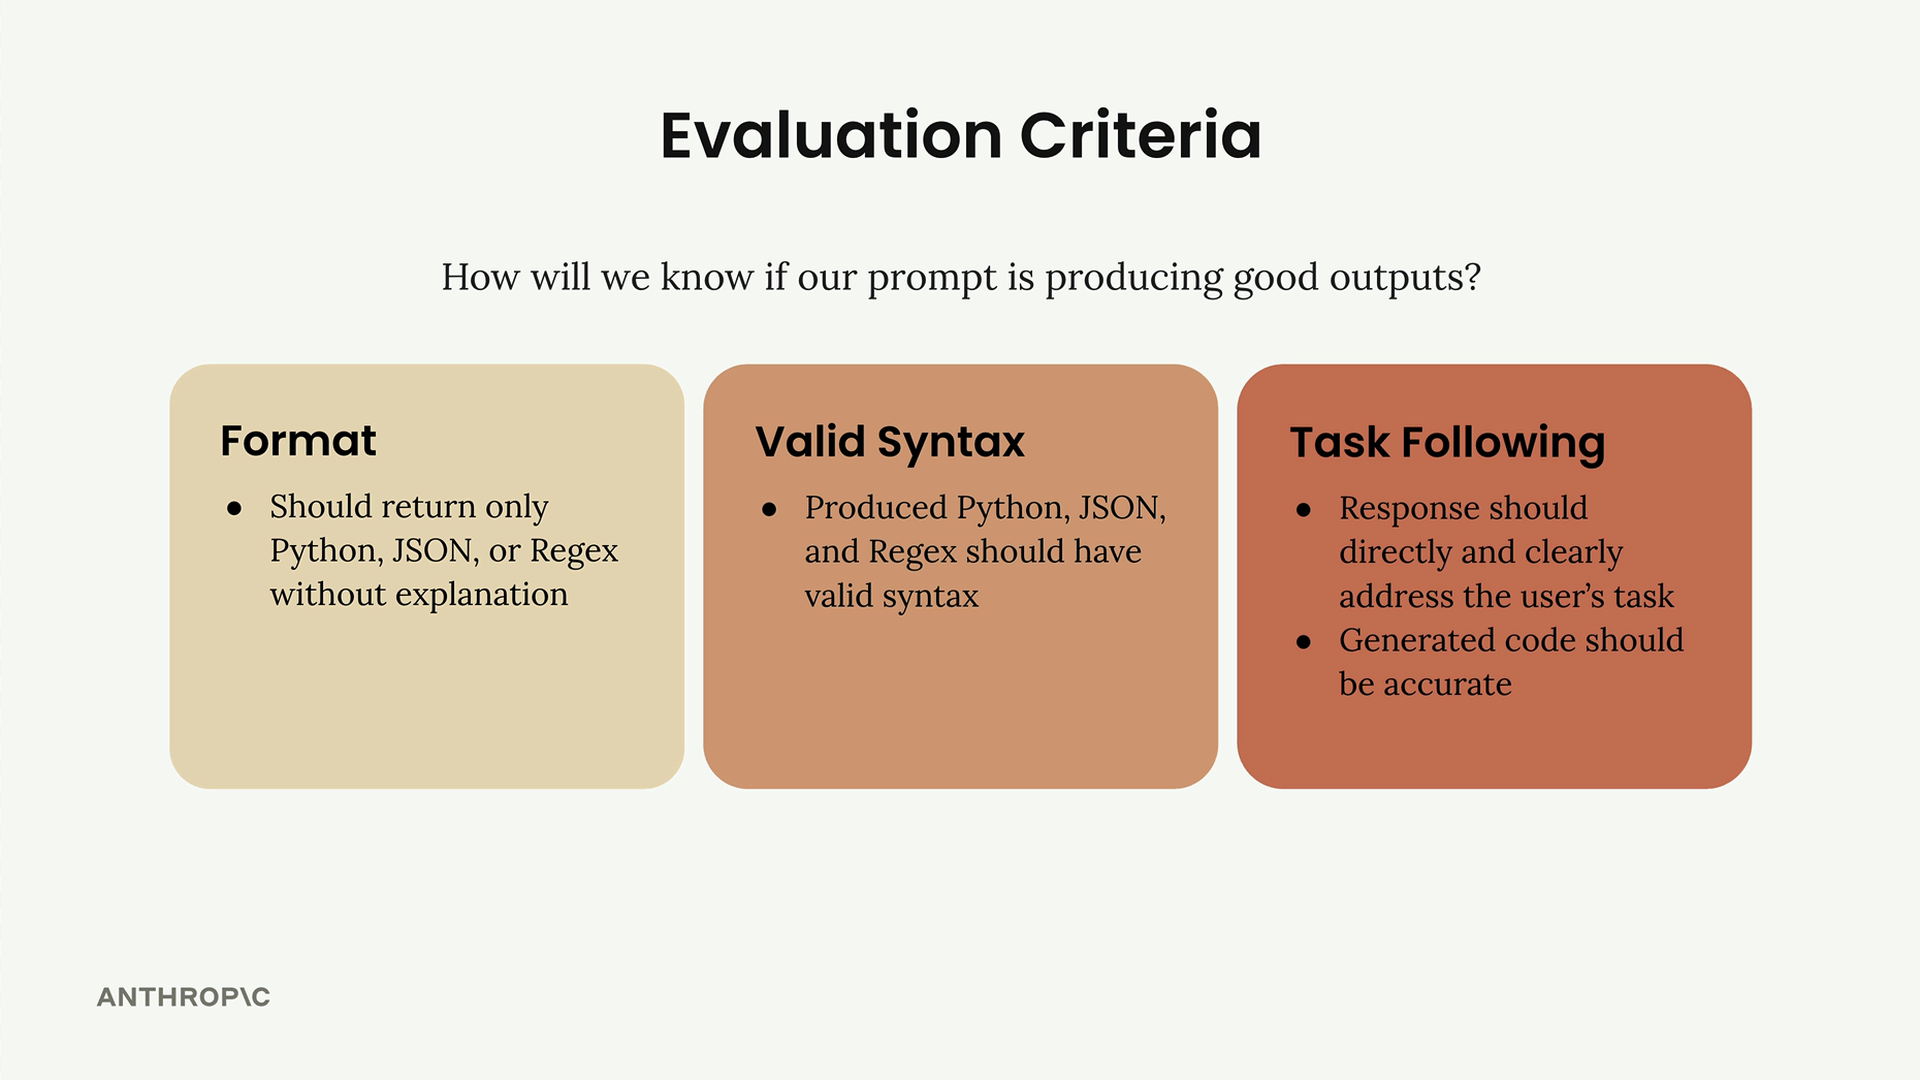
Avant d'implémenter un évaluateur, vous avez besoin de critères d'évaluation clairs. Pour un prompt de génération de code, vous pourriez vous concentrer sur :
- Format - Doit renvoyer uniquement du Python, du JSON ou une expression régulière sans explication
- Syntaxe valide - Le code produit doit avoir une syntaxe valide
- Respect de la tâche - La réponse doit répondre directement à la tâche de l'utilisateur avec un code précis
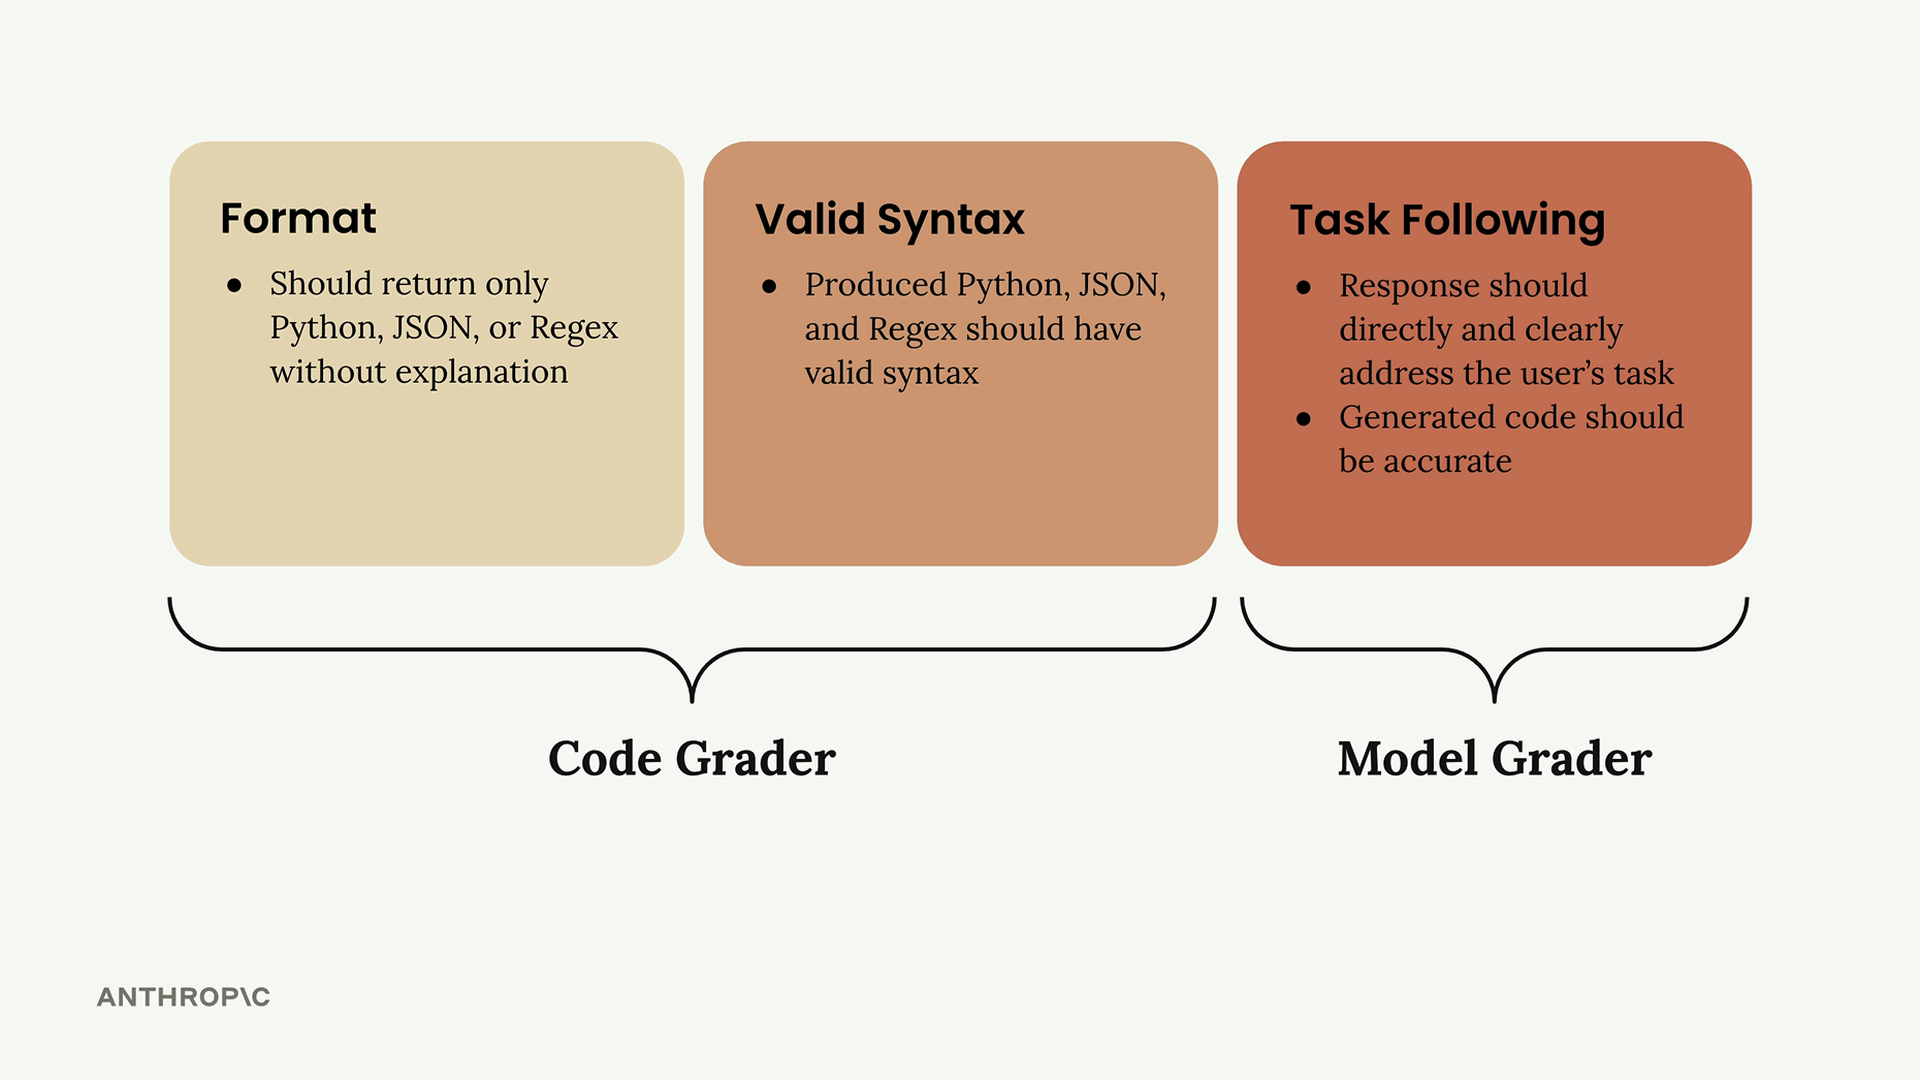
Les deux premiers critères fonctionnent bien avec les évaluateurs de code, tandis que le respect de la tâche est mieux adapté aux évaluateurs basés sur un modèle en raison de leur flexibilité.
Implémenter un évaluateur basé sur un modèle
Voici comment créer une fonction d'évaluateur basé sur un modèle :
def grade_by_model(test_case, output):
    # Créer l'invite d'évaluation
    eval_prompt = """
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {task}
    Solution: {solution}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")

    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)
L'idée clé est de demander les points forts, les points faibles et le raisonnement en plus du score. Sans ce contexte, les modèles ont tendance à se rabattre par défaut sur des scores moyens autour de 6. ## Intégrer l'évaluateur Mettez à jour votre fonction de cas de test pour utiliser l'évaluateur basé sur un modèle : ``` def run_test_case(test_case): output = run_prompt(test_case) # Get model evaluation model_grade = grade_by_model(test_case, output) score = model_grade["score"] reasoning = model_grade["reasoning"] return \{ "output": output, "test_case": test_case, "score": score, "reasoning": reasoning \} ``` `` ## Calculer les scores moyens Pour obtenir une métrique de performance globale, calculez le score moyen sur l'ensemble des cas de test : ``` from statistics import mean def run_eval(dataset): results = [] for test_case in dataset: result = run_test_case(test_case) results.append(result) average_score = mean([result["score"] for result in results]) print(f"Average score: \{average_score\}") return results ``` ` Cela vous donne une métrique concrète et objective pour suivre la performance de vos prompts au fil du temps. Bien que les évaluateurs basés sur un modèle puissent être quelque peu incohérents, ils constituent un point de départ pour mesurer et améliorer vos prompts de manière systématique. ` ``