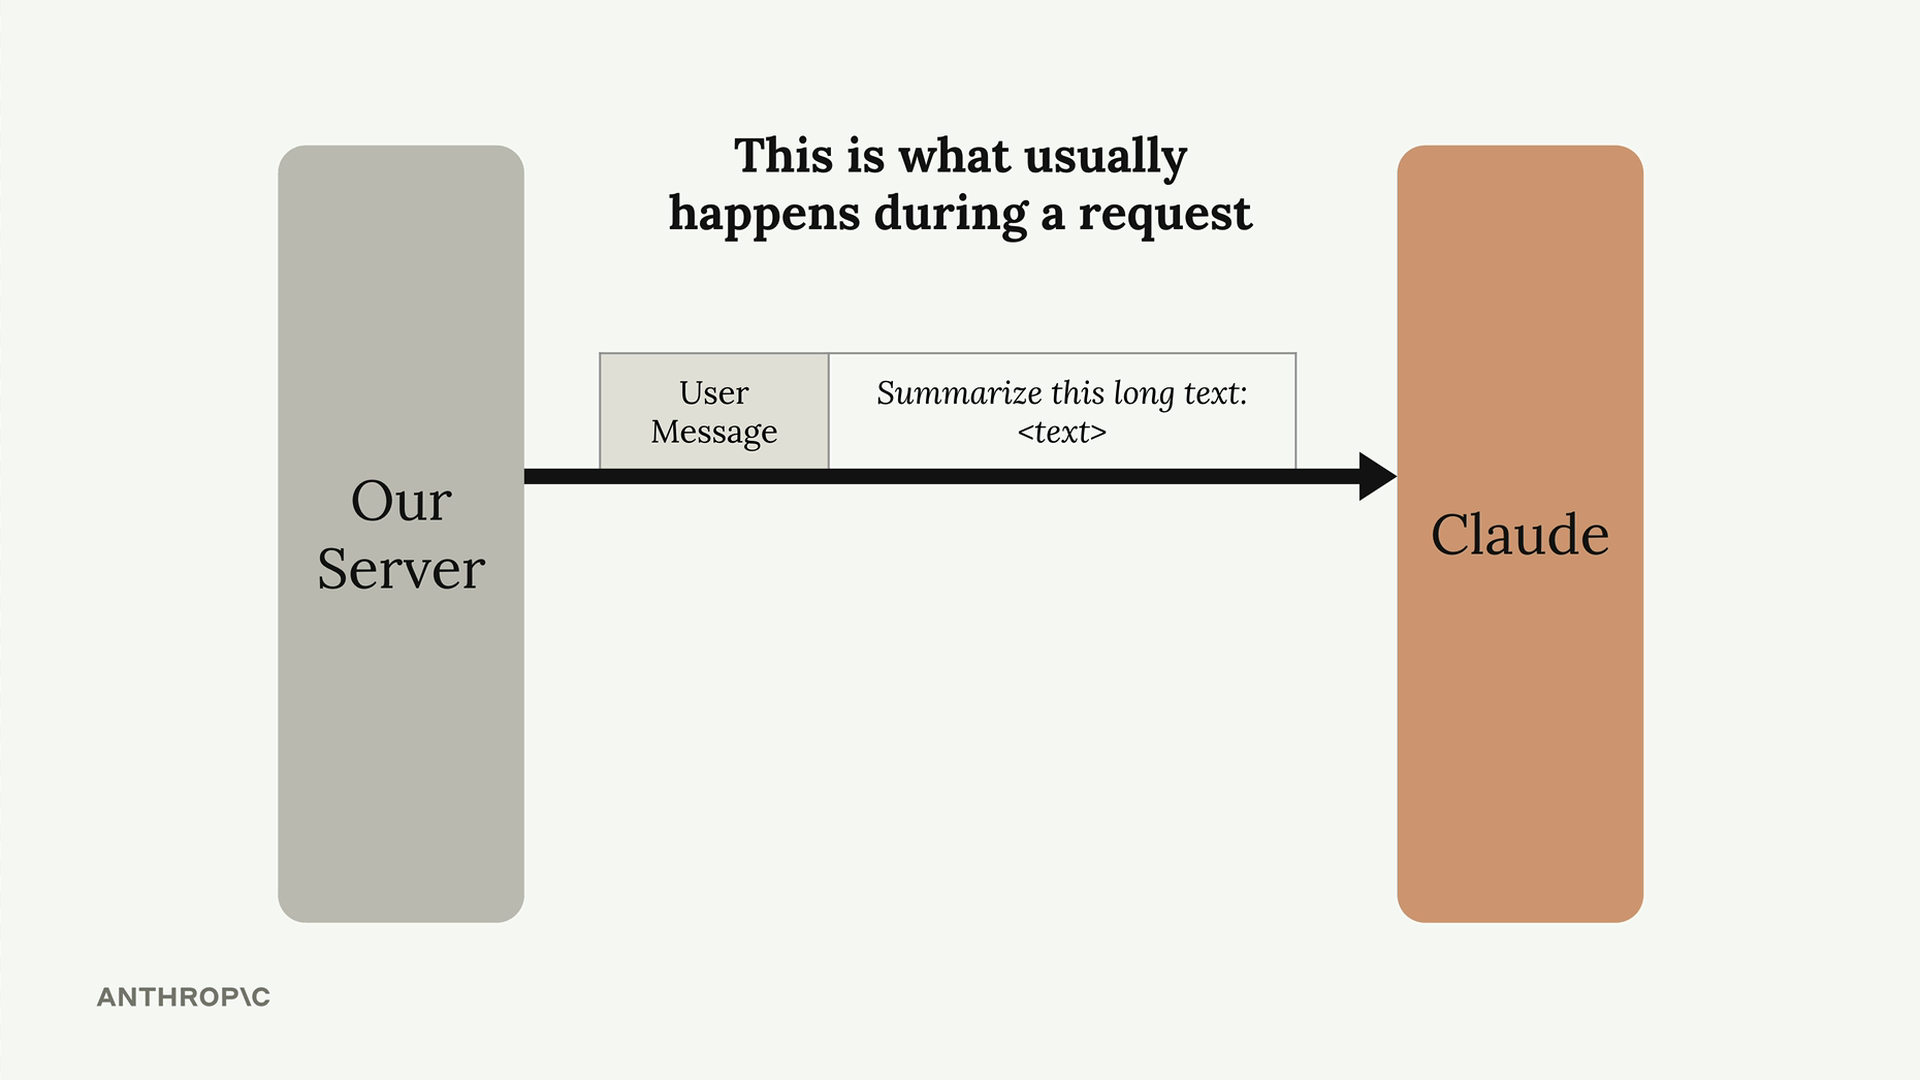
La mise en cache des prompts est une fonctionnalité qui accélère les réponses de Claude et réduit le coût de la génération de texte en réutilisant le travail de calcul effectué lors de requêtes précédentes. Pour comprendre comment cela fonctionne, examinons d'abord ce qui se passe normalement à l'intérieur de Claude lors d'une requête typique.
Comment Claude traite normalement les requêtes
Lorsque vous envoyez un message à Claude, beaucoup de choses se passent en arrière-plan avant que vous n'obteniez une réponse. Claude ne commence pas immédiatement à générer du texte - il effectue d'abord un travail approfondi sur votre message d'entrée.
Voici ce que Claude fait avec votre message :
- Tokeniser le prompt
- Créer des embeddings pour chaque token
- Ajouter du contexte basé sur le texte environnant
- Générer le texte de sortie
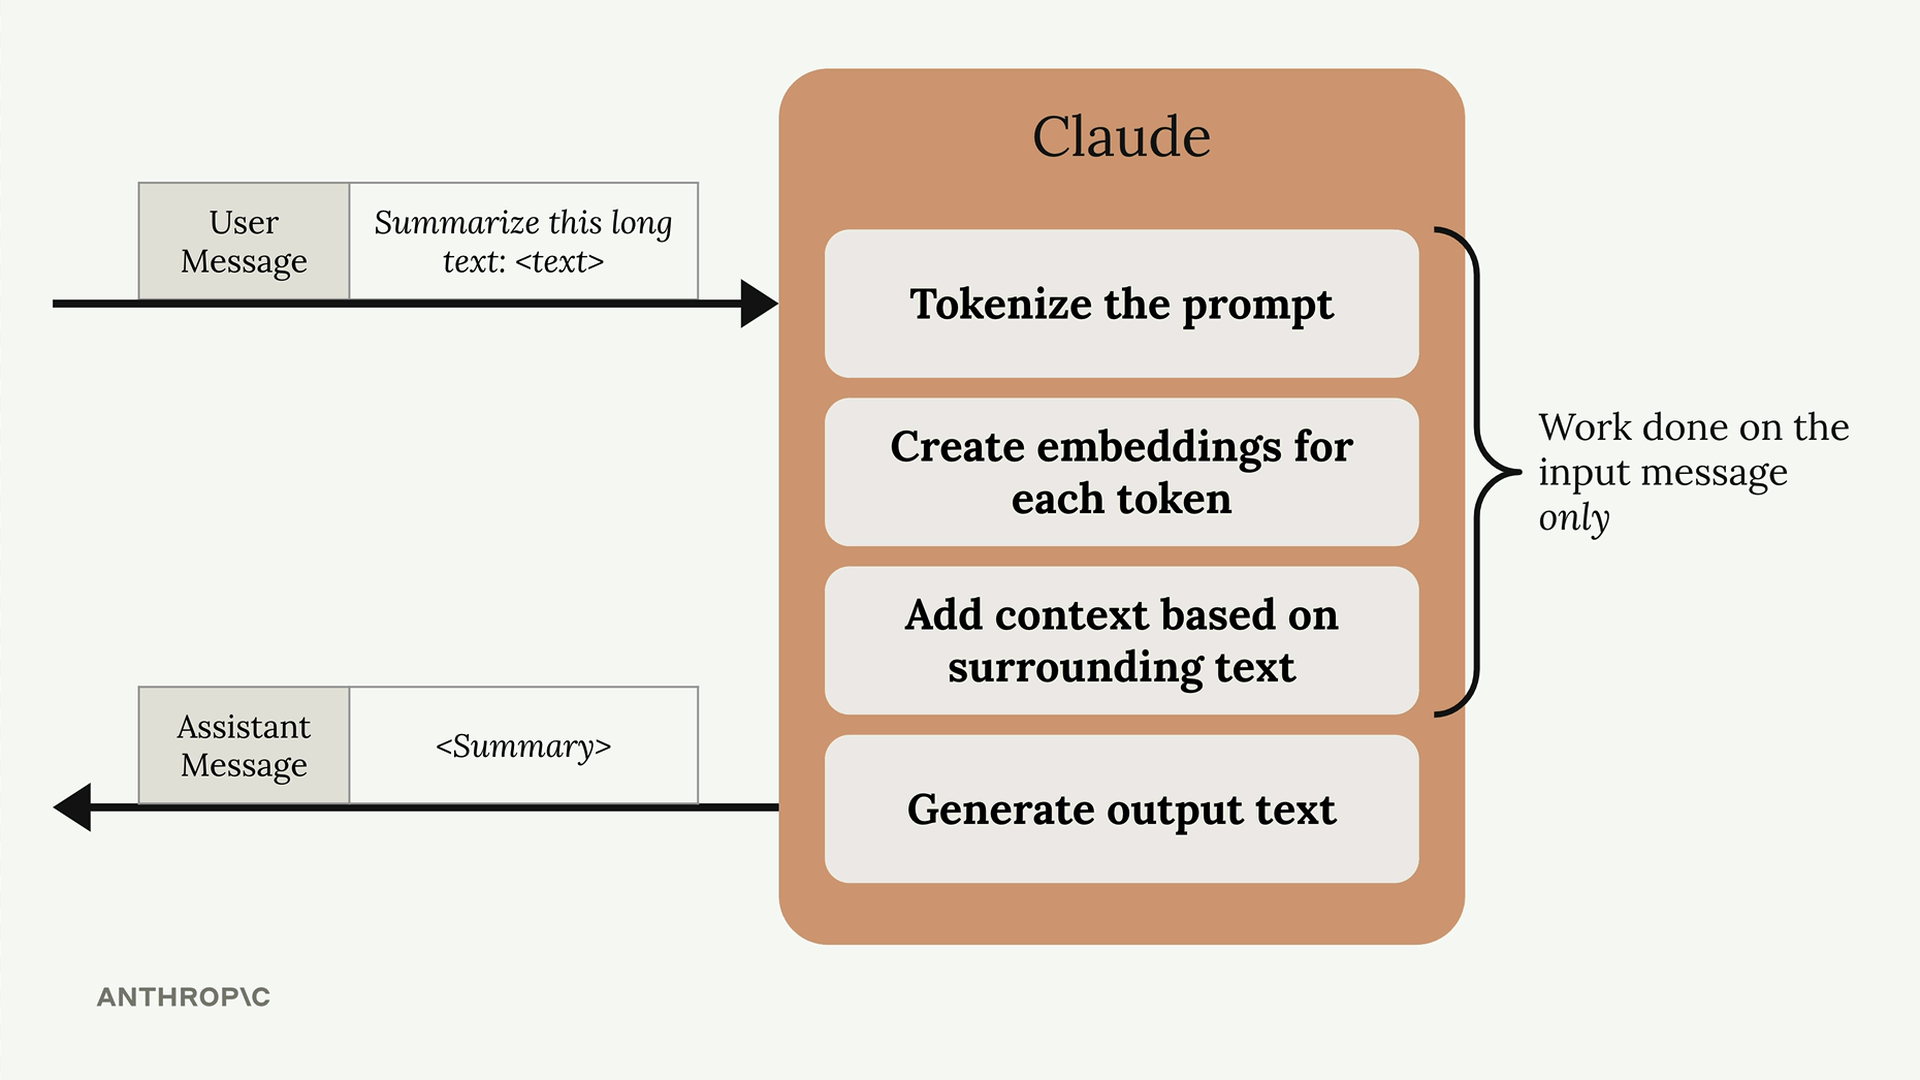
Tout ce travail de prétraitement se produit avant que Claude ne génère une réponse réelle. Une fois que Claude a terminé de traiter votre requête et renvoyé la réponse, il jette tout le travail de calcul qu'il vient d'effectuer.
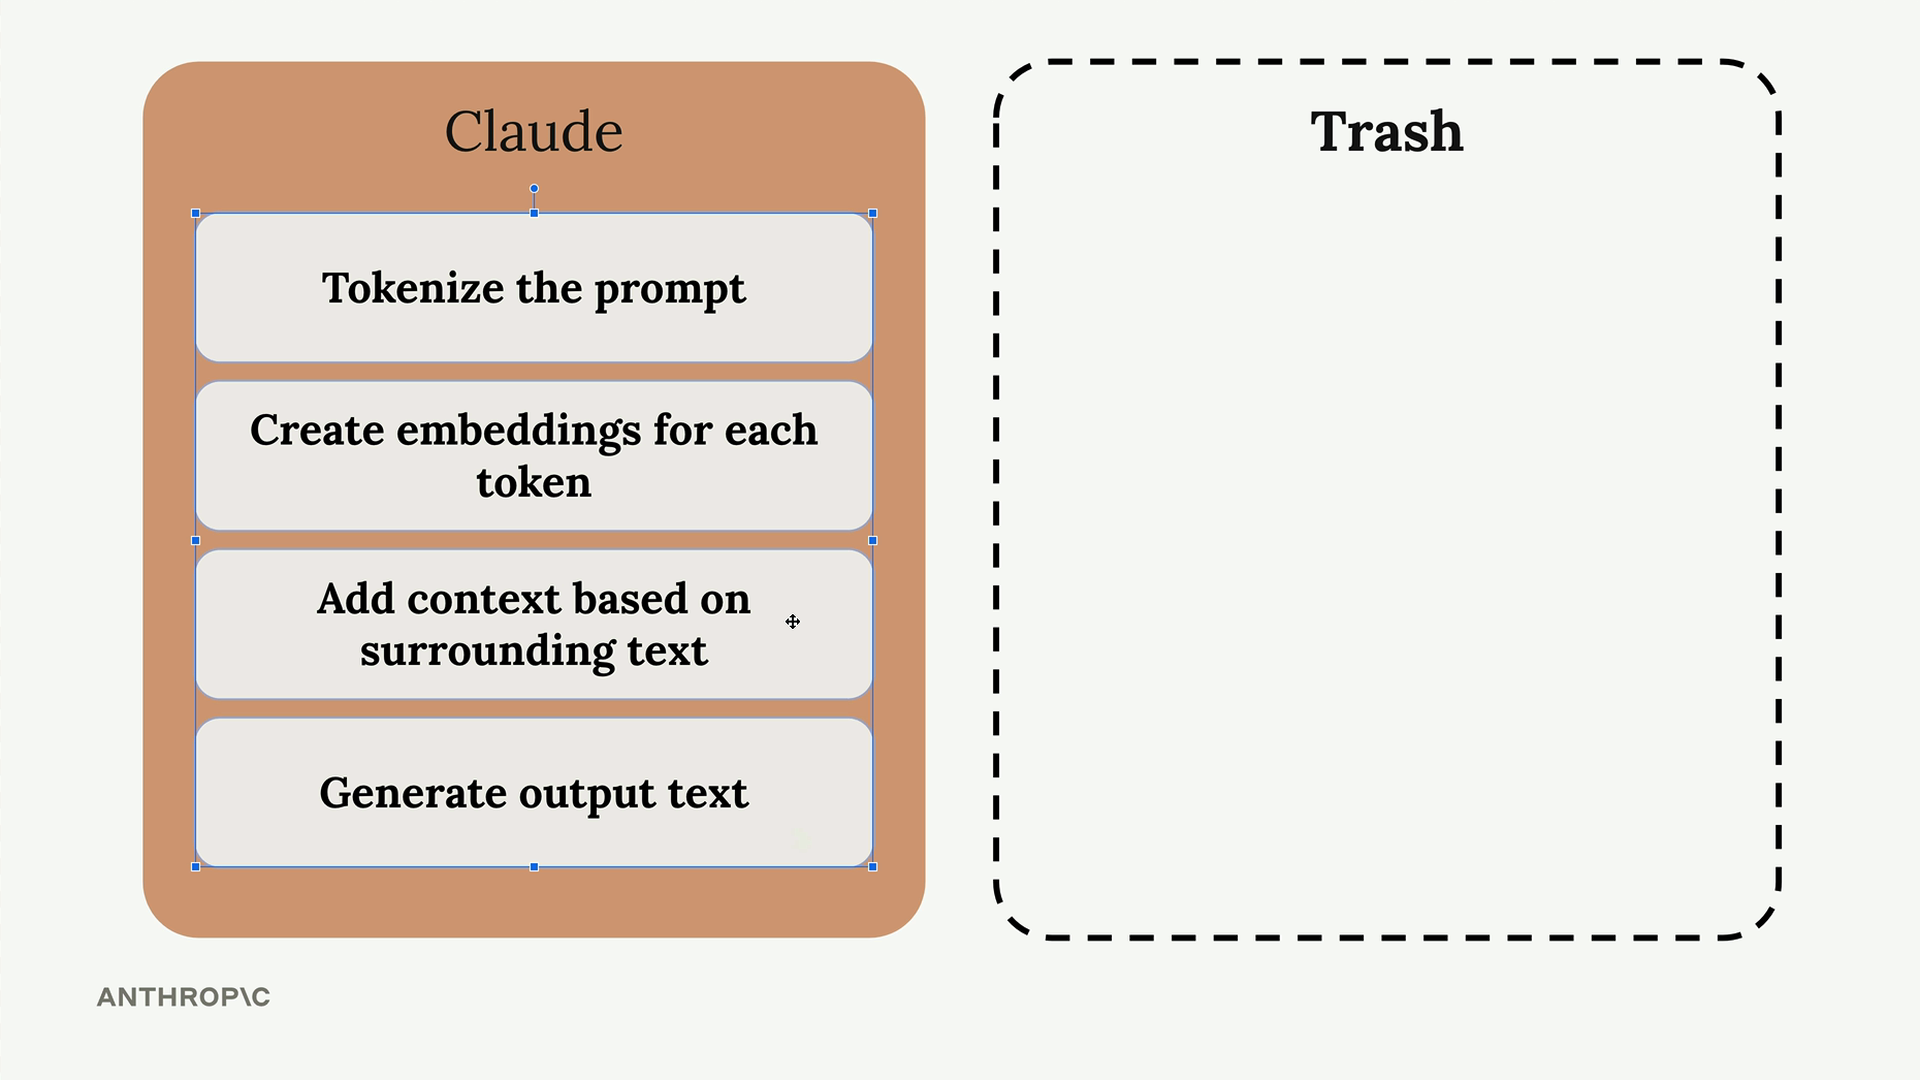
Le problème de jeter le travail effectué
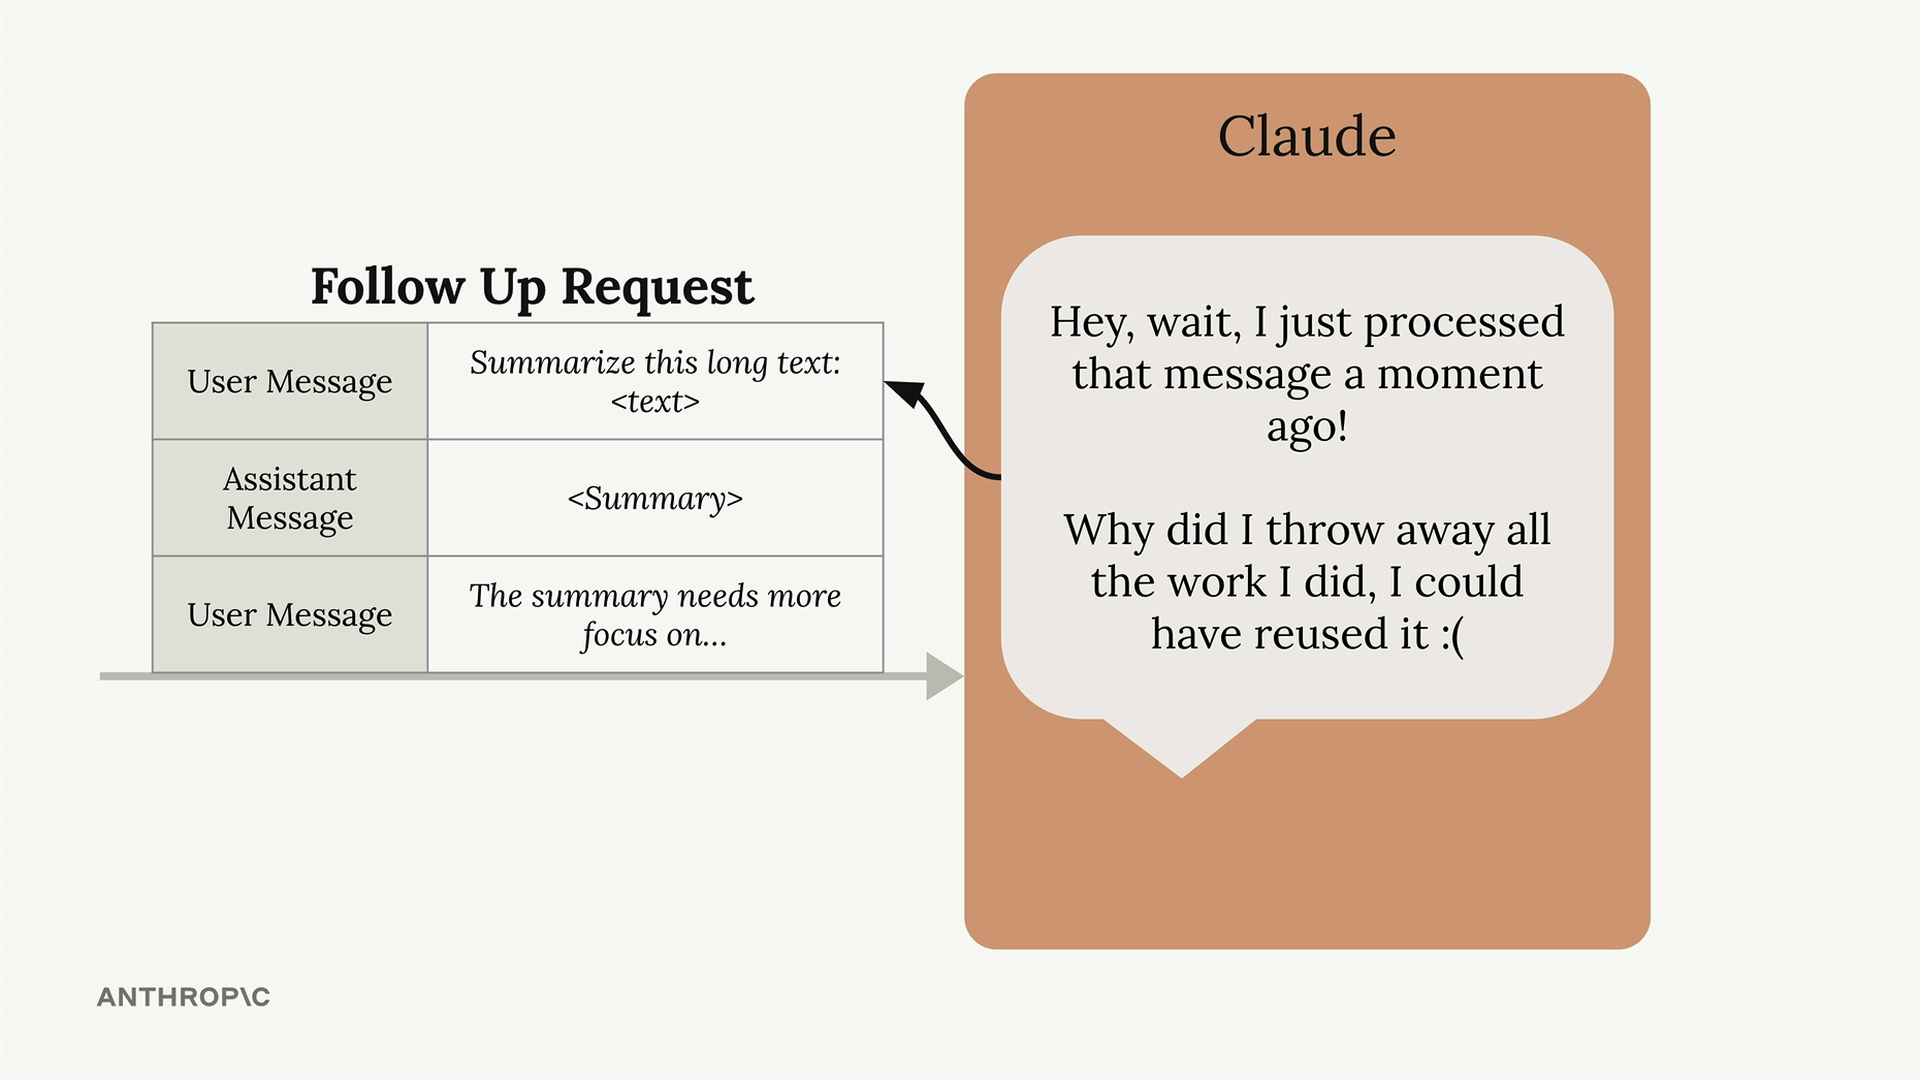
Cela crée une inefficacité lorsque vous avez des conversations avec Claude. Supposons que vous fassiez une requête de suivi qui inclut le même message qu'auparavant, plus la réponse précédente de Claude, plus un nouveau message pour poursuivre la conversation.
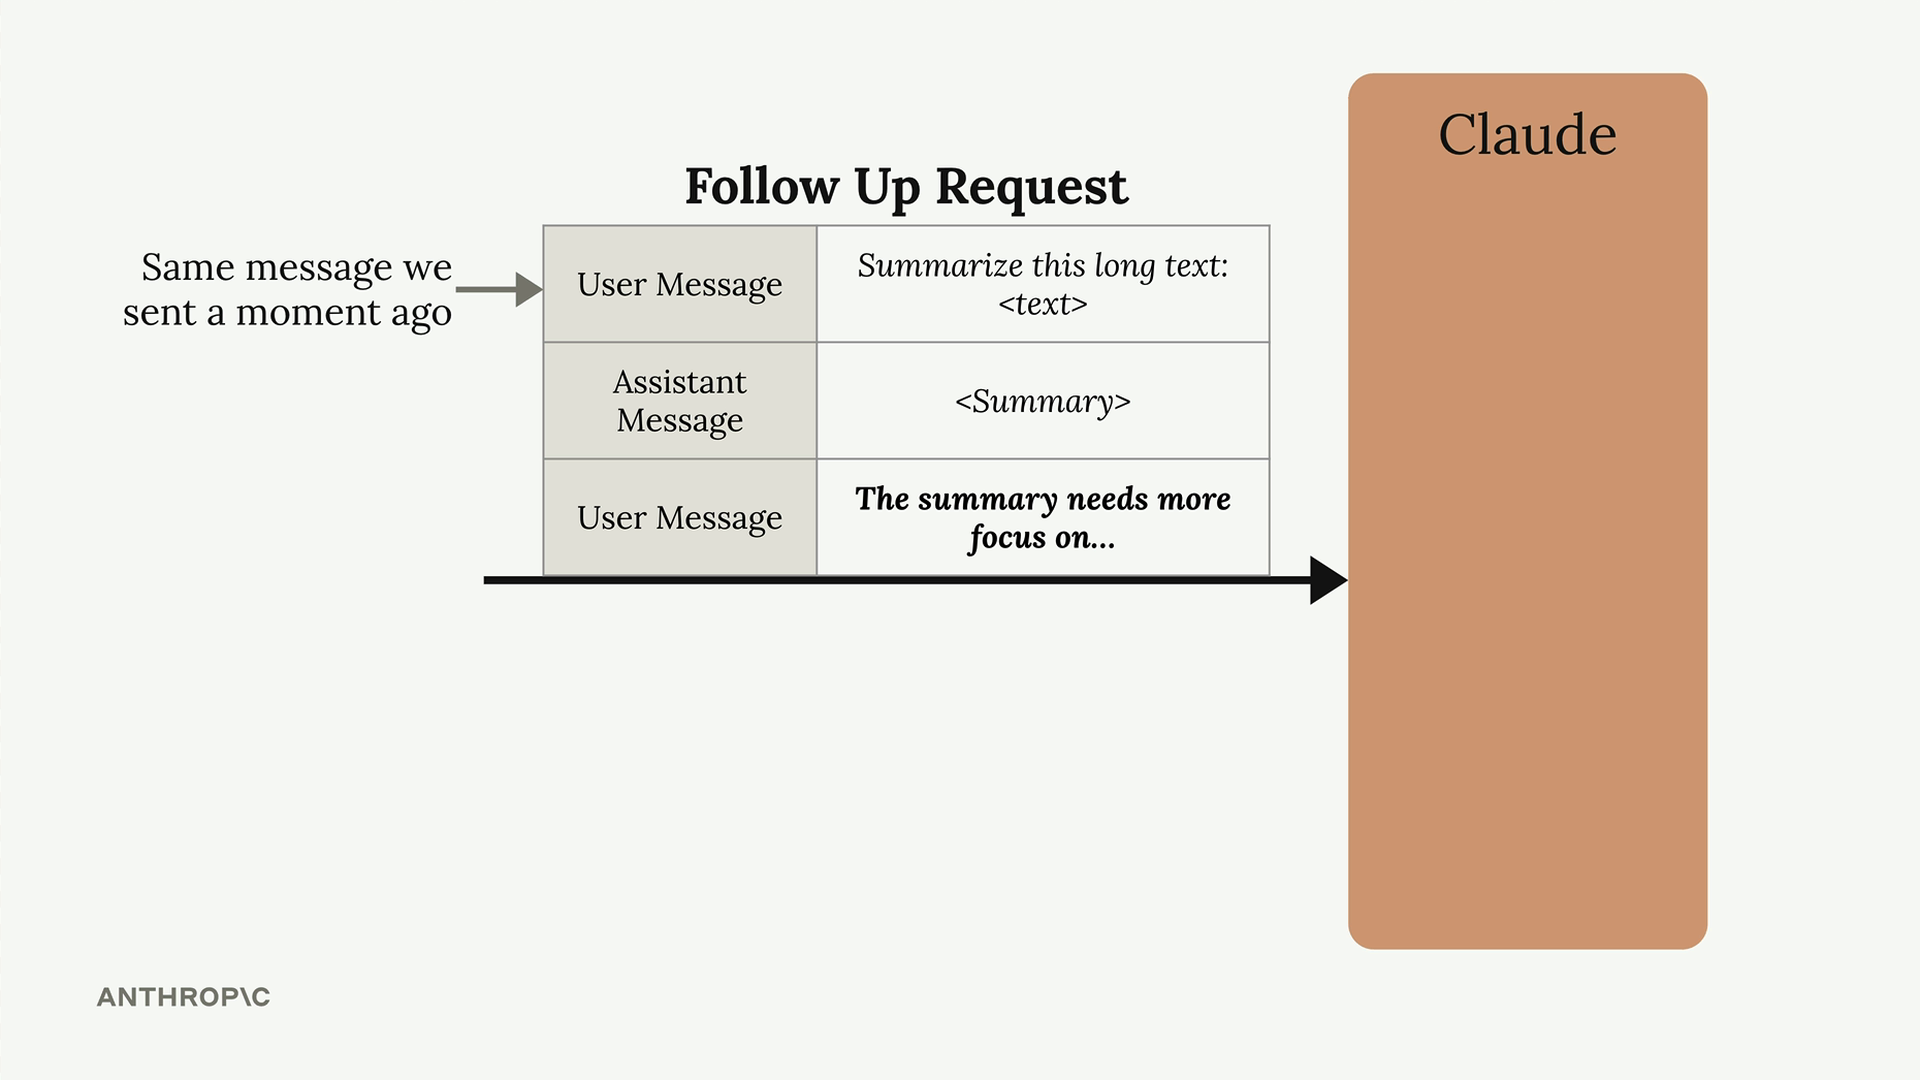
Lorsque Claude voit à nouveau ce message original, il doit refaire tout le même travail de calcul qu'il vient de jeter quelques instants plus tôt. Claude pense essentiellement : « Je viens de traiter exactement ce message et d'effectuer tout ce travail, puis je l'ai jeté. Maintenant, je dois tout refaire. »
Comment la mise en cache des prompts résout ce problème
La mise en cache des prompts résout cette inefficacité en sauvegardant le travail de calcul au lieu de le jeter. Voici comment cela fonctionne :
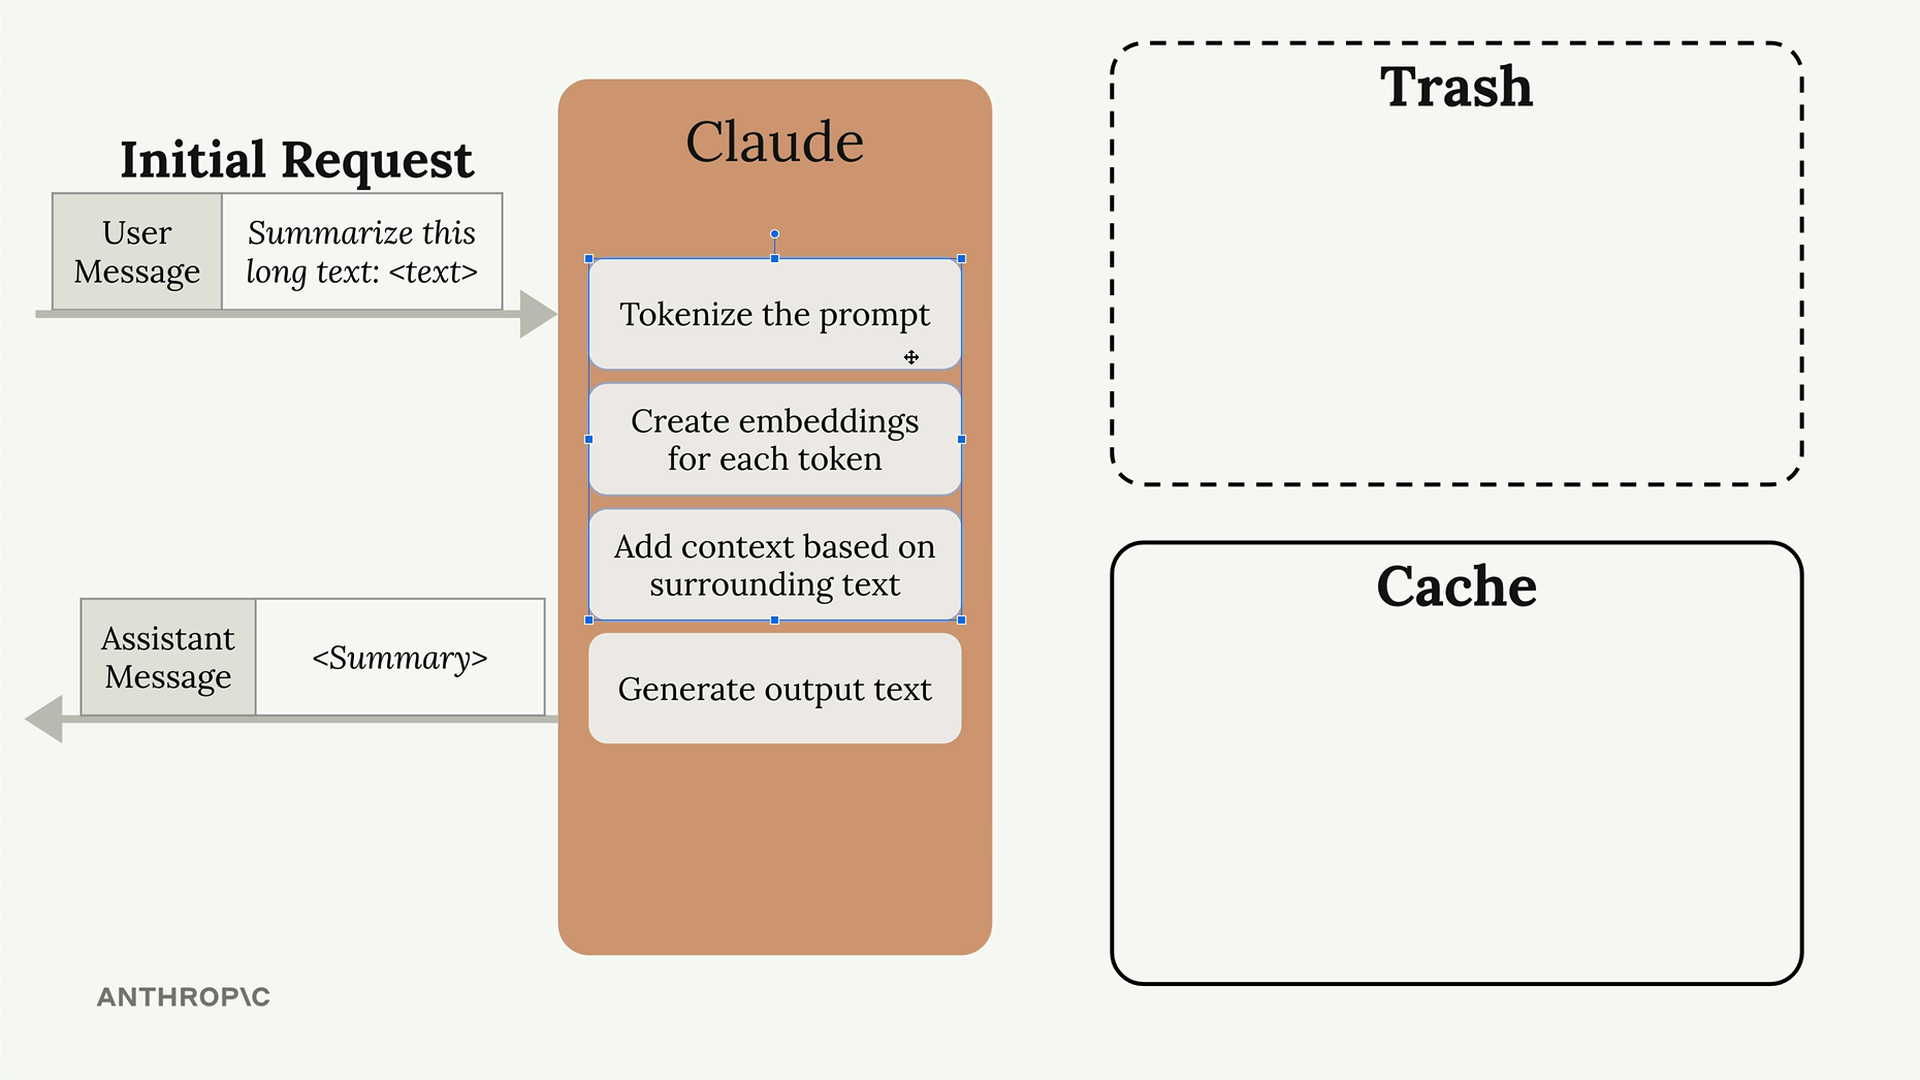
Lorsque Claude traite votre requête initiale, au lieu de jeter tout le travail de prétraitement, il stocke ce travail dans un cache. Le cache agit comme une table de correspondance qui associe des messages d'entrée spécifiques à leurs résultats de calcul correspondants.
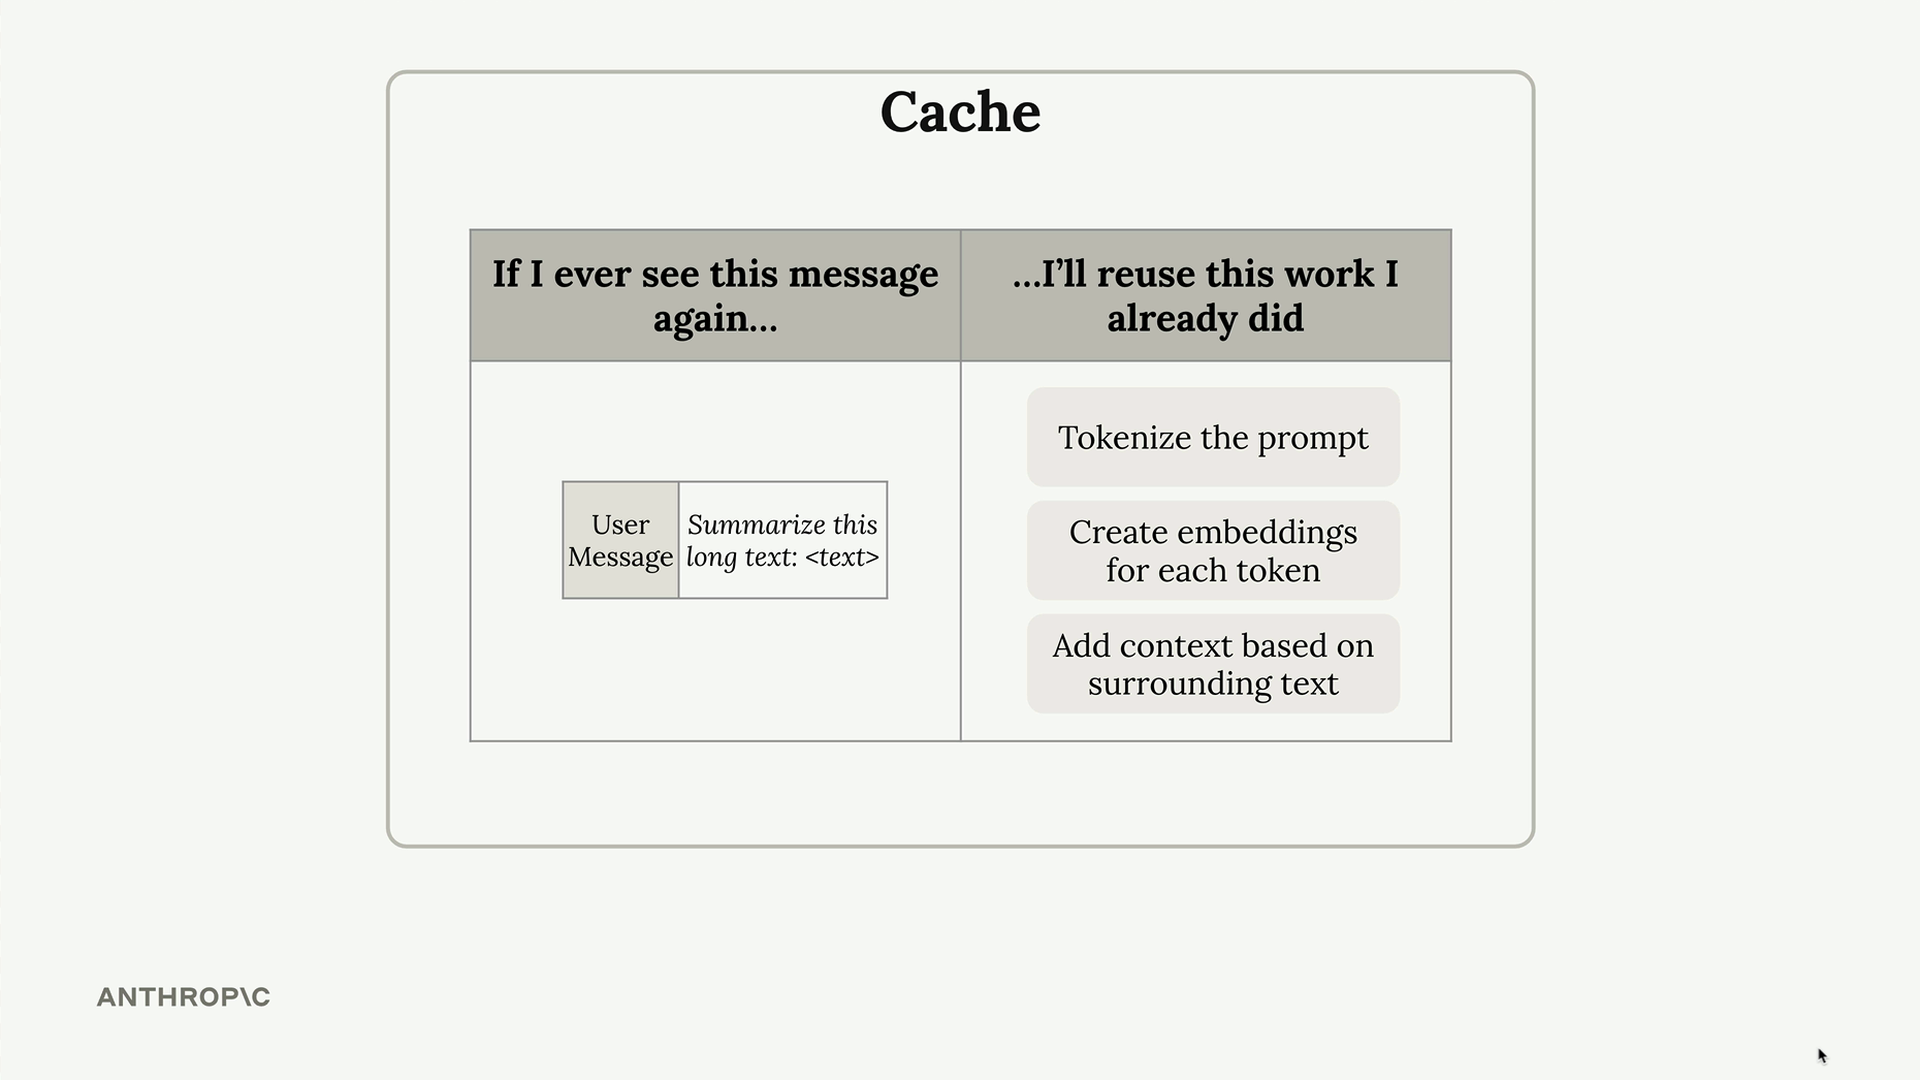
Lorsque vous effectuez une requête de suivi qui inclut le même contenu, Claude peut vérifier son cache et réutiliser le travail précédent au lieu de repartir de zéro.
Avantages et limites clés
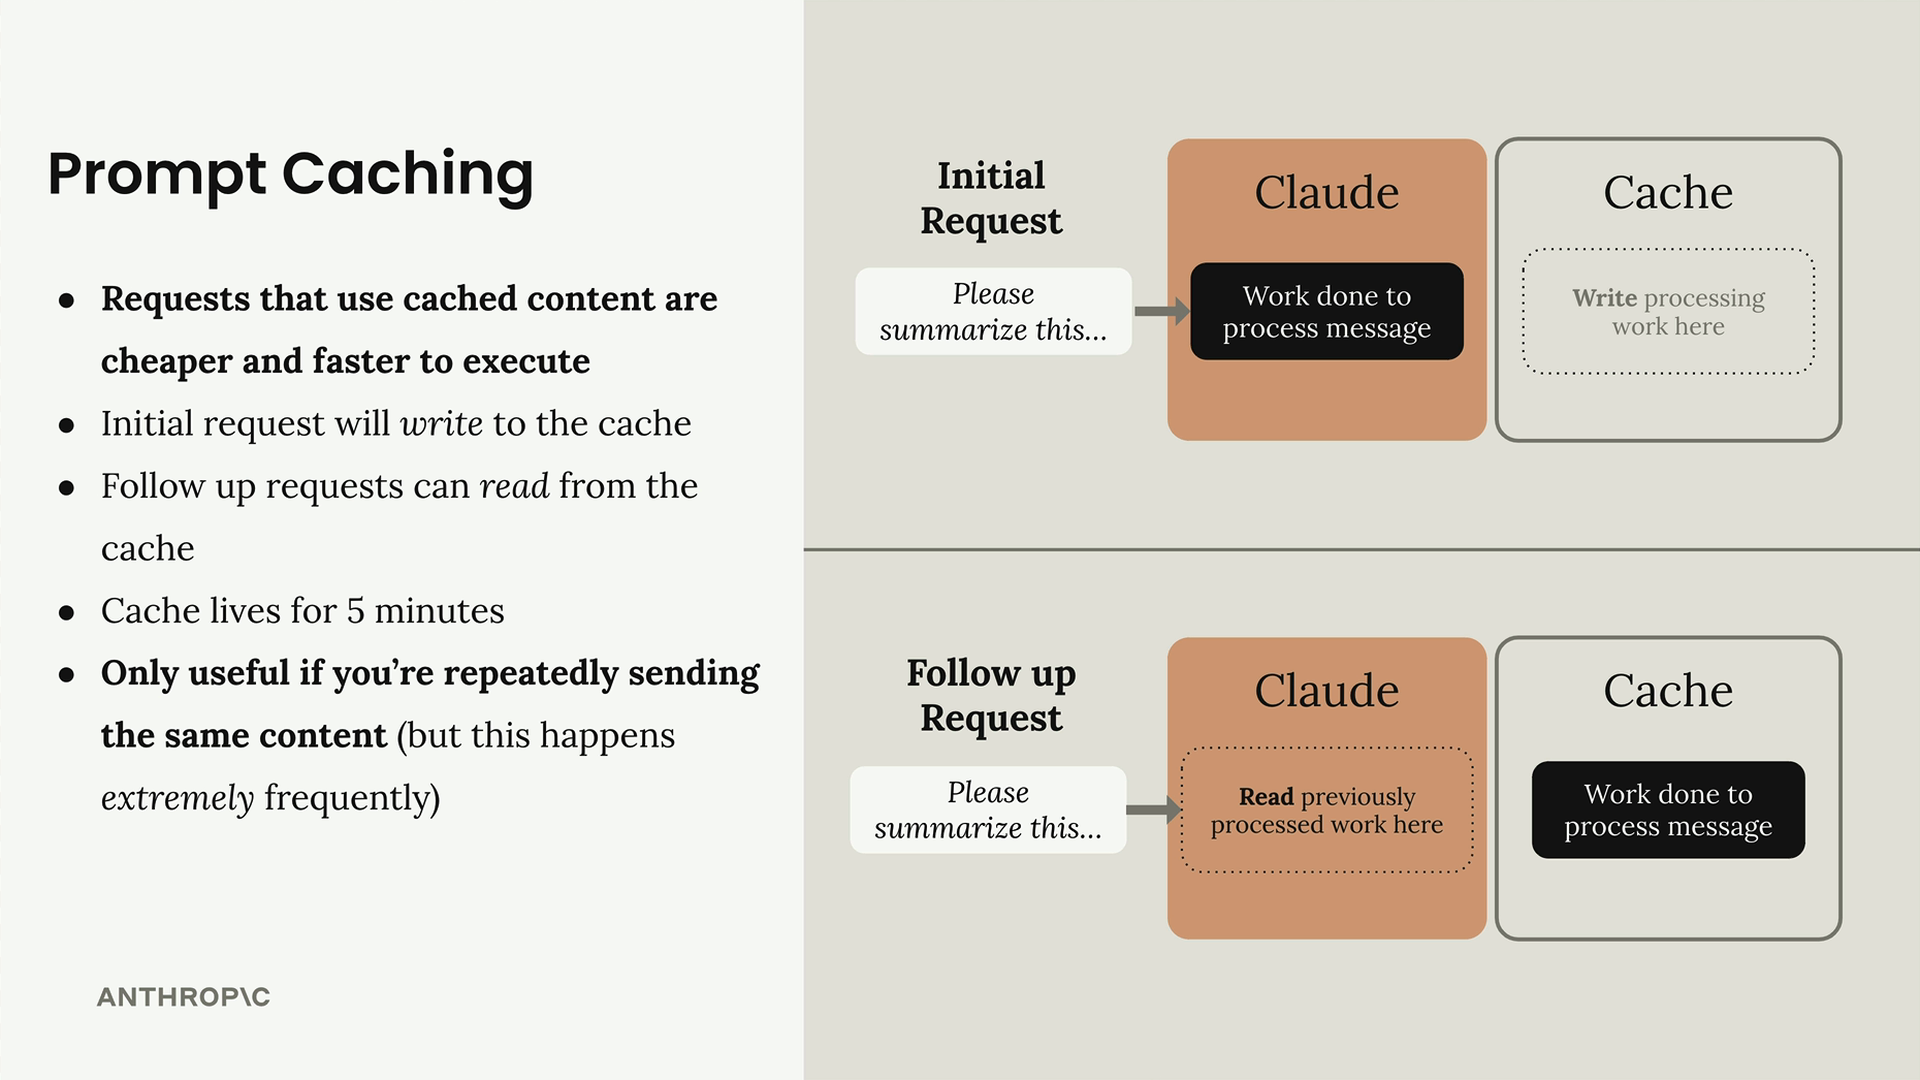
La mise en cache des prompts offre plusieurs avantages :
- Les requêtes qui utilisent du contenu mis en cache sont moins coûteuses et plus rapides à exécuter
- La requête initiale écrira dans le cache
- Les requêtes de suivi peuvent lire depuis le cache
- Le cache vit pendant 5 minutes
- Utile uniquement si vous envoyez de manière répétée le même contenu (mais cela se produit extrêmement fréquemment)
Le cache a une durée de vie de 5 minutes, il est donc particulièrement bénéfique pour les conversations ou les flux de travail où vous effectuez plusieurs requêtes avec du contenu qui se chevauche dans un court délai. Ce schéma est en fait très courant dans les applications réelles - pensez aux chatbots, aux outils d'analyse de documents, ou à tout système qui maintient le contexte d'une conversation.
La mise en cache des prompts est particulièrement précieuse car de nombreuses applications d'IA envoient de manière répétée le même contenu. Qu'il s'agisse d'invites système, d'historique de conversation, ou de grands documents en cours d'analyse, le même texte apparaît souvent dans plusieurs requêtes au sein d'une session.