Ce tutoriel démontre l'implémentation complète du RAG (Retrieval-Augmented Generation) à l'aide d'un exemple pratique. Nous allons construire une base de données vectorielle à partir de zéro et exécuter les cinq étapes du flux de travail RAG en utilisant un exemple de document de rapport.
Configuration de la base de données vectorielle
L'implémentation utilise une classe personnalisée VectorIndex qui gère le stockage des embeddings et l'exécution de recherches de similarité. Cette classe fournit la fonctionnalité de base dont nous avons besoin pour nos opérations de base de données vectorielle.
L'implémentation RAG en cinq étapes
Étape 1 : Découper le texte par section
Tout d'abord, nous chargeons et découpons notre document source en utilisant la même approche de découpage basée sur les sections que précédemment :
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
Cela divise notre rapport en sections logiques qui peuvent être traitées indépendamment.
Étape 2 : Générer des embeddings pour chaque extrait
Ensuite, nous créons des embeddings pour chaque extrait en utilisant une compréhension de liste :
embeddings = [generate_embedding(chunk) for chunk in chunks]Cette étape implique plusieurs appels API, elle prend donc un certain temps à se terminer. Chaque extrait est converti en une représentation vectorielle numérique.
Étape 3 : Stocker les embeddings dans la base de données vectorielle
Maintenant, nous créons notre magasin vectoriel et le remplissons à la fois avec les embeddings et leur texte associé :
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
L'idée clé ici est que nous stockons à la fois l'embedding et le texte original. Obtenir simplement une liste de nombres n'est pas utile - nous avons besoin du contenu textuel réel qui correspond à ces embeddings. Ces métadonnées nous permettent de récupérer des résultats significatifs par la suite.
Étape 4 : Générer l'embedding de la requête utilisateur
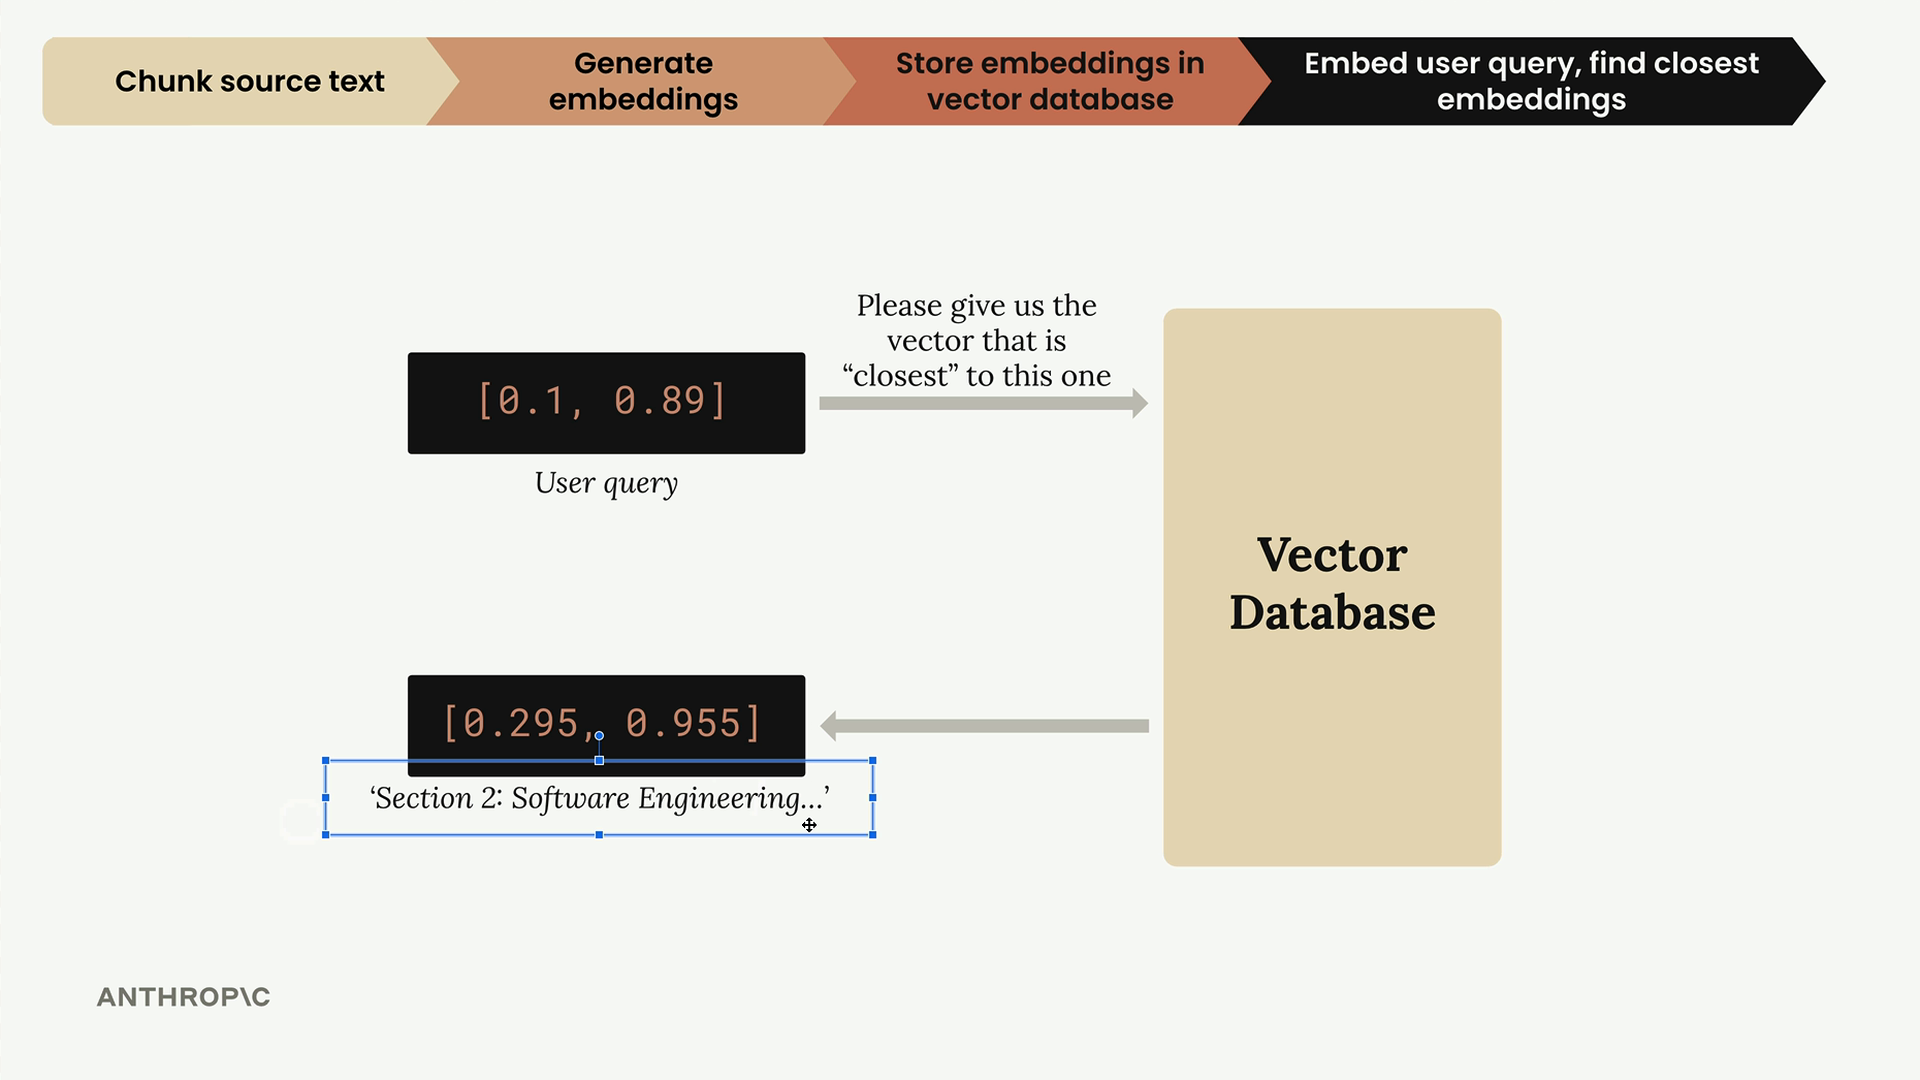
Lorsqu'un utilisateur pose une question, nous la convertissons au même format d'embedding :
user_embedding = generate_embedding("What did the software engineering dept do last year?")Cela crée une représentation vectorielle de la question de l'utilisateur qui peut être comparée à nos embeddings stockés.
Étape 5 : Rechercher et récupérer les extraits pertinents
Enfin, nous effectuons une recherche dans notre magasin vectoriel pour trouver le contenu le plus similaire :
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Cela renvoie les deux extraits les plus pertinents ainsi que leurs scores de distance cosinus. Des distances plus faibles indiquent une similarité plus élevée.
Comprendre les résultats
La recherche renvoie des résultats classés par pertinence. Dans notre exemple, la section sur l'ingénierie logicielle avait la distance la plus faible (0,71), ce qui en fait la correspondance la plus pertinente. La section sur la méthodologie arrivait en deuxième position avec une distance de 0,72.
La métrique de distance vous aide à comprendre le degré de confiance du système quant à la pertinence de chaque résultat. Des distances plus proches signifient de meilleures correspondances avec la requête de l'utilisateur.
Pourquoi stocker le texte avec les embeddings
Une décision de conception cruciale consiste à stocker le texte original aux côtés de chaque embedding. Sans cela, vous n'obtiendriez que des tableaux de nombres, qui ne sont pas utiles pour générer des réponses. En incluant le texte source, vous pouvez immédiatement utiliser les extraits récupérés pour fournir du contexte à votre modèle de langage.
Cela complète le flux de travail RAG de base, bien qu'il existe des optimisations et des améliorations supplémentaires qui peuvent améliorer les performances dans des scénarios réels.