Le découpage de texte est l'une des étapes les plus critiques dans la construction d'un pipeline RAG (Retrieval Augmented Generation). La façon dont vous découpez vos documents a un impact direct sur la qualité de l'ensemble de votre système. Une mauvaise stratégie de découpage peut conduire à l'insertion de contexte non pertinent dans vos invites, ce qui amène votre IA à donner des réponses complètement erronées.
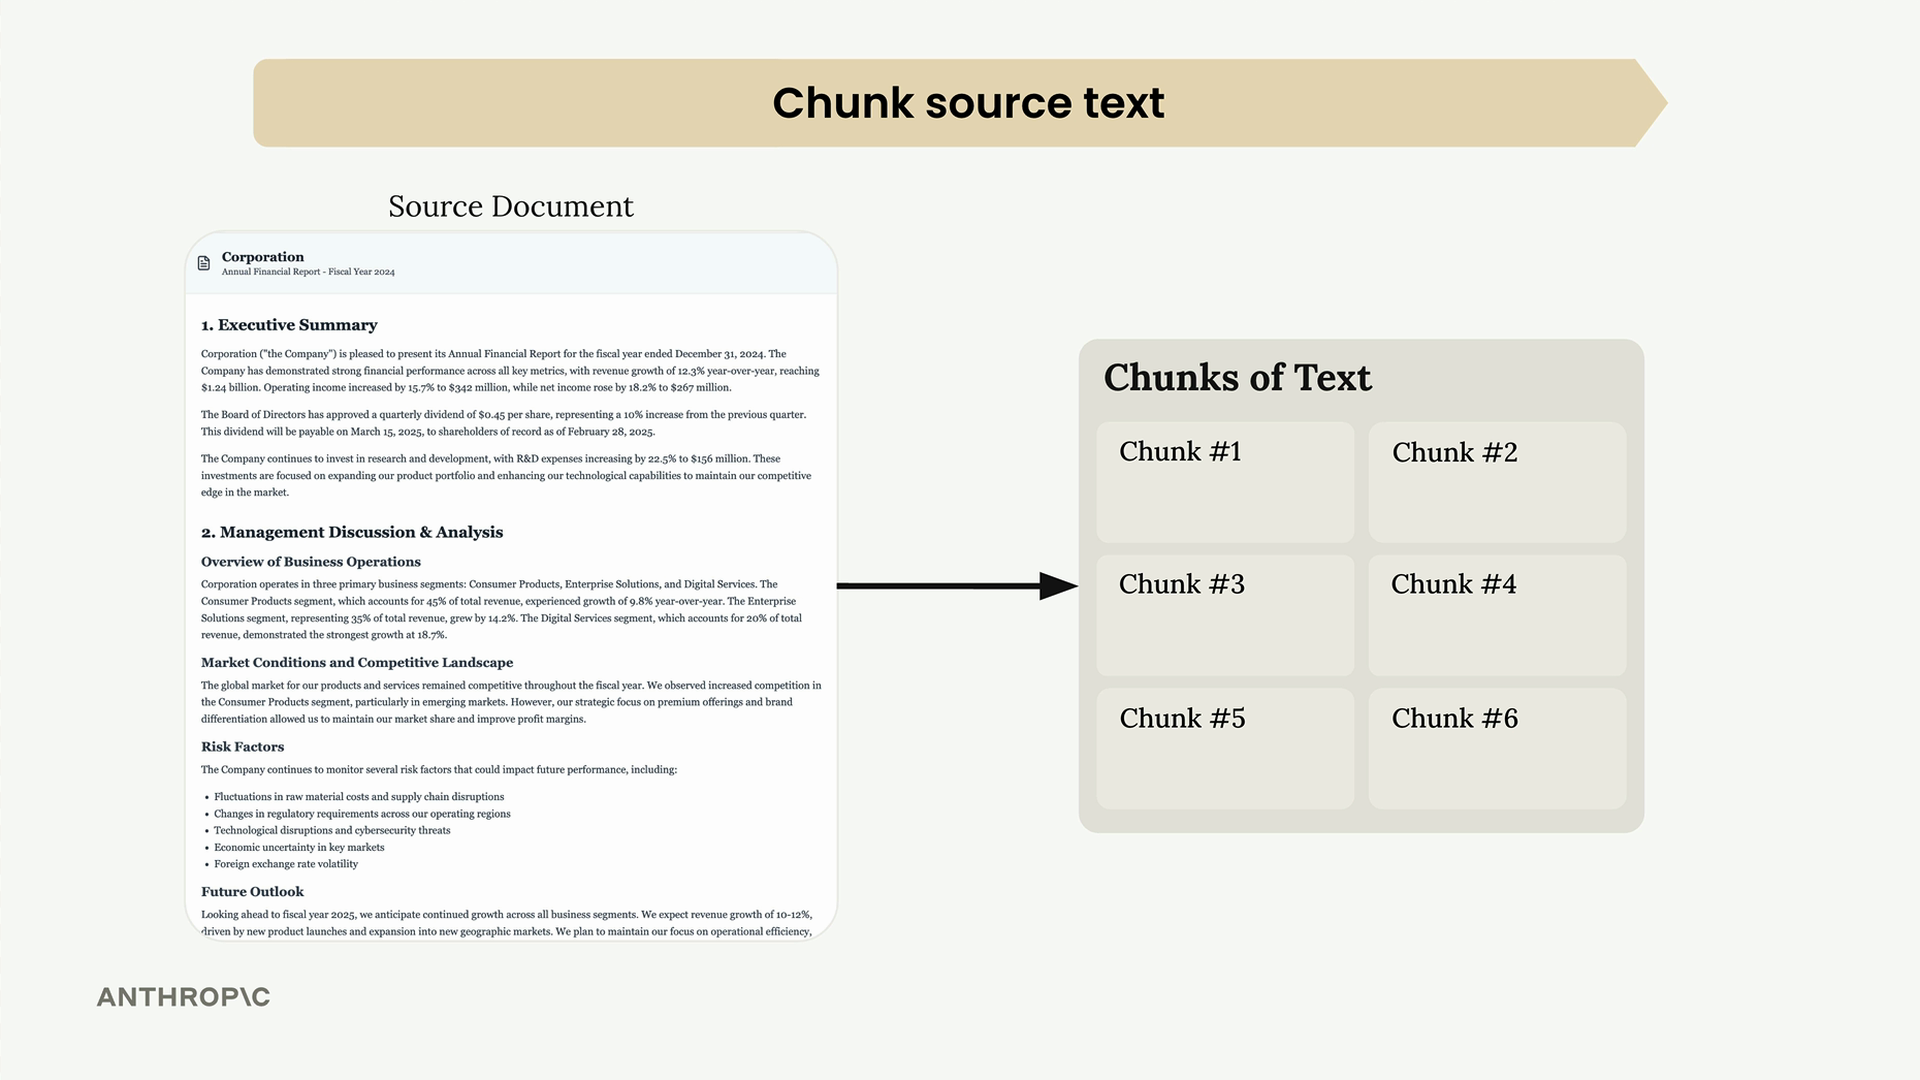
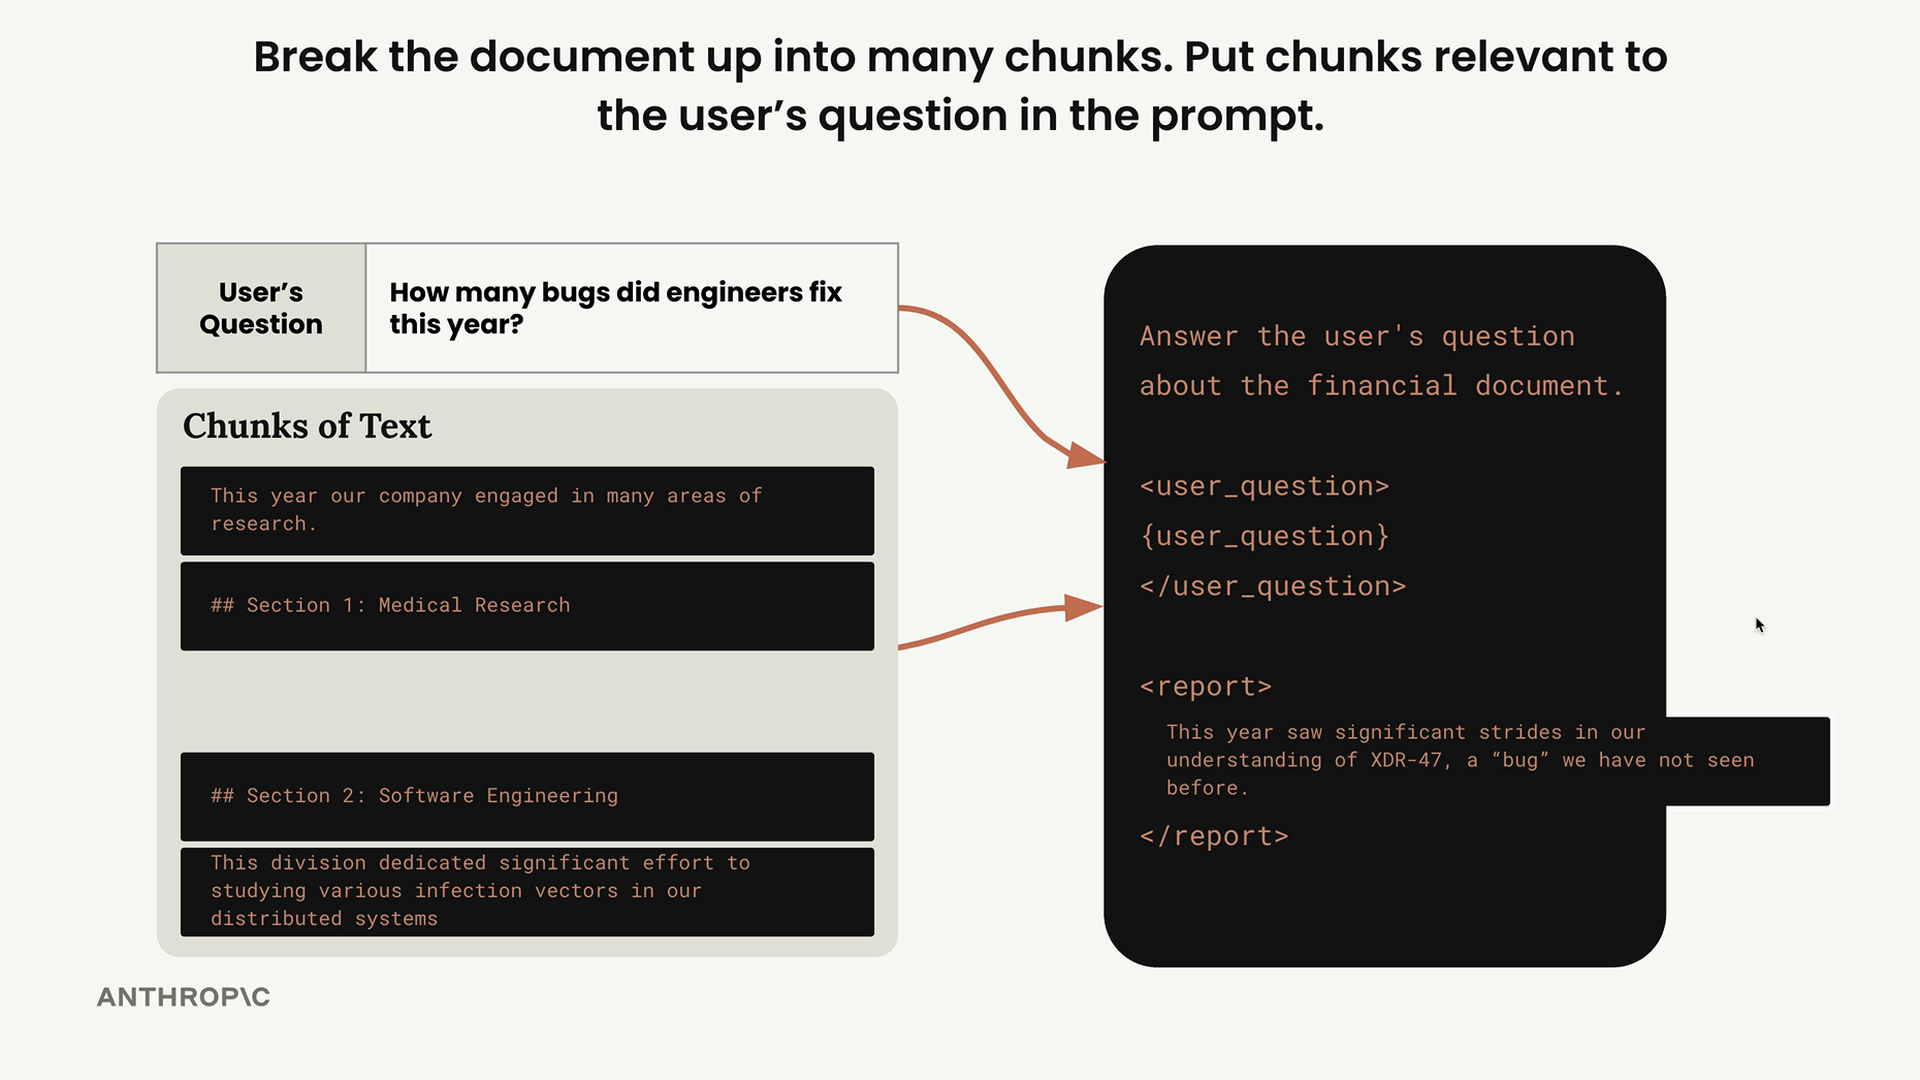
Prenons cet exemple : vous avez un document avec des sections sur la recherche médicale et l'ingénierie logicielle. Si vous découpez mal, un utilisateur demandant « Combien de bugs les ingénieurs ont-ils corrigés cette année ? » pourrait obtenir des informations sur la recherche médicale au lieu de l'ingénierie logicielle, simplement parce que la section médicale contenait le mot « bug » dans un contexte différent.
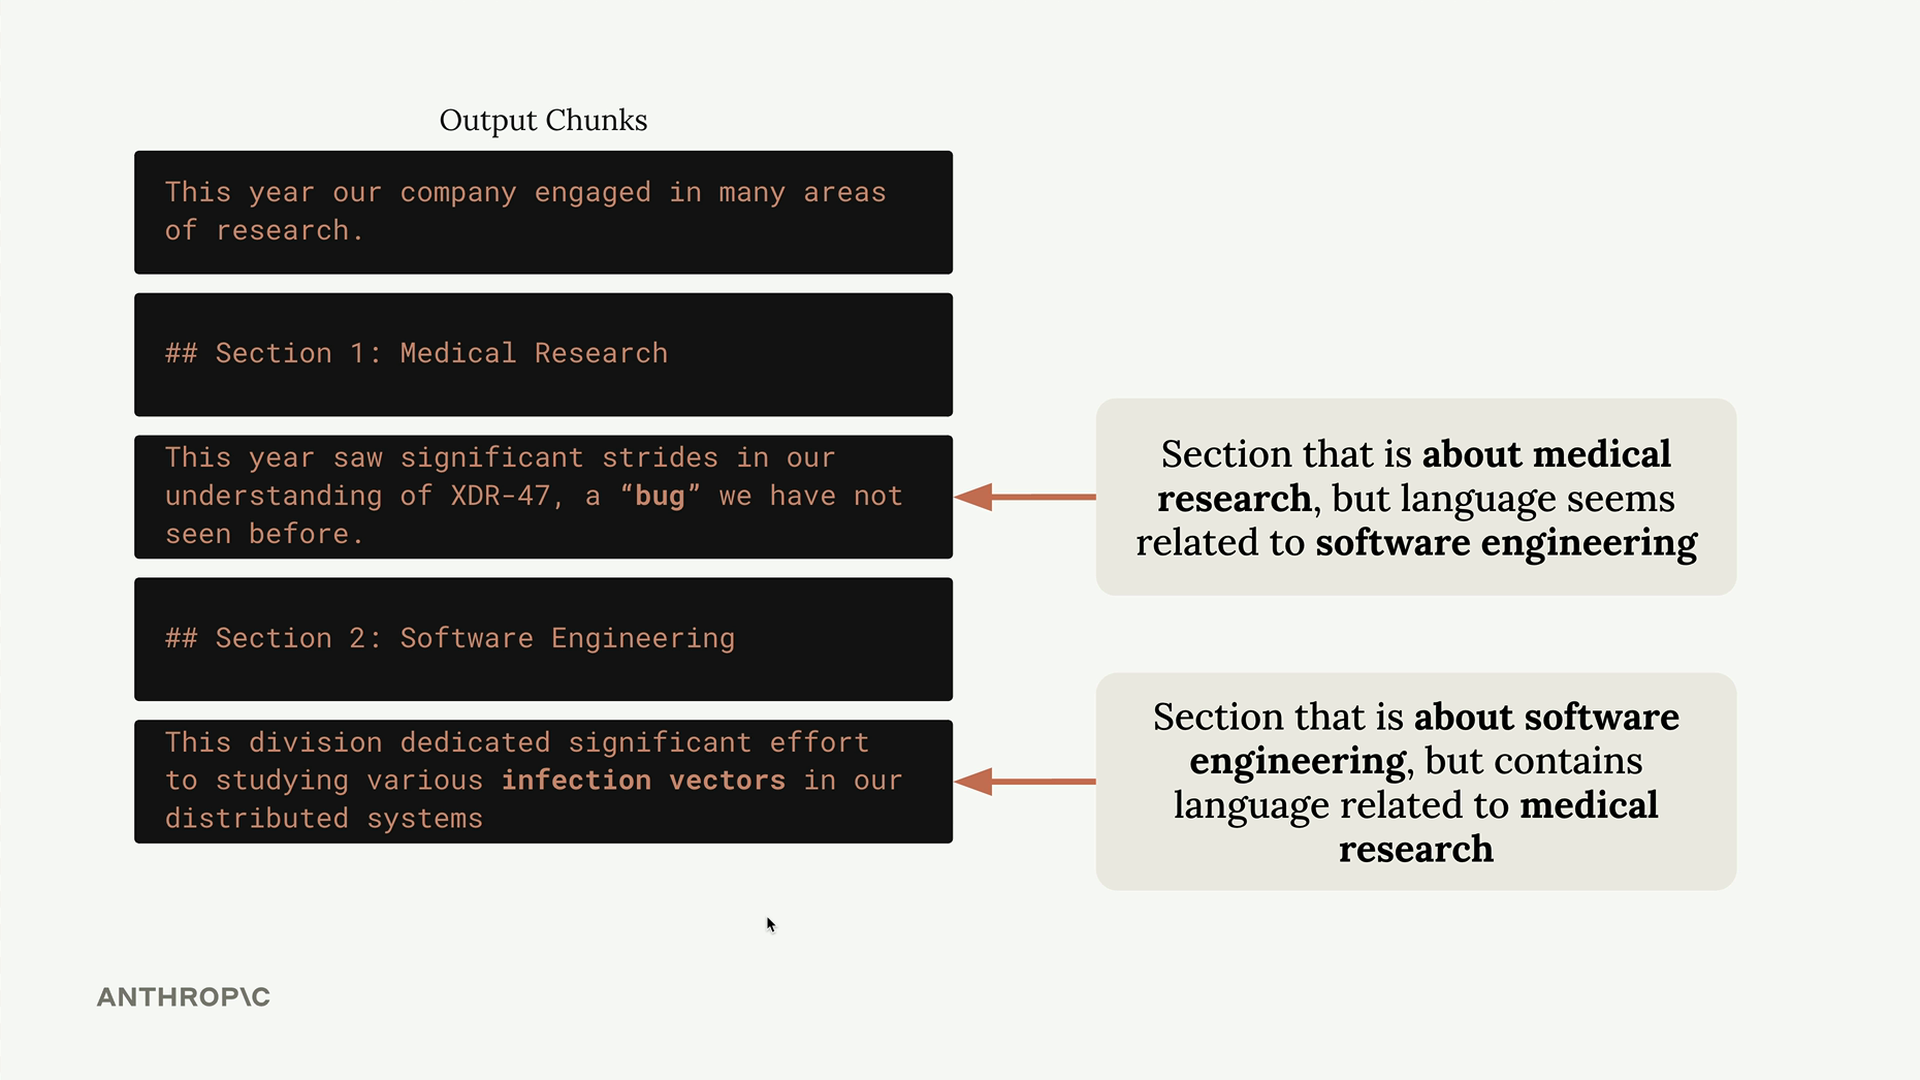
Cela démontre pourquoi la stratégie de découpage est si importante. L'objectif est de créer des segments qui maintiennent une cohérence sémantique et fournissent un contexte utile lorsqu'ils sont récupérés.
Trois stratégies principales de découpage
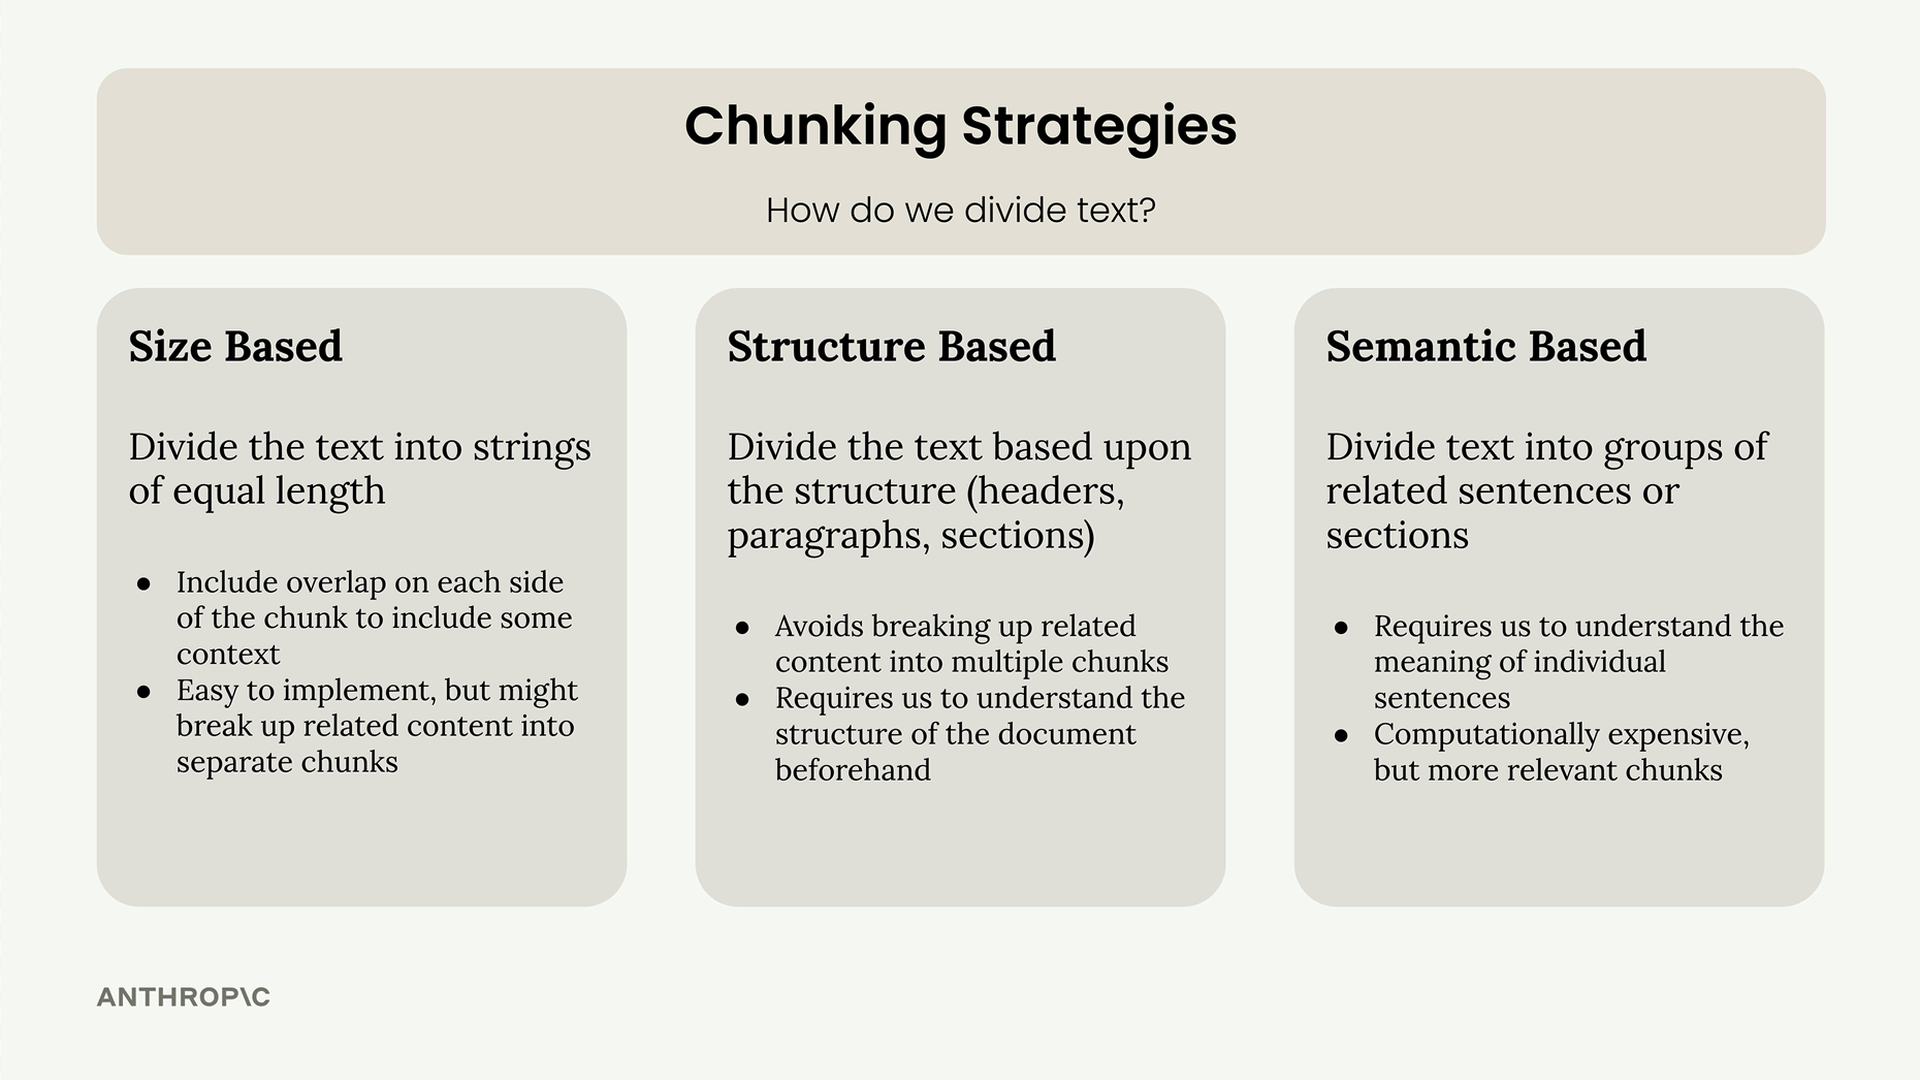
Il existe trois approches principales pour diviser le texte en segments :
- Basé sur la taille : Diviser le texte en chaînes de longueur égale
- Basé sur la structure : Diviser en fonction de la structure du document (en-têtes, paragraphes, sections)
- Basé sur la sémantique : Regrouper des phrases ou sections liées en utilisant des techniques de TAL (traitement automatique du langage)
Découpage basé sur la taille
Le découpage basé sur la taille est l'approche la plus simple. Vous divisez simplement votre document en segments de longueur approximativement égale en caractères ou en mots. C'est facile à mettre en œuvre et cela fonctionne de manière fiable sur différents types de documents.
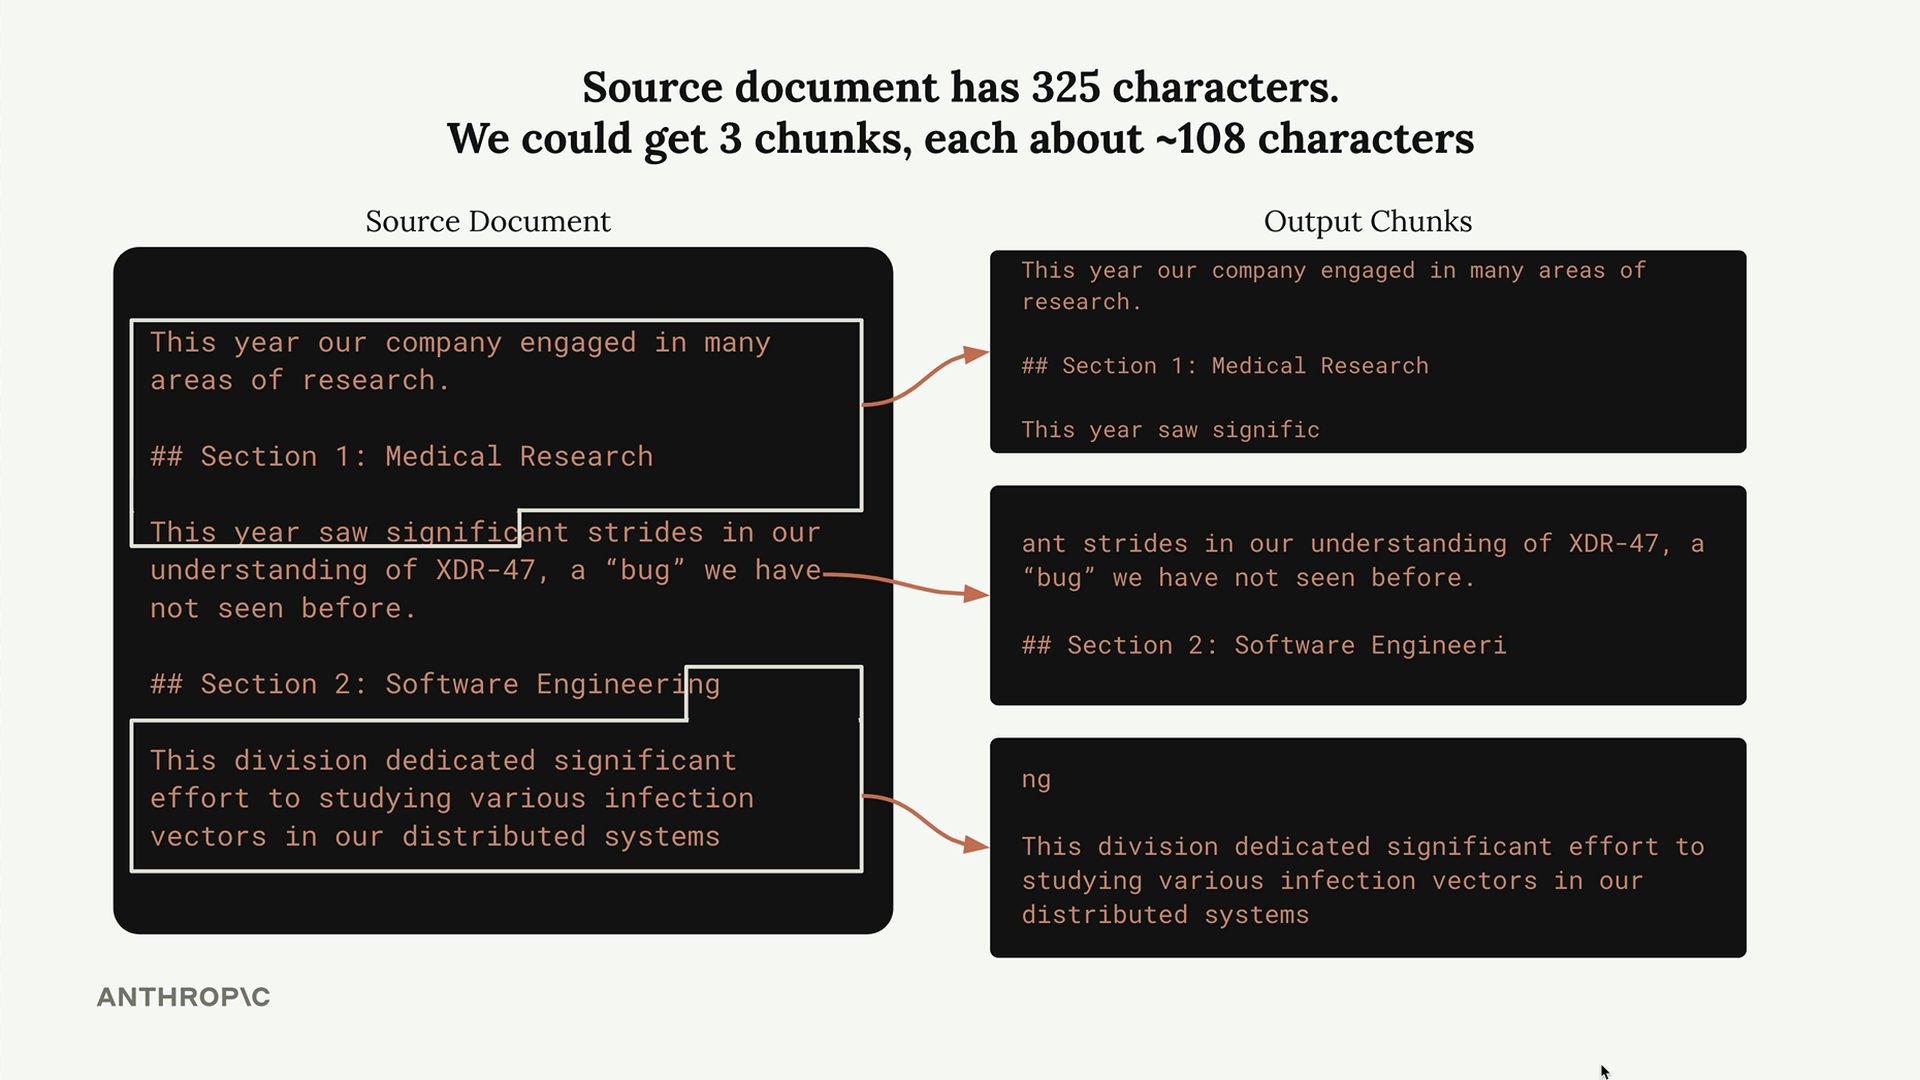
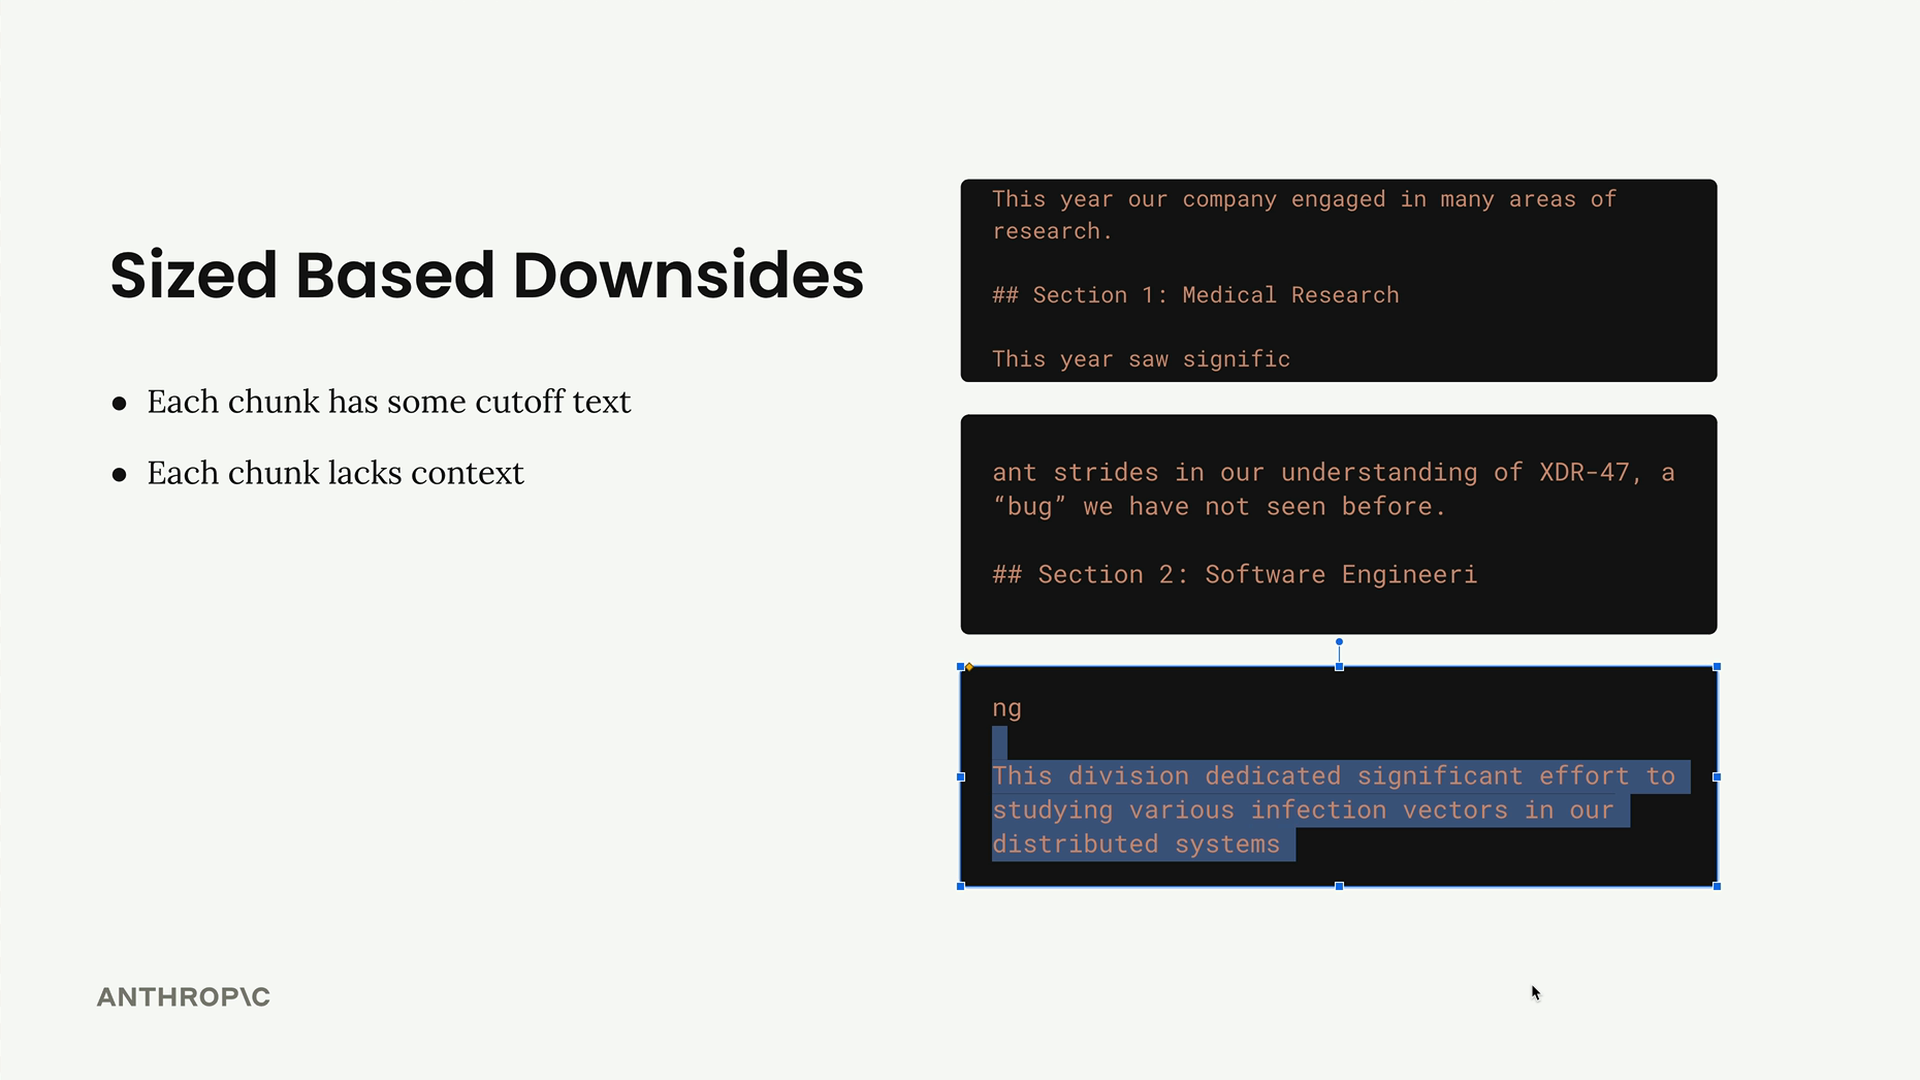
Cependant, cette approche présente des inconvénients évidents :
- Les mots sont coupés en plein milieu d'une phrase
- Les segments perdent un contexte important provenant du texte environnant
- Le contenu lié peut être divisé entre plusieurs segments
Ajout de chevauchement
Pour résoudre le problème de contexte, vous pouvez mettre en œuvre une stratégie de chevauchement. Chaque segment inclut certains caractères des segments voisins, fournissant un contexte supplémentaire et garantissant que les informations importantes ne sont pas perdues aux limites des segments.
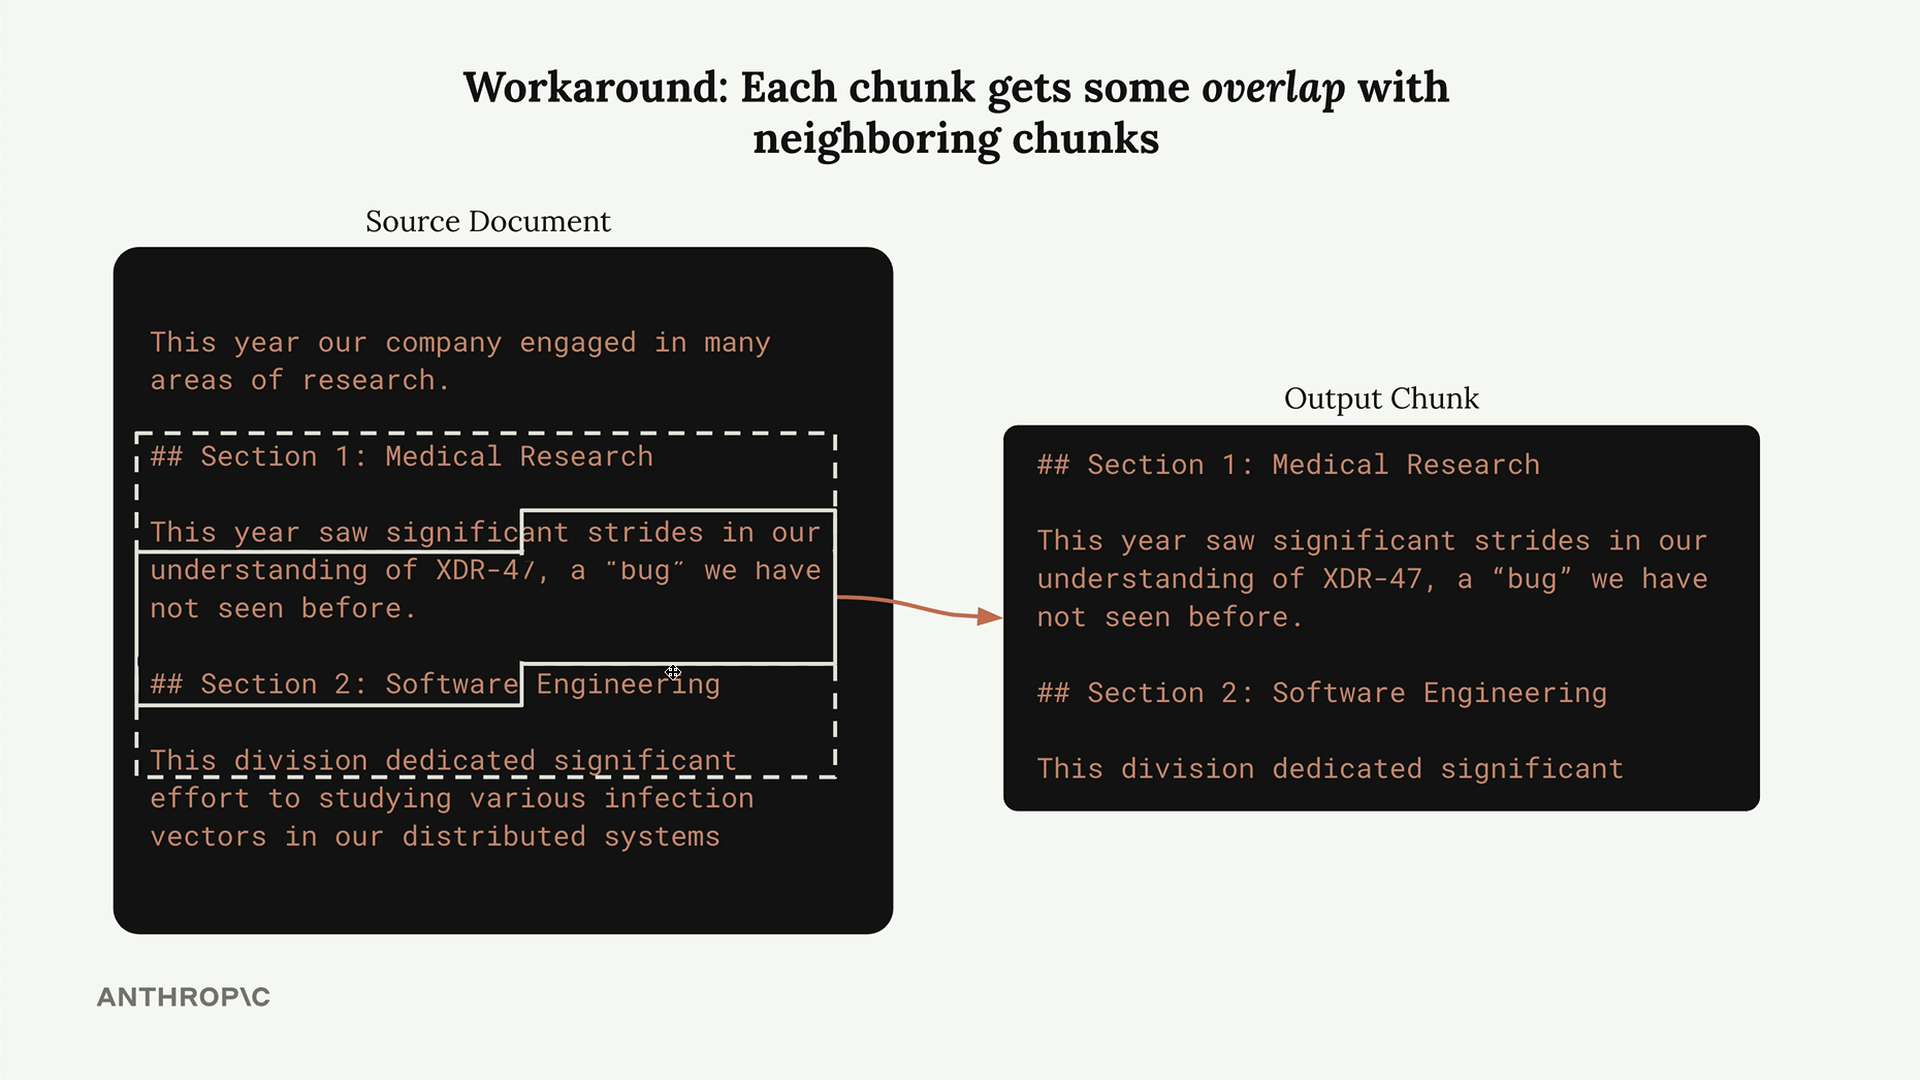
Bien que cela crée une certaine duplication, le compromis en vaut généralement la peine pour le contexte amélioré que reçoit chaque segment.
Découpage basé sur la structure
Lorsque vos documents ont un formatage cohérent (comme du markdown avec des en-têtes clairs), le découpage basé sur la structure peut produire d'excellents résultats. Vous divisez selon des éléments structurels comme les en-têtes, créant des segments qui s'alignent avec l'organisation naturelle du document.
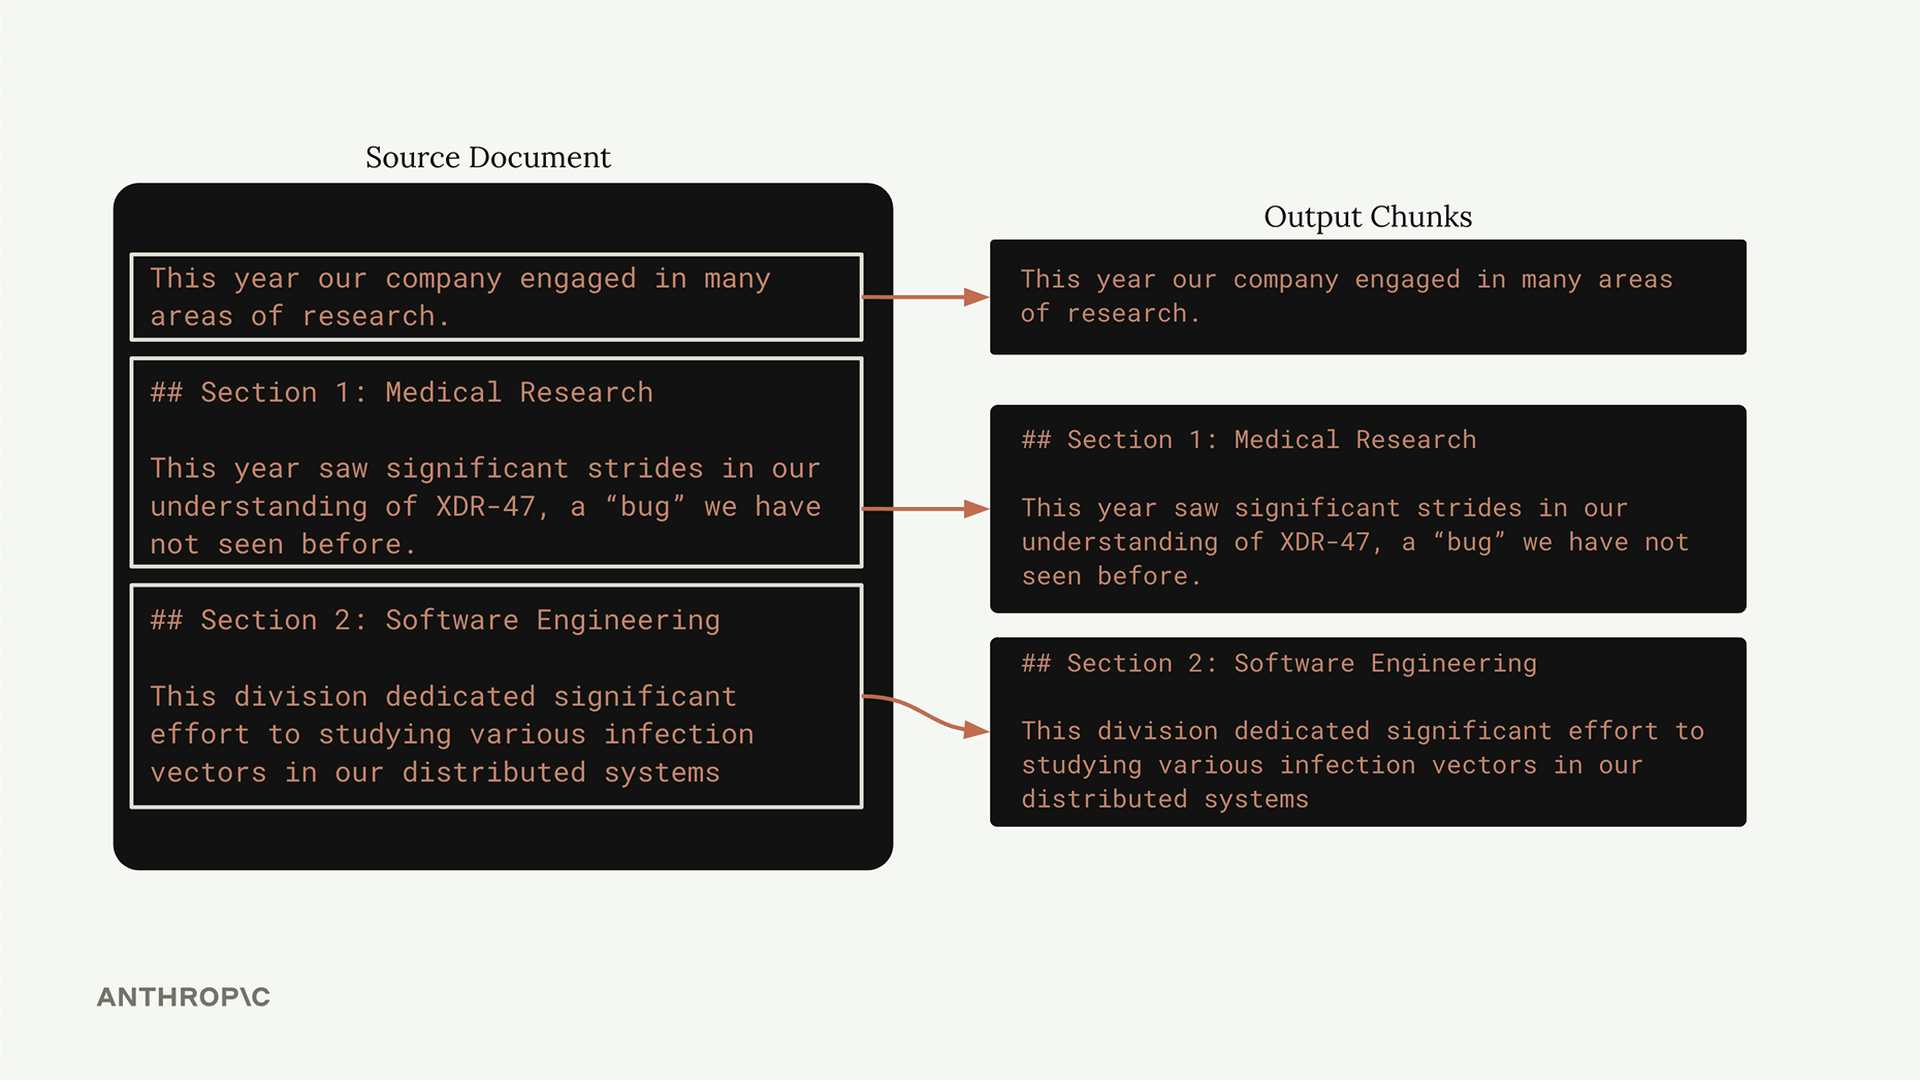
Cela fonctionne à merveille pour les documents bien formatés mais nécessite des garanties sur la structure du document. Cela ne fonctionnera pas de manière fiable avec des fichiers texte brut ou des documents formatés de façon incohérente.
Exemples d'implémentation
Voici trois fonctions de découpage pratiques que vous pouvez implémenter :
Découpage basé sur les caractères
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
Découpage basé sur les phrases
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
Découpage basé sur les sections
def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
Choisir la bonne stratégie
Votre choix de stratégie de découpage dépend entièrement de votre cas d'usage spécifique :
- Basé sur les caractères : Solution de repli la plus fiable, fonctionne avec tout type de document
- Basé sur les phrases : Bon équilibre entre contexte et sens pour la prose
- Basé sur les sections : Excellents résultats lorsque vous avez des documents structurés
Pour les documents téléchargés par les utilisateurs sans garanties de formatage, le découpage basé sur les caractères est souvent votre option la plus sûre. Pour les documents internes bien structurés, le découpage basé sur les sections peut fournir des résultats supérieurs. Le découpage basé sur les phrases fonctionne bien pour la plupart des textes en prose mais peut rencontrer des difficultés avec du code ou des documents techniques qui utilisent des points de manière inattendue.
Rappelez-vous que le découpage est souvent un processus itératif. Commencez par une approche simple, testez-la avec vos documents et cas d'usage spécifiques, puis affinez-la en fonction de la qualité des résultats que vous obtenez de votre système RAG.