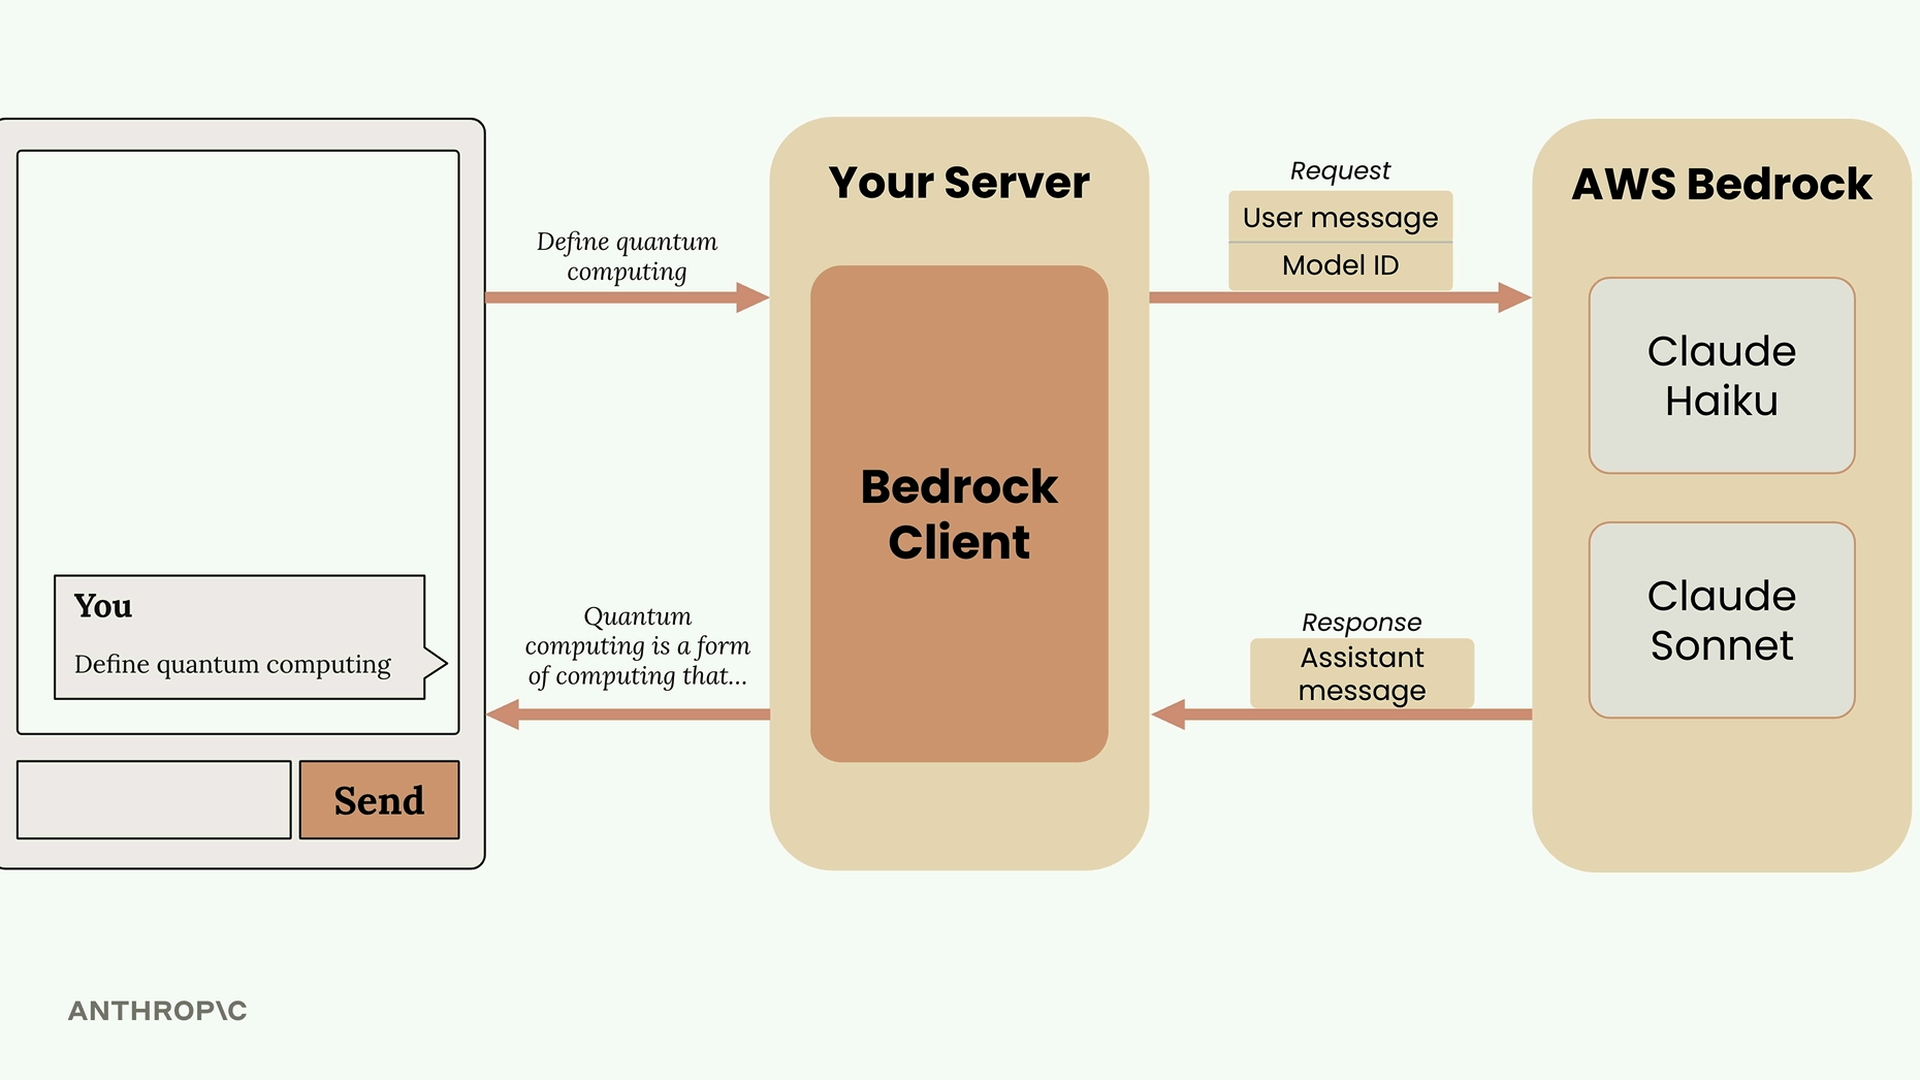
Lorsque vous créez des applications avec des modèles d'IA, vous devez comprendre le flux de données depuis la saisie de l'utilisateur jusqu'à la réponse générée par l'IA. Parcourons ensemble le fonctionnement de ce processus avec AWS Bedrock et voyons ce qui se passe en coulisses dans une application de chat typique.
Comment fonctionnent les applications de chat
Imaginez que vous créez une application web avec une interface de chat simple. Un utilisateur tape « Définir l'informatique quantique » et clique sur envoyer. Voici ce qui se passe réellement :
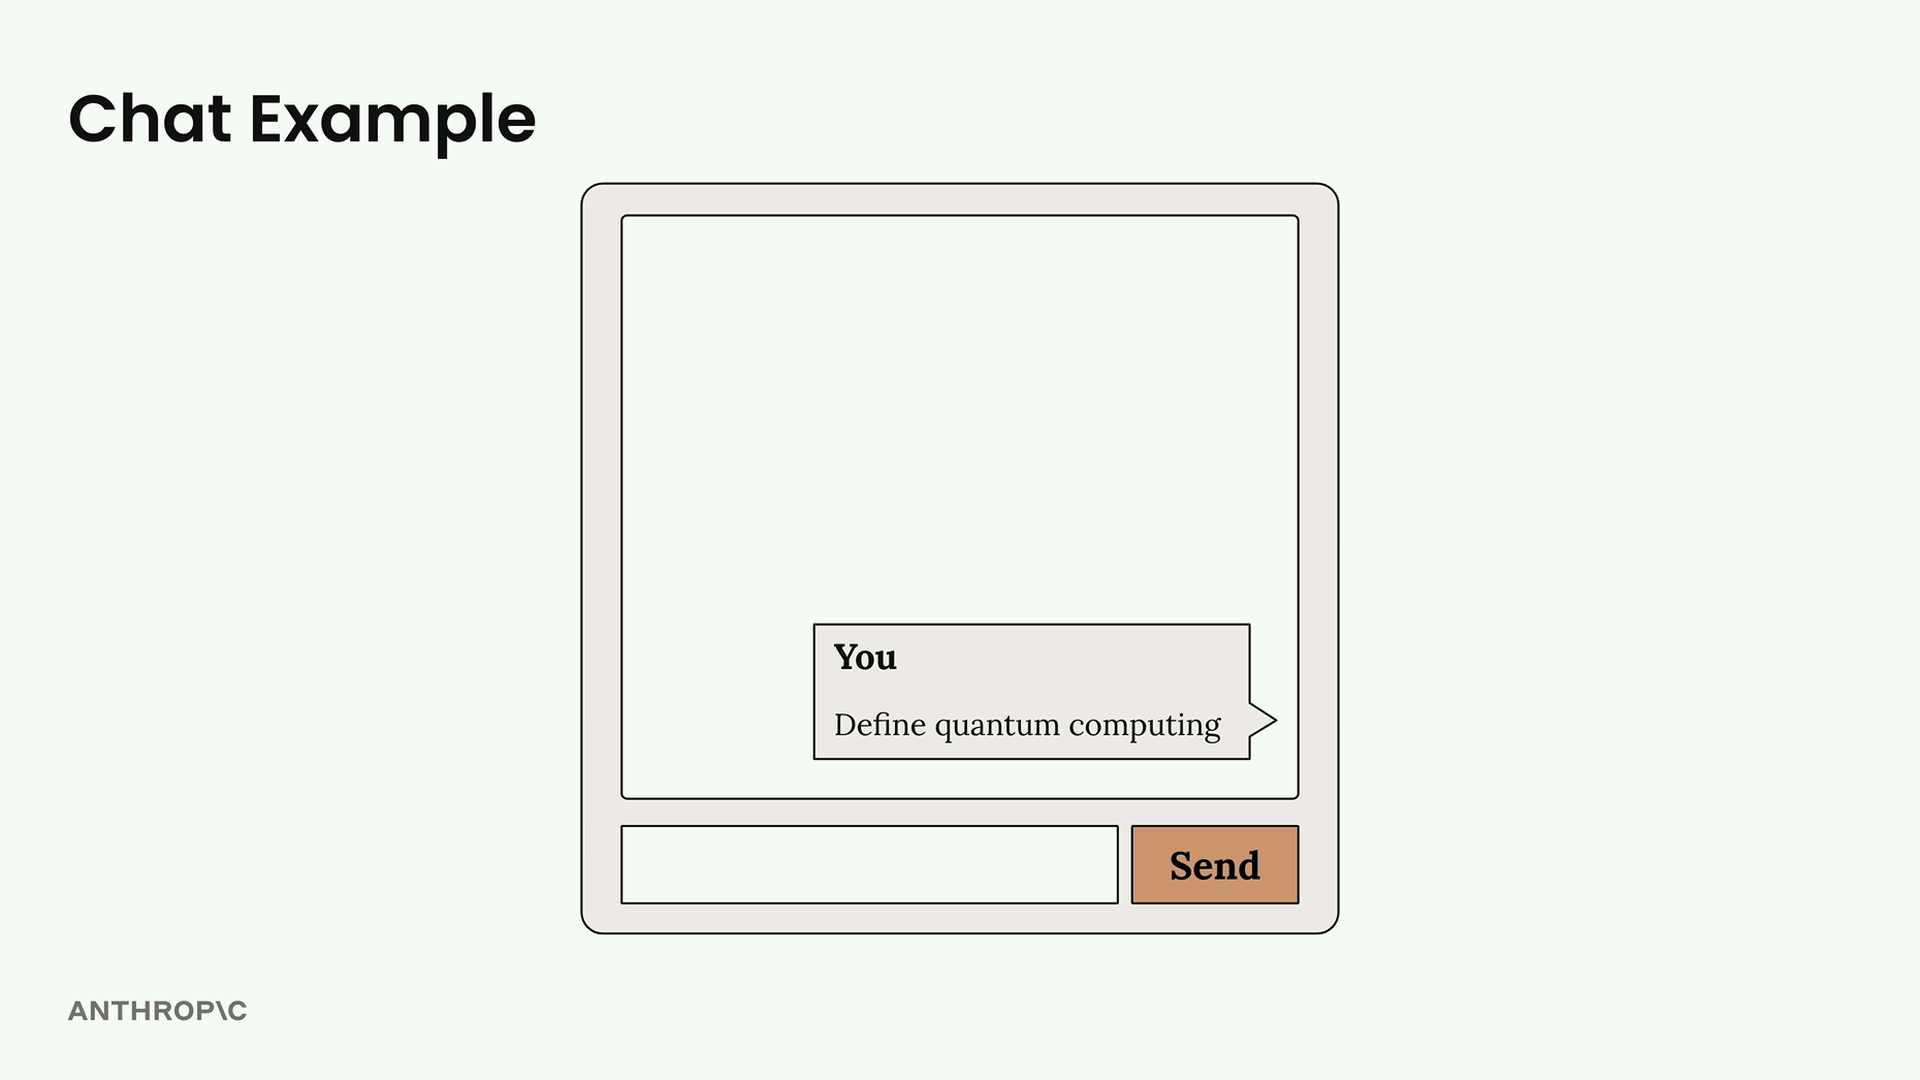
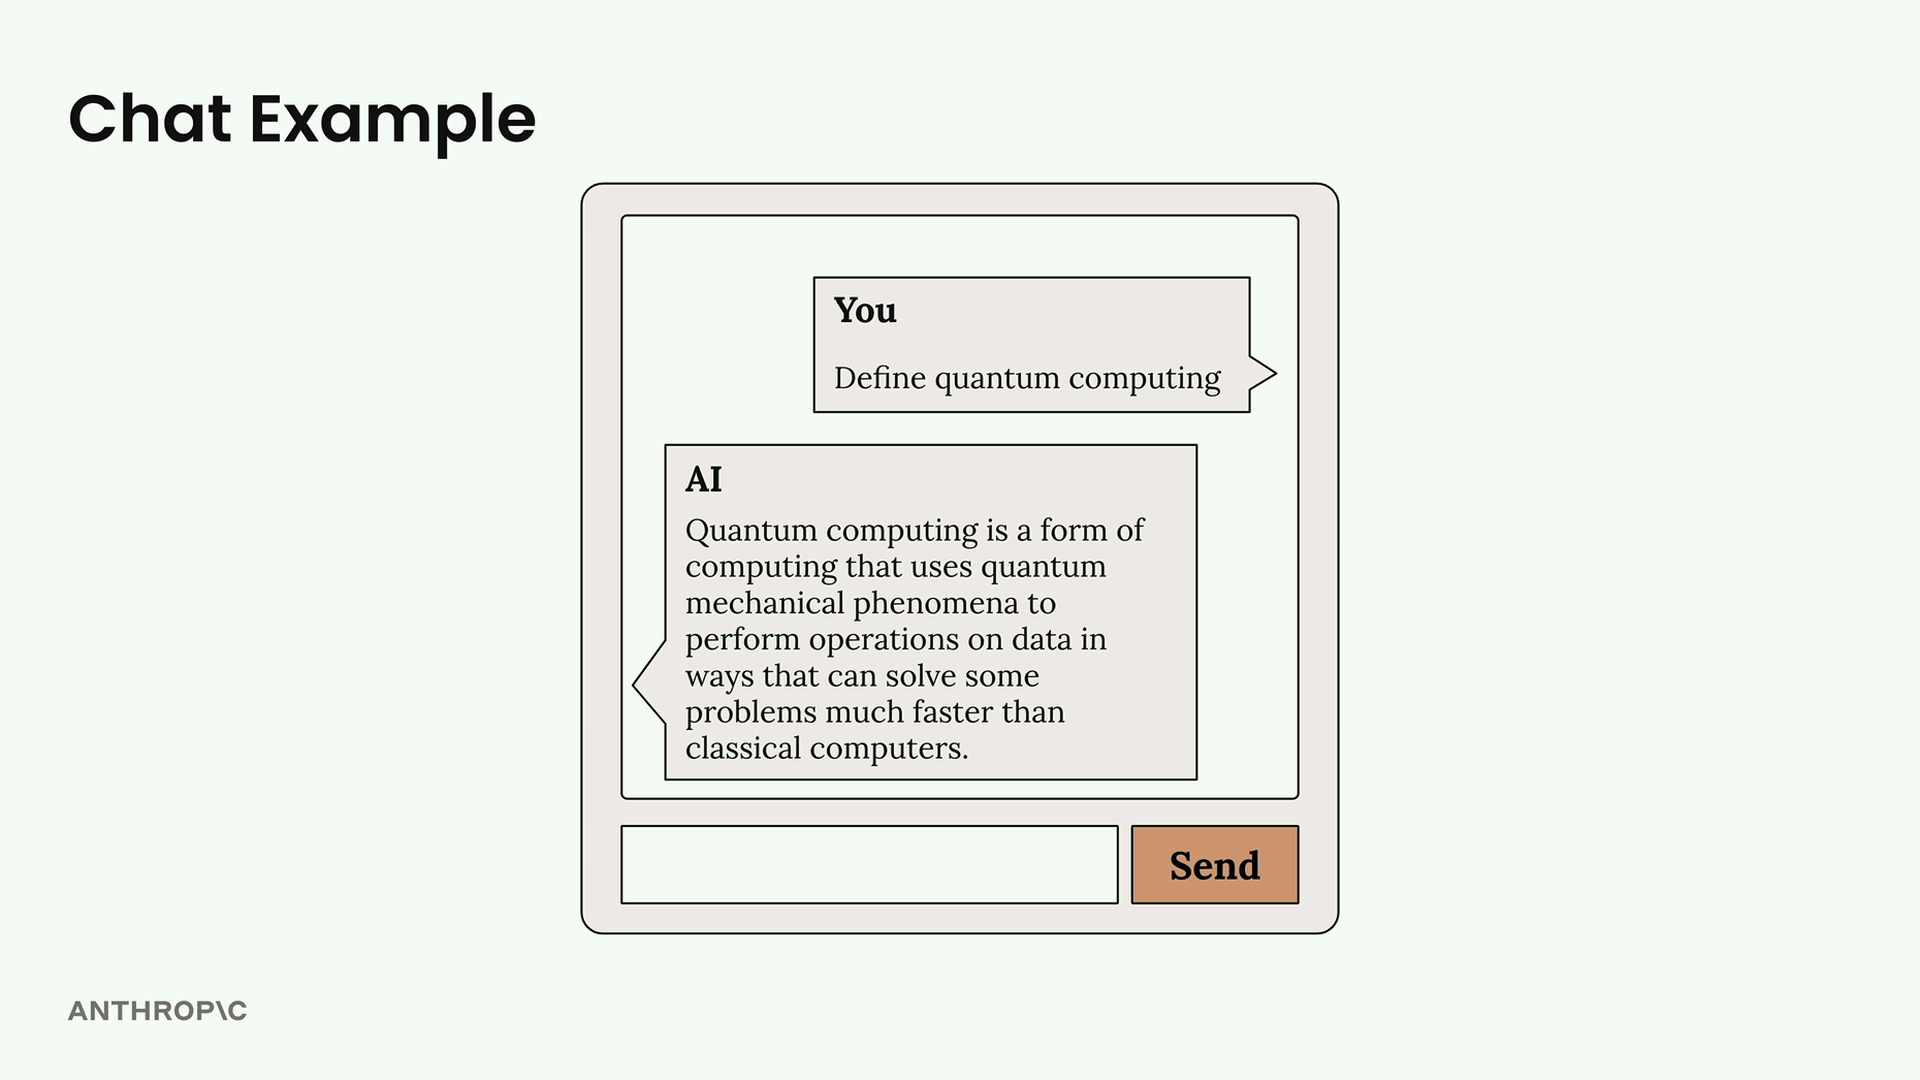
L'utilisateur voit une interface épurée, mais tout un système travaille en coulisses pour générer cette réponse.
Le flux de la requête
Lorsqu'un utilisateur soumet un texte, voici le parcours que suit ce message :
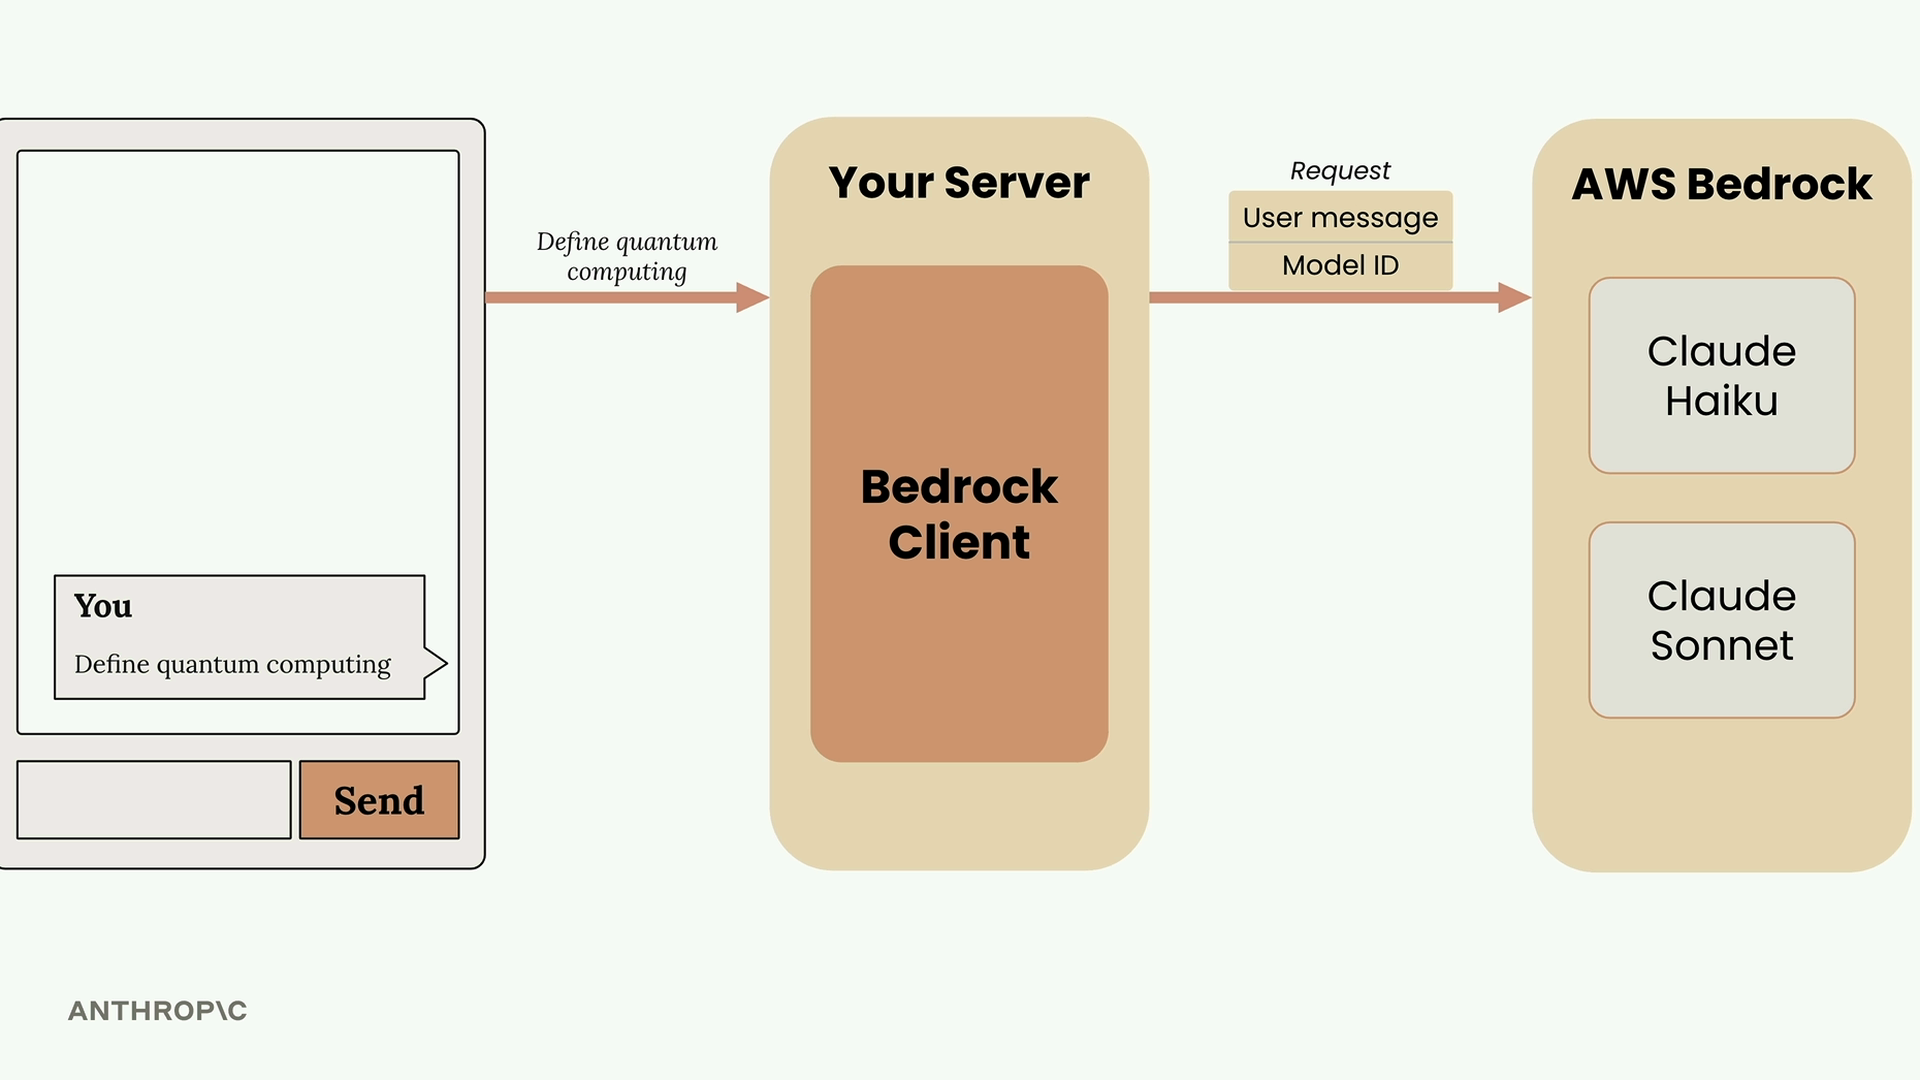
- L'utilisateur soumet son message via votre interface web
- Votre serveur reçoit la requête contenant ce texte
- Votre serveur utilise le client Bedrock pour effectuer une requête vers AWS Bedrock
- La requête inclut le message de l'utilisateur et un identifiant de modèle (comme Claude Haiku ou Claude Sonnet)
- Le modèle choisi traite la requête et génère du texte
- AWS Bedrock renvoie un message d'assistant contenant la réponse générée
- Votre serveur transmet cette réponse au navigateur de l'utilisateur