Au-delà de la rédaction de meilleures invites, il existe deux techniques puissantes pour contrôler la sortie de Claude : les messages assistant préremplis et les séquences d'arrêt. Ces méthodes vous donnent un contrôle précis sur la façon dont Claude répond et sur le moment où il arrête de générer du texte.
Messages assistant préremplis
Le préremplissage de message vous permet de fournir le début de la réponse de Claude, ce qui influence fortement la direction de sa réponse. Plutôt que de laisser Claude décider comment commencer sa réponse, vous lui donnez une ouverture spécifique qui oriente la conversation.
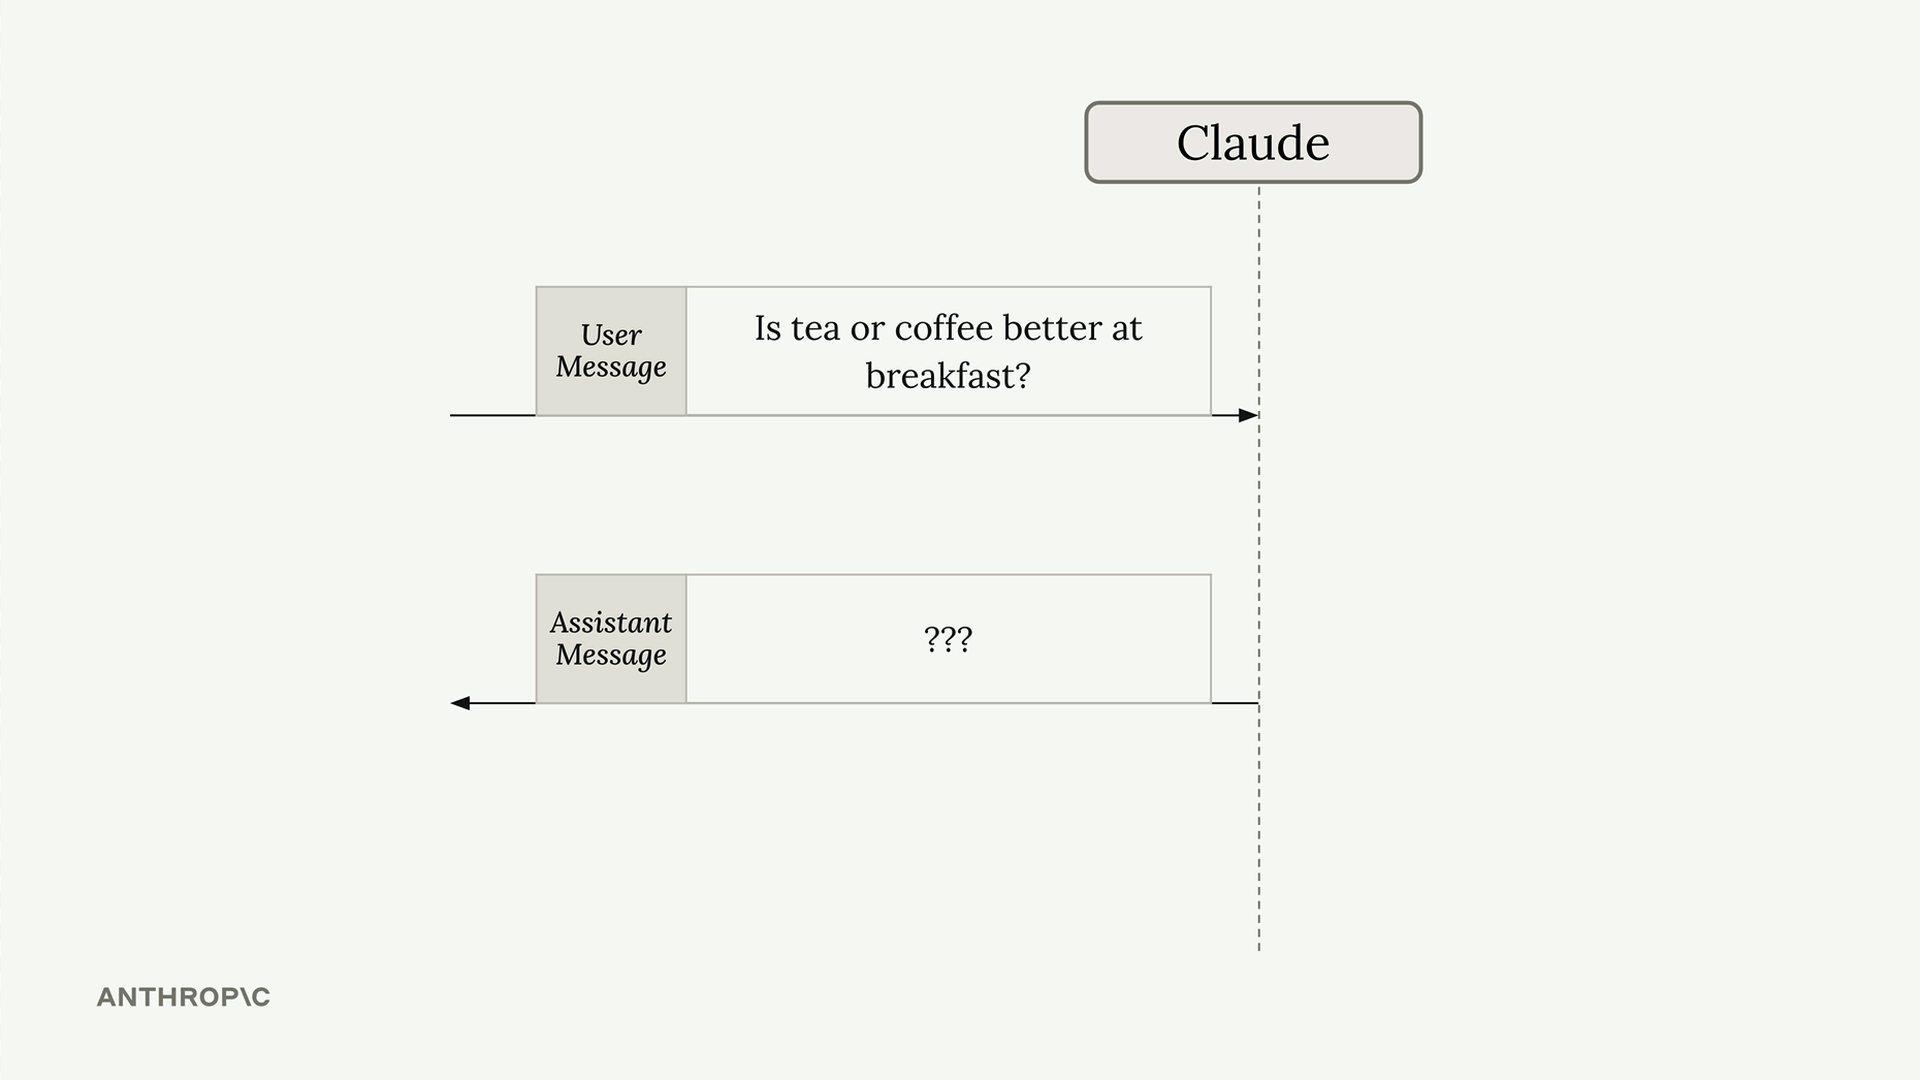
Voici comment cela fonctionne : vous construisez votre liste normale de messages avec la question de l'utilisateur, puis vous ajoutez un message assistant à la fin contenant le début de la réponse que vous souhaitez. Lorsque Claude traite cela, il voit le message assistant et pense « J'ai déjà commencé à répondre à cette question, je devrais donc continuer là où je me suis arrêté ».
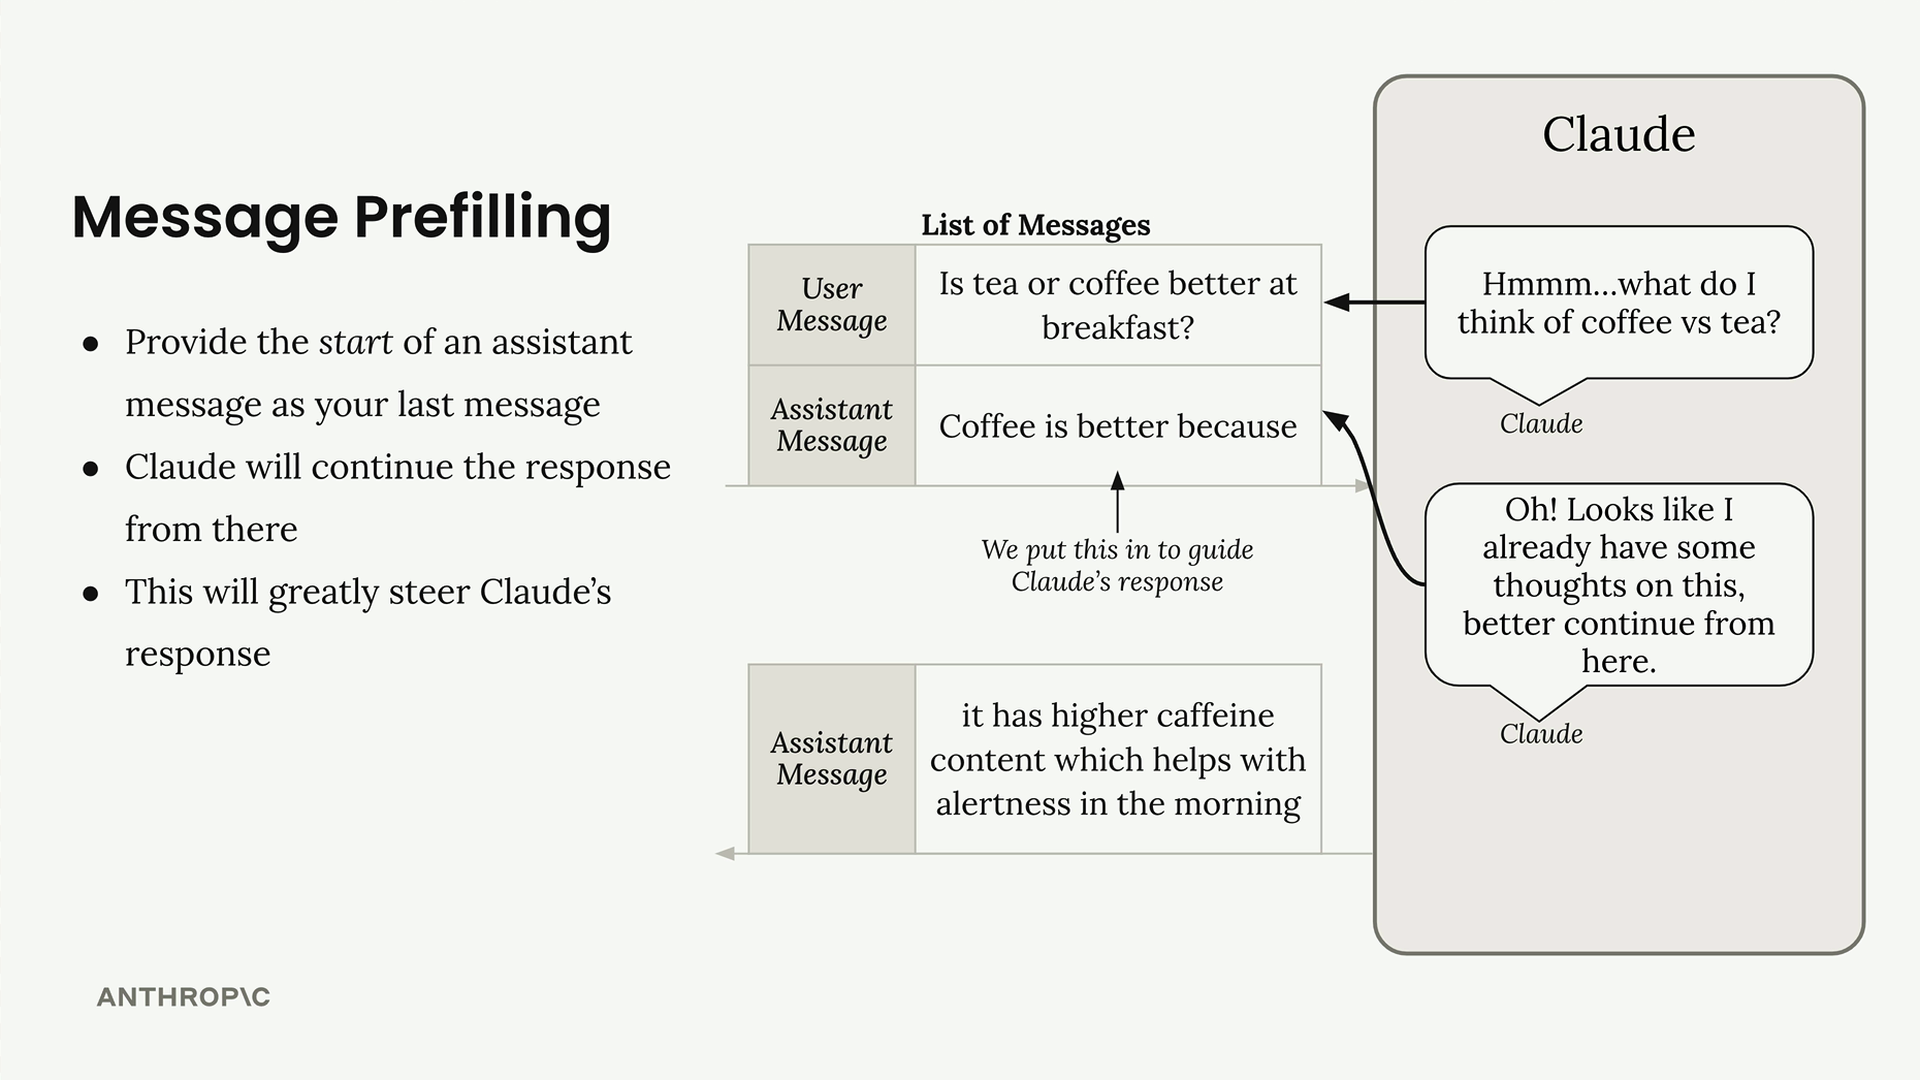
Par exemple, si vous demandez « Le thé ou le café est-il meilleur au petit-déjeuner ? » et que vous préremplissez avec « Le café est meilleur parce que », Claude continuera à partir de ce point et construira une réponse en faveur du café. L'idée clé est que Claude reprendra exactement là où votre texte prérempli se termine - il ne répétera pas ce que vous avez écrit.
Voyons cela en pratique :
messages = []
add_user_message(messages, "Is coffee or tea better for breakfast?")
add_assistant_message(messages, "Coffee is better because")

chat(messages)
Cela renvoie quelque chose comme « il contient plus de caféine ». Remarquez que Claude continue directement à partir de votre texte prérempli, vous devrez donc combiner les deux parties pour obtenir la réponse complète : « Le café est meilleur parce qu'il contient plus de caféine ».
Vous pouvez orienter Claude dans n'importe quelle direction en modifiant votre texte prérempli :
"Tea is better because"- oriente vers le thé"They are the same because"- crée une réponse neutre
Séquences d'arrêt
Les séquences d'arrêt forcent Claude à terminer sa réponse immédiatement lorsqu'il génère un texte spécifique. Ceci est utile lorsque vous souhaitez tronquer la sortie à un point particulier ou empêcher Claude de continuer au-delà d'un certain marqueur.
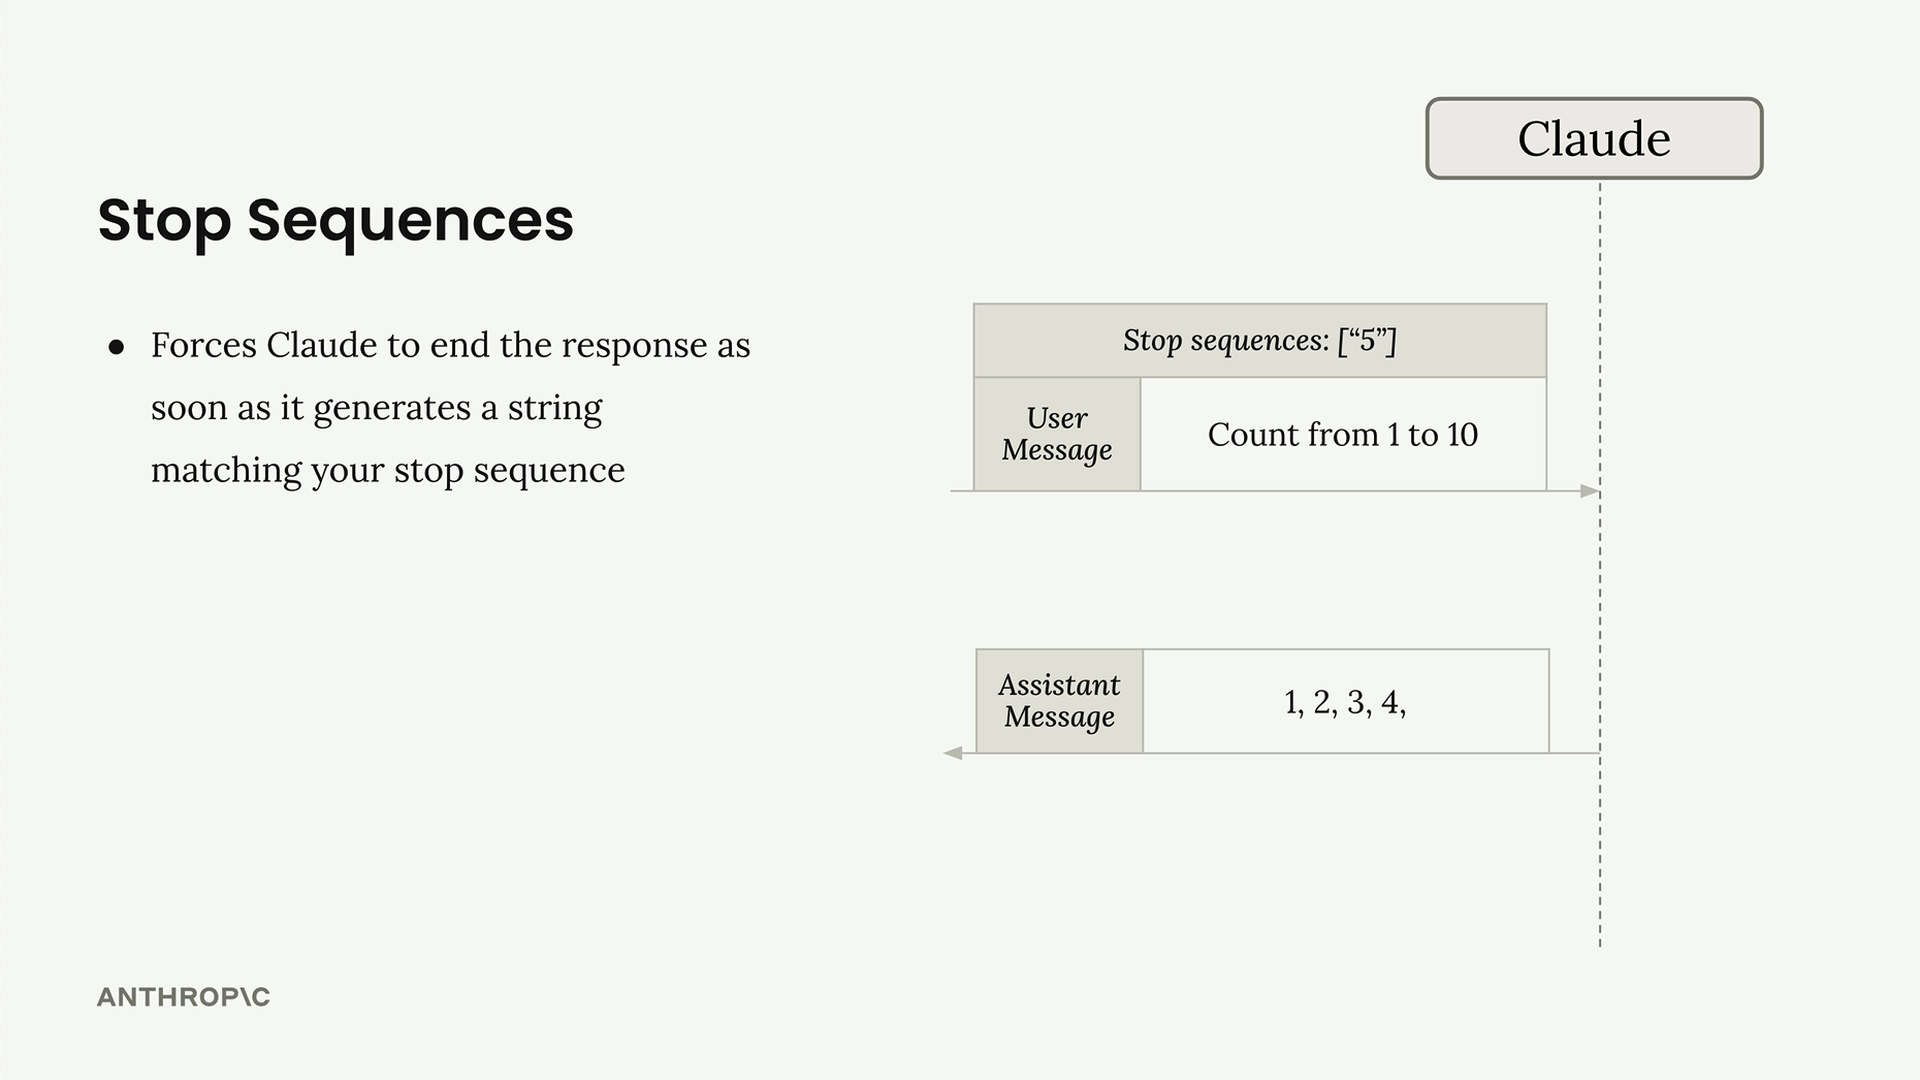
Le concept est simple : vous fournissez une liste de chaînes de caractères, et dès que Claude génère l'une de ces chaînes, il s'arrête et renvoie tout ce qu'il a généré jusqu'à présent. La séquence d'arrêt elle-même n'est pas incluse dans la réponse.
Pour utiliser les séquences d'arrêt, vous devez modifier votre fonction de chat pour les accepter en tant que paramètre :
def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "modelId": model_id,
        "messages": messages,
        "inferenceConfig": {
            "temperature": temperature,
            "stopSequences": stop_sequences
        },
    }
Voici un exemple pratique :
messages = []
add_user_message(messages, "Count from 1 to 10")

chat(messages, stop_sequences=["5"])
Cela renvoie « 1, 2, 3, 4, » et s'arrête avant d'inclure le « 5 ». Vous pouvez spécifier plusieurs séquences d'arrêt, et Claude s'arrêtera à celle qu'il rencontrera en premier :
chat(messages, stop_sequences=["5", "3, 4"])Les séquences d'arrêt sont particulièrement utiles pour :
- Contrôler la longueur des réponses
- S'arrêter à des points de rupture naturels dans une sortie structurée
- Empêcher Claude de continuer au-delà de marqueurs ou de délimiteurs spécifiques
Les deux techniques vous donnent un contrôle fin sur le comportement de Claude, vous permettant de façonner les réponses de manières que le simple prompting ne peut pas atteindre à lui seul.