Lorsque vous construisez un pipeline RAG, vous découvrirez rapidement que la recherche sémantique seule ne renvoie pas toujours les meilleurs résultats. Parfois, vous avez besoin de correspondances exactes de mots-clés que la recherche sémantique pourrait manquer. La solution consiste à combiner la recherche sémantique avec la recherche lexicale en utilisant une technique appelée BM25.
Le problème de la recherche sémantique seule
Supposons que vous recherchiez un identifiant d'incident spécifique comme « INC-2023-Q4-011 » dans un document. Bien que ce terme exact apparaisse plusieurs fois dans des sections pertinentes, la recherche sémantique pourrait renvoyer des sections non liées qui semblent sémantiquement similaires mais ne contiennent pas réellement l'information spécifique dont vous avez besoin.
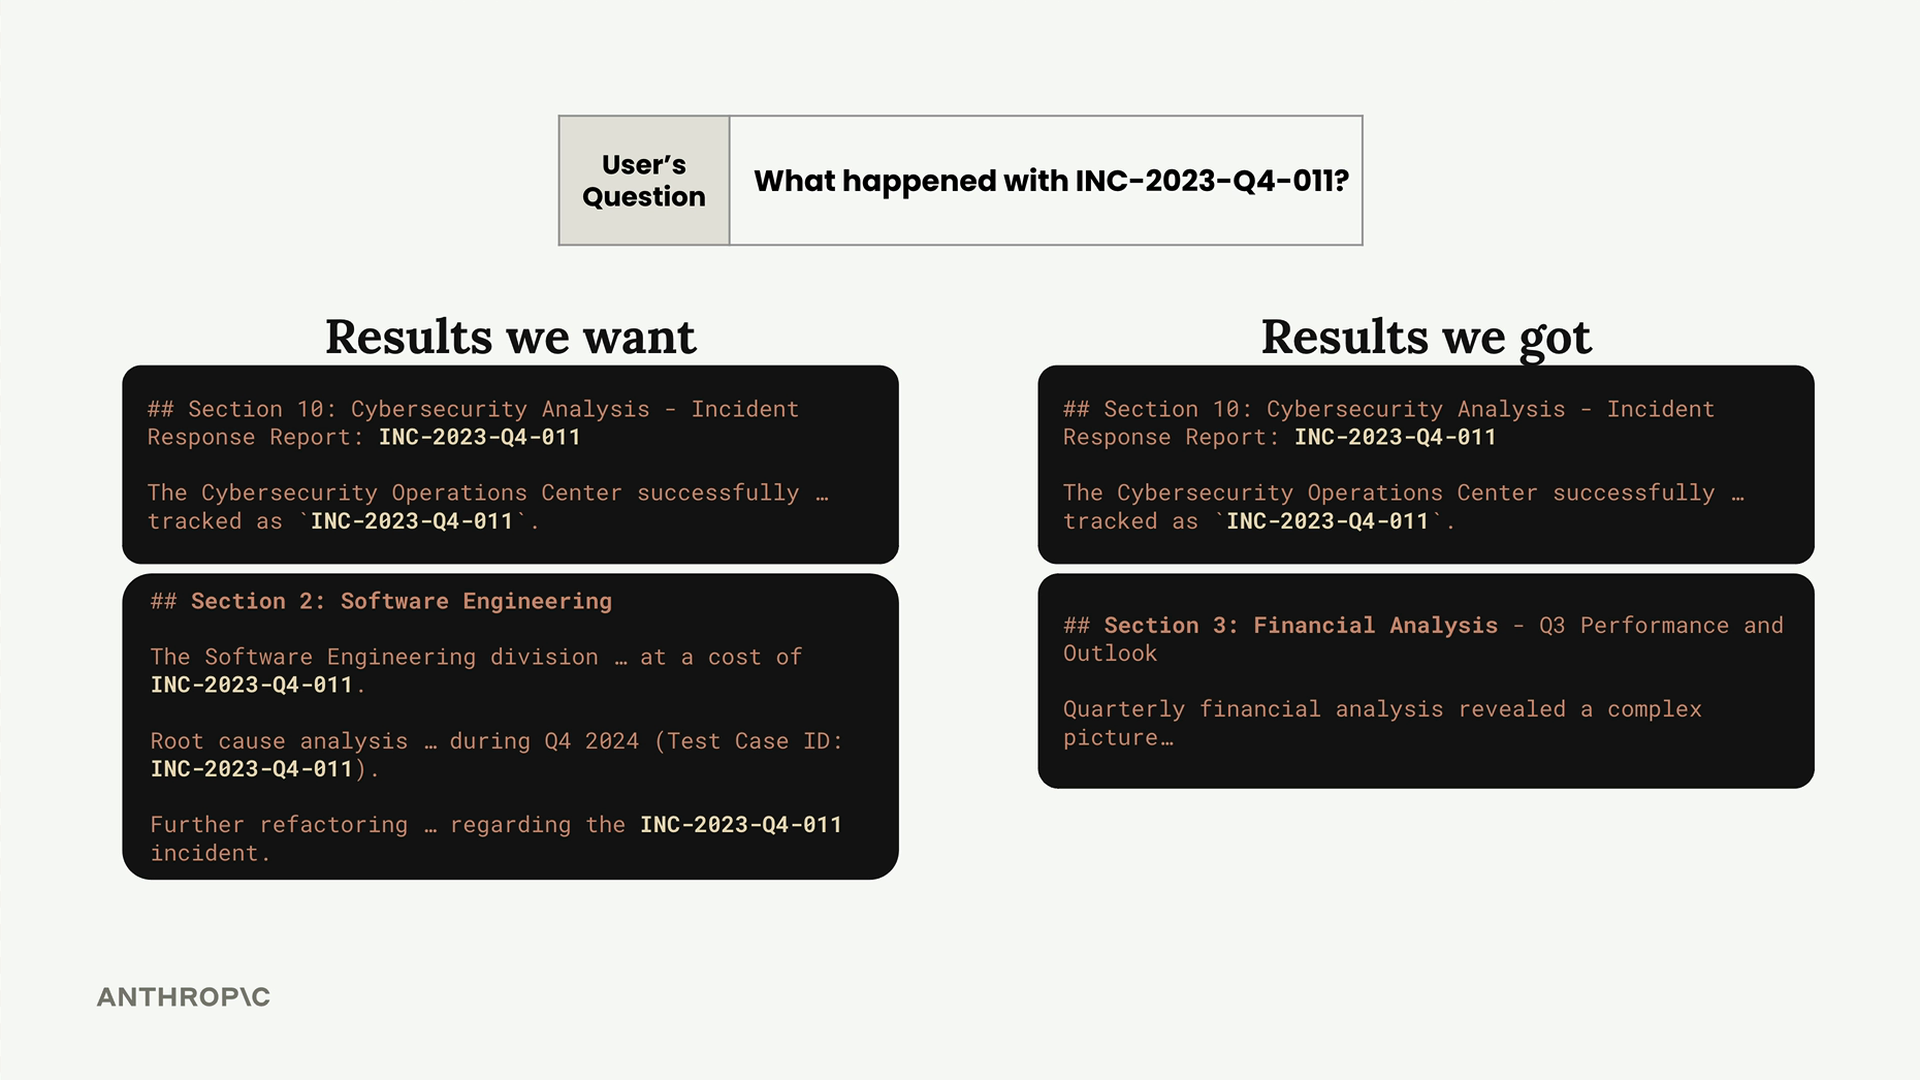
Cela se produit parce que la recherche sémantique se concentre sur le sens plutôt que sur les correspondances exactes de texte. Lorsque vous avez besoin d'une correspondance précise de mots-clés, vous avez besoin d'une approche différente.
Stratégie de recherche hybride
La solution consiste à exécuter à la fois des recherches sémantiques et lexicales en parallèle, puis à fusionner les résultats. Cela vous offre le meilleur des deux mondes :
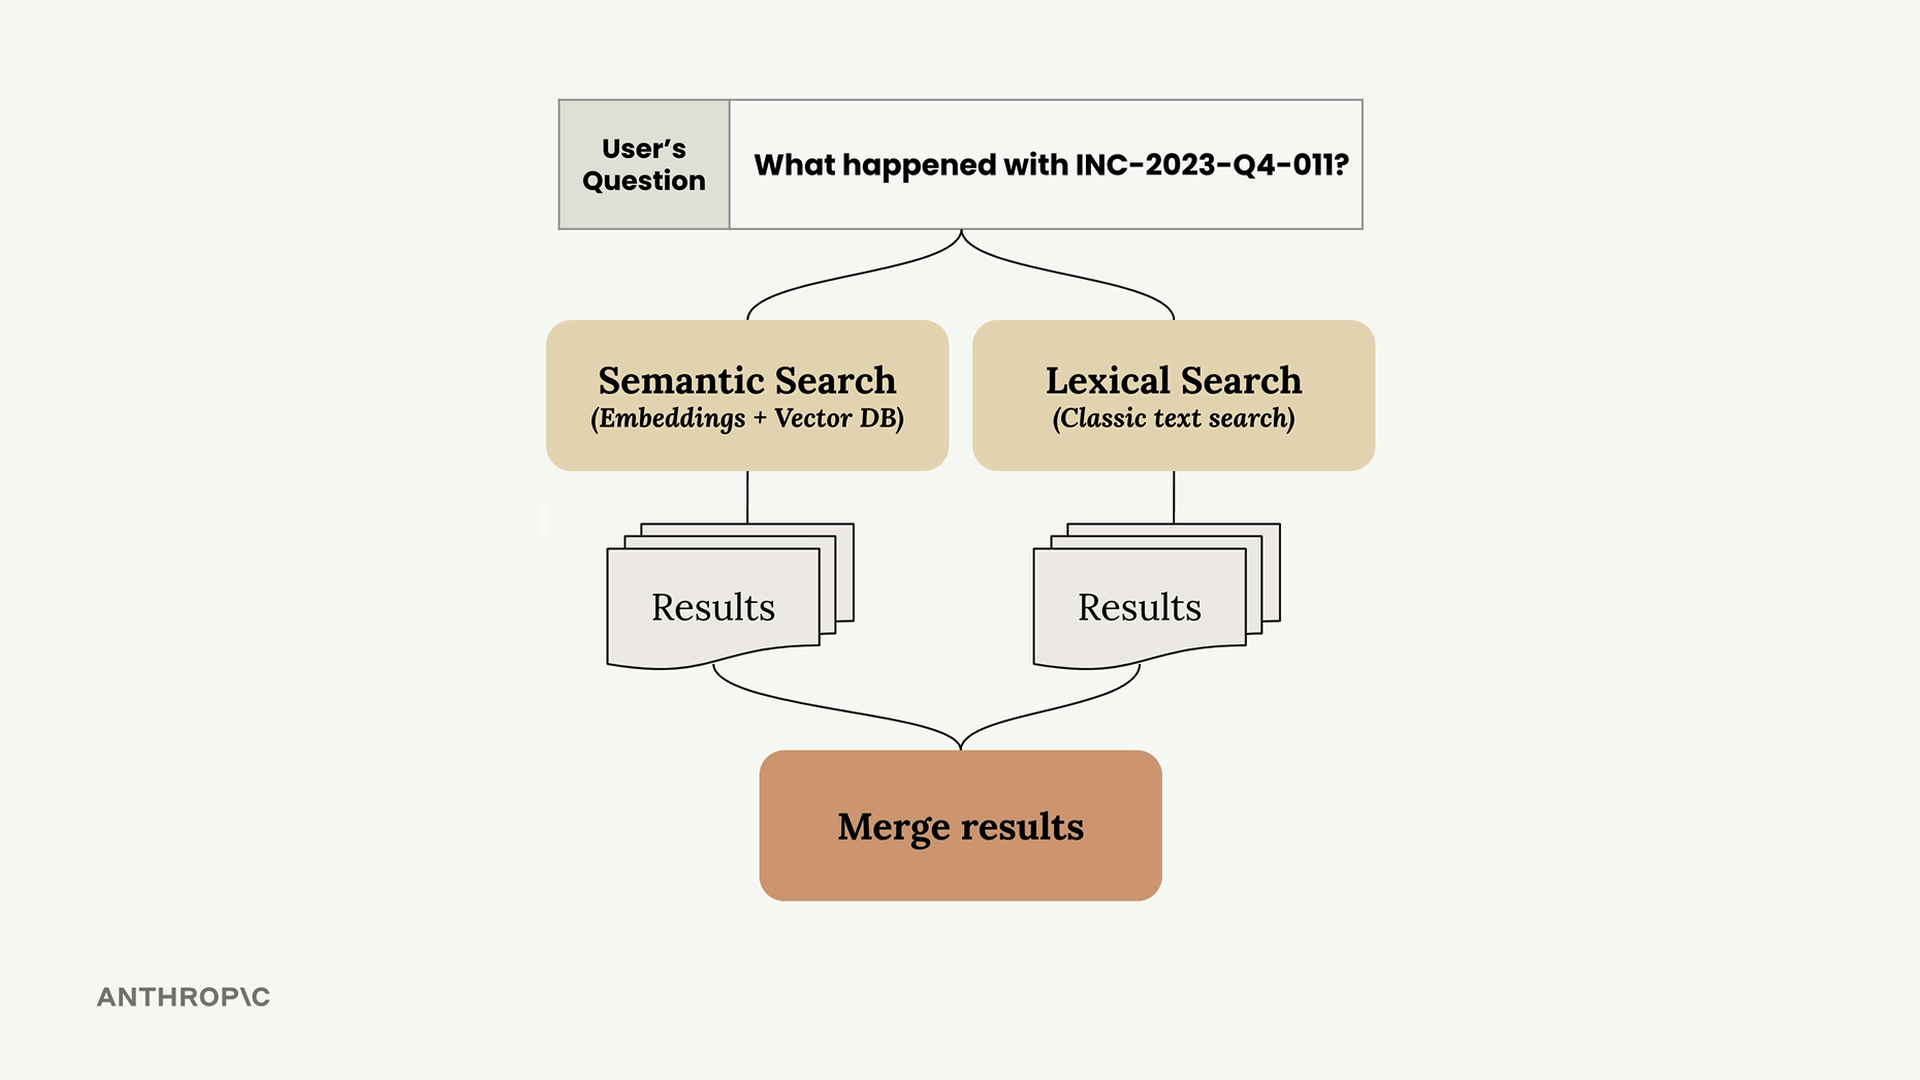
- Recherche sémantique - Trouve du contenu conceptuellement lié en utilisant des embeddings
- Recherche lexicale - Trouve des correspondances exactes de mots-clés en utilisant la recherche textuelle classique
- Résultats fusionnés - Combine les deux approches pour une meilleure pertinence globale
Comment fonctionne BM25
BM25 (Best Match 25) est un algorithme populaire pour la recherche lexicale dans les pipelines RAG. Voici comment il traite une requête de recherche :
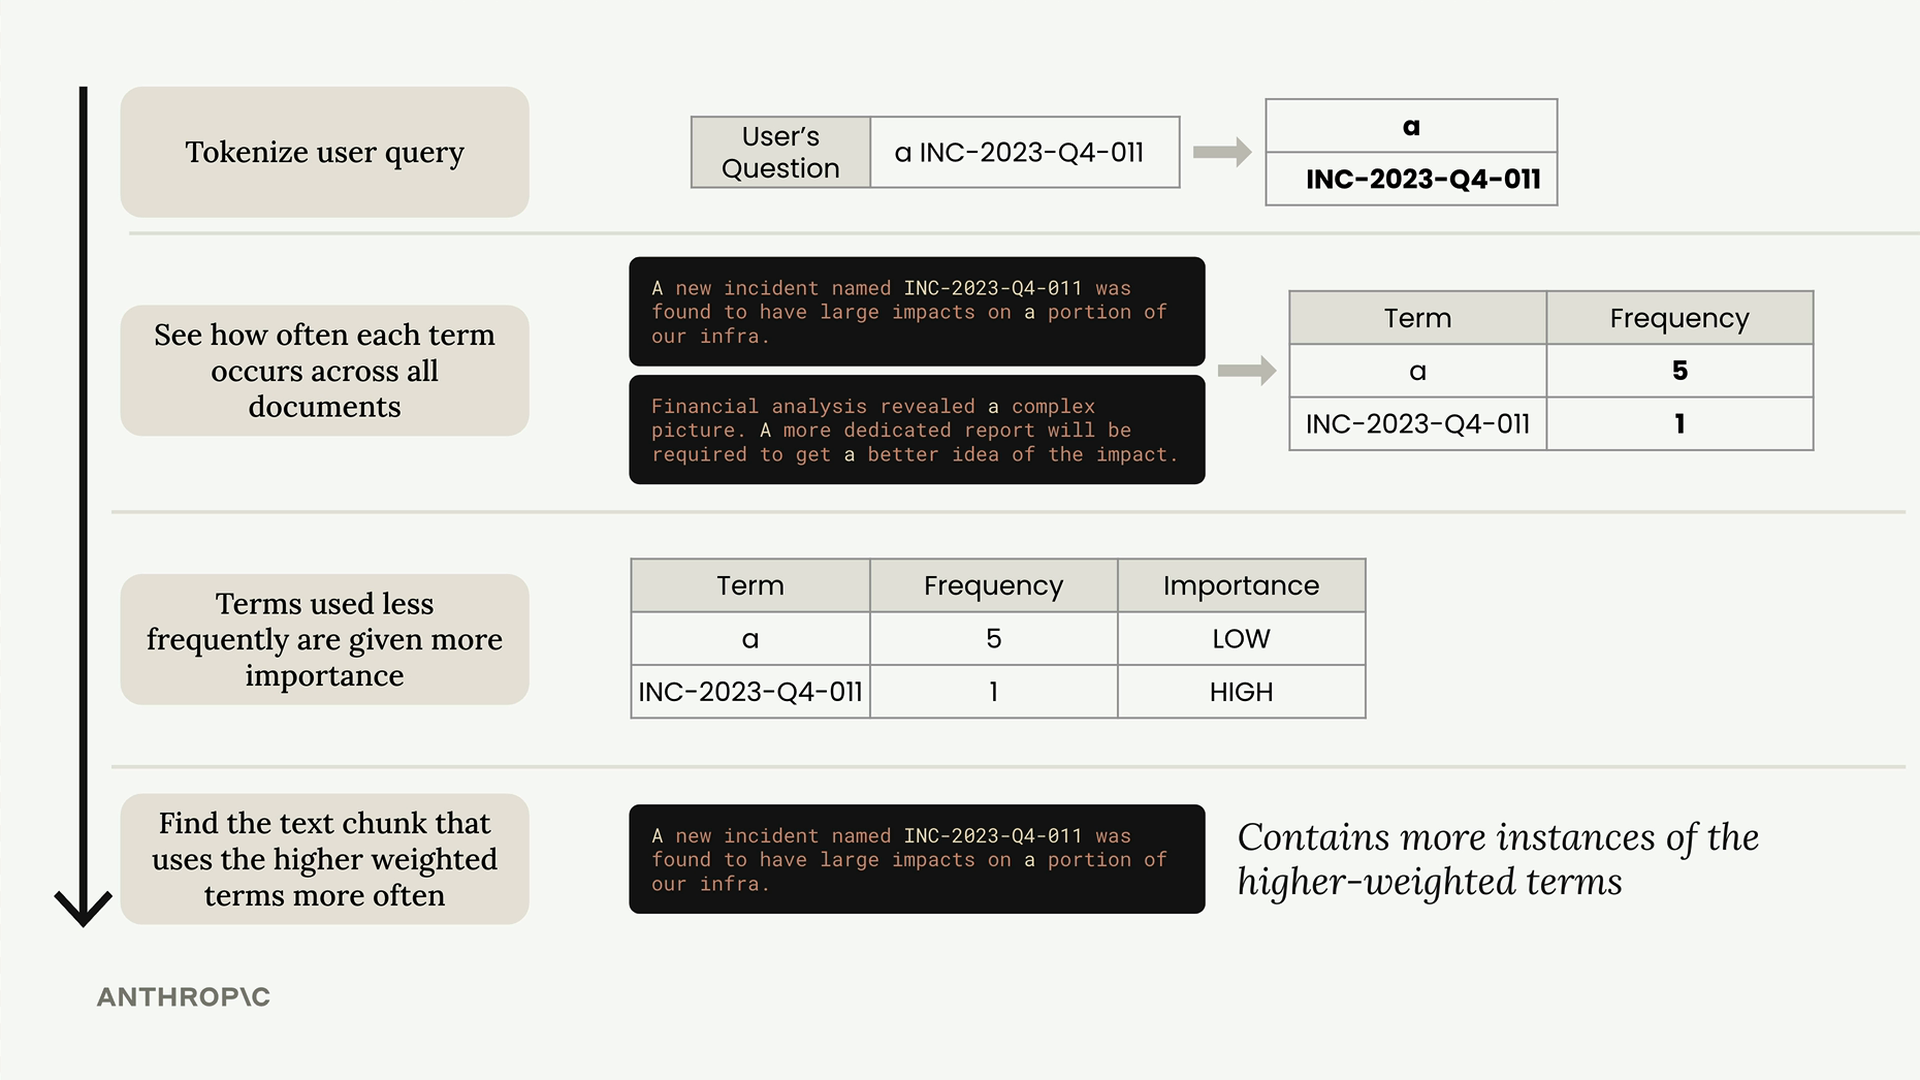
L'algorithme suit ces étapes clés :
- Tokeniser la requête - Décomposer la question de l'utilisateur en termes individuels
- Compter la fréquence des termes - Voir à quelle fréquence chaque terme apparaît dans tous les documents
- Pondérer les termes par rareté - Les termes utilisés moins fréquemment obtiennent des scores d'importance plus élevés
- Noter les documents - Trouver les extraits de texte qui contiennent davantage d'instances des termes les plus fortement pondérés
L'idée clé est que les termes rares comme « INC-2023-Q4-011 » sont beaucoup plus importants pour la pertinence de la recherche que les mots courants comme « un » ou « le ».
Mise en œuvre de la recherche BM25
Voici comment configurer un système de recherche BM25 :
# Créer un store BM25
store = BM25Index()

# Ajouter des documents au store
for chunk in chunks:
    store.add_document({"content": chunk})

# Rechercher dans le store
results = store.search("What happened with INC-2023-Q4-011?", 3)
L'implémentation BM25 maintient une API similaire à votre magasin de vecteurs, avec les méthodes add_document() et search(). Cette cohérence facilite l'utilisation conjointe des deux systèmes.
De meilleurs résultats de recherche
Lorsque vous exécutez la même requête via BM25 qui a échoué avec la recherche sémantique seule, vous obtenez de bien meilleurs résultats. L'algorithme priorise correctement les sections qui contiennent l'identifiant d'incident exact, les classant plus haut que les sections qui pourraient être sémantiquement liées mais ne contiennent pas le terme spécifique que vous recherchez.
Les résultats de recherche font désormais correctement apparaître la section Ingénierie logicielle et la section Cybersécurité qui traitent réellement de l'incident, plutôt que de renvoyer du contenu non lié comme l'Analyse financière.
Prochaines étapes
Maintenant que vous disposez de systèmes de recherche sémantique et lexicale fonctionnant indépendamment, l'étape suivante consiste à fusionner leurs résultats. Cette approche hybride vous offrira la compréhension sémantique des embeddings combinée à la précision de la correspondance de mots-clés, créant une expérience de recherche plus robuste pour votre pipeline RAG.