L'évaluation basée sur le code ajoute une couche supplémentaire de validation à vos évaluations de prompts en vérifiant si la sortie du modèle suit le format correct et possède une syntaxe valide. Cela est particulièrement utile lorsque vous demandez aux modèles de générer du code, du JSON ou des expressions régulières.
Comment fonctionne l'évaluation du code
L'évaluateur de code évalue deux critères principaux :
- Conformité du format - La sortie contient-elle uniquement le format demandé (Python, JSON ou regex) sans explications ?
- Syntaxe valide - La sortie peut-elle réellement être analysée ou compilée avec succès ?
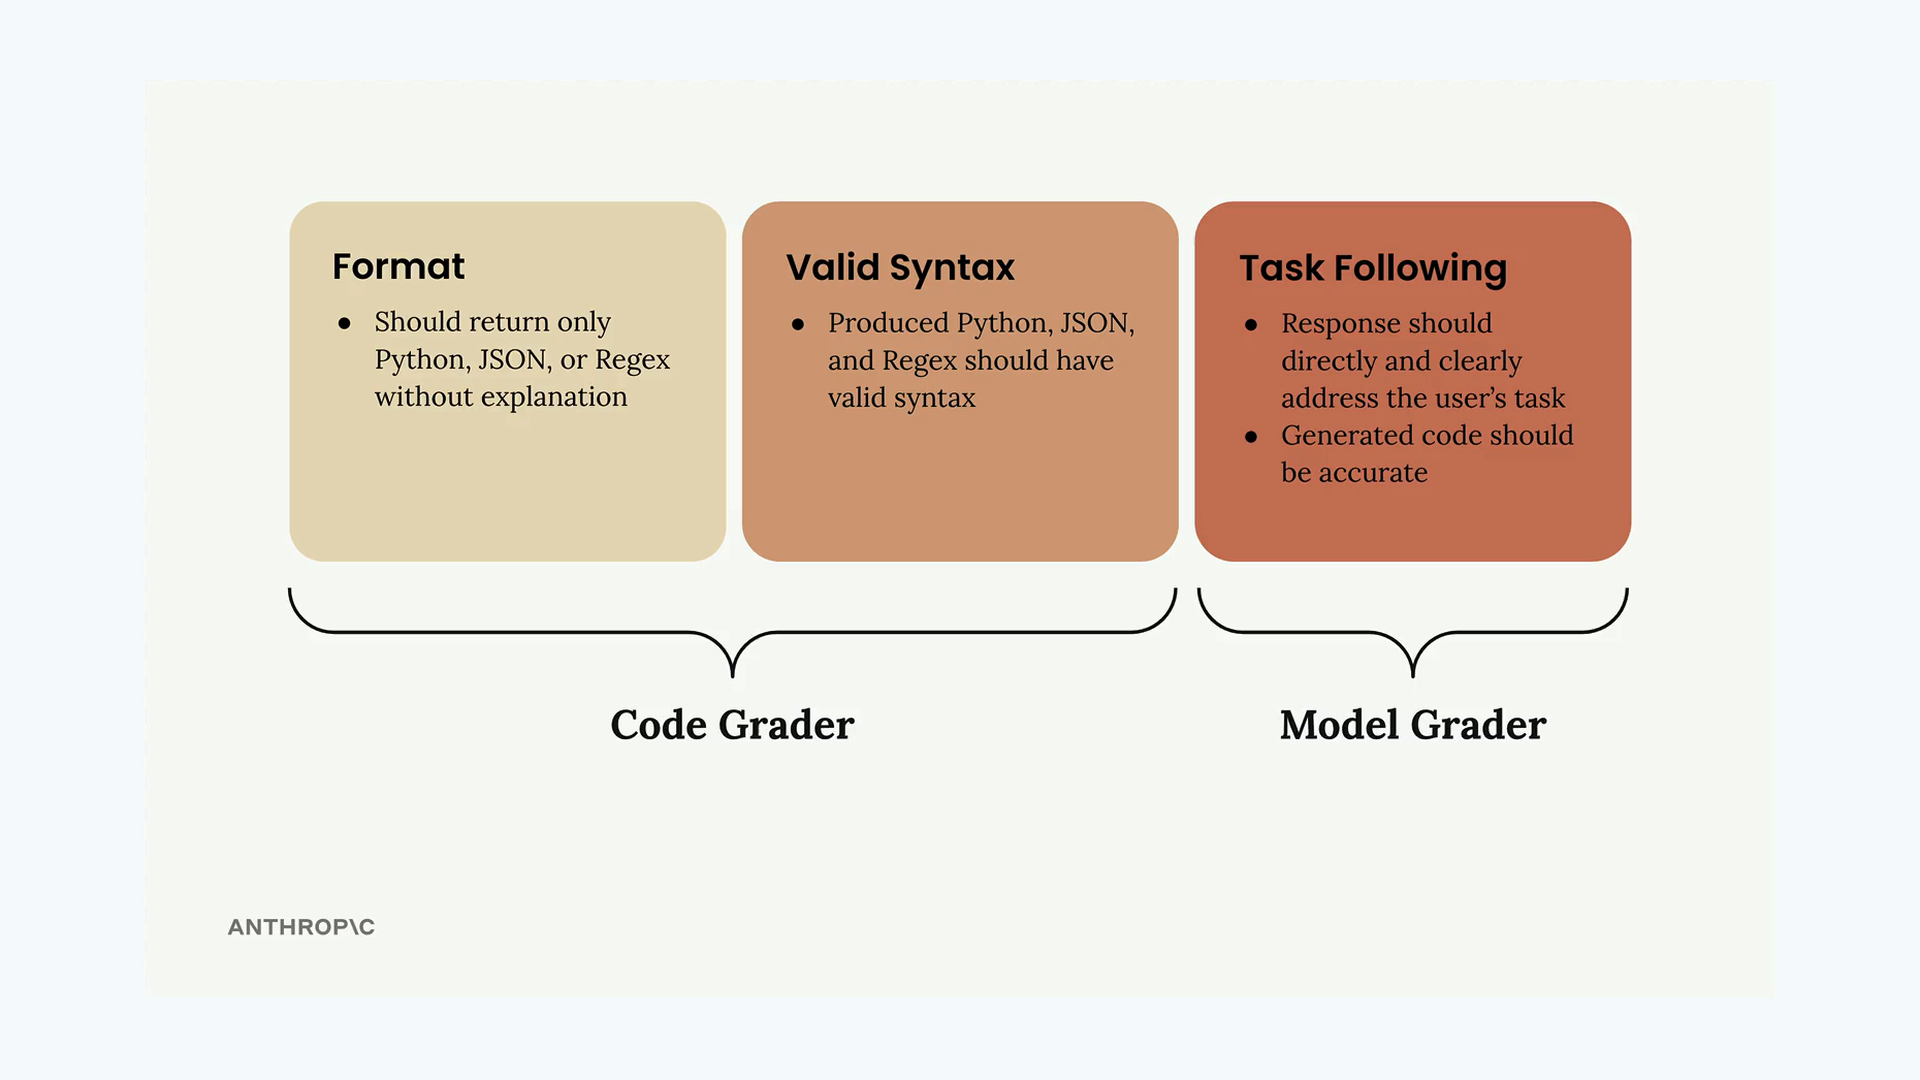
Le système utilise des fonctions de validation distinctes pour chaque type de format. Si le code est analysé avec succès, il obtient un score parfait de 10. Si l'analyse échoue avec une erreur, il obtient un score de 0.
Configuration des fonctions de validation
Vous aurez besoin de trois fonctions d'assistance pour valider différents types de sortie :
def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
Ces fonctions utilisent les capacités d'analyse intégrées de Python pour vérifier la validité de la syntaxe. La fonction json.loads() valide le JSON, ast.parse() crée un arbre syntaxique abstrait Python, et re.compile() valide les expressions régulières.
Ajout d'informations de format aux cas de test
Votre jeu de données de test doit spécifier le format de sortie attendu pour chaque tâche. Mettez à jour votre prompt de génération de jeu de données pour inclure un champ de format :
{
    "task": "Description of task",
    "format": "python"
}
Le champ de format doit contenir « json », « python » ou « regex » selon le type de sortie que vous attendez de cette tâche particulière.
Amélioration de votre prompt
Pour obtenir de meilleurs résultats de l'évaluateur de code, rendez vos instructions de prompt plus spécifiques :
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationVous pouvez également utiliser un message d'assistant pré-rempli avec des blocs de code et des séquences d'arrêt pour garantir un formatage de sortie propre.
Combinaison des scores
La dernière étape consiste à fusionner le score de votre évaluateur de modèle avec le score de l'évaluateur de syntaxe. Une approche simple consiste à prendre la moyenne des deux scores :
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
Cela accorde un poids égal à la fois à la qualité du contenu (de l'évaluateur de modèle) et à la justesse technique (de l'évaluateur de code). Vous pouvez ajuster cette pondération en fonction de ce qui compte le plus pour votre cas d'usage spécifique.
Interprétation des résultats
Une fois que vous avez exécuté votre évaluation, vous obtenez un score combiné qui reflète à la fois la qualité sémantique et la justesse technique du code généré. N'oubliez pas qu'un score isolé ne vous apprend pas grand-chose - la véritable valeur vient de la comparaison des scores au fur et à mesure que vous itérez sur la conception de votre prompt.
Utilisez ce score de référence pour tester les améliorations de prompt et voir si vos changements conduisent réellement à une génération de code meilleure et plus fiable.