L'approche de récupération hybride que nous avons construite fonctionne bien, mais il reste encore quelques aspérités. Lorsque vous recherchez des termes spécifiques ou utilisez des abréviations, les résultats peuvent ne pas être parfaitement ordonnés. Par exemple, demander « Qu'a fait l'équipe d'ingénierie concernant INC-2023-Q4-011 ? » pourrait renvoyer la section cybersécurité en premier, même si la section ingénierie logicielle est plus pertinente pour cette requête spécifique.
Reclassement basé sur un LLM
Le reclassement ajoute une autre étape de post-traitement après la fusion des résultats de votre index vectoriel et de votre index BM25. Le concept est simple : prendre vos résultats de recherche et demander à Claude de les réordonner en fonction de leur pertinence par rapport à la question de l'utilisateur.
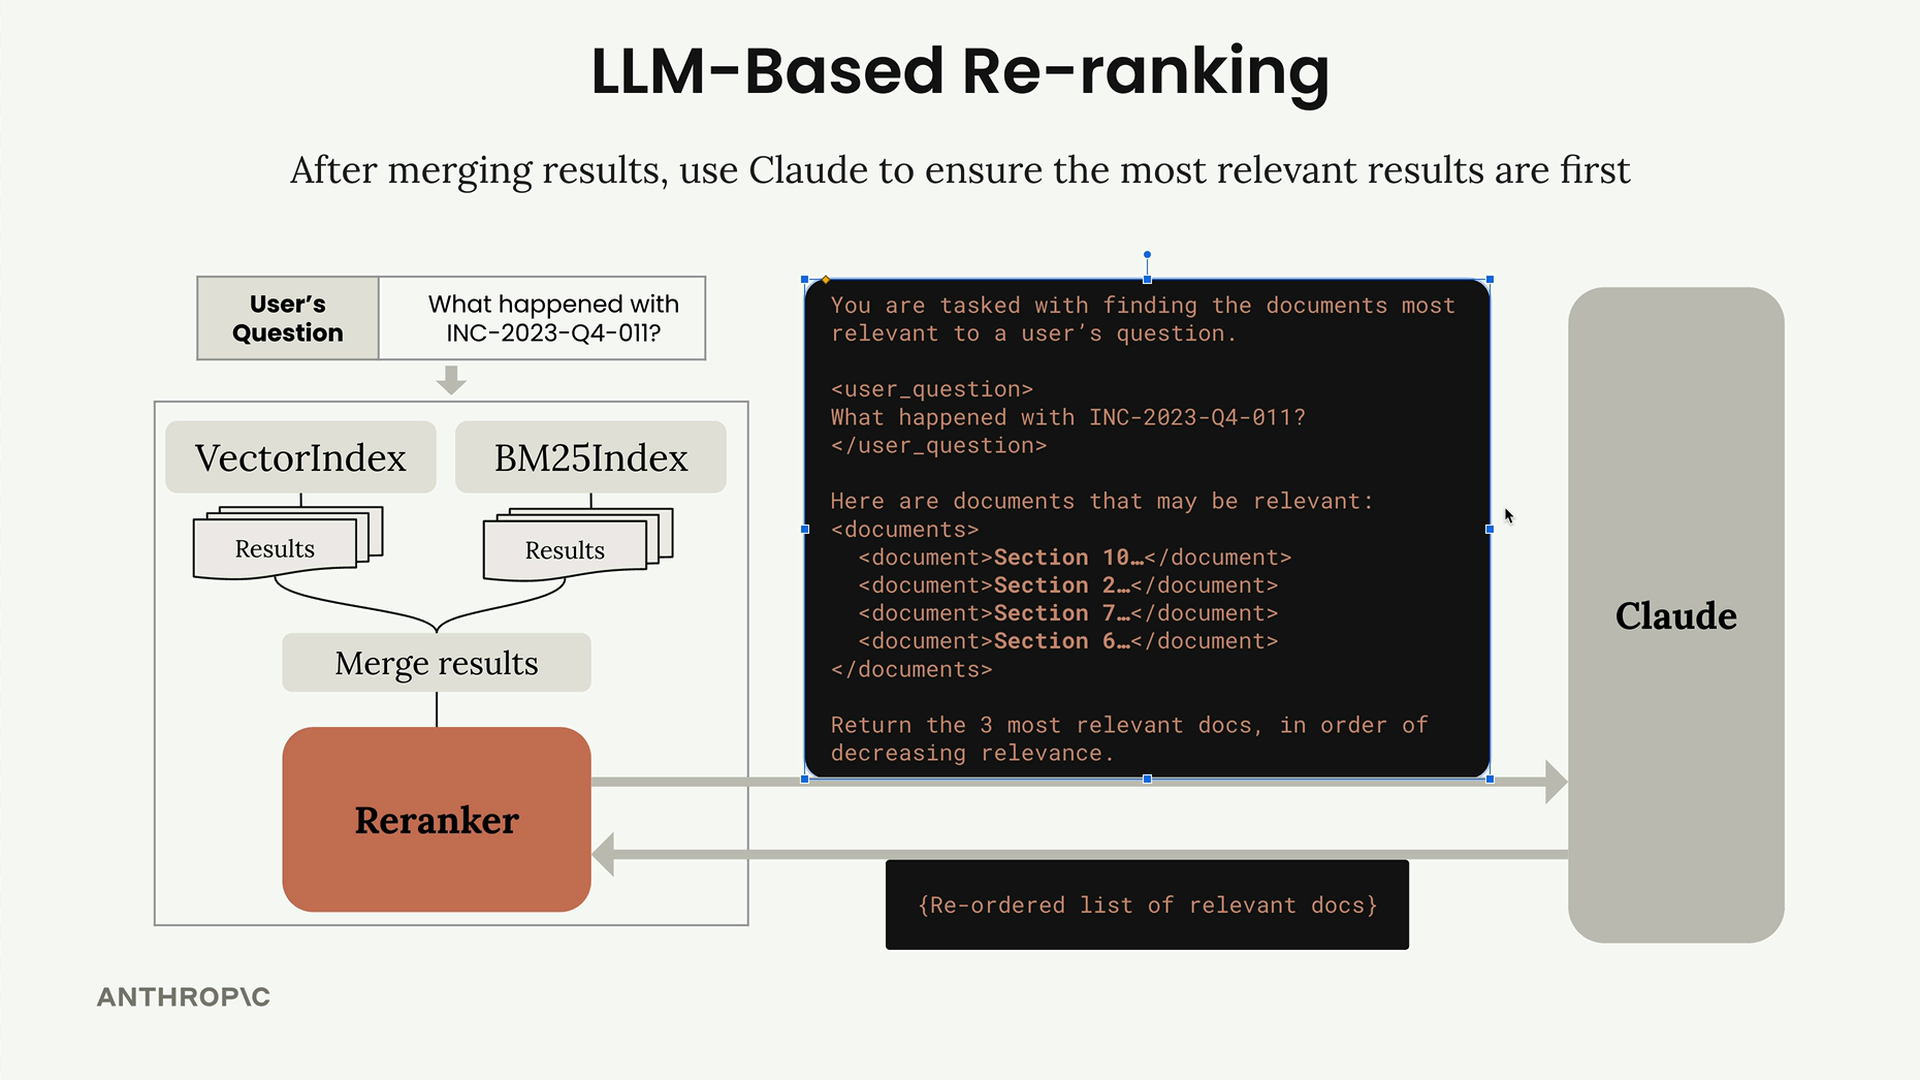
Voici comment le processus fonctionne :
- Exécutez votre recherche hybride (vecteur + BM25) comme d'habitude
- Fusionnez les résultats comme précédemment
- Transmettez les résultats fusionnés à une fonction de reclassement
- Le reclasseur envoie tout à Claude avec une invite spécifique
- Claude renvoie une liste réordonnée des documents les plus pertinents
Invites système
L'invite de reclassement est conçue pour être claire et précise. Vous fournissez à Claude la question de l'utilisateur et tous les documents qui semblent pertinents, puis vous demandez une tâche simple : renvoyer les documents les plus pertinents par ordre de pertinence décroissante.
Une structure d'invite typique ressemble à ceci :
You are tasked with finding the documents most relevant to a user's question.

<user_question>
What happened with INC-2023-Q4-011?
</user_question>

Here are documents that may be relevant:
<documents>
<document>Section 10...</document>
<document>Section 2...</document>
<document>Section 7...</document>
<document>Section 6...</document>
</documents>

Return the 3 most relevant docs, in order of decreasing relevance.Considérations d'efficacité
Demander à Claude de renvoyer des extraits de texte complets serait inefficace - vous attendriez que Claude copie de grandes quantités de texte. Au lieu de cela, attribuez à chaque extrait de texte un identifiant unique à l'avance. Demandez ensuite à Claude de renvoyer uniquement ces identifiants dans le bon ordre.
Cette approche est beaucoup plus rapide car Claude n'a besoin de renvoyer qu'une simple liste comme ["1p5g", "51n3", "ab83"] au lieu de copier des sections entières de documents.
Implémentation
La fonction de reclassement est appelée automatiquement par votre récupérateur après la recherche hybride initiale. Voici la structure de base :
def reranker_fn(docs, query_text, k):
    # Formater les documents avec des IDs
    joined_docs = "\n".join([
        f"<document><document_id>{doc['id']}</document_id>"
        f"<document_content>{doc['content']}</document_content></document>"
        for doc in docs
    ])

    # Créer un prompt avec la question de l'utilisateur et les documents
    prompt = f"""You are about to be given a set of documents...
    {query_text}
    {joined_docs}
    """

    # Obtenir la réponse de Claude et analyser les IDs de documents
    result = chat(messages, stop_sequences=["```"])
    return json.loads(result["text"])["document_ids"]
Résultats
Lorsque vous testez le reclasseur avec des requêtes comme « Qu'a fait l'équipe d'ingénierie concernant INC-2023-Q4-011 ? », vous devriez voir des résultats plus pertinents en haut de la liste. Claude comprend le contexte et peut identifier qu'une requête concernant l'équipe d'ingénierie devrait privilégier la section ingénierie logicielle par rapport à d'autres sections qui mentionnent simplement l'incident.
Le compromis est clair : le reclassement augmente la latence car vous devez attendre la réponse de Claude, mais il améliore considérablement la précision de la recherche en exploitant la compréhension du contexte et de la pertinence par Claude.