Lorsque vous avez besoin que Claude génère des données structurées comme du JSON, du code Python ou des listes à puces, vous rencontrerez souvent un problème courant : Claude veut être utile et ajoute du texte explicatif, des en-têtes ou un formatage markdown autour de votre contenu. Ce commentaire supplémentaire nuit à l'expérience utilisateur lorsque vous avez simplement besoin des données brutes.
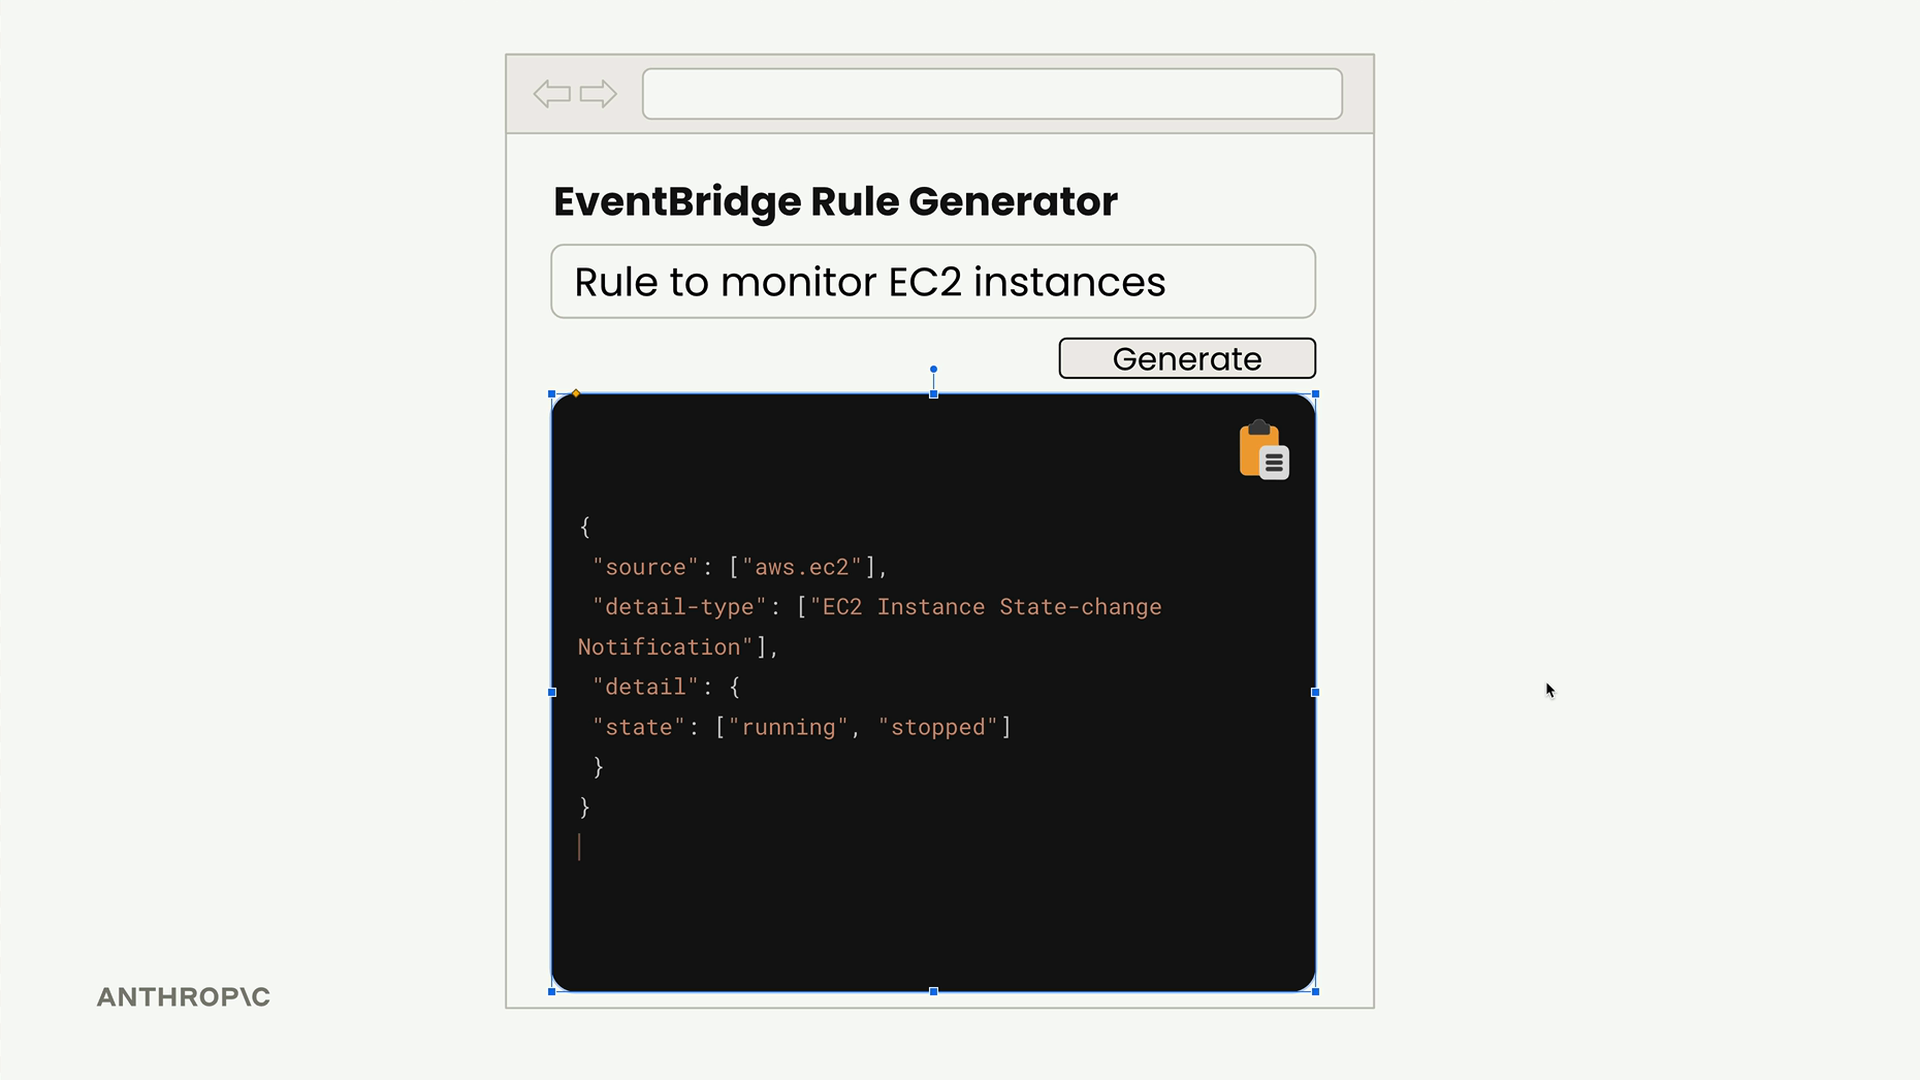
Imaginez que vous construisez une application web qui génère des règles AWS EventBridge. Les utilisateurs saisissent une description, cliquent sur générer, et s'attendent à voir du JSON propre qu'ils peuvent immédiatement copier et utiliser. Si Claude renvoie le JSON enveloppé dans des blocs de code markdown avec du texte explicatif, les utilisateurs ne peuvent pas simplement copier l'ensemble de la réponse - ils doivent sélectionner manuellement uniquement la partie JSON.
Le problème avec les réponses par défaut
Par défaut, Claude a tendance à formater la sortie structurée ainsi :
# EventBridge Rule
```json
\{
  "source": ["aws.ec2"],
  "detail-type": ["EC2 Instance State-change Notification"],
  "detail": \{"state": ["running"]\}
\}
```
This rule captures EC2 instance state changes when instances start running or stop.
Bien que cela soit excellent pour la documentation, c'est problématique lorsque vous avez besoin uniquement du JSON pour une utilisation programmatique.
La solution : préremplissage du message de l'assistant + séquences d'arrêt
Vous pouvez combiner le préremplissage du message de l'assistant avec des séquences d'arrêt pour obtenir exactement le contenu que vous souhaitez. Voici comment cela fonctionne :
messages = []
add_user_message(messages, "Generate a very short event bridge rule as json")
add_assistant_message(messages, "```json")

text = chat(messages, stop_sequences=["```"])
Cette technique fonctionne en :
- Préremplissant le message de l'assistant avec le délimiteur markdown d'ouverture
- Définissant une séquence d'arrêt pour interrompre la génération lorsque Claude tente de fermer le bloc de code
- Capturant uniquement le contenu entre ces délimiteurs
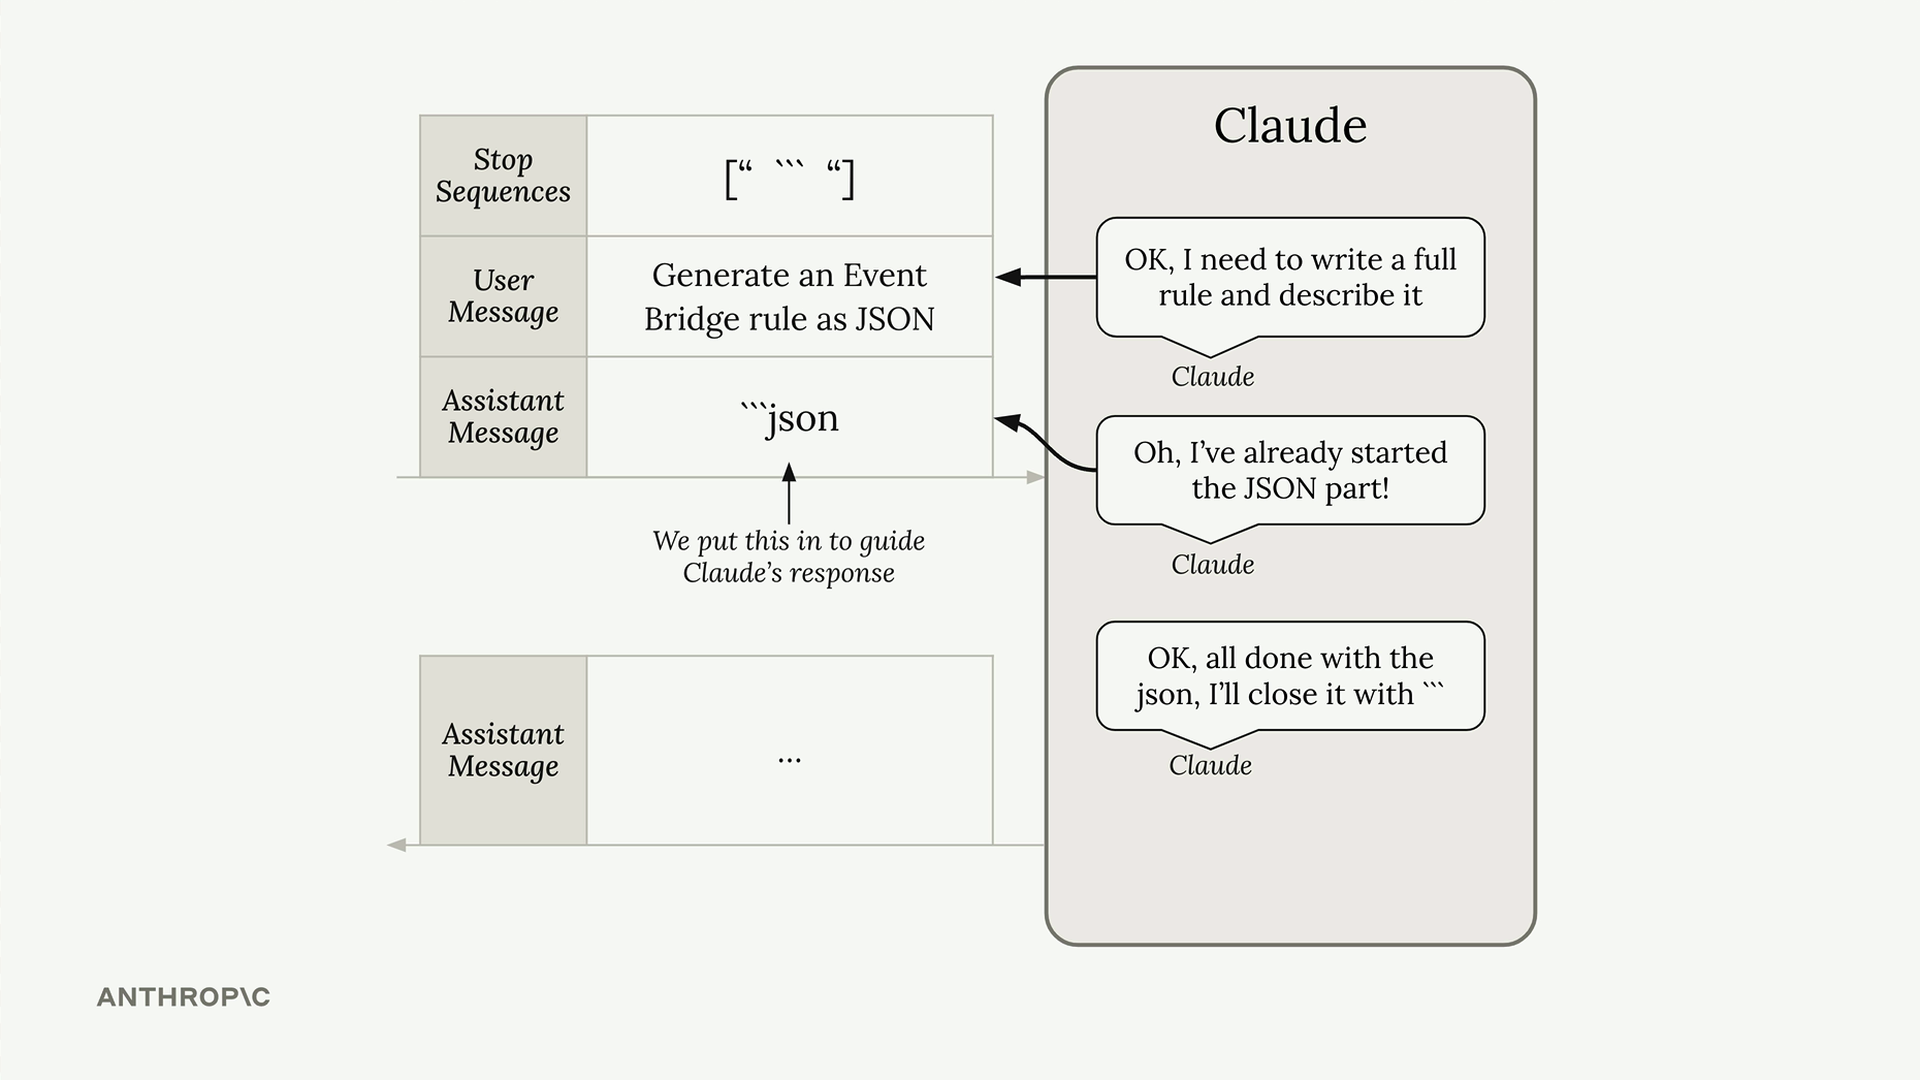
Comment cela fonctionne en arrière-plan
Lorsque Claude reçoit votre requête, il voit le message de l'assistant prérempli et suppose qu'il a déjà commencé à écrire le bloc de code JSON. Au lieu d'ajouter son propre en-tête et délimiteur d'ouverture, Claude passe directement à la génération du contenu JSON réel.
Lorsque Claude termine le JSON et souhaite naturellement fermer le bloc de code markdown avec ```, la séquence d'arrêt interrompt immédiatement la génération et renvoie la réponse. Vous obtenez uniquement le contenu JSON sans formatage supplémentaire.
Traitement des résultats
Le texte renvoyé peut contenir quelques caractères de retour à la ligne, mais vous pouvez facilement nettoyer cela :
import json

# Analyser en JSON pour valider et formater
parsed_data = json.loads(text.strip())

# Ou simplement supprimer les espaces pour les autres types de données
clean_text = text.strip()
Au-delà du JSON
Cette technique ne se limite pas à la génération de JSON. Vous pouvez l'utiliser pour toute donnée structurée où vous souhaitez uniquement le contenu sans la tendance naturelle de Claude à ajouter du texte explicatif :
- Extraits de code Python
- Listes à puces
- Données CSV
- Fichiers de configuration
- Tout format où une sortie propre et copiable est importante
La clé consiste à identifier quels délimiteurs Claude utiliserait naturellement autour de votre type de contenu, puis à préremplir le délimiteur d'ouverture et à s'arrêter au délimiteur de fermeture. Cela vous donne un contrôle précis sur le format de sortie tout en exploitant les instincts naturels de formatage de Claude.