在將文件分割成區塊後,RAG 管線的下一步是找出哪些區塊與使用者的問題最相關。這基本上是一個搜尋問題——您需要檢視所有的文字區塊,並找出與使用者所詢問內容相關的區塊。
尋找相關區塊
挑戰在於判斷哪些區塊與使用者的問題「相關」。這並不像關鍵字比對那麼簡單——您需要理解問題和區塊兩者的意義與上下文。
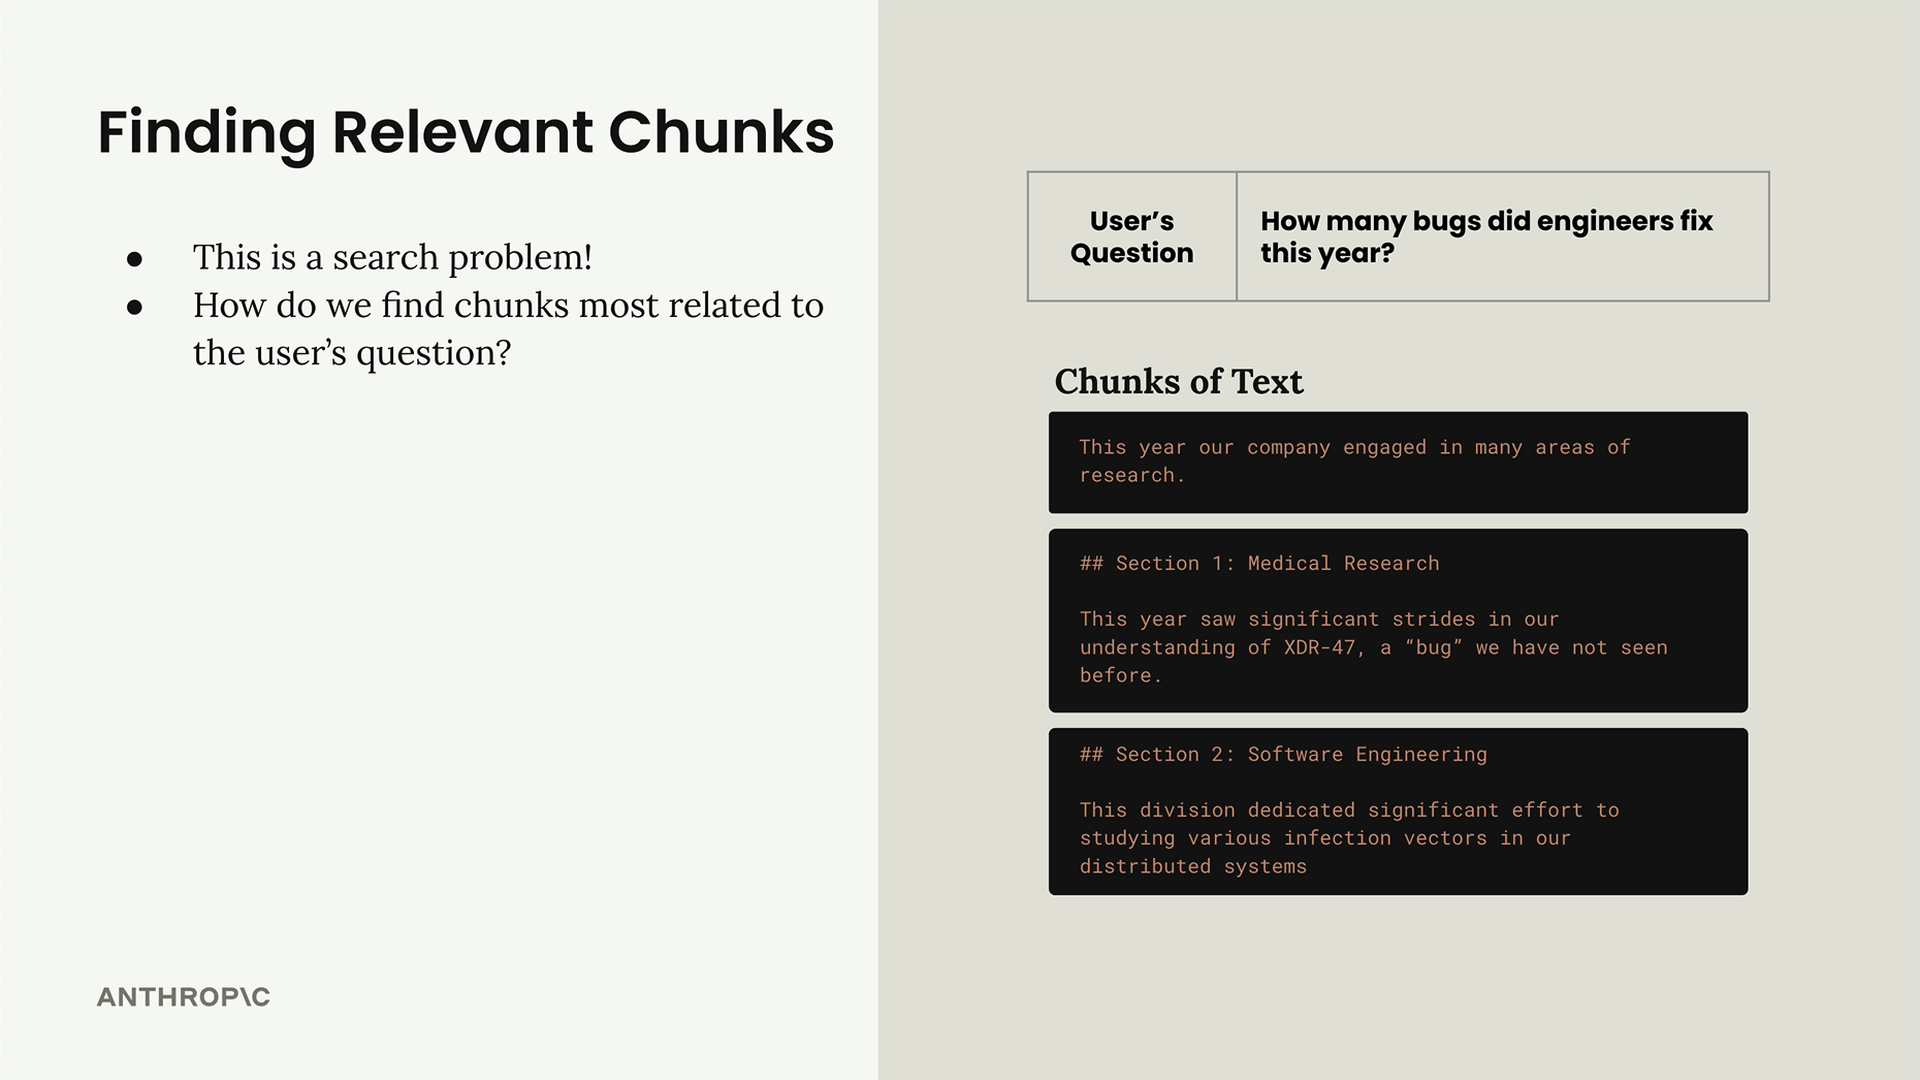
最常見的解決方案是語意搜尋,它使用文字嵌入來理解每段文字實際上在講什麼,而不僅僅是尋找完全相符的字詞。
什麼是文字嵌入?
文字嵌入是某段文字所包含意義的數值表示。可以將其視為將文字和句子轉換成電腦能夠以數學方式處理的格式。
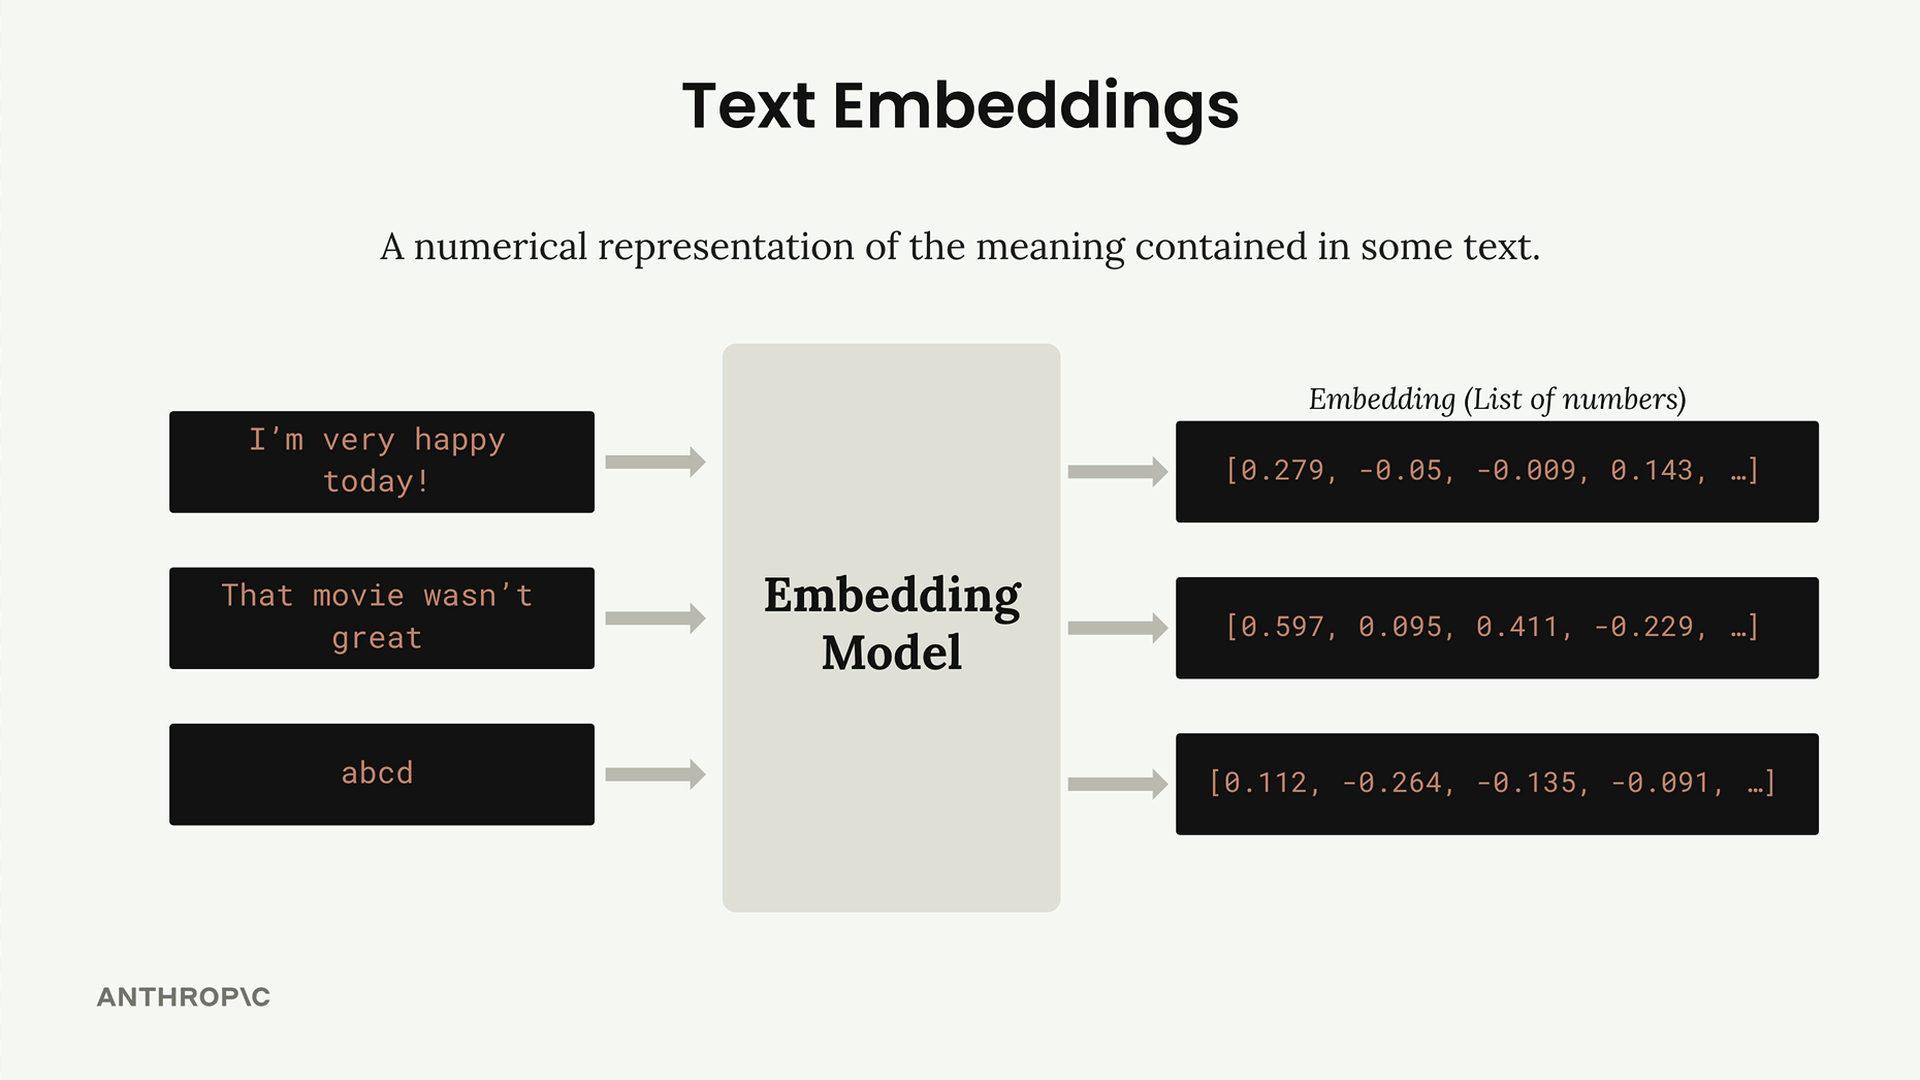
運作方式如下:
- 您將文字輸入嵌入模型
- 模型輸出一長串數字(通常是 1024 個數字)
- 每個數字代表輸入文字某種特質的「分數」
- 這些數字的範圍從 -1 到 +1
理解這些數字
嵌入中的每個數字就像是文字某個面向的分數。雖然我們並不確切知道每個位置代表什麼,但將它們視為衡量不同特質會很有幫助。
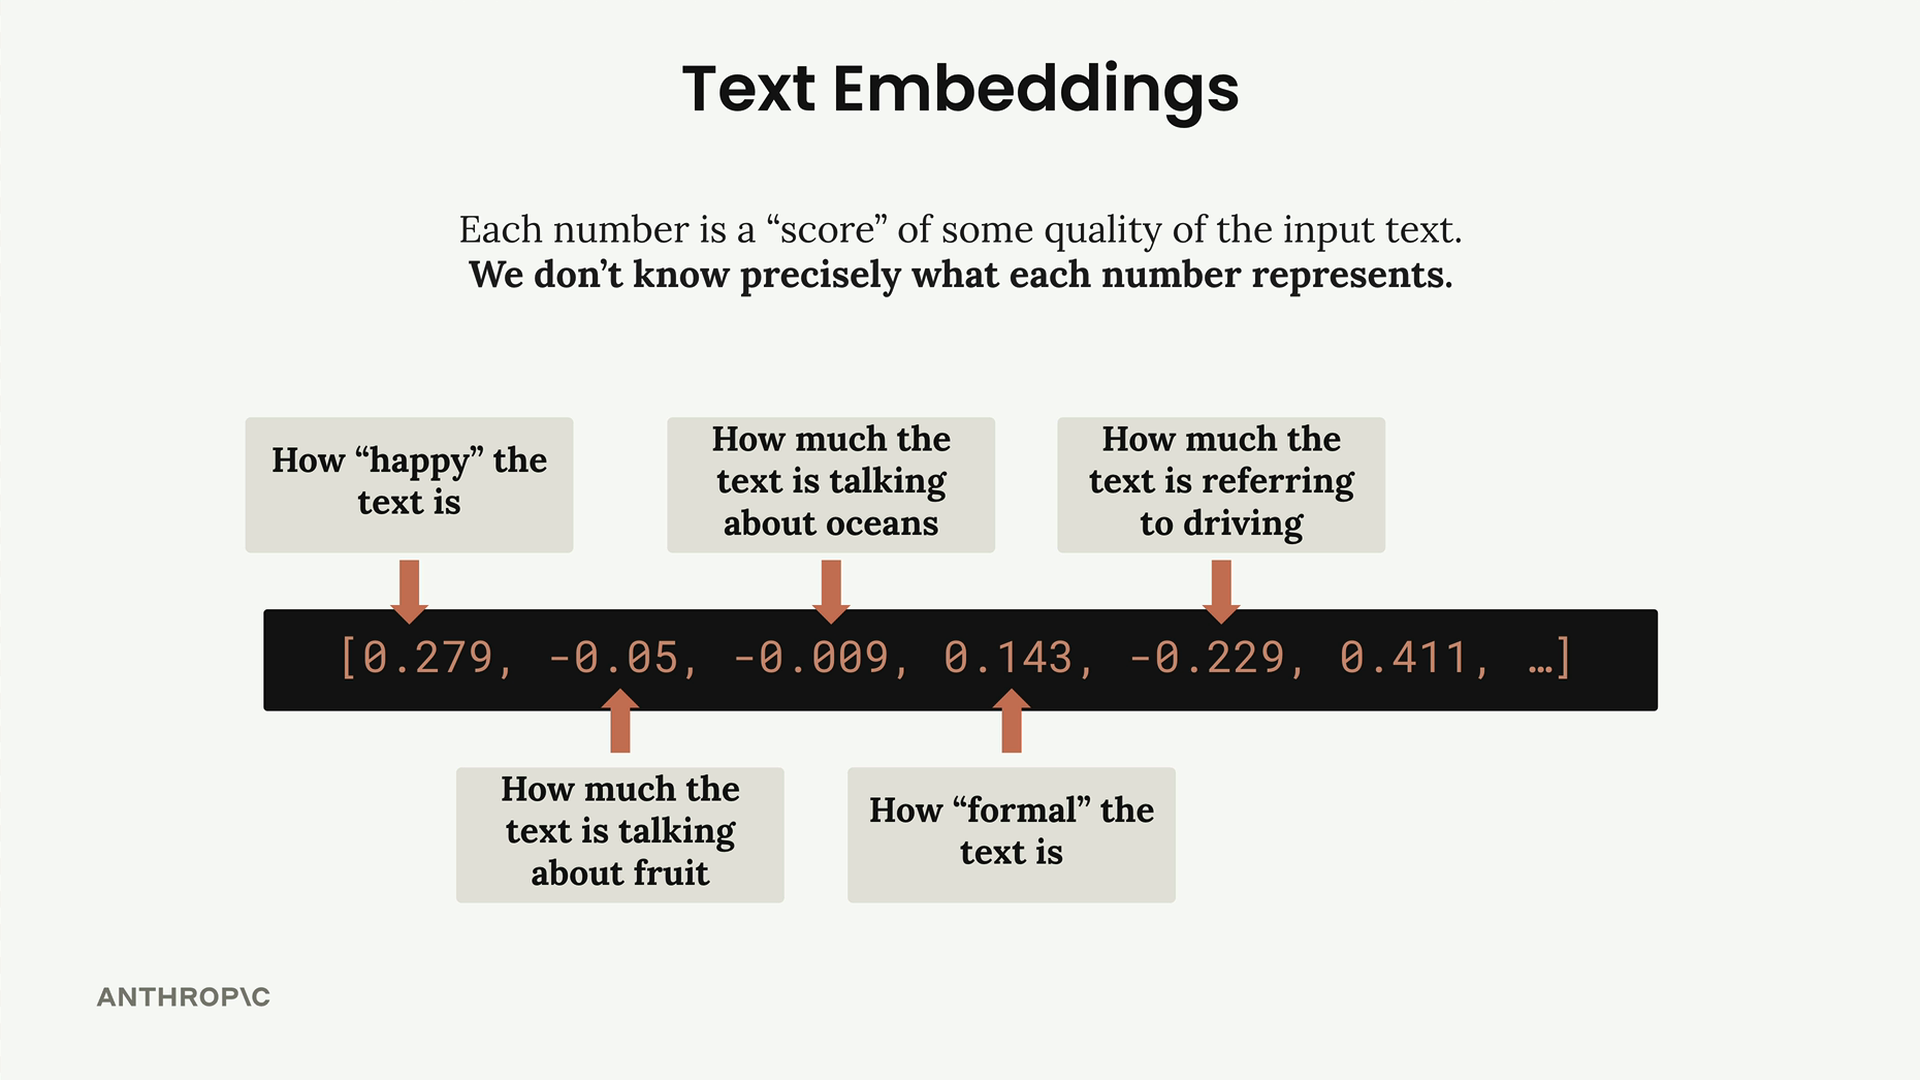
舉例來說,某個數字可能為「文字有多快樂」打分,而另一個數字可能衡量「文字談論海洋的程度」。關鍵在於,我們實際上並不知道每個數字代表什麼——嵌入模型在訓練過程中學習這些模式,而這些模式並非人類可以解讀的。
用程式碼產生嵌入
建立嵌入非常簡單。以下是基本流程:
python
def generate_embedding(
    text,
    embedding_model_id="amazon.titan-embed-text-v2:0",
    dimensions=1024,
    normalize=True,
):
    request_body = {
        "inputText": text,
        "dimensions": dimensions,
        "normalize": normalize,
    }

    request_json = json.dumps(request_body)
    response = client.invoke_model(
        modelId=embedding_model_id,
        body=request_json,
        accept="application/json",
        contentType="application/json",
    )

    response_body = json.loads(response.get("body").read())
    return response_body["embedding"]
當您對一個文字區塊執行此函式時,您會得到一串 1024 個數字,代表該文字的語意意義。
請注意,您可能需要在 AWS Bedrock 主控台中申請存取 Titan 嵌入模型。如果版本 2 無法使用,版本 1 對於學習目的來說同樣適用。
為什麼嵌入對 RAG 很重要
當您意識到相似的文字會有相似的嵌入值時,嵌入的強大之處就變得顯而易見。這意味著您可以用數學方式比較使用者的問題與您的文件區塊,並找出語意上最相似的區塊——即使它們並未使用完全相同的字詞。
這種數值表示正是使語意搜尋成為可能的關鍵,並使其在 RAG 系統中尋找相關上下文方面,比簡單的關鍵字比對更加有效。