我們建立的混合檢索方法運作良好,但仍有一些粗糙之處。當您搜尋特定詞彙或使用縮寫時,結果可能無法完美排序。例如,詢問「工程團隊對 INC-2023-Q4-011 做了什麼?」可能會先返回網路安全部分,即使軟體工程部分與該特定查詢更相關。
基於 LLM 的重新排序
重新排序在合併向量索引和 BM25 索引的結果後,增加了另一個後處理步驟。這個概念很直接:取得您的搜尋結果,並要求 Claude 根據與使用者問題的相關性重新排序。
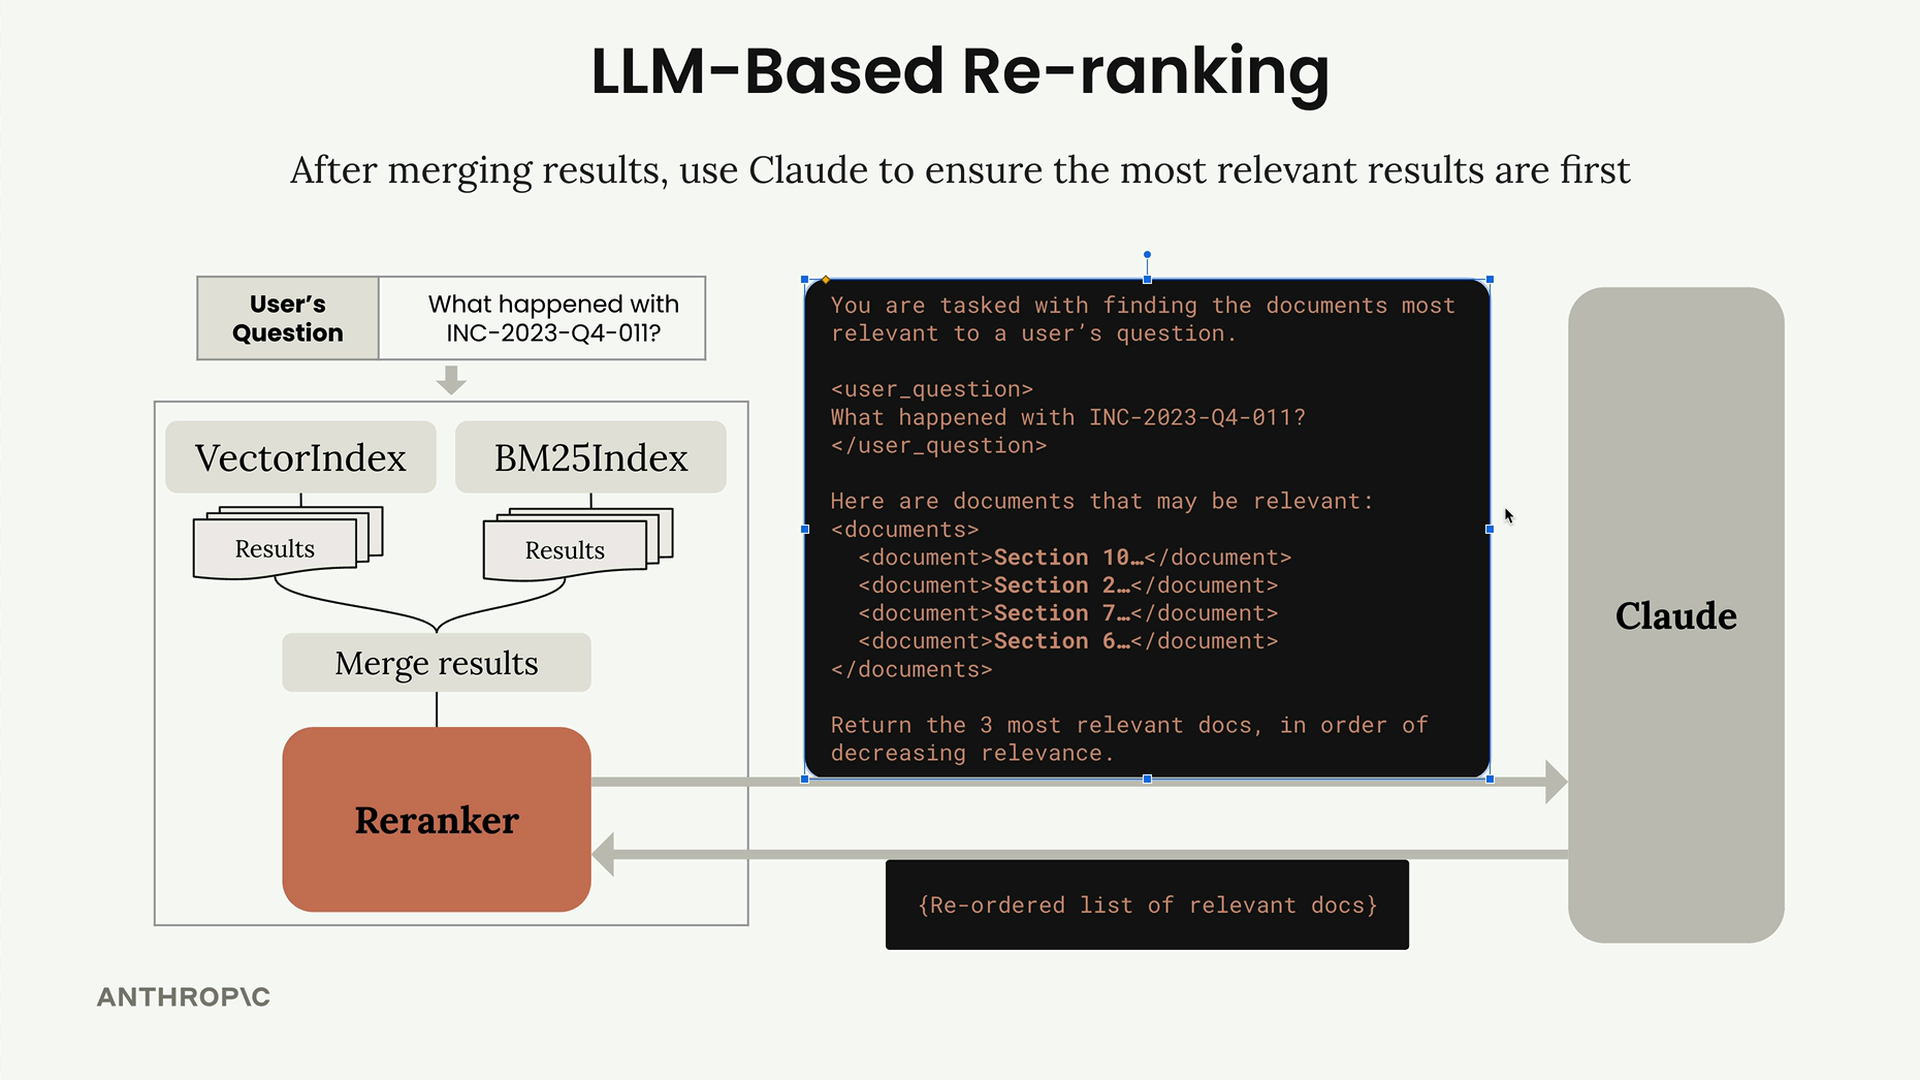
以下是此流程的運作方式:
- 照常執行您的混合搜尋(向量 + BM25)
- 像之前一樣合併結果
- 將合併後的結果傳遞給重新排序函式
- 重新排序器會將所有內容連同特定提示傳送給 Claude
- Claude 返回重新排序後的最相關文件清單
系統提示
重新排序提示的設計旨在清晰且具體。您向 Claude 提供使用者的問題以及所有看起來相關的文件,然後要求執行一個簡單的任務:依相關性遞減的順序返回最相關的文件。
典型的提示結構如下所示:
You are tasked with finding the documents most relevant to a user's question.

<user_question>
What happened with INC-2023-Q4-011?
</user_question>

Here are documents that may be relevant:
<documents>
<document>Section 10...</document>
<document>Section 2...</document>
<document>Section 7...</document>
<document>Section 6...</document>
</documents>

Return the 3 most relevant docs, in order of decreasing relevance.效率考量
要求 Claude 返回完整的文字區塊會很沒效率——您將需要等待 Claude 複製大量文字。相反地,請事先為每個文字區塊指定一個唯一的 ID。然後要求 Claude 僅以正確的順序返回這些 ID。
這種方法快得多,因為 Claude 只需要返回一個簡單的清單,例如 ["1p5g", "51n3", "ab83"],而不是複製整個文件區段。
實作
重新排序函式會在初始混合搜尋之後,由您的檢索器自動呼叫。以下是基本結構:
python
def reranker_fn(docs, query_text, k):
    # 格式化帶有 ID 的文件
    joined_docs = "\n".join([
        f"<document><document_id>{doc['id']}</document_id>"
        f"<document_content>{doc['content']}</document_content></document>"
        for doc in docs
    ])

    # 建立包含使用者問題與文件的提示
    prompt = f"""You are about to be given a set of documents...
    {query_text}
    {joined_docs}
    """

    # 取得 Claude 的回應並解析文件 ID
    result = chat(messages, stop_sequences=["```"])
    return json.loads(result["text"])["document_ids"]
結果
當您使用像「工程團隊對 INC-2023-Q4-011 做了什麼?」這樣的查詢測試重新排序器時,您應該會看到更相關的結果排在最前面。Claude 理解上下文,並能識別出關於工程團隊的查詢應優先考慮軟體工程部分,而非僅僅提及該事件的其他部分。
這個取捨很明顯:重新排序會增加延遲,因為您需要等待 Claude 的回應,但它透過利用 Claude 對上下文和相關性的理解,顯著提升了搜尋準確度。