擴展思考是 Claude 的進階功能,讓模型在生成最終回應之前有時間推理複雜問題。您可以將其想像成 Claude 的內心獨白——您可以看到它如何一步步處理您的問題。
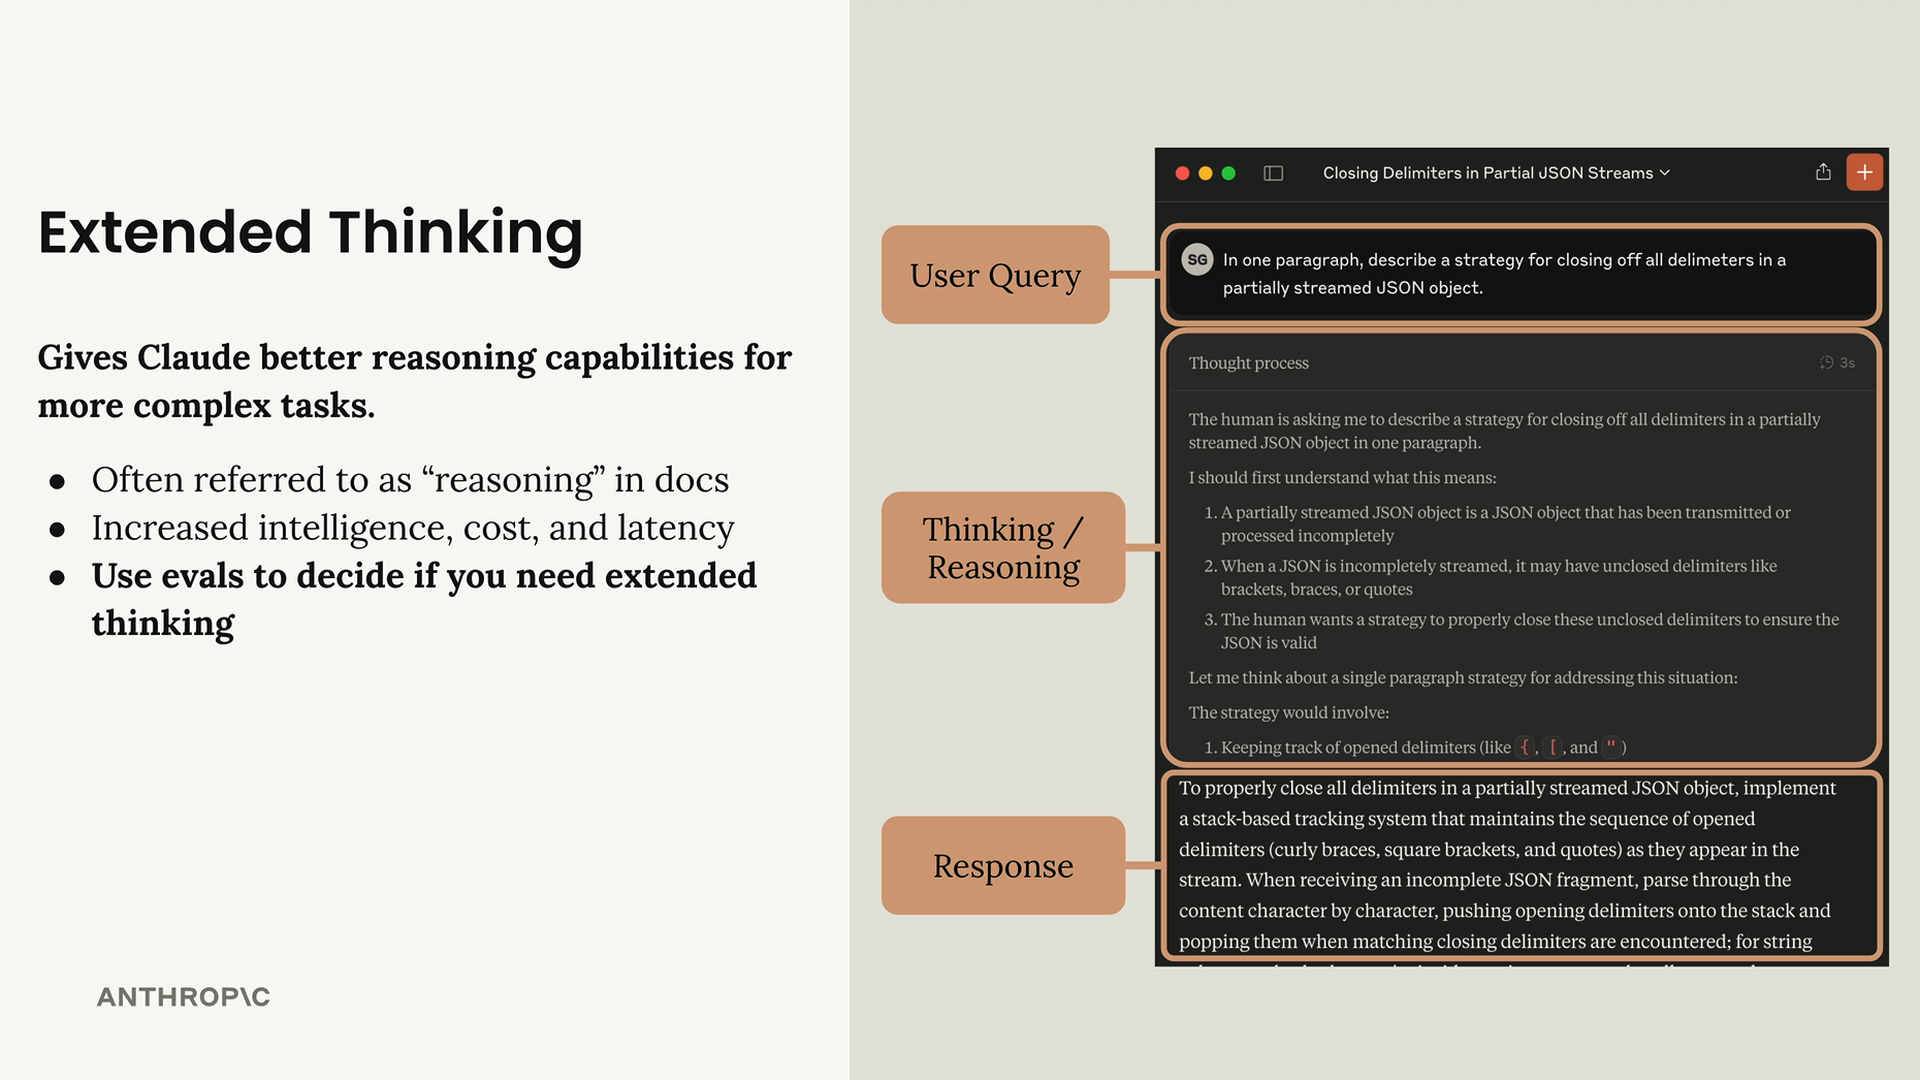
擴展思考如何運作
當您啟用擴展思考時,Claude 的回應會包含兩個部分,而不是一個:
- 推理內容部分 - Claude 的內部思考過程
- 文字部分 - 您實際想要的最終回應
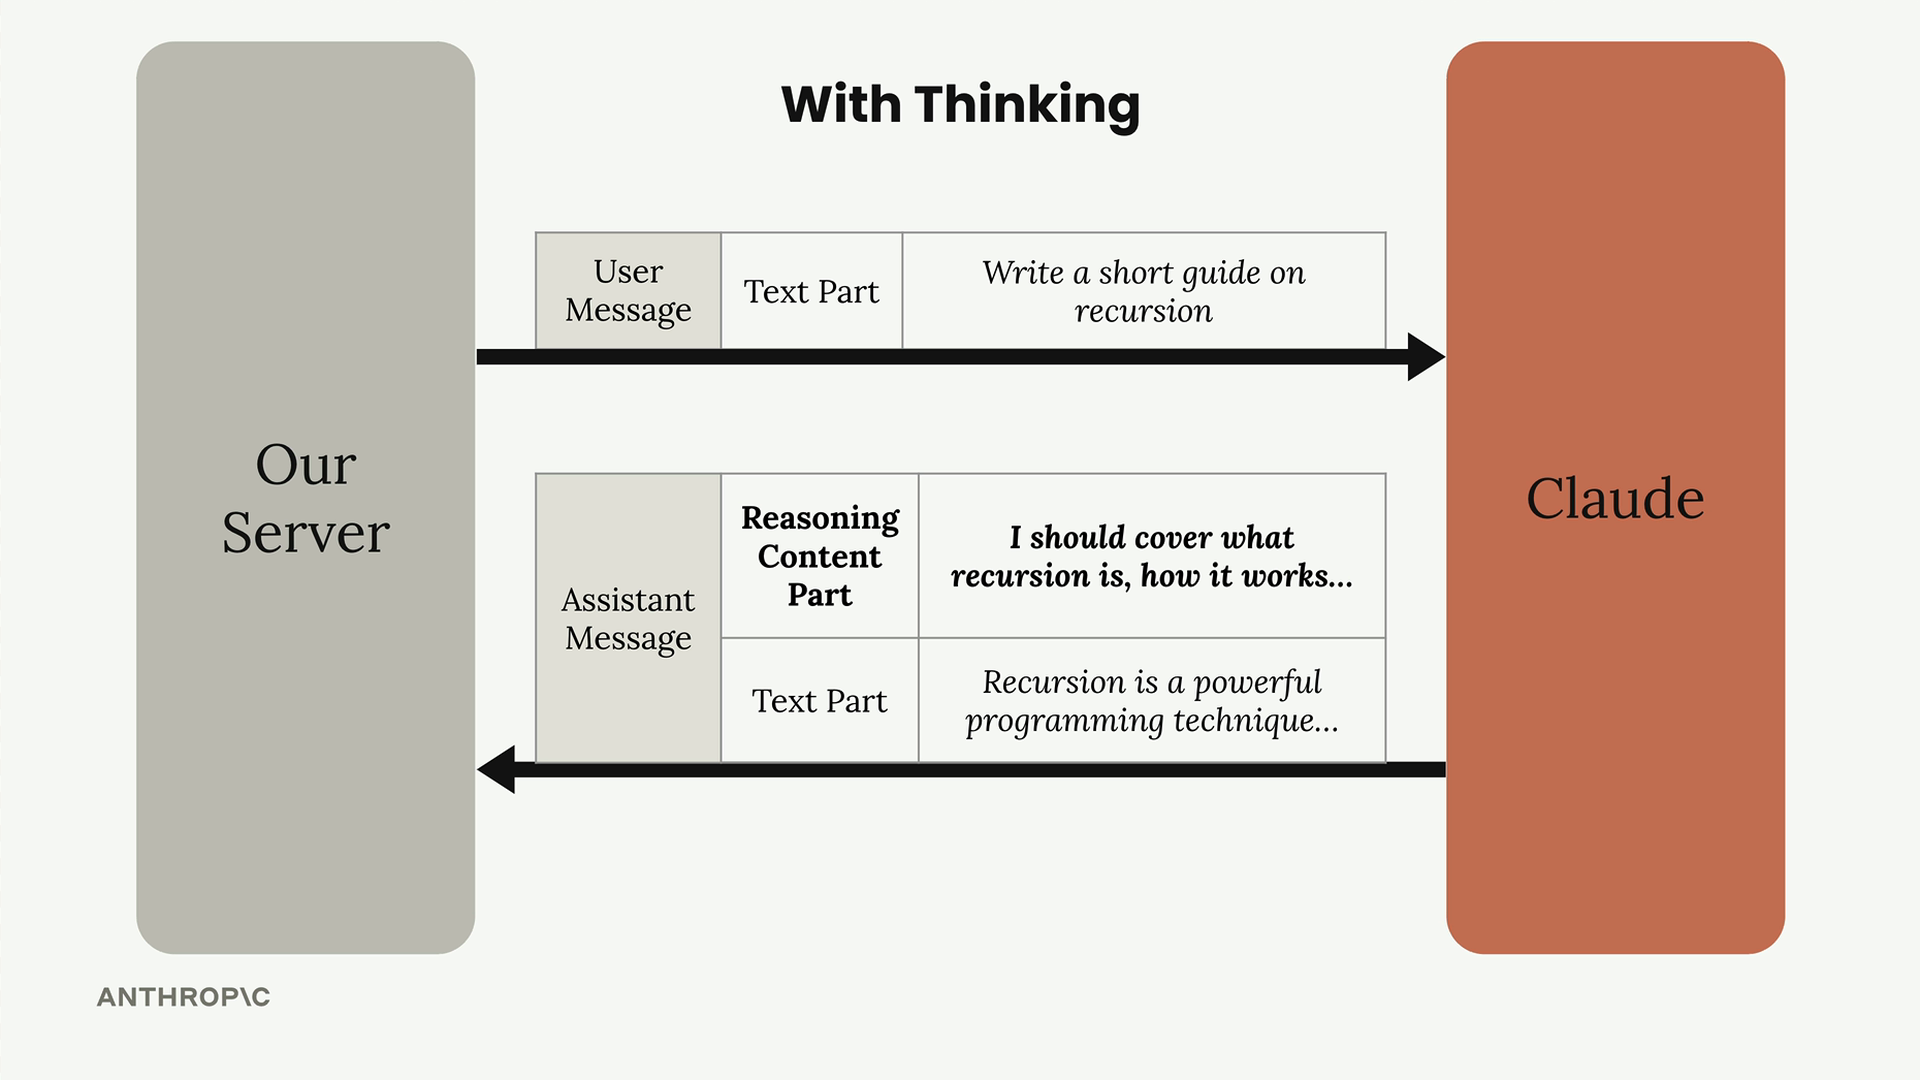
推理內容會準確地向您展示 Claude 如何拆解您的問題、考慮了哪些因素,以及它如何得出最終答案。這種透明度對於理解和除錯複雜任務而言,可能極具價值。
需要考量的取捨
擴展思考有明確的好處與成本:
- 在複雜任務上更高的準確性
- 更高的成本 - 您需要為所有思考權杖付費
- 增加的延遲 - 思考需要時間
關鍵的決策點很簡單:使用您的評估。如果您已經優化了提示,但仍未獲得所需的準確性,那就是該考慮使用擴展思考的時候了。
簽章系統
您會立即注意到的一個重要細節是附加在推理內容上的加密簽章:
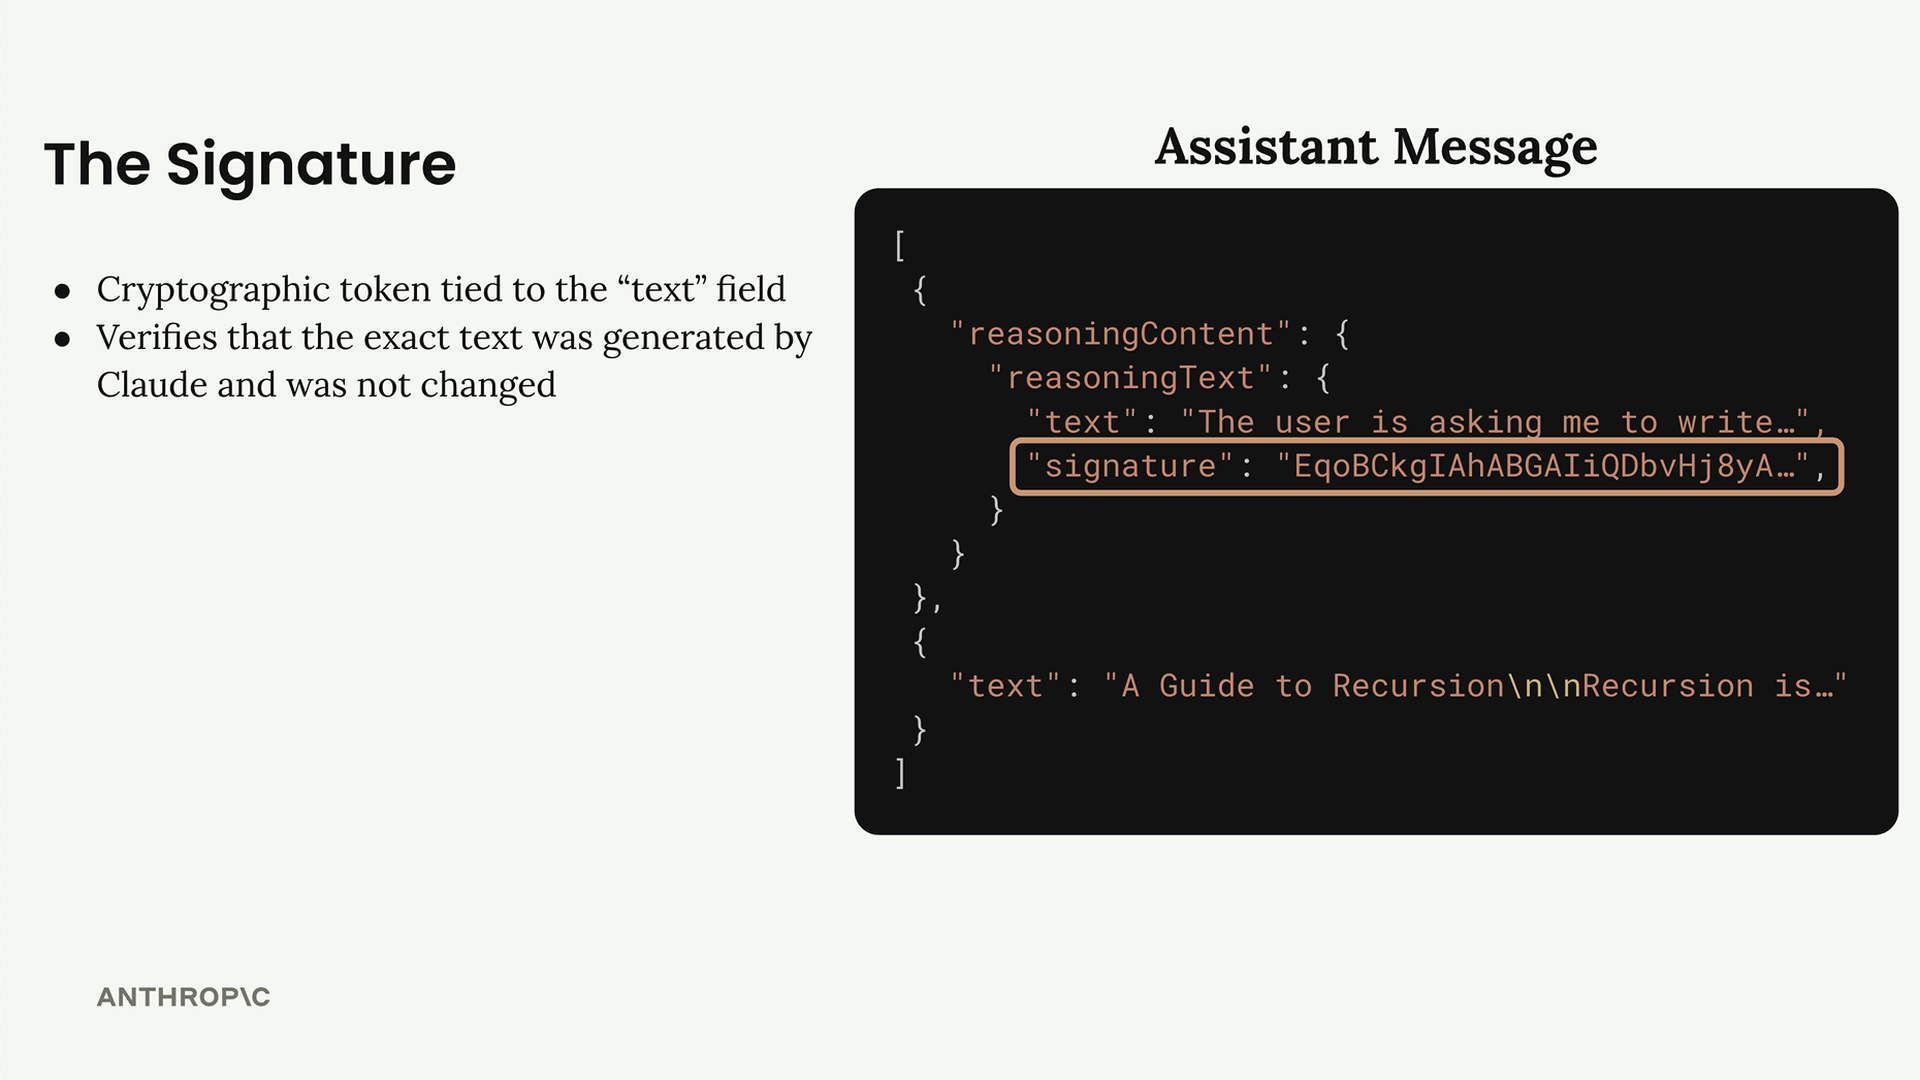
此簽章確保您無法修改思考文字。如果您想在後續對話中包含 Claude 先前的推理內容,該簽章會驗證內容未被竄改。這可以防止因修改過的推理文字而產生的潛在安全問題。
遭編輯的內容
有時 Claude 的思考內容會被安全系統標記。發生這種情況時,您會收到一個 redactedContent 欄位,而不是可讀的思考文字:
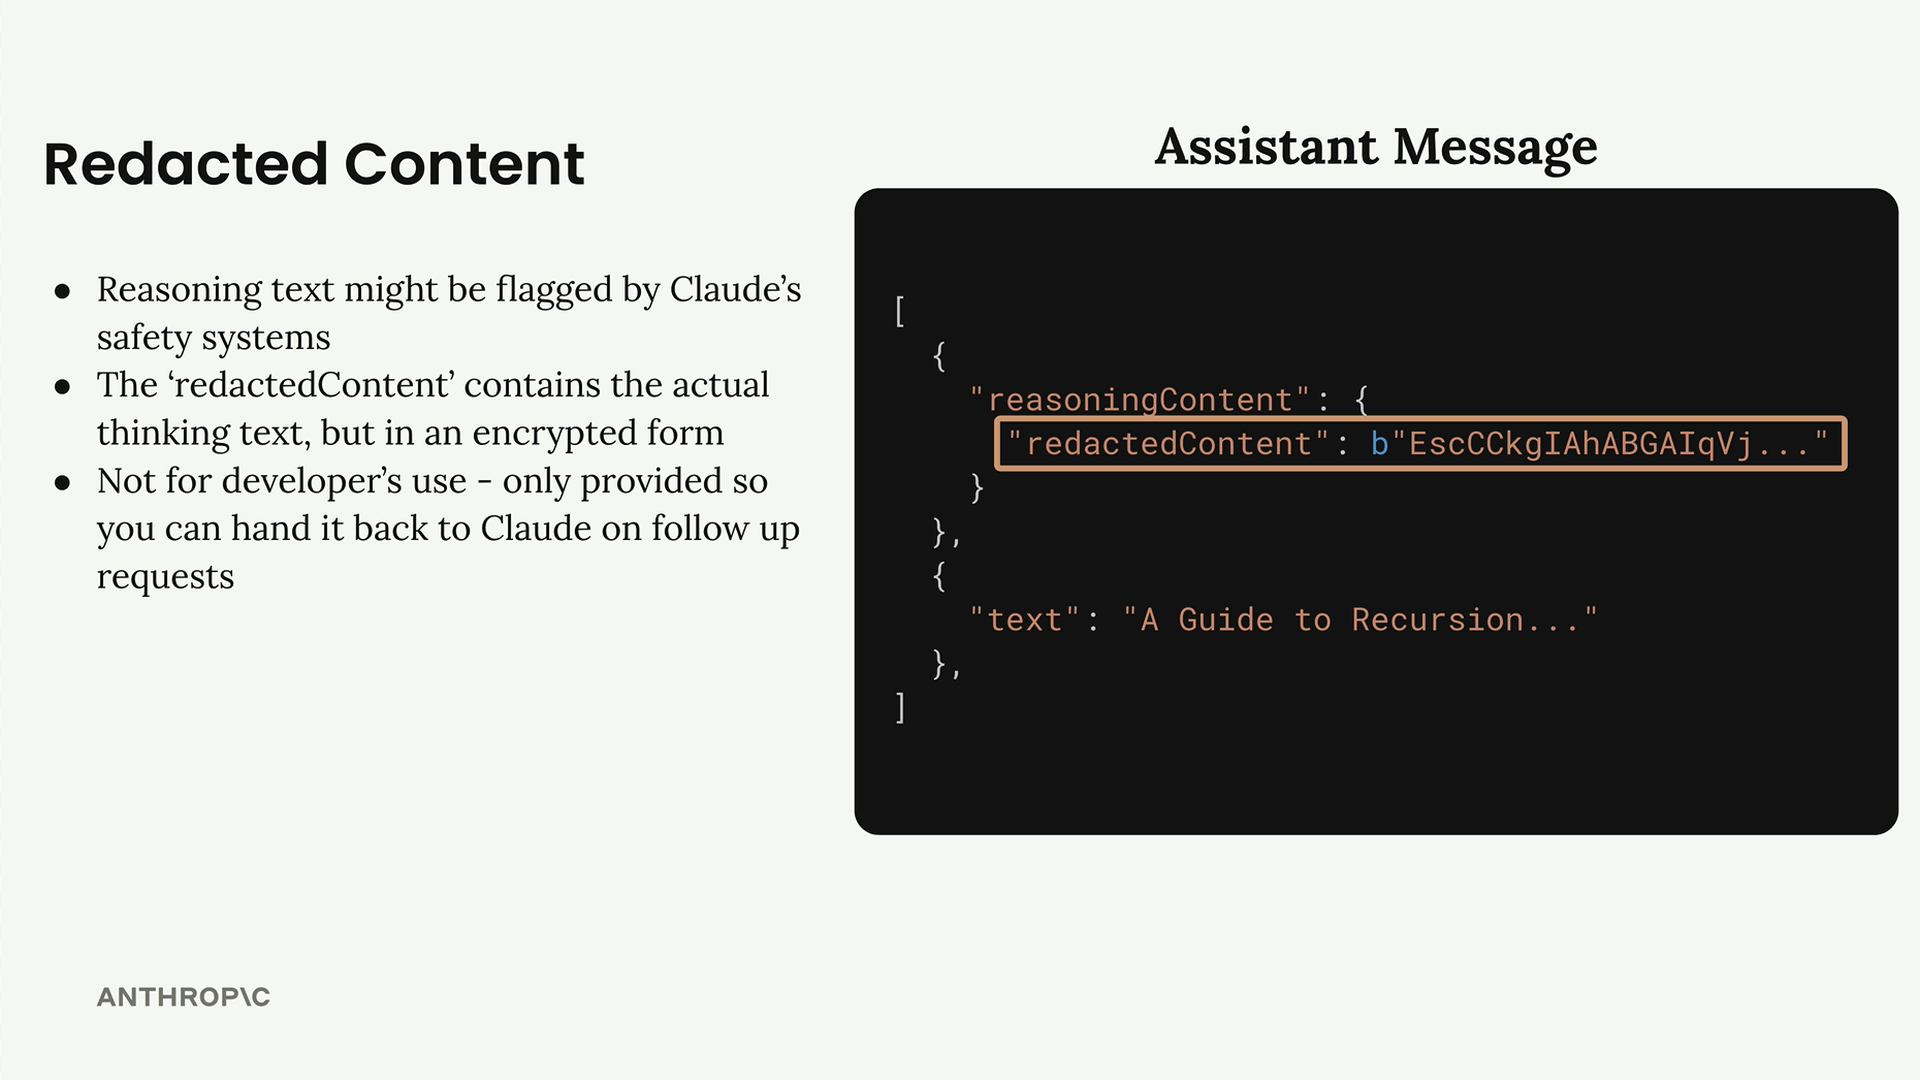
遭編輯的內容是經過加密的,但仍然可以運作——您可以在未來的對話中將其傳回給 Claude,而不會失去上下文。只是身為開發者的您無法讀取它。
實作
在目前的 Claude 模型上,例如 Claude Opus 5 和 Claude Sonnet 5,思考會以自適應思考(adaptive thinking)的方式運行,並且預設為開啟:Claude 會自行決定每個請求需要多少推理,無需管理權杖預算。這些模型除非您要求,否則會省略推理文字,因此請將 display 設為 summarized 以查看它:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
在開啟自適應思考的情況下,簡單的問題通常會很快得到回應,而較難的問題則會獲得更多的推理時間。為了引導 Claude 思考的程度,您可以將自適應思考與 effort 參數結合使用。effort 層級作為 Claude 思考分配的軟性指引,取代了您原本需要手動管理的權杖預算。
如果您以前使用過擴展思考,請注意手動設定正逐步淘汰:在 Claude Opus 4.6 和 Claude Sonnet 4.6 上,搭配 budget_tokens 的 thinking.type: "enabled" 已被棄用,而 Claude Opus 4.7 及更新的模型(包括 Claude Opus 5 和 Claude Sonnet 5)不再支援此設定,並會以 400 錯誤拒絕此類請求。請改用搭配 effort 參數的 thinking.type: "adaptive"。
不支援自適應思考的模型
Claude 4.5 系列模型(Claude Haiku 4.5、Claude Sonnet 4.5 和 Claude Opus 4.5)以及更早的模型不支援自適應思考。在這些模型上,您需要透過手動權杖預算來啟用擴展思考:
additional_model_fields["thinking"] = {
    "type": "enabled",
    "budget_tokens": thinking_budget
}
thinking_budget 控制 Claude 可以花費在推理上的權杖數量。最小值為 1024 個權杖,但對於複雜問題,您可能需要更多。與 Claude 的其他一切一樣,請使用您的評估來找出適合您使用情境的預算。
以下是更新後的聊天函式的樣子:
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    tool_choice="auto",
    text_editor=None,
    thinking=False,
    thinking_budget=1024
):
測試您的實作
在建置處理擴展思考的應用程式時,您會想要測試正常的推理內容以及遭編輯內容的情境。實際上有一個特殊的測試字串,可以強制 Claude 回傳遭編輯的內容——這對於確保您的程式碼能正確處理這兩種情況很有用。
關於擴展思考,最重要的要點是:是否使用它的決定應該始終以數據為依據。先執行您的評估,優化您的提示,只有在您需要為複雜任務提升準確性時,才考慮使用擴展思考。這種紀律建立在一個簡單的習慣上:在您追求更多能力之前,先決定什麼才算是「好」。當您知道任務所需的準確性時,您就能判斷擴展思考是否值得其成本,而不是靠猜測。
練習:親自執行自適應思考
透過觀察自適應思考做決策的過程,最容易理解它。在您一直在建置聊天函式的程式碼中,將其開啟:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
現在透過這個相同的設定發送兩個請求。首先問一個您已經知道答案的簡單事實性問題。然後問一個真正困難的問題,例如來自您自己工作中的多步驟分析問題。如果您使用的模型不支援自適應思考,請使用上一節中的手動 budget_tokens 設定來啟用思考,並執行相同的兩個請求。
檢查思考做了什麼
設定該旗標只能證明請求已被接受。以下這些檢查可以告訴您思考做了什麼:
- 確認思考已啟動。 每個回應現在應該包含兩個部分,推理內容和最終文字,而不是單純的文字。唯一的例外是遭編輯的內容,正如您先前所見:
redactedContent欄位表示思考已經運行,但文字已被加密。 - 閱讀推理內容。 檢查它是否真正針對您提出的問題進行推理,而不是只是重述問題。這與您稍後在除錯複雜任務時所依賴的透明度是一樣的。
- 比較這兩個請求。 簡單的問題通常會很快得到回應,推理較少,而困難的問題則會明顯獲得更多推理。這種差異正是自適應思考為您做出的分配決策。
- 權衡成本。 您需要為每個思考權杖付費,因此請檢查較難的答案是否比不使用思考時得到的答案更好。您的評估才是這方面的判斷依據,看到推理文字出現並不能取代它們。
值得從這堂課中保留的行為是:每當您在新任務上啟用擴展思考時,請在幾個具代表性的請求上閱讀推理內容,並在決定保留該設定之前重新執行您的評估。