建立自訂提示評估工作流程,首先要設定明確的目標並生成測試資料。在此案例中,我們要建立一個提示,協助使用者撰寫 AWS 專用程式碼——可能是 Python 函式、JSON 設定,或正規表達式——且不含額外的說明或格式。
設定目標
此提示應接收使用者的任務描述,並回傳以下三種輸出類型之一:
- Python 程式碼
- JSON 設定
- 正規表達式
關鍵要求是回應應僅包含所要求的程式碼,不含標頭、頁尾或說明。
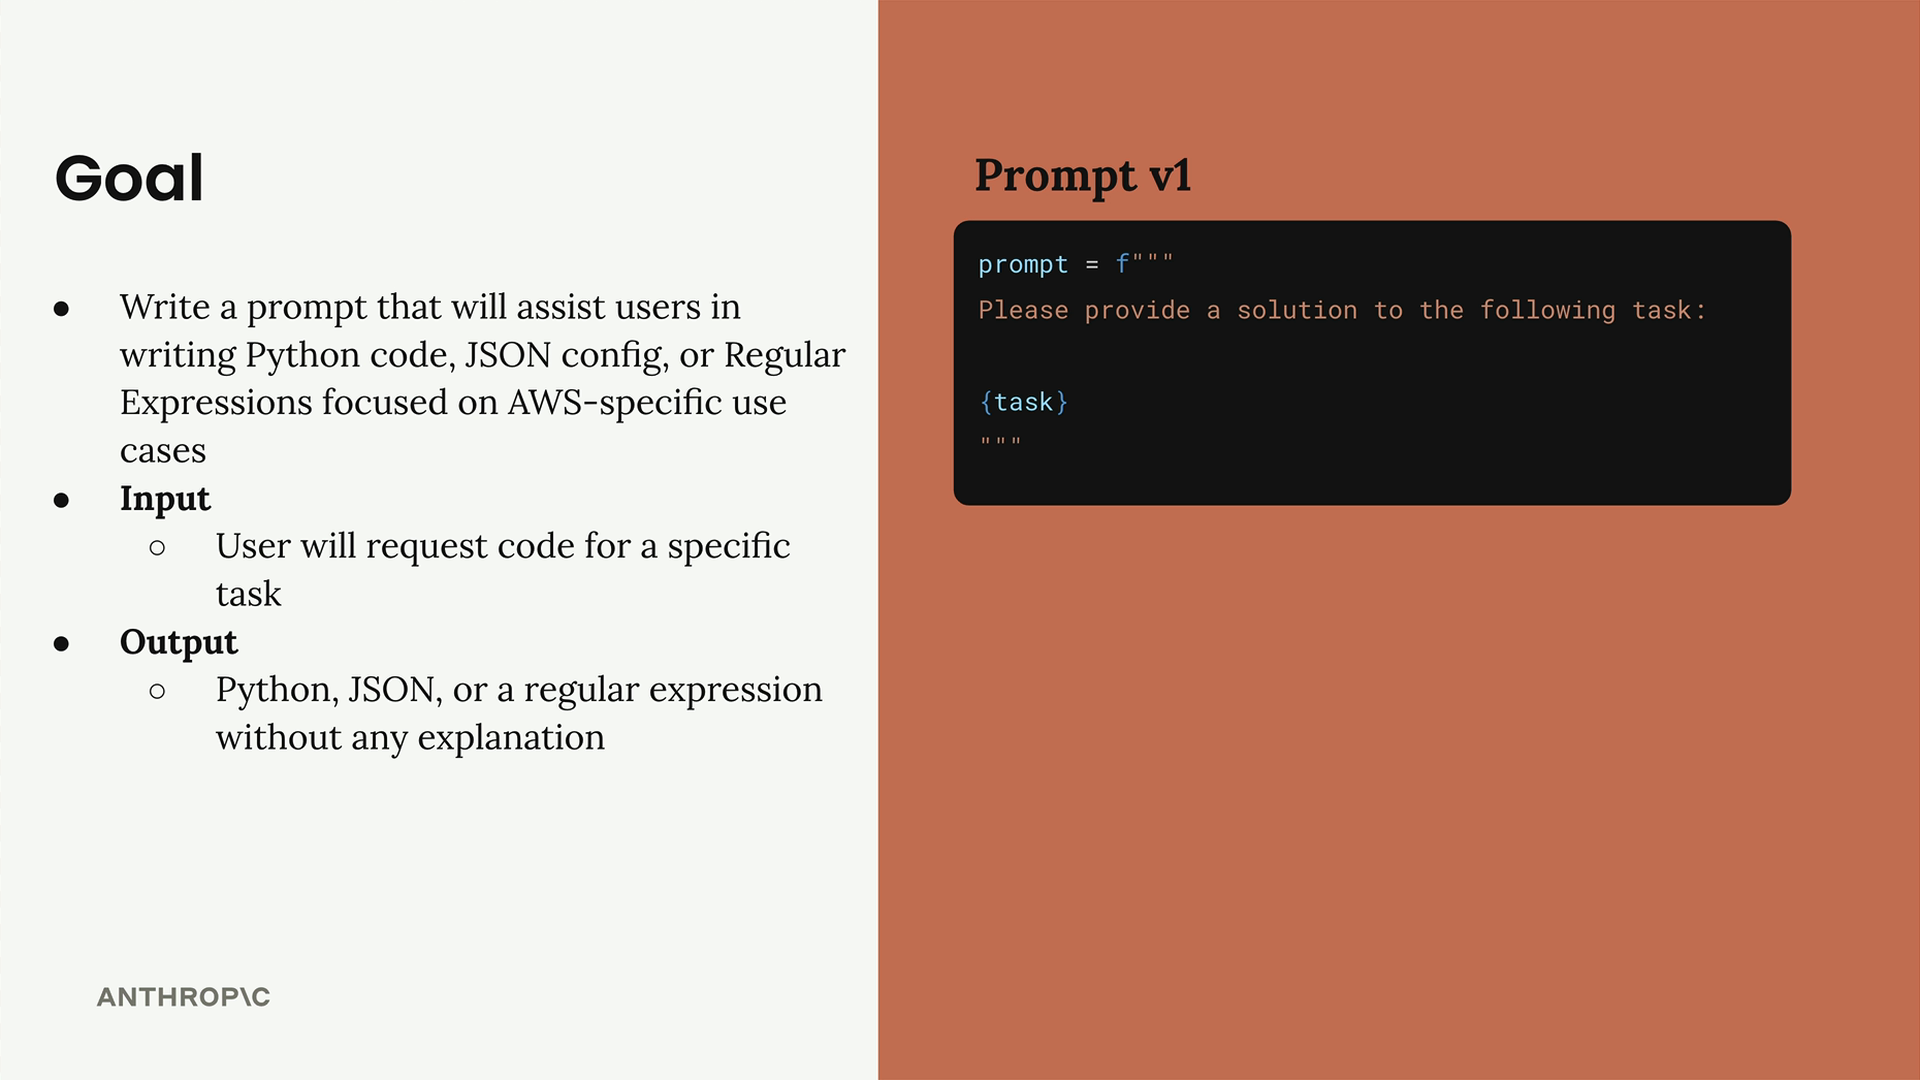
從簡單的初始版本開始,能讓事情更容易掌控。初始提示範本很直接:「請針對以下任務提供解決方案:{task}」
建立評估資料集
評估資料集包含您將輸入提示中的範例。每個測試案例會與您的提示結合,並傳送給 Claude,讓您了解提示在不同情境下的表現。
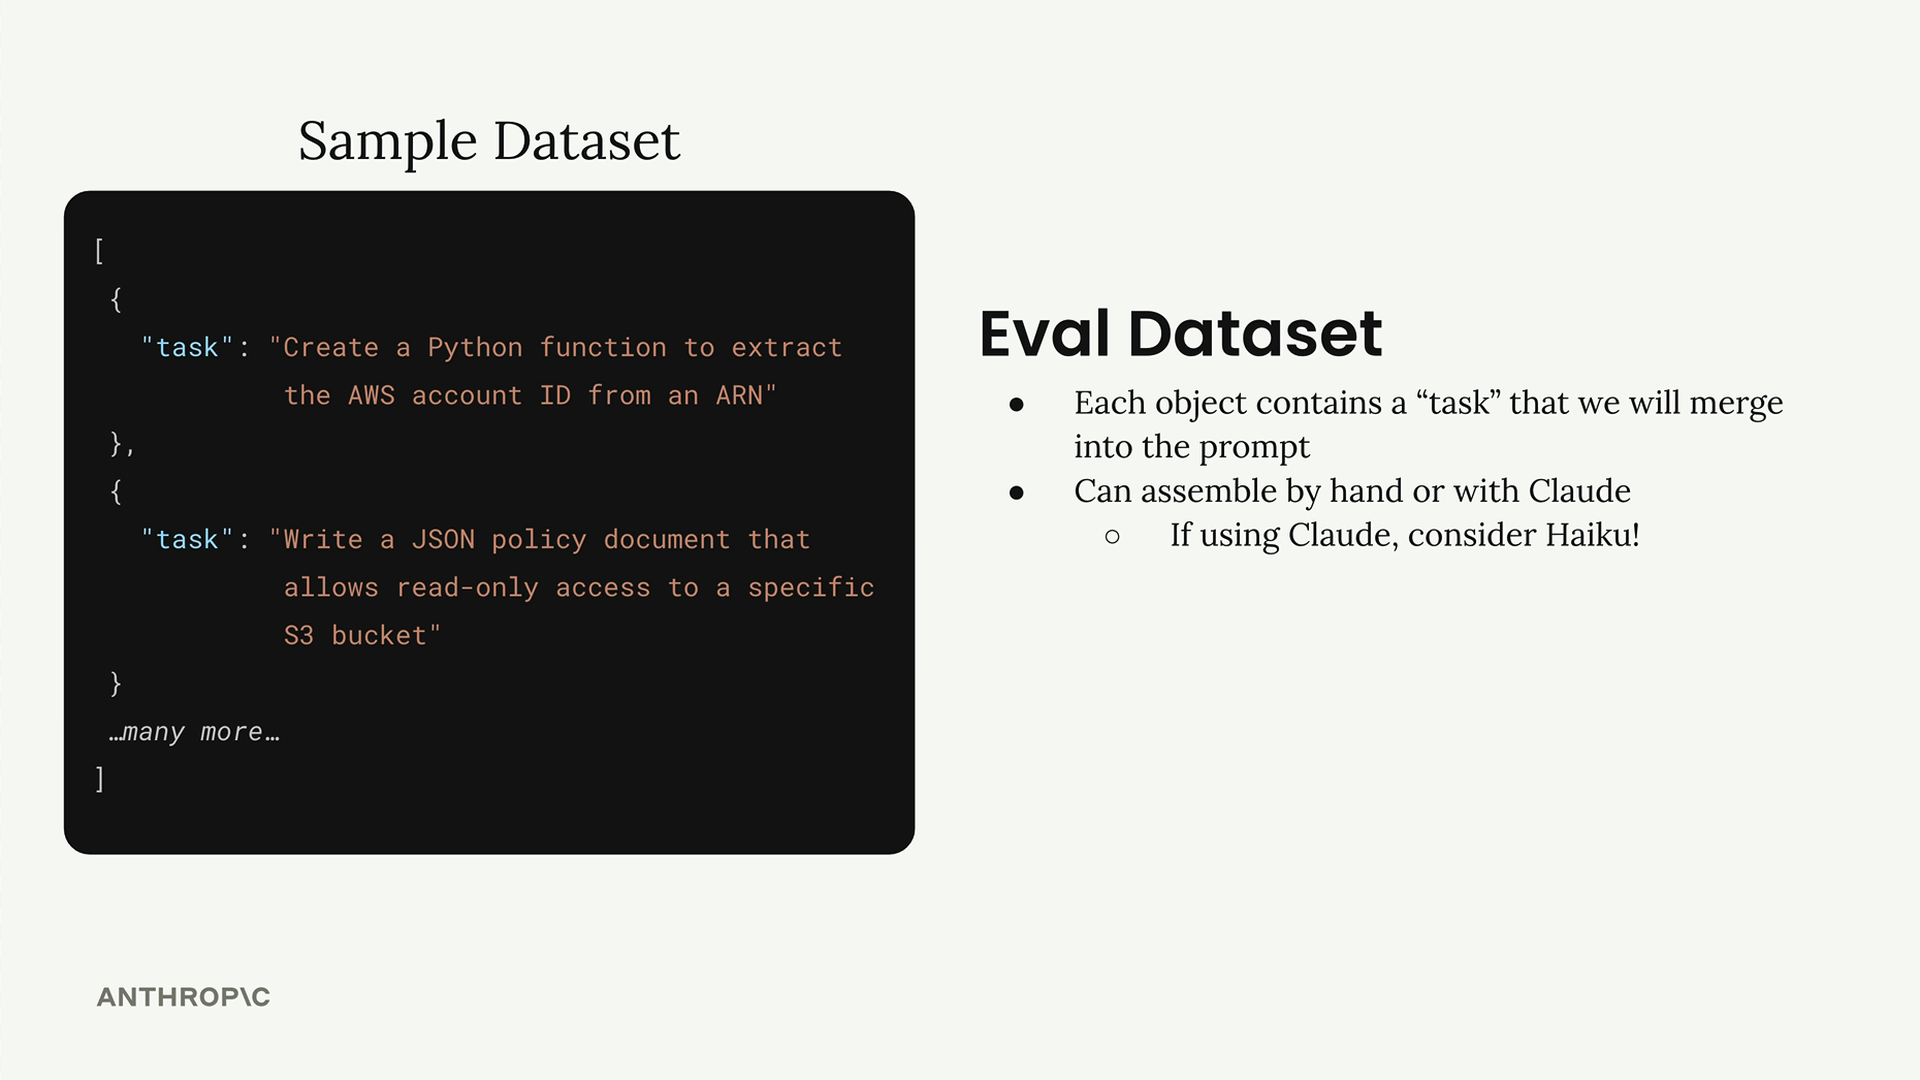
您可以用兩種方式建立資料集:
- 手動撰寫測試案例
- 使用 Claude 自動生成
對於自動生成,由於您要生成多個測試案例,使用像 Haiku 這樣較快速的模型是合理的選擇。
使用程式碼生成測試資料
資料集生成函式使用 Claude 來建立逼真的測試情境。以下是基本結構:
def generate_dataset():
    prompt = """
    Generate 3 AWS-related tasks that require Python, JSON, or Regex solutions.

    Focus on tasks that can be solved by writing a single Python function,
    a single JSON object, or tasks that do not require writing much code.

    Example output:
    [
        {
            "task": "Description of task"
        },
        ...additional
    ]

    Please generate 3 objects.
    """

    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
此方法使用預填助理訊息技術搭配停止序列,以提取乾淨的 JSON 回應。助理訊息以「```json」開頭,並在結尾的「```」處停止,確保您取得格式正確的資料。 ## 儲存您的資料集 生成後,請儲存資料集,以避免不斷重新生成: ``` dataset = generate_dataset() with open("dataset.json", "w") as f: json.dump(dataset, f, indent=2) ``` ` 生成的資料集會建立逼真的 AWS 任務,例如從 ARN 中提取帳戶 ID、為 EC2 設定撰寫 JSON 結構,以及為 S3 儲存桶名稱建立正規表達式模式。雖然三個測試案例適用於初期開發,但正式環境的評估需要更多且更多樣化的範例。 這個基礎為您提供了一個可重複的流程,用於建立符合您特定使用案例的評估資料集,為接下來執行評估和衡量提示效能的步驟做好準備。 `