文本分塊是建構 RAG(Retrieval Augmented Generation,檢索增強生成)管線中最關鍵的步驟之一。您如何分割文件會直接影響整個系統的品質。不良的分塊策略可能導致不相關的上下文被插入到您的提示中,使您的 AI 給出完全錯誤的答案。
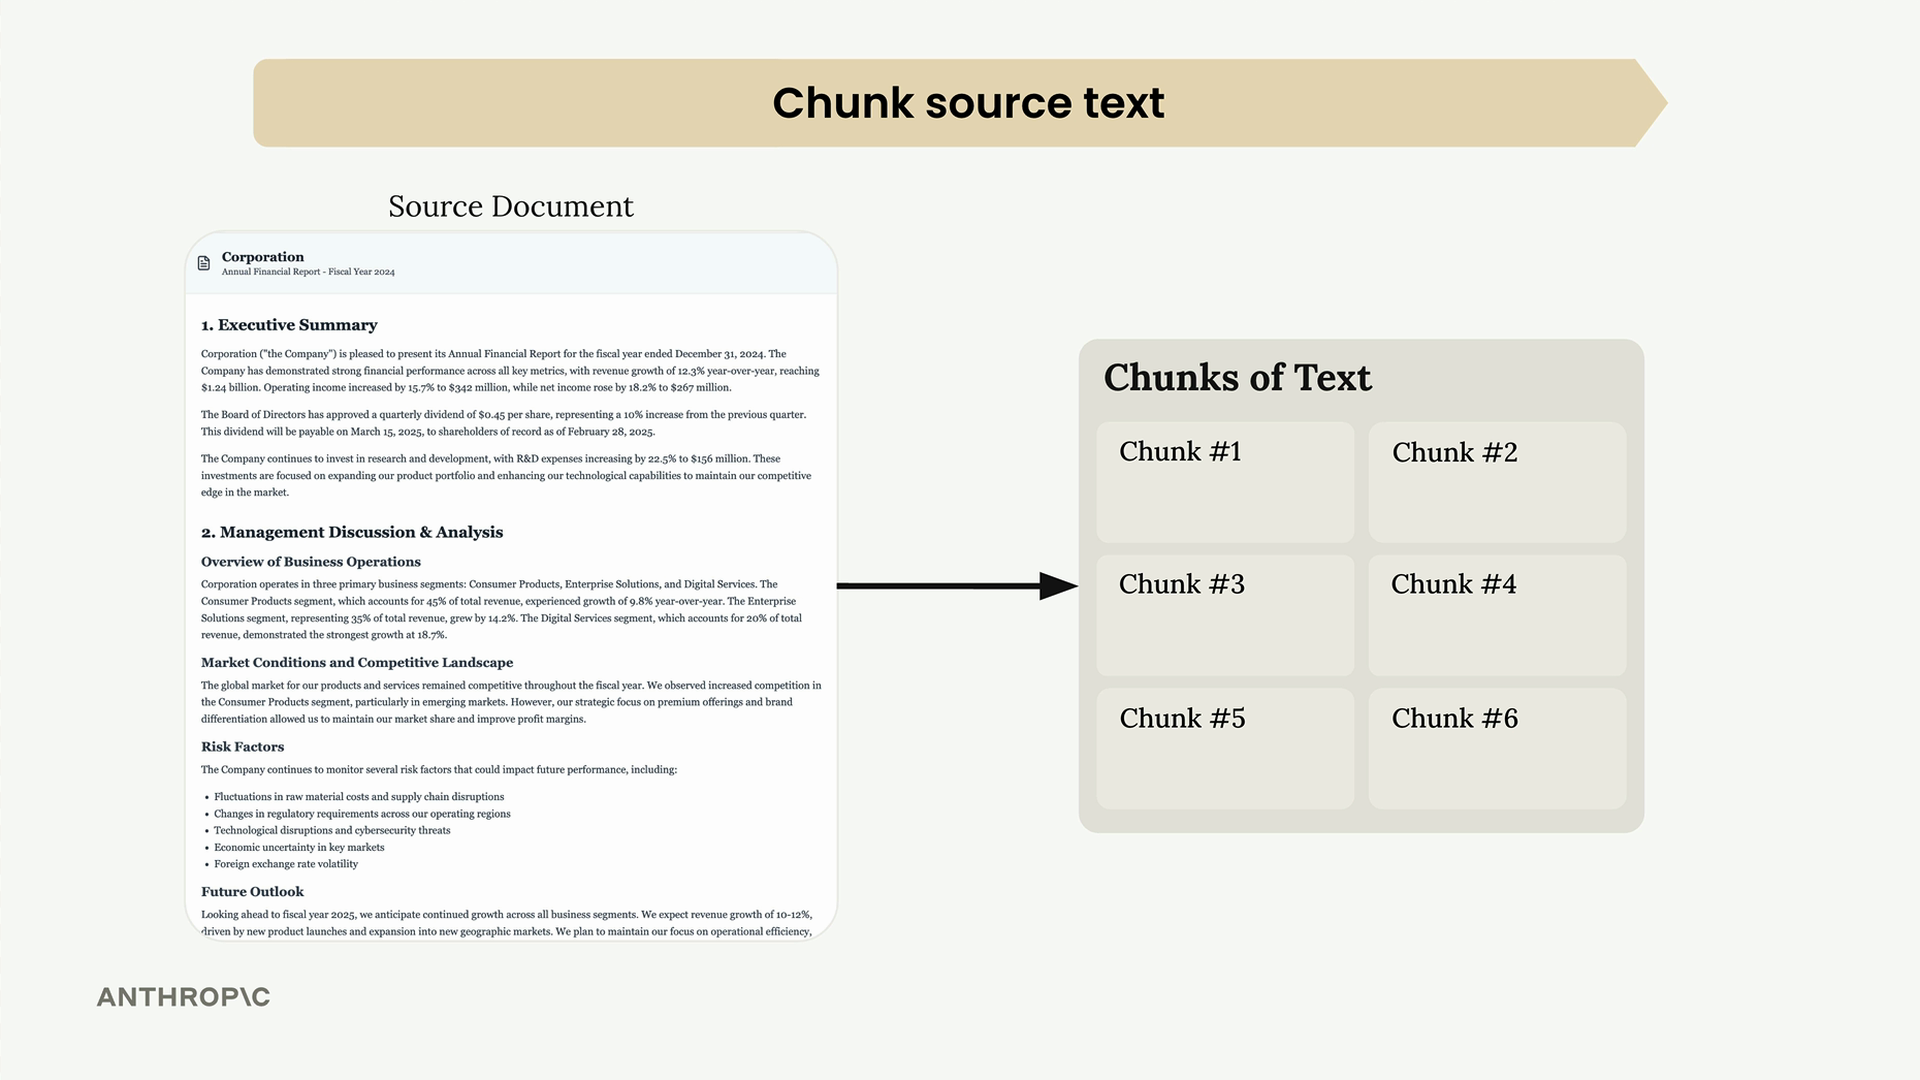
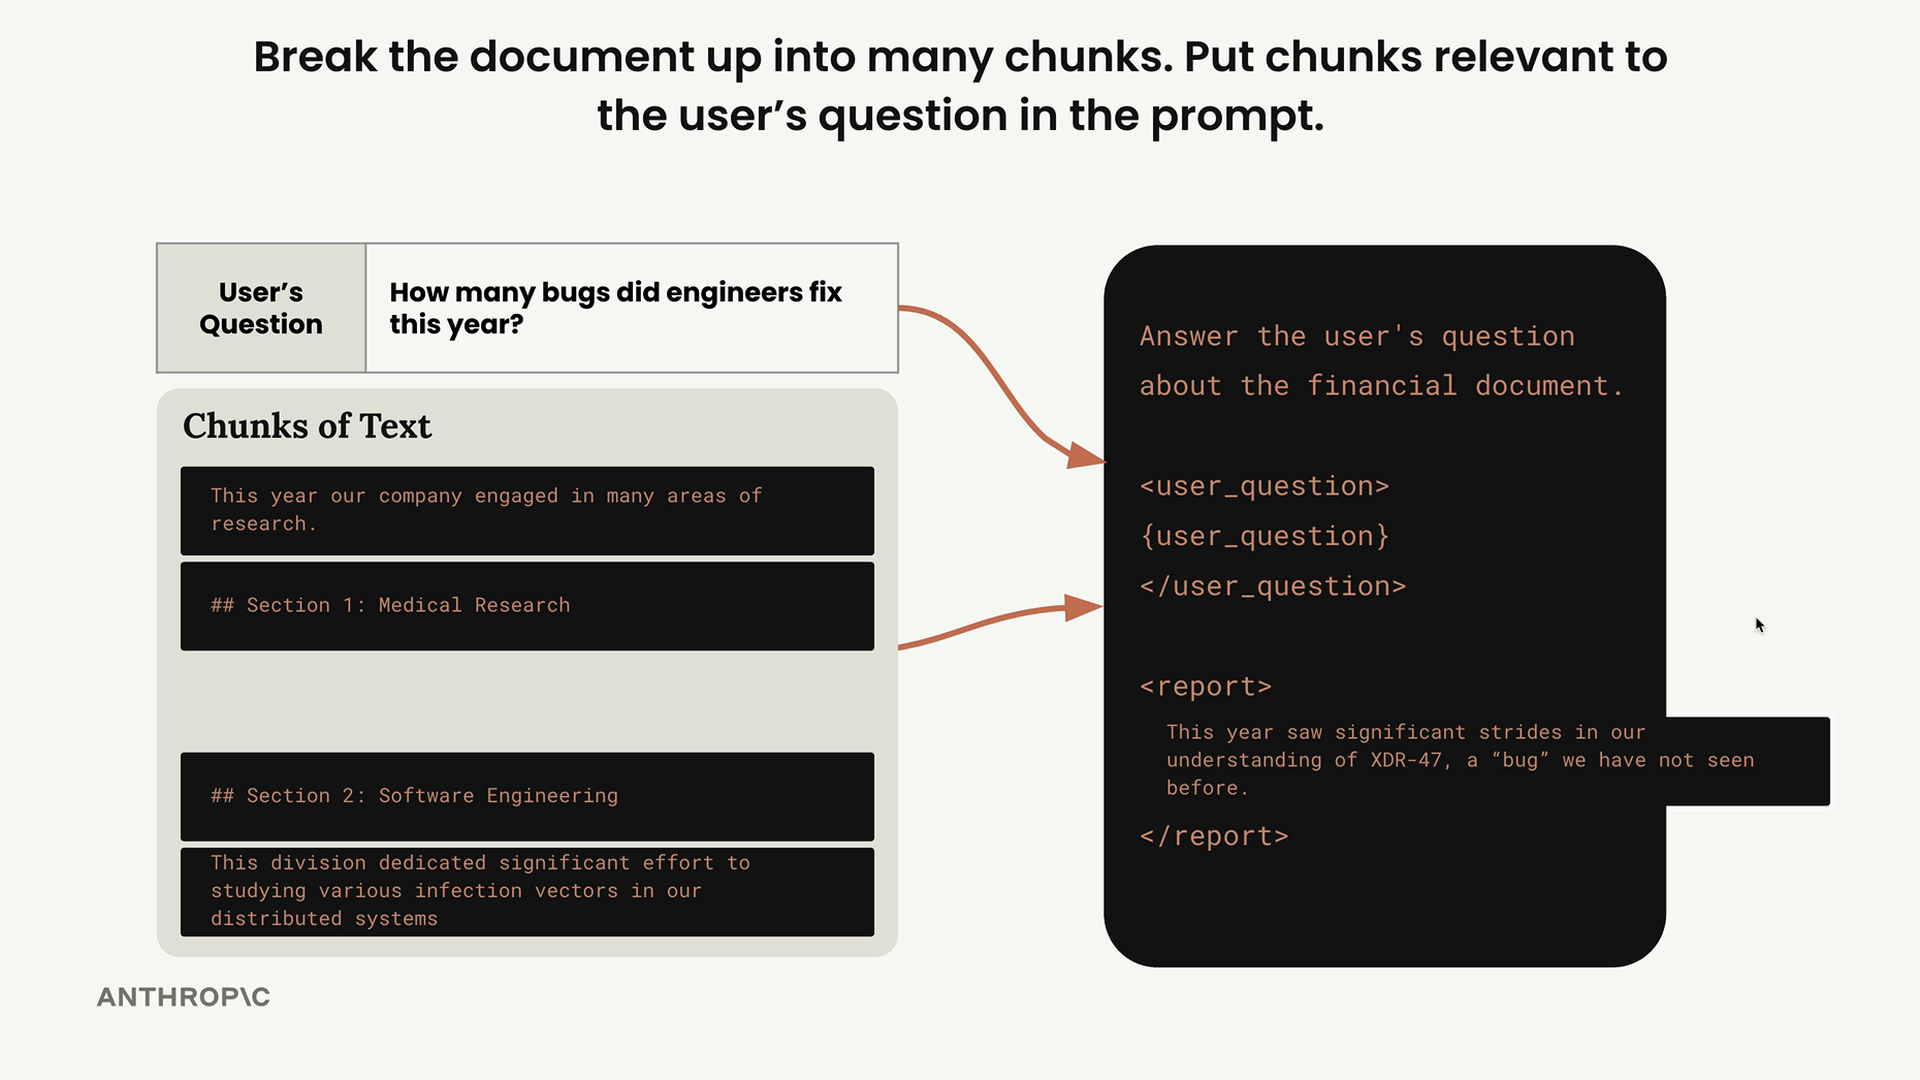
請考慮這個例子:您有一份文件,其中包含醫學研究和軟體工程的章節。如果分塊不當,使用者詢問「今年工程師修復了多少個 bug?」可能會得到關於醫學研究的資訊,而不是軟體工程,僅僅因為醫學章節中恰好在不同的語境下出現了「bug」這個詞。
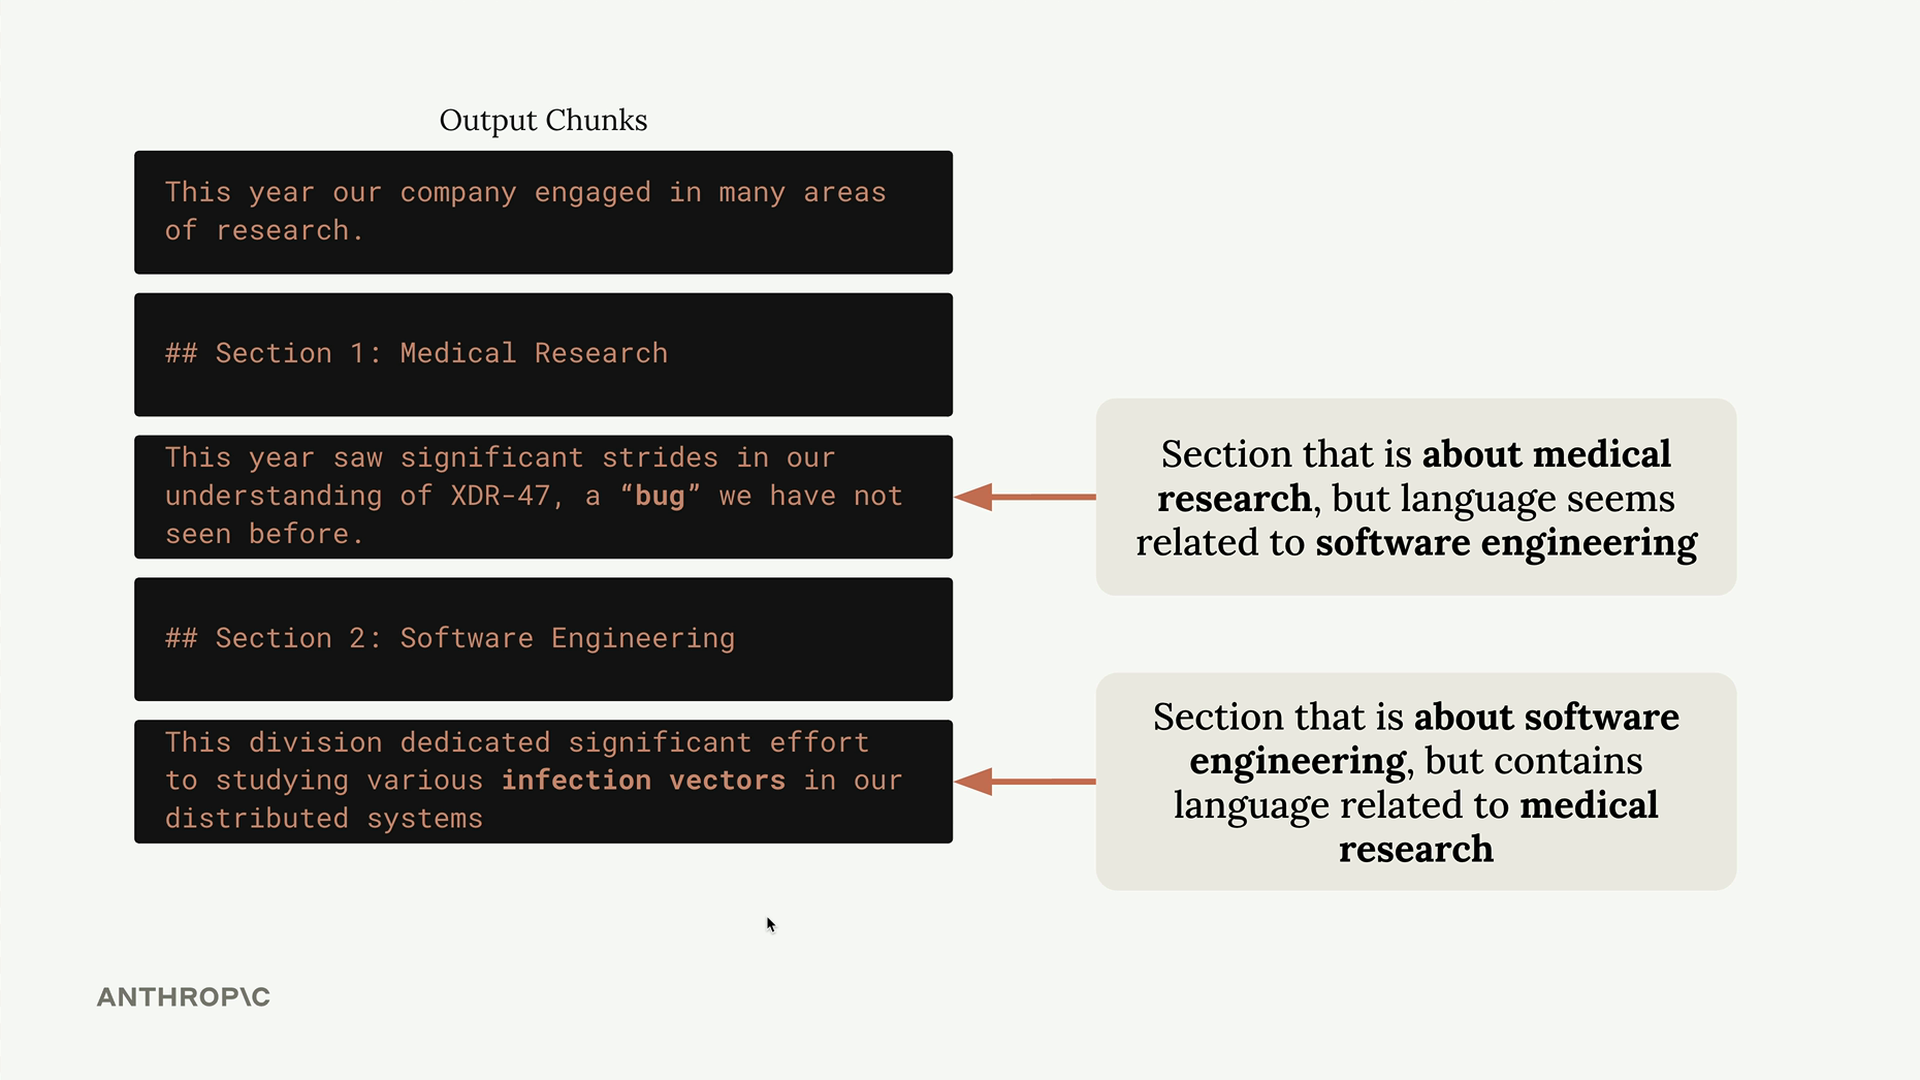
這說明了為什麼分塊策略如此重要。目標是創建能夠保持語義連貫性,並在檢索時提供有用上下文的分塊。
三種主要分塊策略
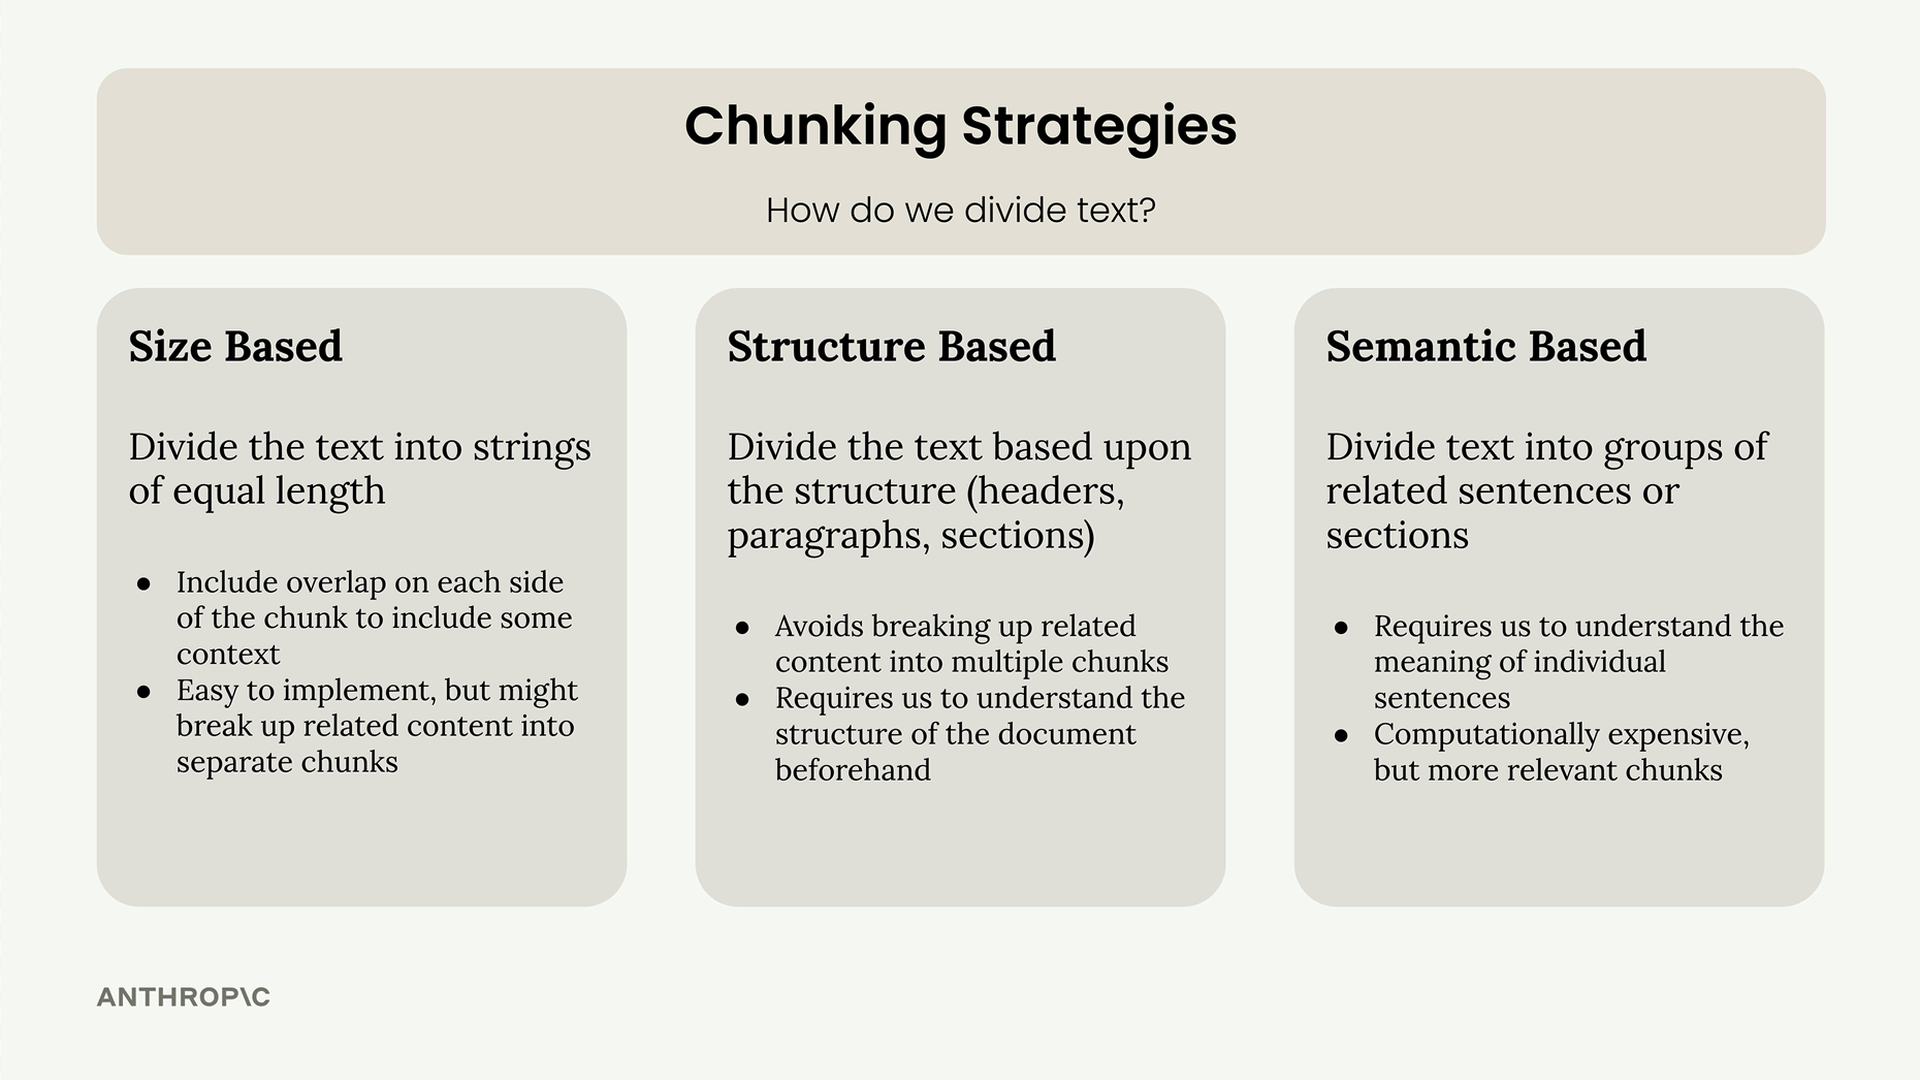
將文本分割成塊有三種主要方法:
- 基於大小: 將文本分割成長度相等的字串
- 基於結構: 根據文件結構(標題、段落、章節)進行分割
- 基於語義: 使用 NLP 技術將相關的句子或章節分組
基於大小的分塊
基於大小的分塊是最直接的方法。您只需將文件分割成字元數或字數大致相等的塊。它易於實作,並且在不同文件類型中都能可靠運作。
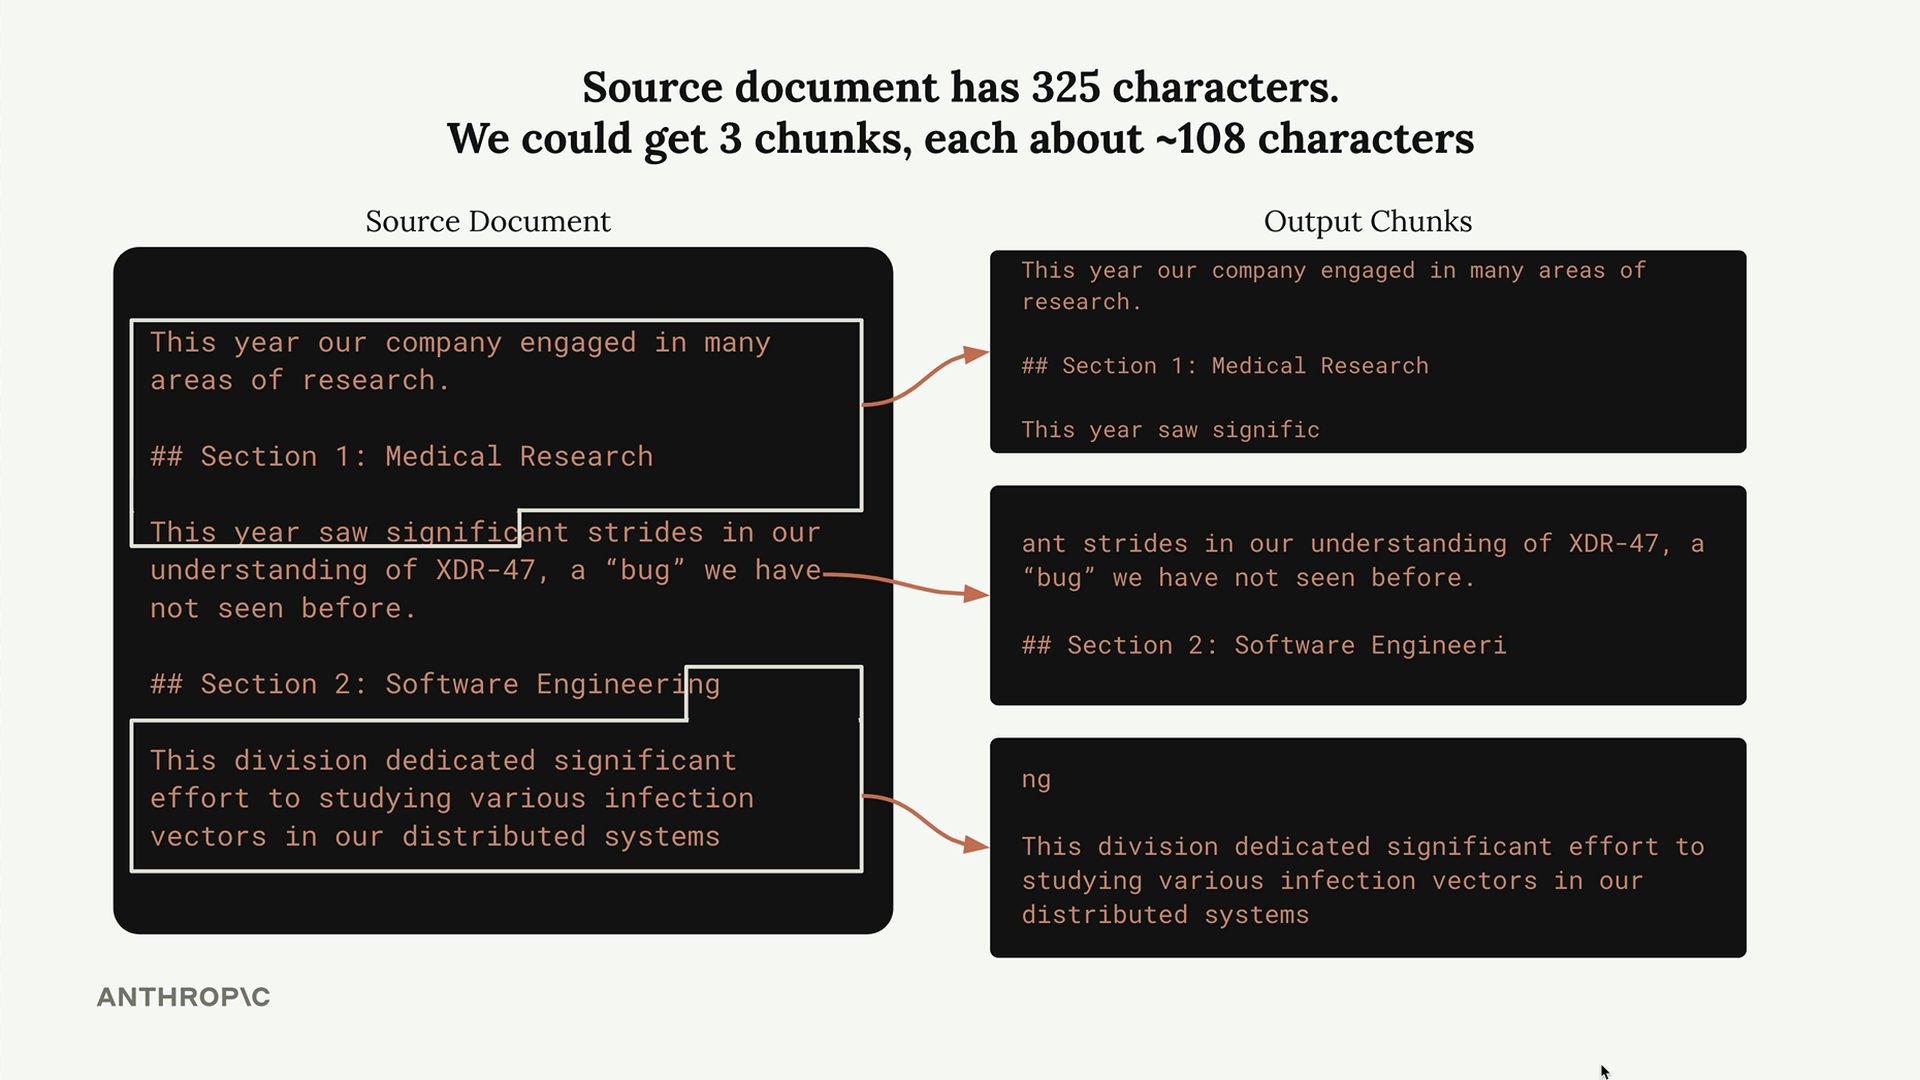
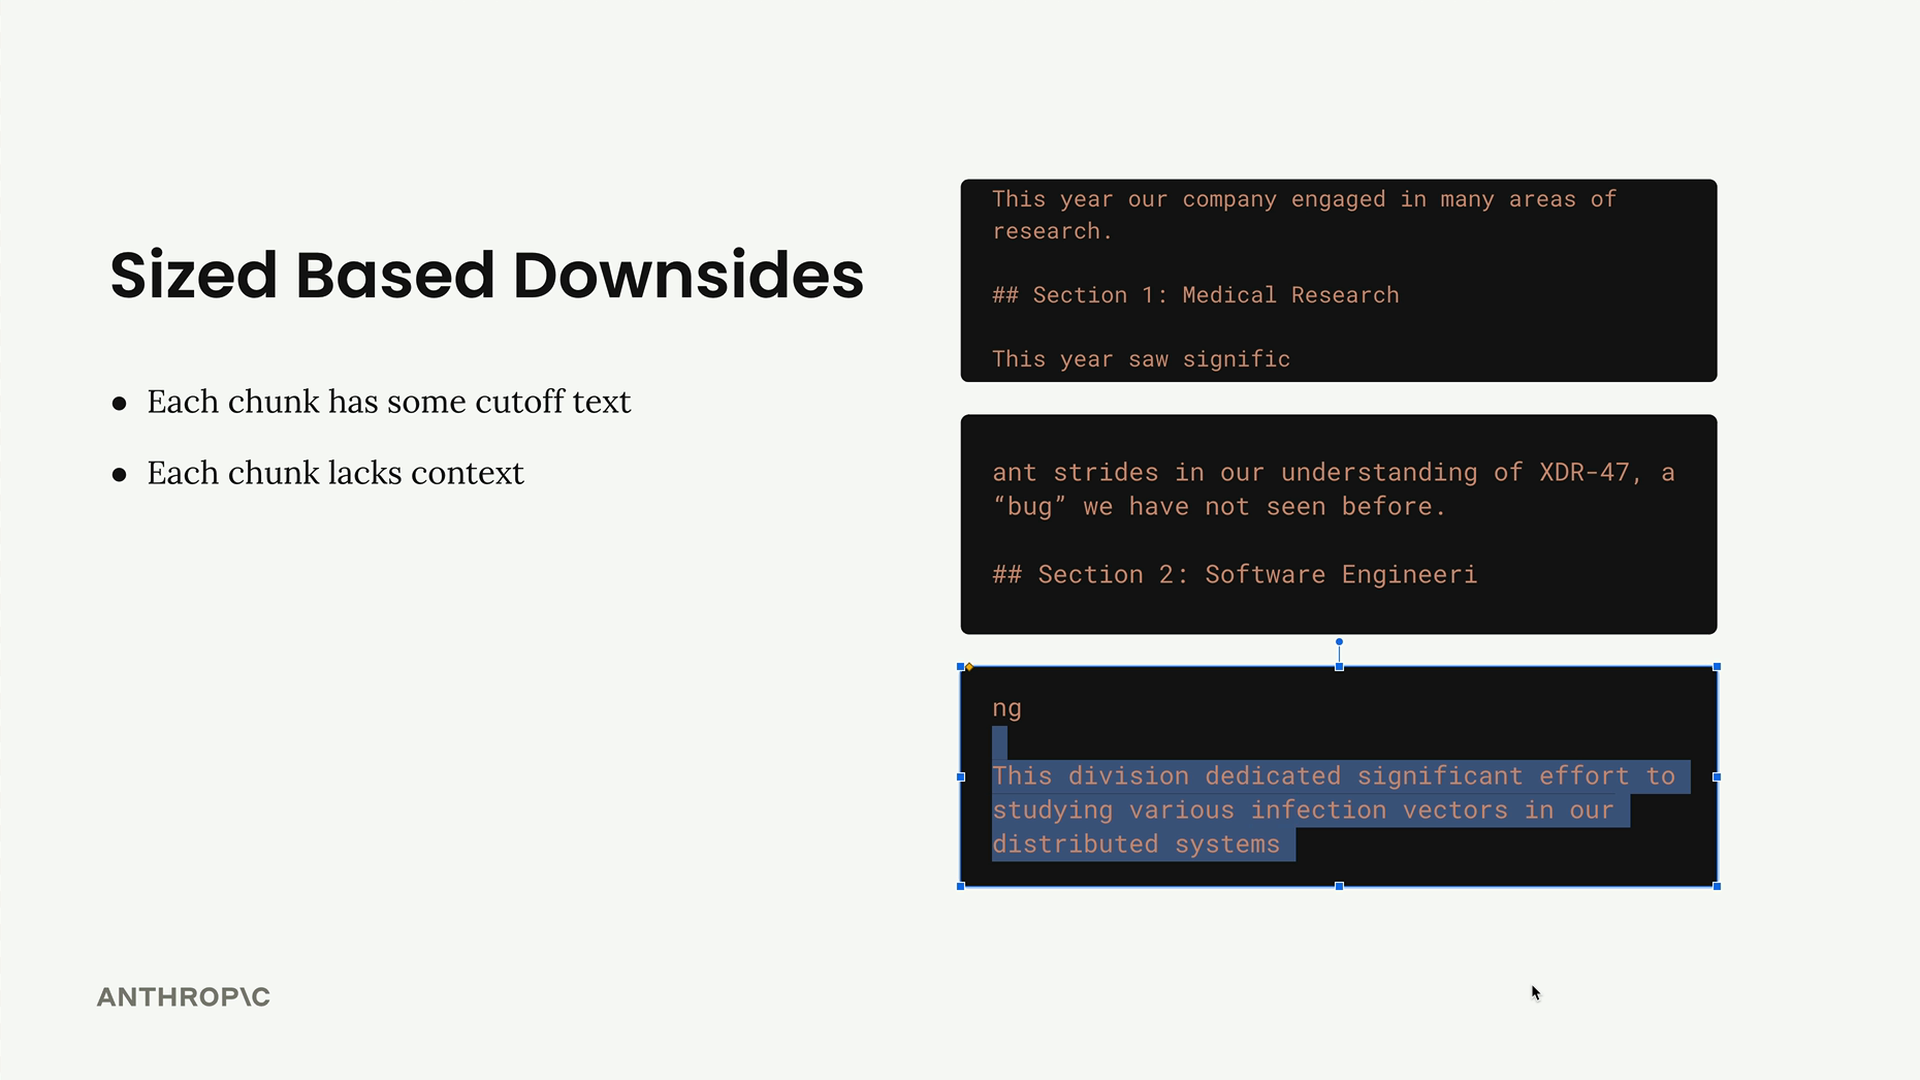
然而,這種方法有明顯的缺點:
- 單詞會在句子中間被截斷
- 分塊會失去周圍文本的重要上下文
- 相關內容可能會被分割到多個分塊中
新增重疊
為了解決上下文問題,您可以實作重疊策略。每個分塊包含來自相鄰分塊的一些字元,提供額外的上下文,並確保重要資訊不會在分塊邊界處遺失。
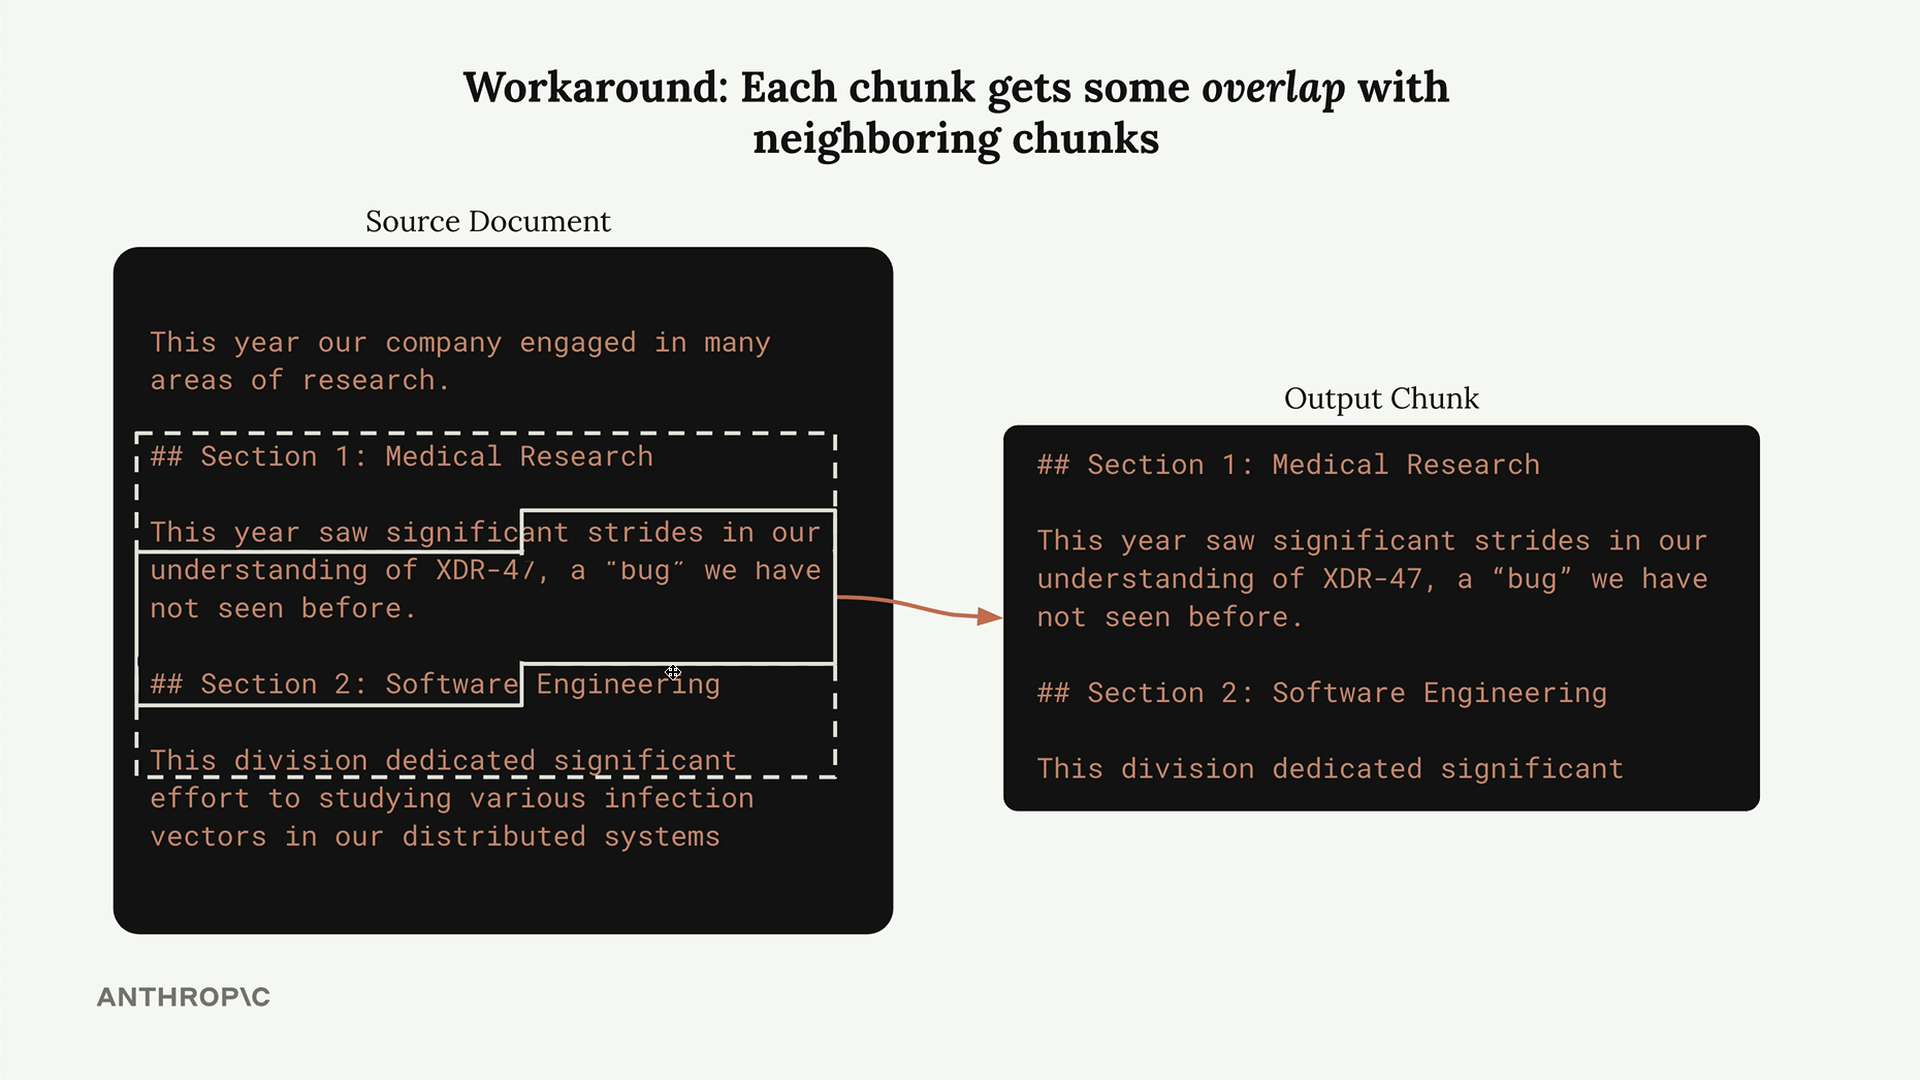
雖然這會造成一些重複,但為了讓每個分塊獲得更好的上下文,這種取捨通常是值得的。
基於結構的分塊
當您的文件具有一致的格式(例如具有清晰標題的 markdown)時,基於結構的分塊可以產生出色的結果。您根據標題等結構元素進行分割,創建與文件自然組織方式一致的分塊。
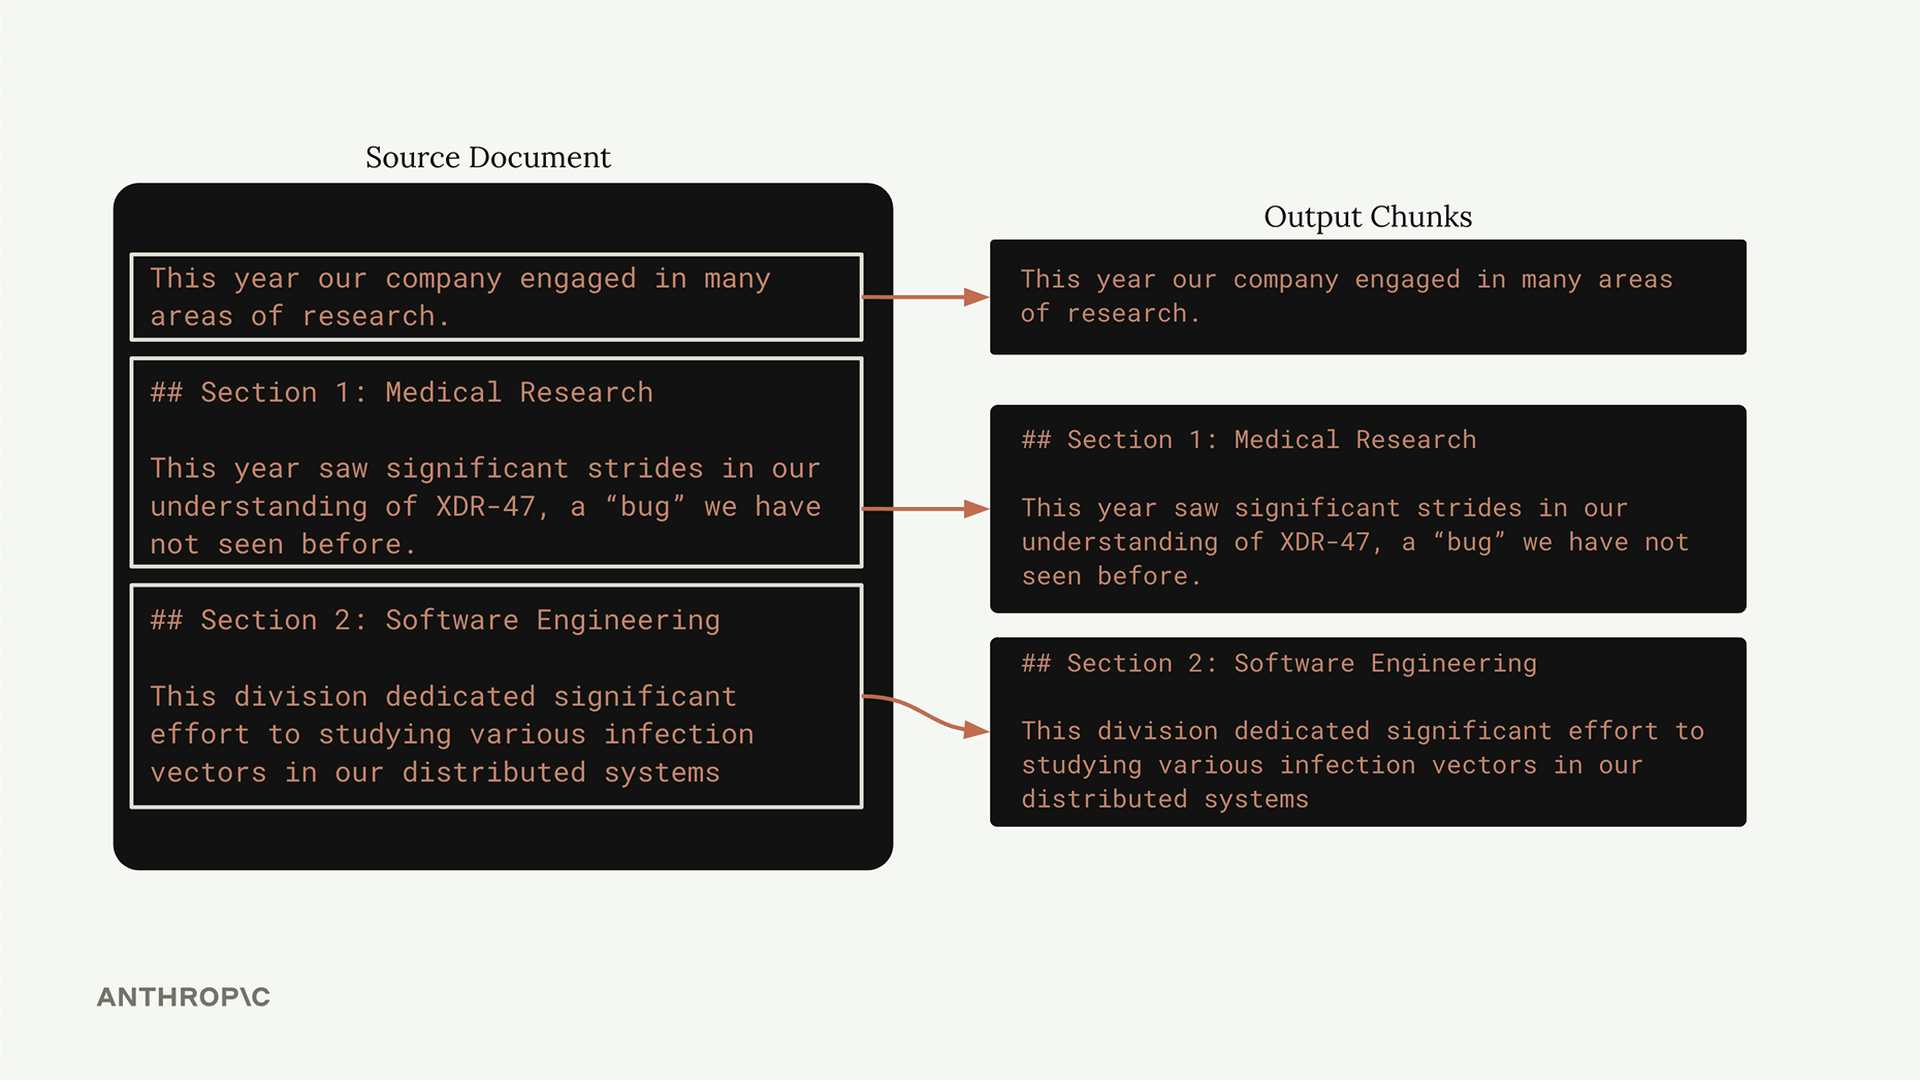
這對於格式良好的文件效果極佳,但需要對文件結構有所保證。對於純文字檔案或格式不一致的文件,它無法可靠地運作。
實作範例
以下是您可以實作的三個實用分塊函式:
基於字元的分塊
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
基於句子的分塊
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
基於章節的分塊
def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
選擇正確的策略
您選擇的分塊策略完全取決於您的特定使用案例:
- 基於字元: 最可靠的備用方案,適用於任何文件類型
- 基於句子: 對於文章而言,在上下文和語義之間取得良好平衡
- 基於章節: 當您擁有結構化文件時,能產生出色的結果
對於沒有格式保證的使用者上傳文件,基於字元的分塊通常是最安全的選擇。對於結構良好的內部文件,基於章節的分塊可以提供更優異的結果。基於句子的分塊對大多數文章都效果良好,但對於以非預期方式使用句點的程式碼或技術文件,可能會遇到困難。
請記住,分塊通常是一個反覆迭代的過程。從簡單的方法開始,用您特定的文件和使用案例進行測試,然後根據您從 RAG 系統獲得的結果品質進行改進。