基於程式碼的評分為您的提示評估增加了一層額外的驗證,檢查模型的輸出是否遵循正確的格式並具有有效的語法。當您要求模型生成程式碼、JSON 或正規表達式時,這特別有用。
程式碼評分的運作方式
程式碼評分器評估兩個主要標準:
- 格式合規性 - 輸出是否只包含所要求的格式(Python、JSON 或 regex)而沒有解釋?
- 有效語法 - 輸出是否能夠成功被解析或編譯?
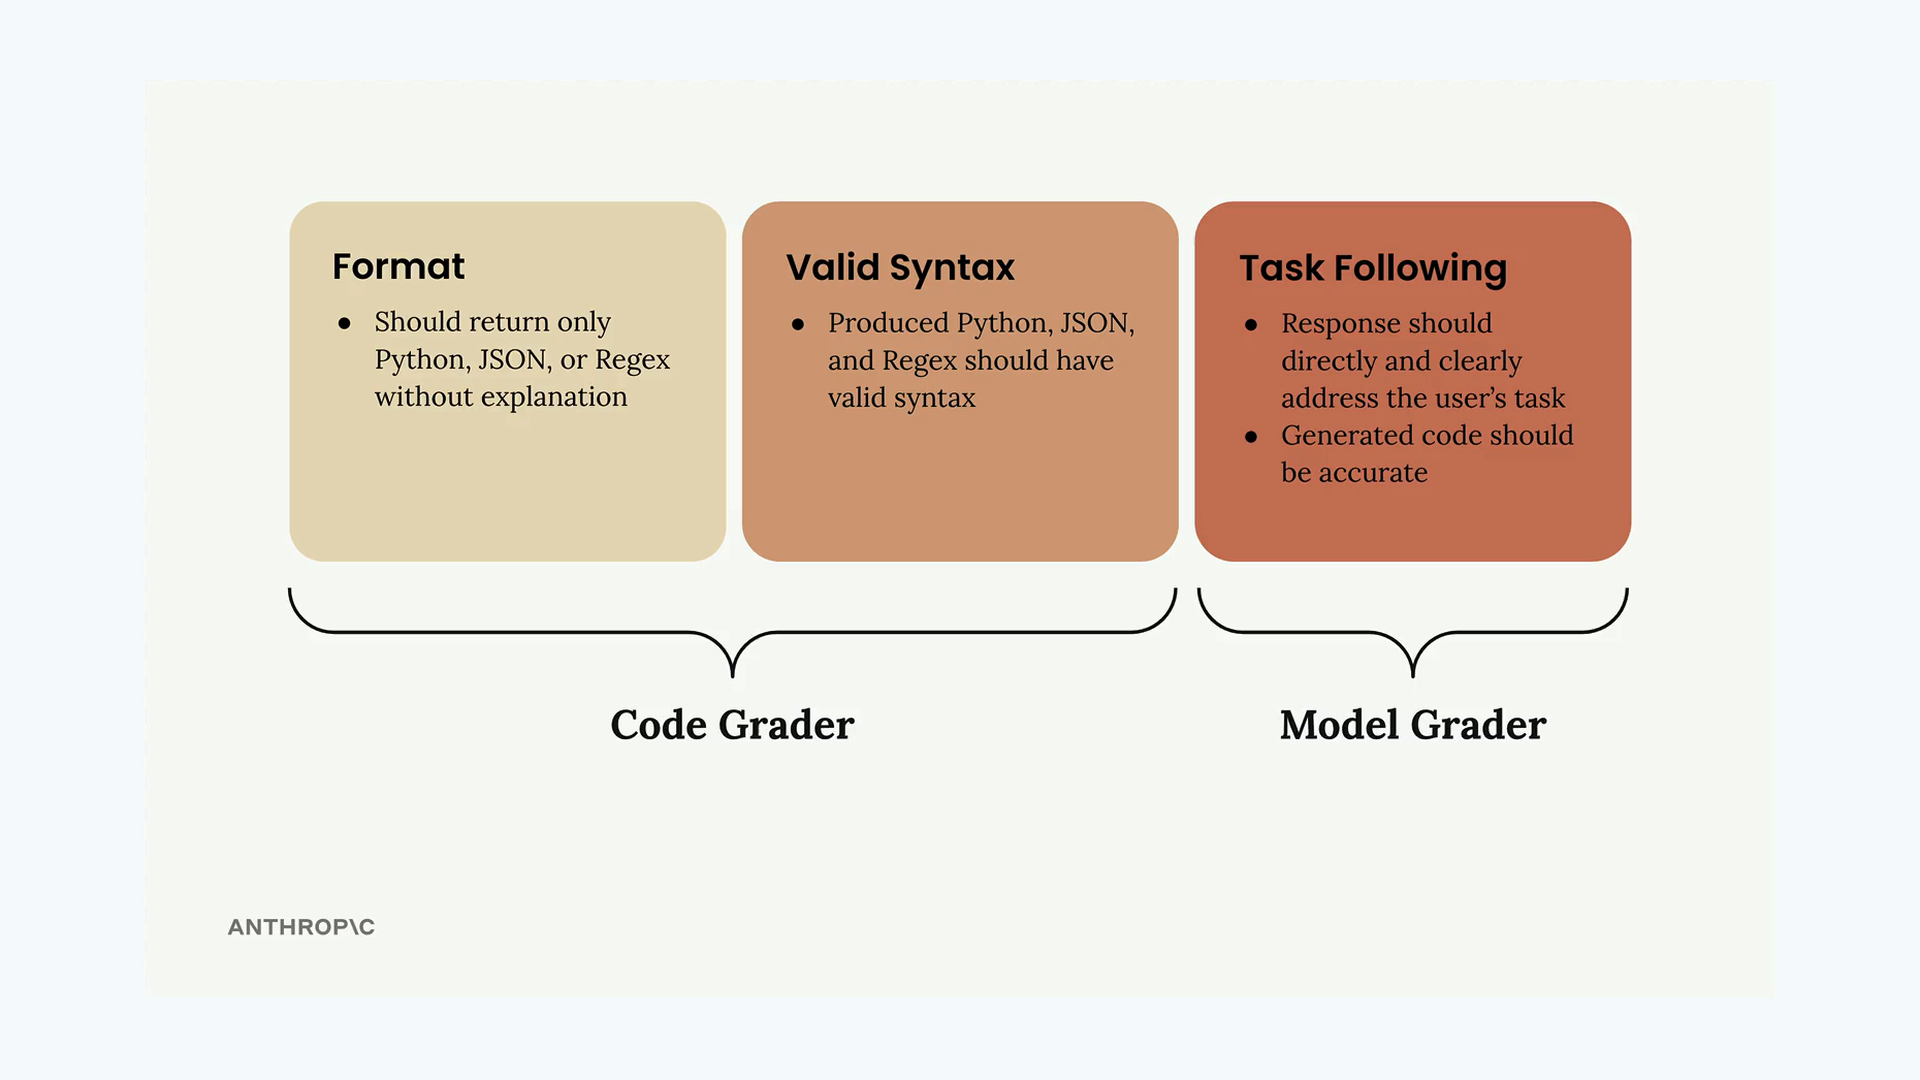
系統為每種格式類型使用獨立的驗證函式。如果程式碼成功解析,則獲得滿分 10 分。如果解析失敗並出現錯誤,則得分為 0。
設定驗證函式
您需要三個輔助函式來驗證不同的輸出類型:
python
def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
這些函式使用 Python 內建的解析功能來檢查語法有效性。json.loads() 函式驗證 JSON,ast.parse() 建立 Python 抽象語法樹,而 re.compile() 驗證正規表達式。
將格式資訊新增到測試案例中
您的測試資料集需要為每個任務指定預期的輸出格式。更新您的資料集生成提示,加入一個格式欄位:
json
{
    "task": "Description of task",
    "format": "python"
}
格式欄位應包含「json」、「python」或「regex」,取決於您期望該特定任務產生的輸出類型。
改進您的提示
為了從程式碼評分器獲得更好的結果,請讓您的提示指示更具體:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanation您也可以使用預先填入的助手訊息,搭配程式碼區塊和停止序列,以確保輸出格式乾淨。
合併分數
最後一步是將您的模型評分器分數與語法評分器分數合併。一個簡單的方法是取兩個分數的平均值:
python
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
這使內容品質(來自模型評分器)和技術正確性(來自程式碼評分器)獲得同等的權重。您可以根據您特定使用案例中哪個更重要來調整此權重。
解讀結果
一旦您執行評估,您將獲得一個綜合分數,反映生成程式碼的語意品質和技術正確性。請記住,單獨的分數本身並不能告訴您太多資訊——真正的價值來自於在您迭代提示設計時比較分數。
使用此基準分數來測試提示改進,並查看您的變更是否真正帶來更好、更可靠的程式碼生成。