溫度是一個強大的參數,用於控制 Claude 的回應有多具創意或多具確定性。了解如何有效使用它可以大幅改善您的 AI 應用程式。
Claude 如何生成文本
在深入探討溫度之前,先了解 Claude 的文本生成過程會很有幫助。當您向 Claude 發送像「你怎麼想?」這樣的提示時,它會經歷三個階段:
- 分詞(Tokenization): 將您的輸入拆分成較小的區塊
- 預測(Prediction): 計算可能的下一個 token 的機率
- 取樣(Sampling): 根據這些機率選擇一個 token
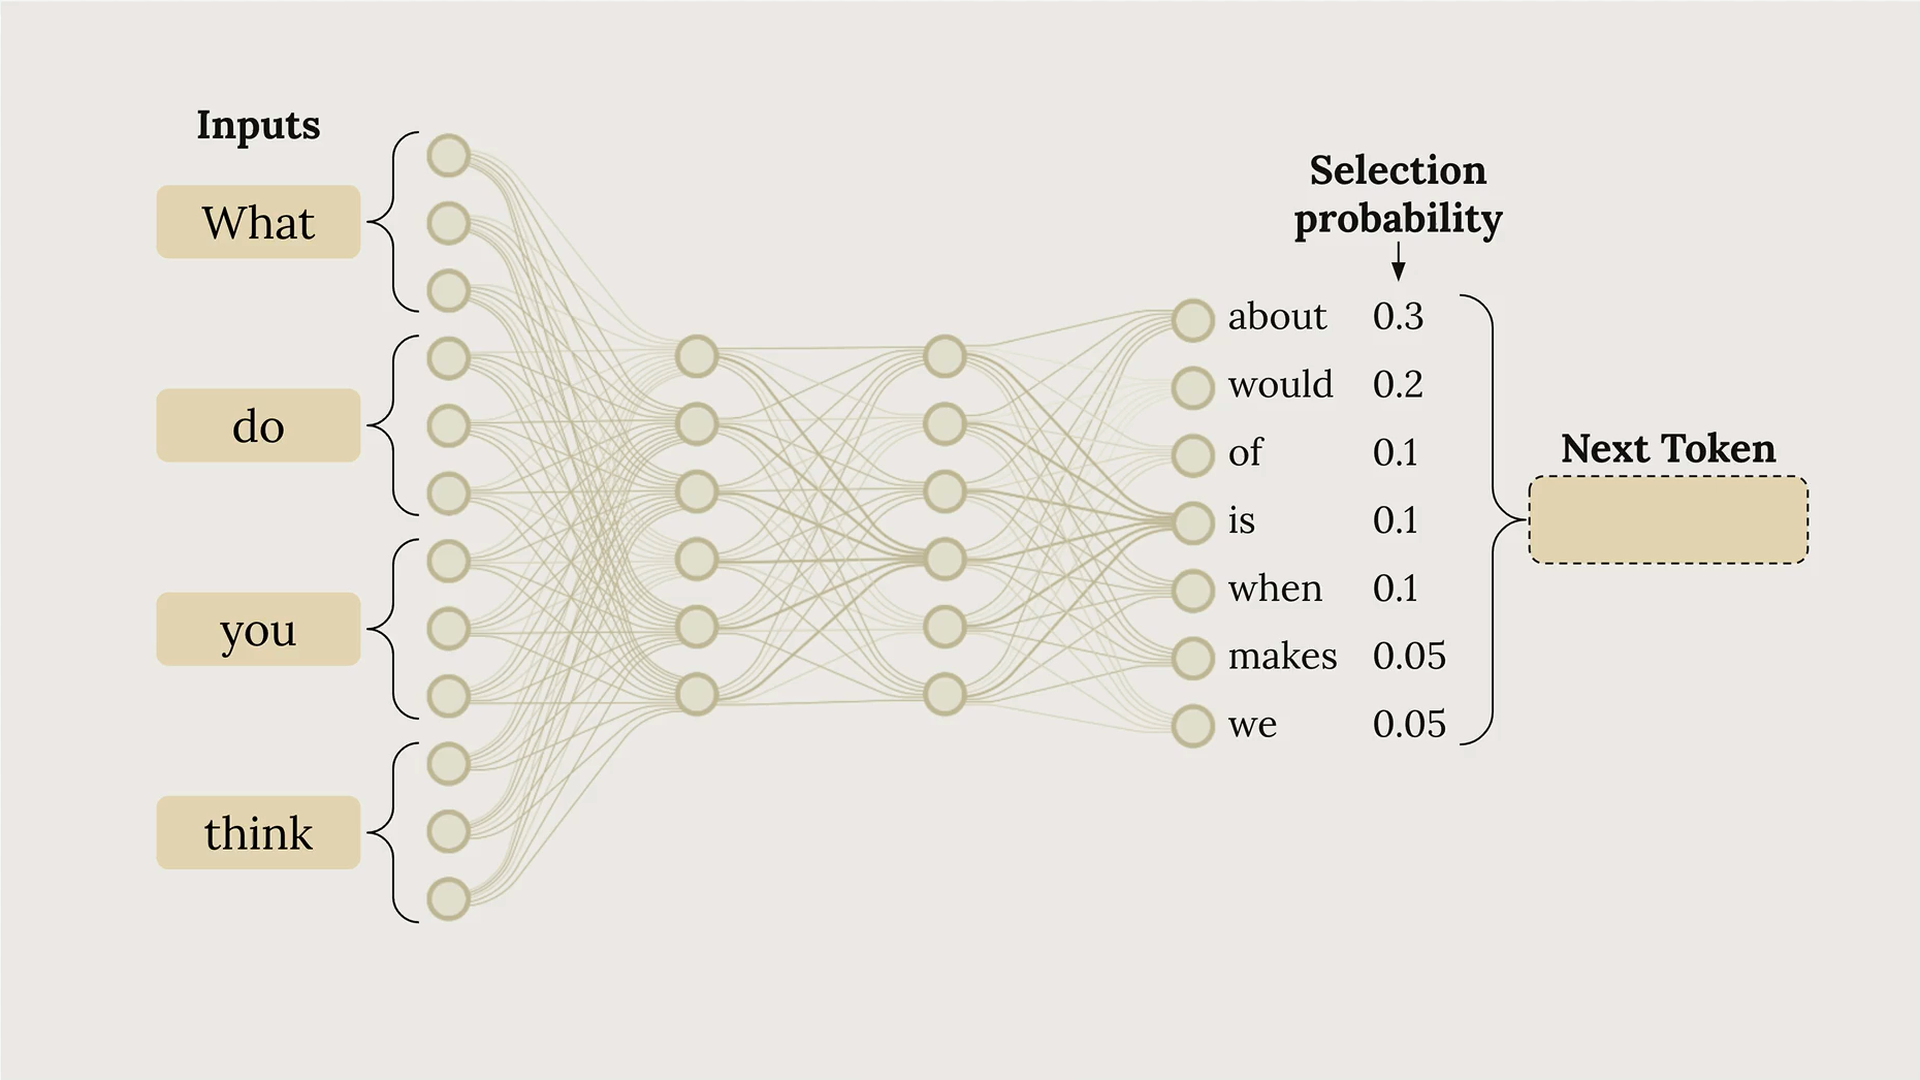
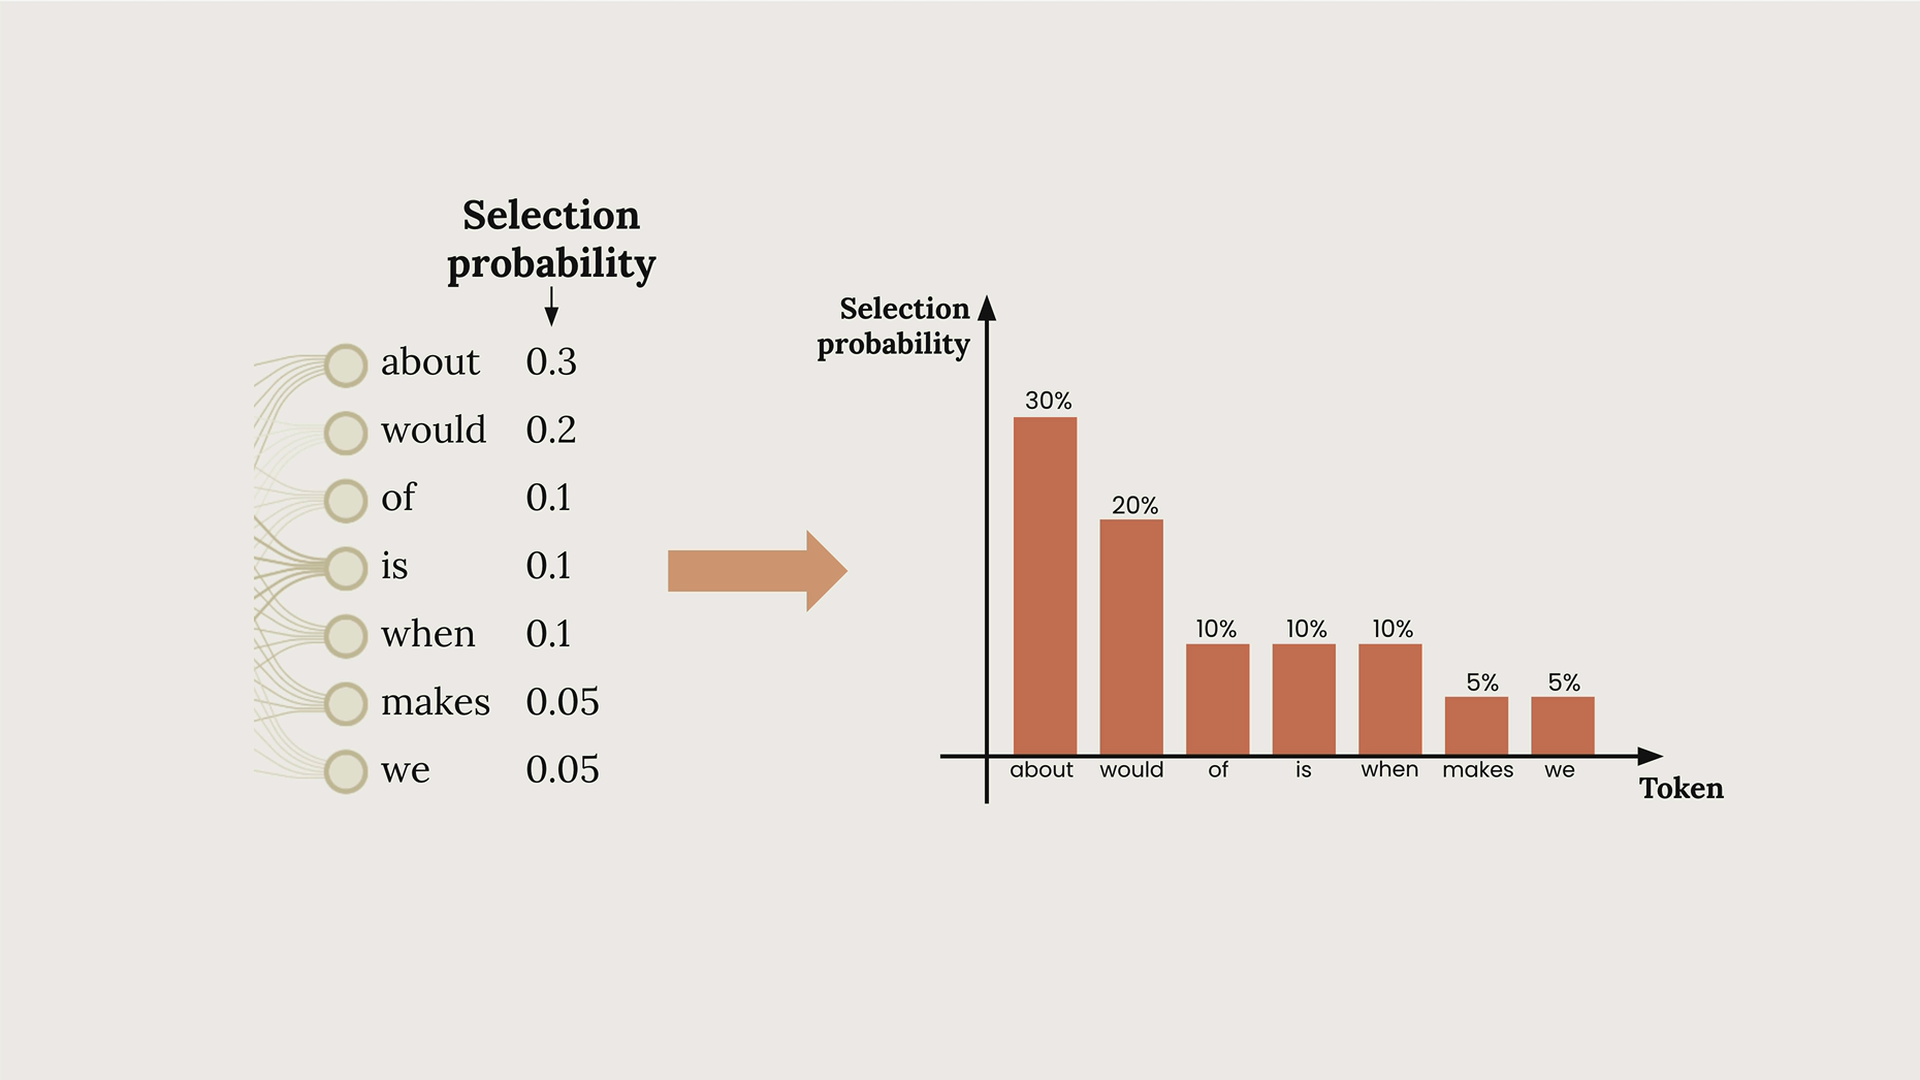
在上圖中,您可以看到 Claude 如何為潛在的下一個 token 分配不同的機率。「about」這個詞有 30% 的機率,「would」有 20%,依此類推。這個過程會針對每個 token 重複進行,直到回應完成。
溫度的作用
溫度是一個介於 0 到 1 之間的小數值,直接影響這些 token 選擇的機率。可以把它想像成一個創意調節器:
- 低溫度(接近 0): 使機率最高的 token 更有可能被選中
- 高溫度(接近 1): 使機率在所有可能的 token 之間更均勻地分佈
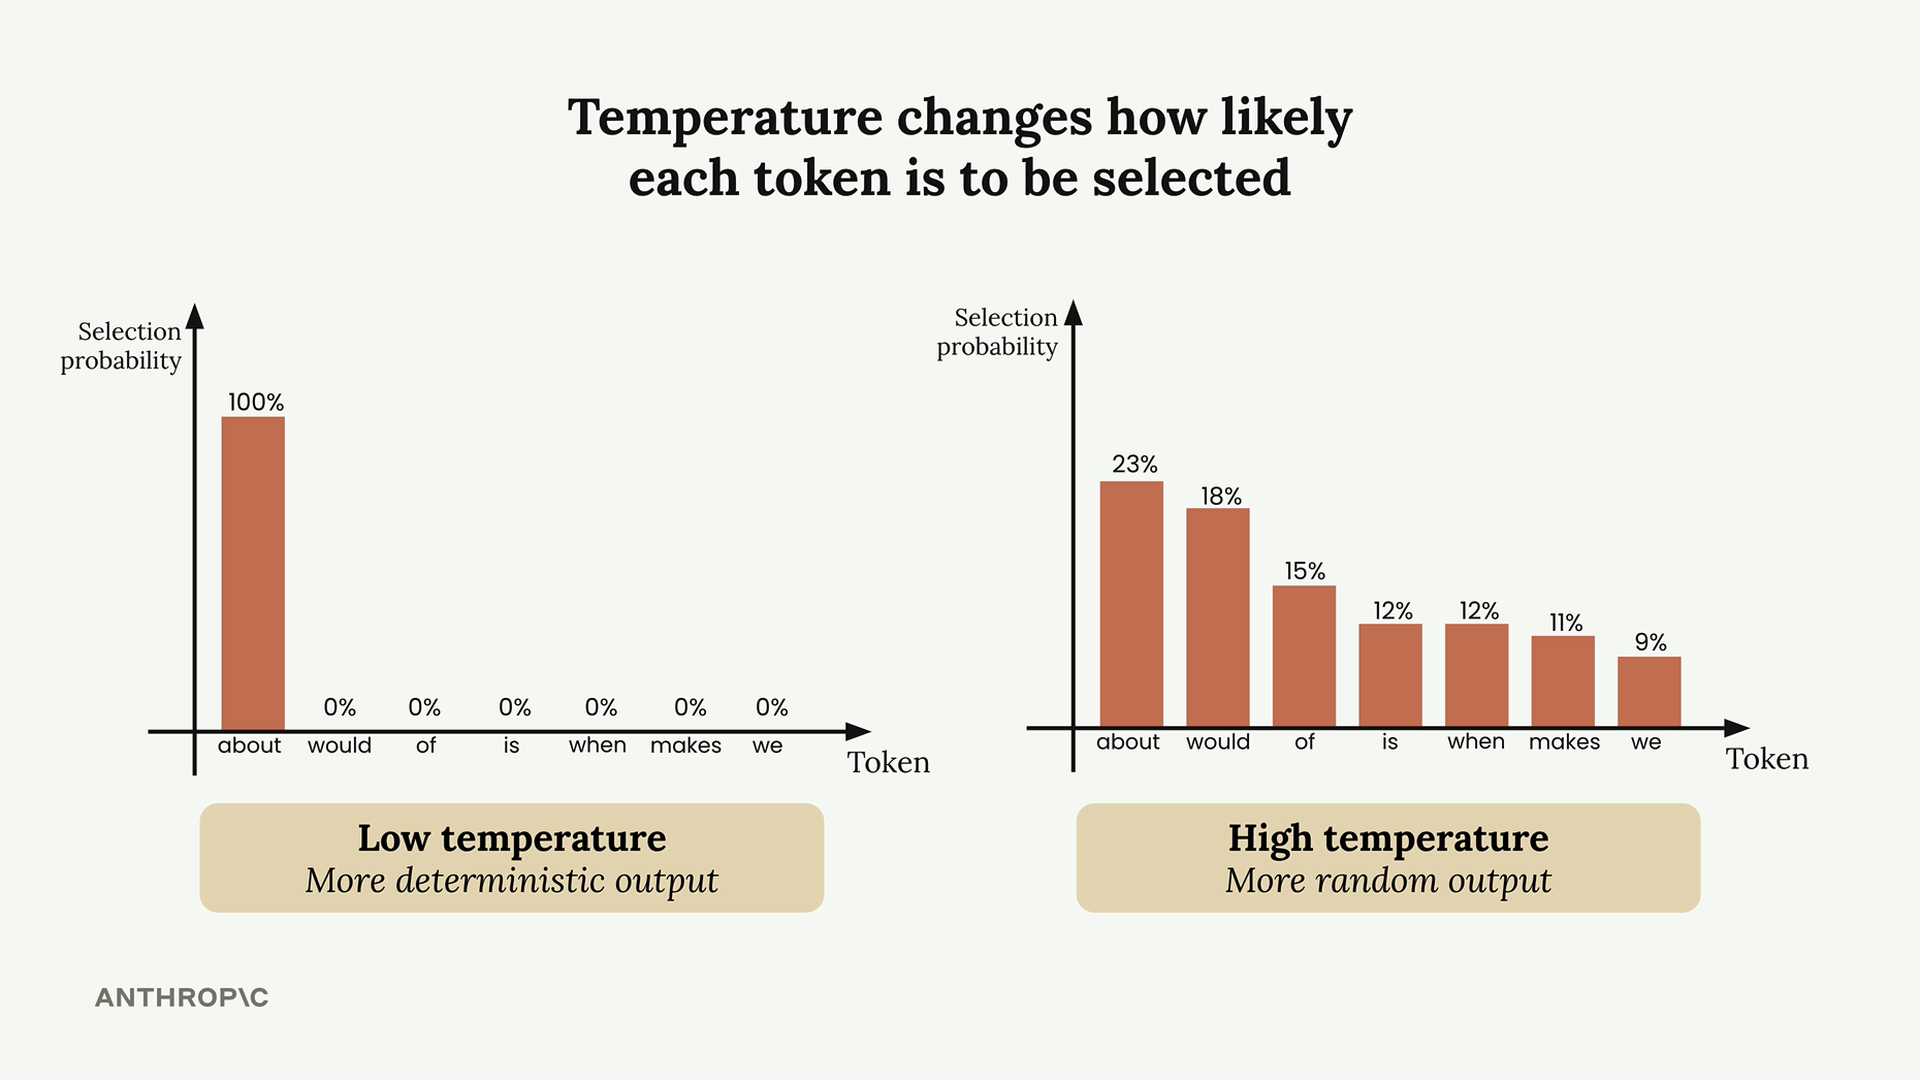
在溫度為 0 時,Claude 會變得具有確定性——它總是會選擇機率最高的 token。在溫度為 1 時,機率較低的 token 有更大的機會被選中,從而產生更具創意和多樣化的輸出。
溫度範圍與使用案例
不同的任務需要不同的溫度設定:
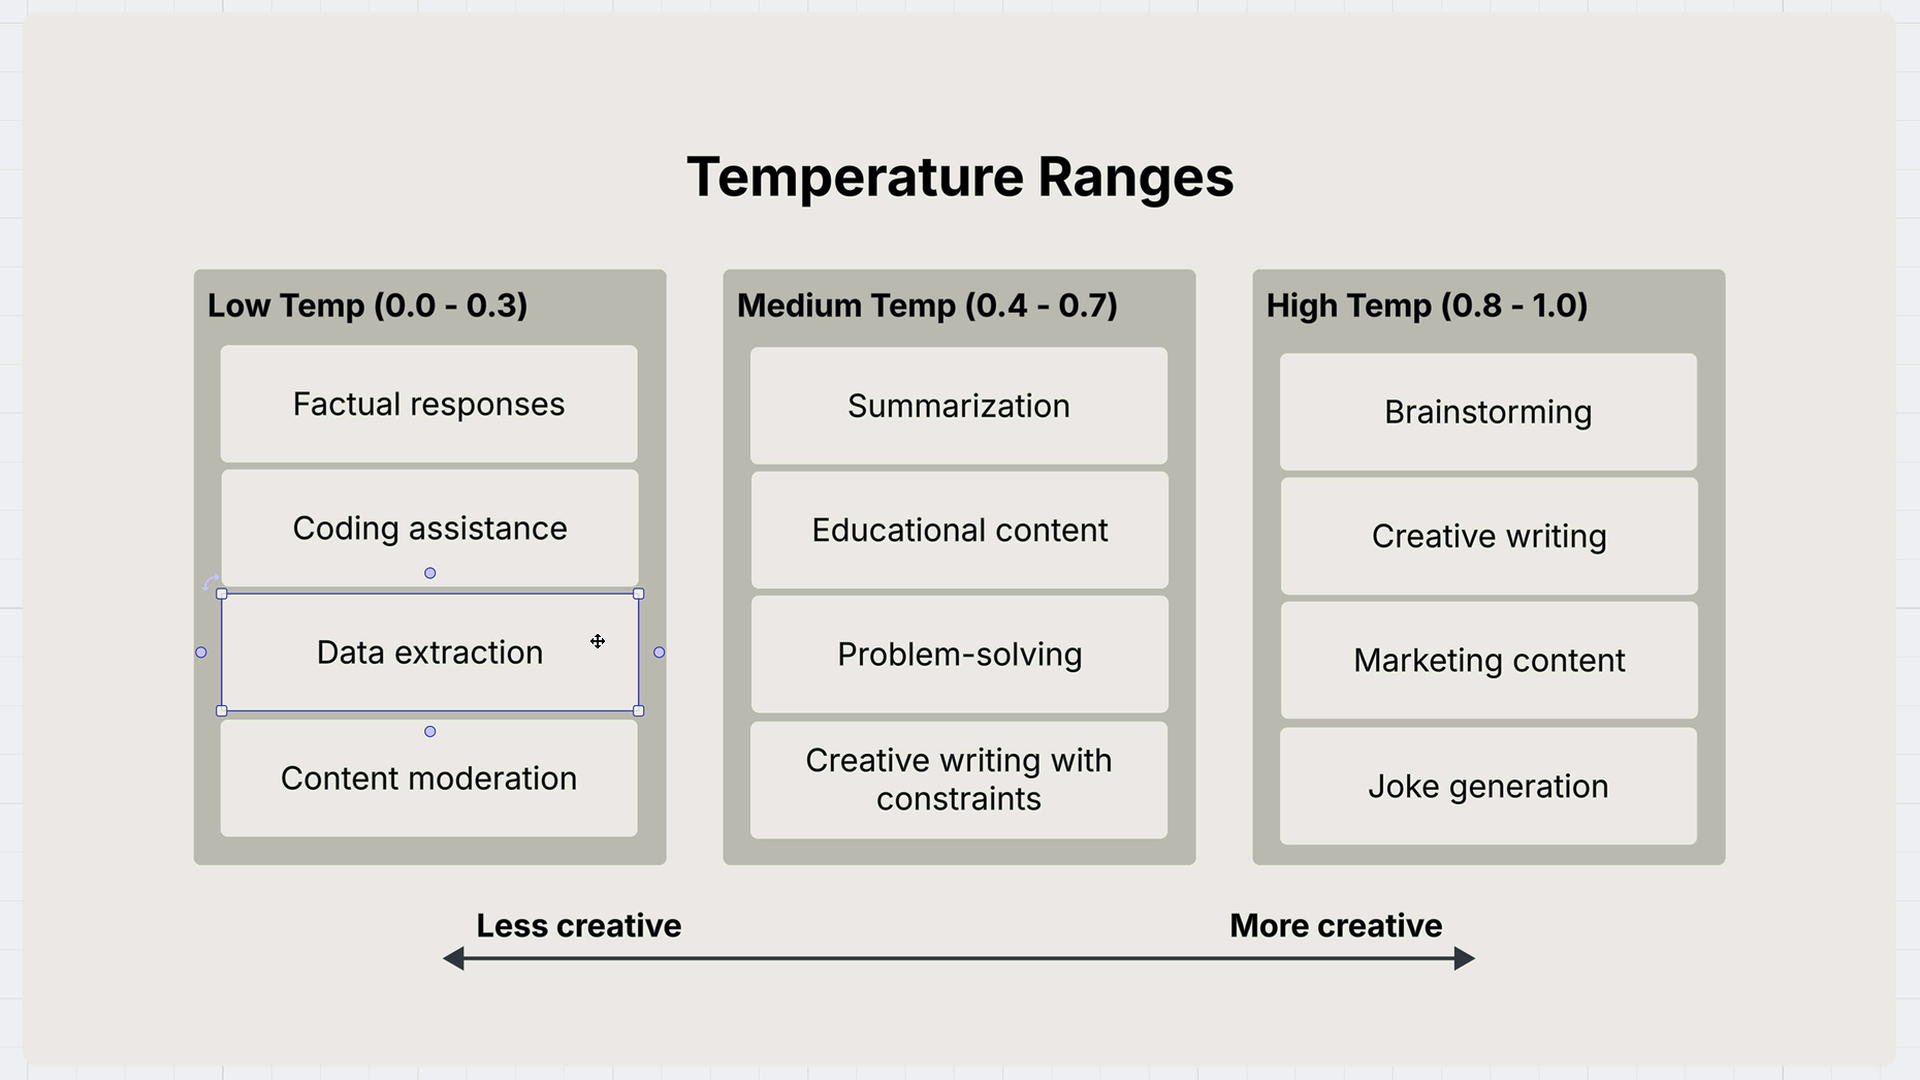
低溫度(0.0 - 0.3)
- 事實性回應
- 程式碼協助
- 資料提取
- 內容審核
中溫度(0.4 - 0.7)
- 摘要
- 教育內容
- 問題解決
- 有限制的創意寫作
高溫度(0.8 - 1.0)
- 腦力激盪
- 創意寫作
- 行銷內容
- 笑話生成
在程式碼中設定溫度
預設情況下,Claude 的溫度設定為 1.0,這意味著最大的創意性。您可以透過在推論設定中加入溫度來覆寫此設定:
def chat(messages, system=None, temperature=1.0):
    params = {
        "modelId": model_id,
        "messages": messages,
        "inferenceConfig": {"temperature": temperature}
    }

    if system:
        params["system"] = [{"text": system}]

    response = client.converse(**params)
    return response["output"]["message"]["content"][0]["text"]
實際應用中的溫度
以下是一個使用電影創意生成的實際範例。當溫度設定為預設值(1.0)時,您可能會得到像這樣的創意回應:
「一位隱居的摺紙大師發現她精緻的紙藝作品在夜晚會活過來,帶領她展開一段奇幻旅程,去拯救她們微型世界,對抗一個威脅要讓她們的存在消失的神秘陰影生物。」
但當您將同一個提示的溫度設定為 0.0 時,您會持續得到更可預測的回應:
「一位穿越時空的考古學家必須阻止古代文物被一位科技億萬富翁偷走,他正利用這些文物建造一個利用其被遺忘力量的末日裝置。」
多次執行低溫度版本會產生非常相似的回應,通常會重複出現像「穿越時空的歷史學家」或「穿越時空的考古學家」這樣的主題。
重點摘要
溫度讓您能夠直接控制 Claude 的創意程度。當您需要一致、事實性的回應時,使用較低的溫度;當您想要創意、多樣化的輸出時,使用較高的溫度。預設溫度 1.0 會最大化創意性,因此對於需要精確性和一致性的任務,請考慮降低溫度。