既然我們已經介紹了 RAG、文字分塊和嵌入的基礎知識,現在讓我們逐步走過完整的 RAG 流程。這個範例將向您展示所有這些部分如何協同運作,以檢索相關資訊並生成回應。
步驟 1:分塊您的來源文字
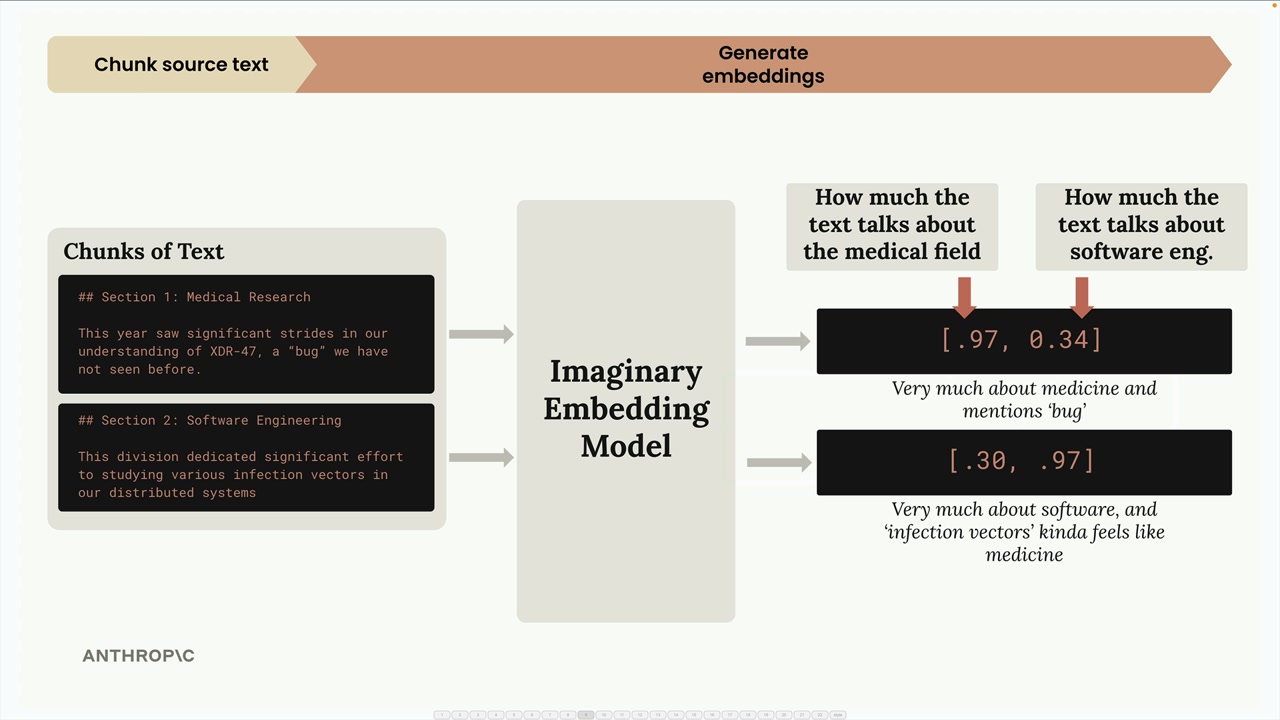
首先,我們取得來源文件並將其分解成可管理的區塊。在這個範例中,我們將使用兩個簡單的文字區段:
- 區段 1:醫學研究 - 「今年在我們對 XDR-47 的理解上取得了重大進展,這是一種我們以前從未見過的『bug』。」
- 區段 2:軟體工程 - 「這個部門投入了大量精力研究我們分散式系統中的各種感染途徑」
步驟 2:生成嵌入
接下來,我們使用嵌入模型將每個文字區塊轉換為數值嵌入。為了讓這更容易理解,讓我們假設我們有一個完美的嵌入模型,它總是恰好回傳兩個數字,而且我們知道每個數字代表什麼。
在我們假想的模型中:
- 第一個數字代表文字談論醫學領域的程度
- 第二個數字代表文字談論軟體工程的程度
對於醫學研究區段,我們可能得到 [0.97, 0.34] - 非常偏重醫學,但由於「bug」這個詞而帶有一些軟體元素。對於軟體工程區段,我們得到 [0.30, 0.97] - 高度偏重軟體,但由於「感染途徑」而帶有醫學色彩。
正規化
嵌入 API 通常會執行一個正規化步驟,將每個向量縮放為大小為 1.0。您不需要擔心這裡的數學運算 - 這是自動處理的。這給我們帶來了像 [0.944, 0.331] 和 [0.295, 0.955] 這樣的正規化向量。
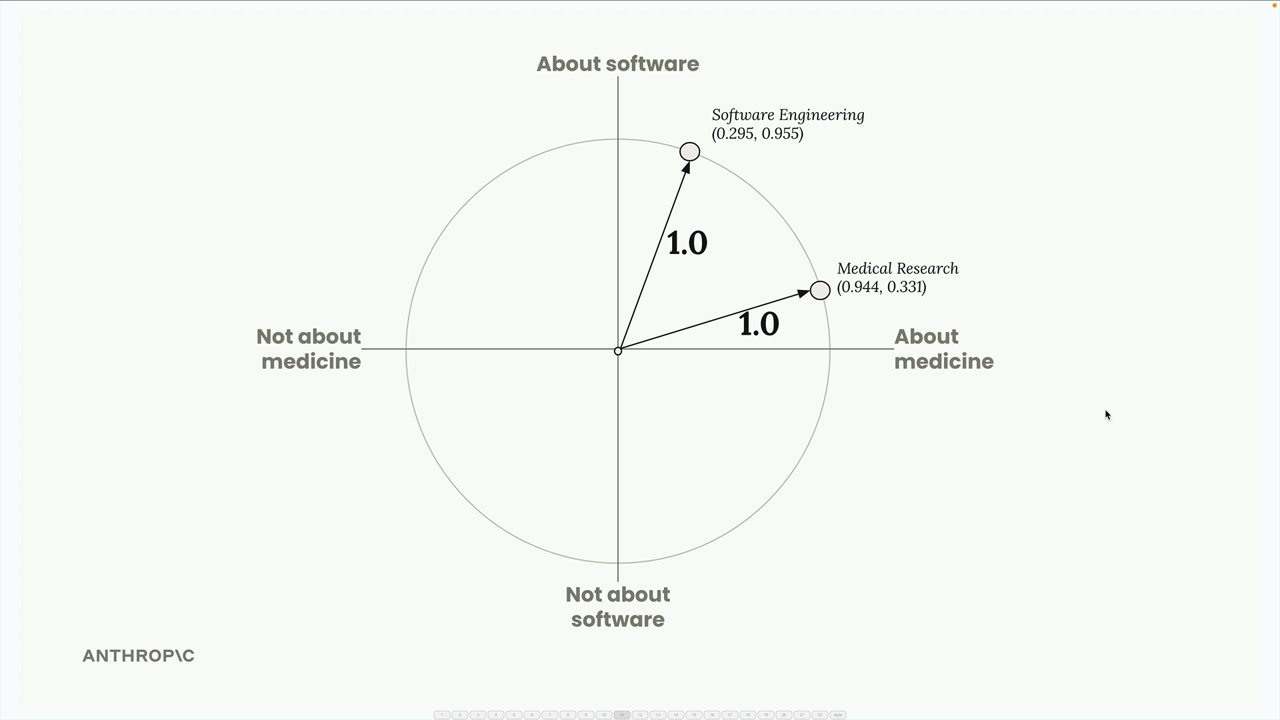
我們可以在單位圓上視覺化這些嵌入,其中每個點代表我們的一個文字區塊。
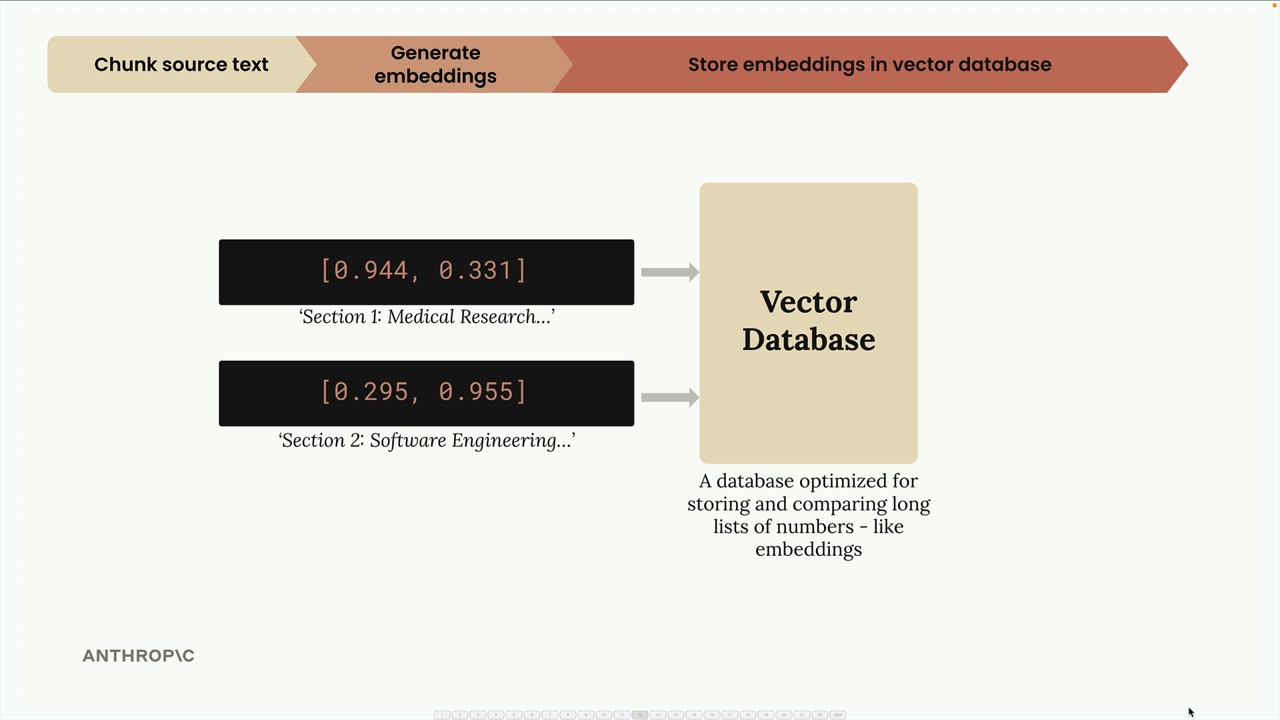
步驟 3:儲存在向量資料庫中
我們將這些嵌入儲存在向量資料庫中 - 這是一種專門用於儲存、比較和搜尋像我們的嵌入這樣的長數字列表的資料庫。
此時,我們暫停一下。到目前為止所做的所有工作都是提前進行的預處理。現在我們等待使用者提交查詢。
步驟 4:處理使用者查詢
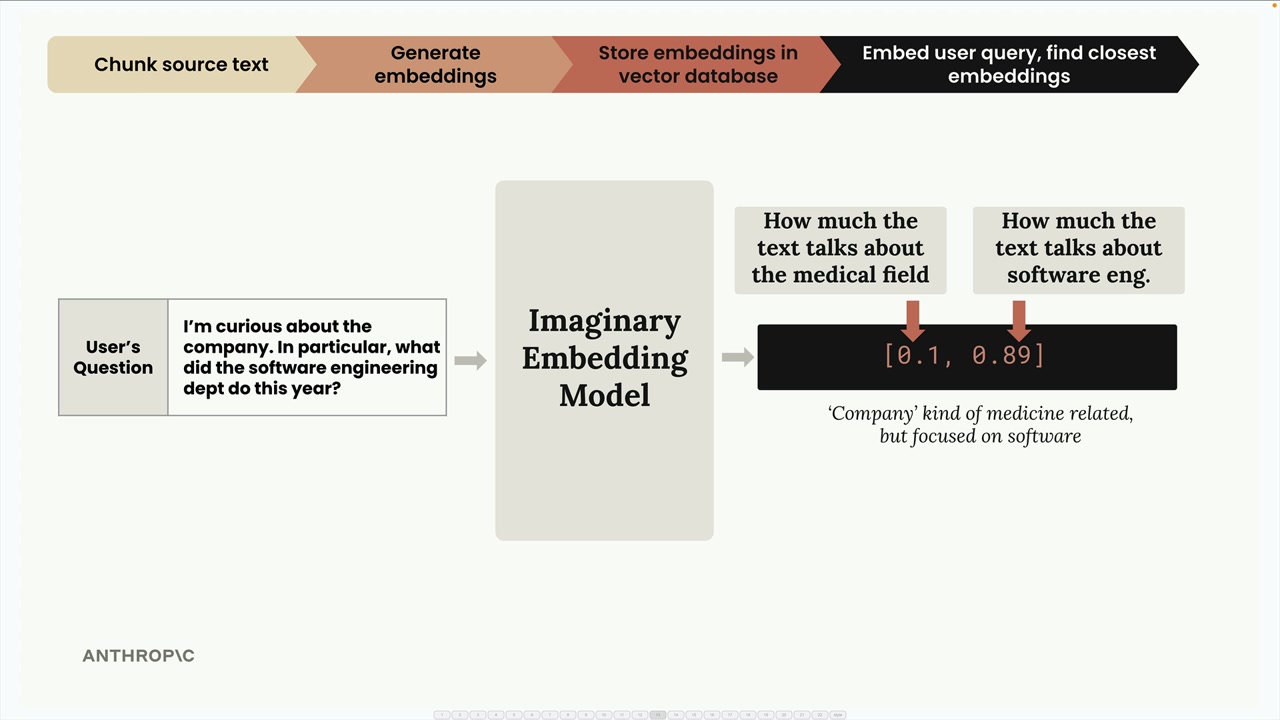
當使用者提出像「我對這家公司很好奇。特別是,軟體工程部門今年做了什麼?」這樣的問題時,我們將他們的查詢透過相同的嵌入模型處理。
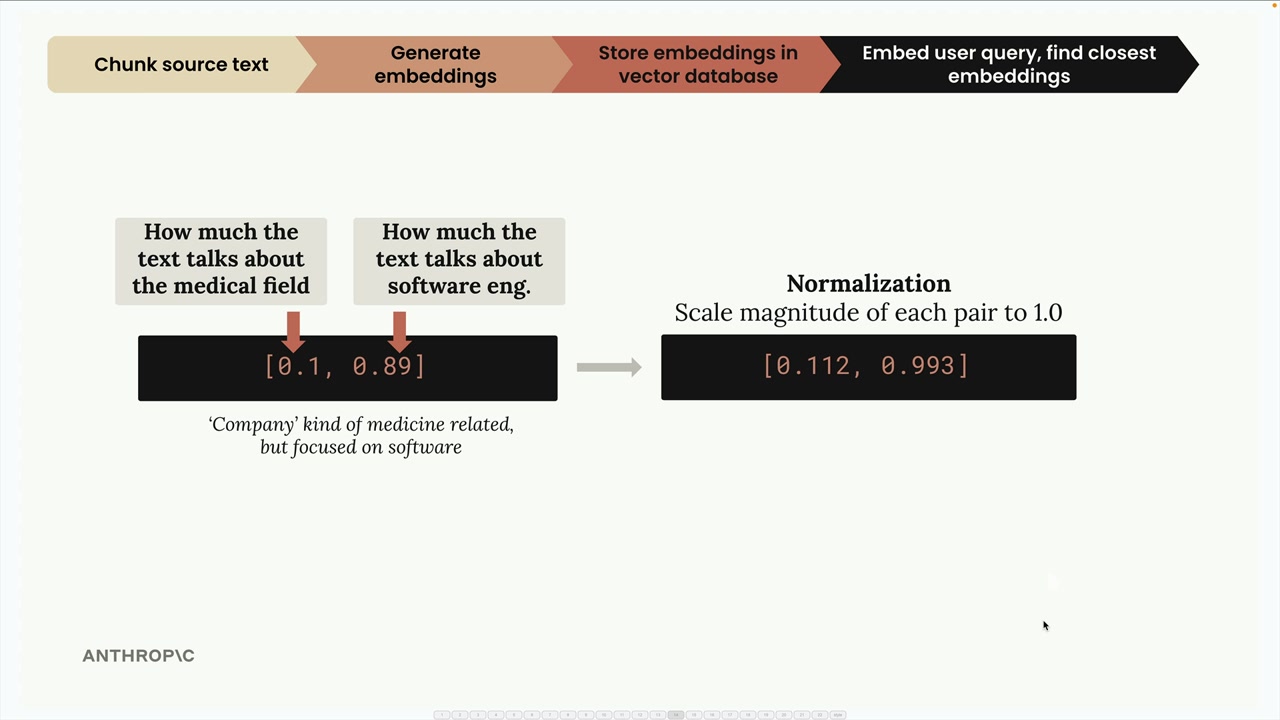
這個查詢被嵌入為類似 [0.1, 0.89] 的東西 - 低醫學分數,高軟體工程分數。正規化後,我們得到 [0.112, 0.993]。
步驟 5:尋找相似的嵌入
我們將使用者的查詢嵌入傳送到我們的向量資料庫,並要求它找到最相似的已儲存嵌入。
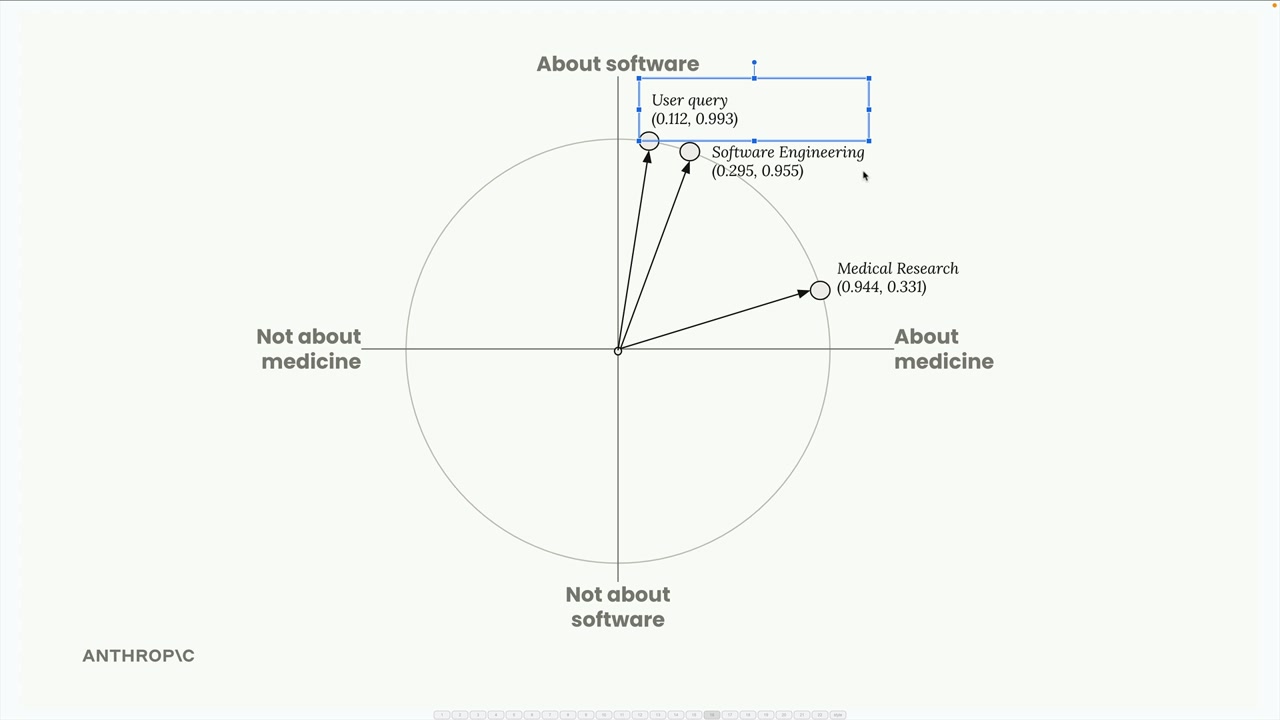
資料庫回傳了軟體工程區段,因為它是與使用者所詢問內容最接近的匹配。
相似度如何運作:餘弦相似度
向量資料庫使用餘弦相似度來判斷哪些嵌入最相似。這測量的是兩個向量之間夾角的餘弦值。
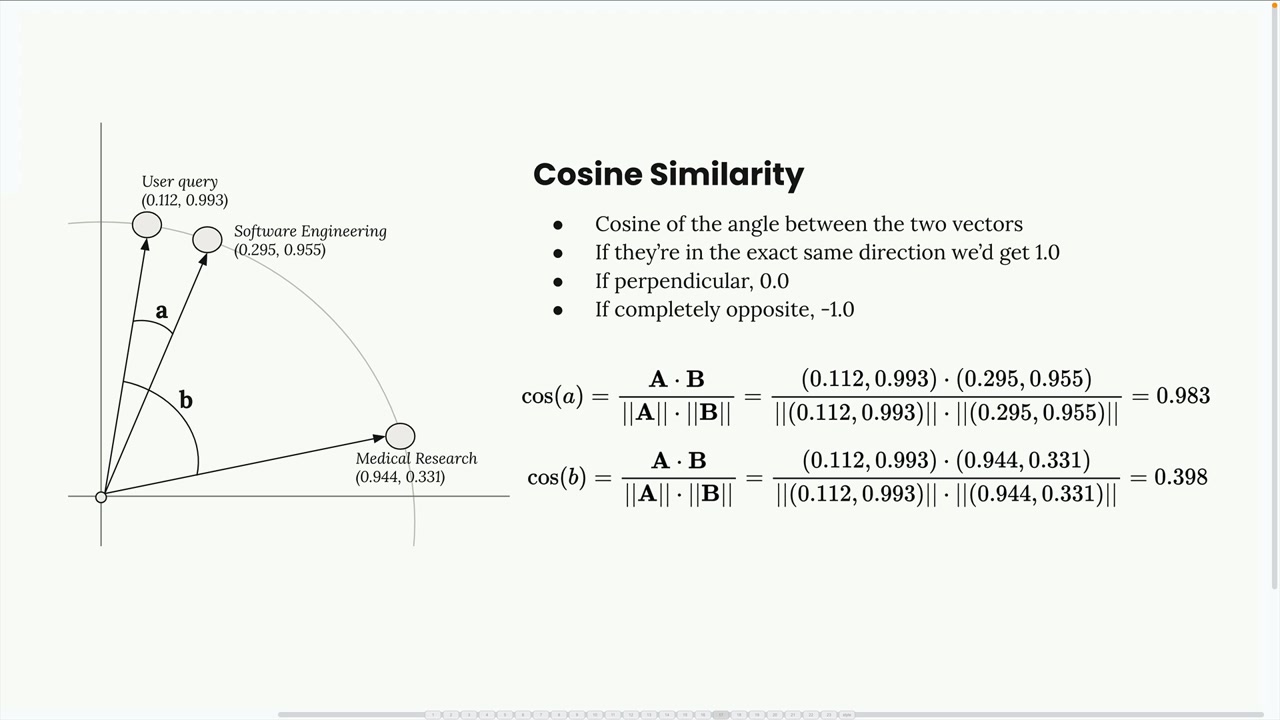
關於餘弦相似度的要點:
- 結果範圍從 -1 到 1
- 接近 1 的值表示高相似度
- 接近 -1 的值表示非常不同
- 0 表示垂直(無關係)
在我們的範例中,使用者查詢與軟體工程區塊之間的餘弦相似度為 0.983 - 非常高的相似度。與醫學研究區塊的相似度僅為 0.398 - 低得多。
餘弦距離
您會經常在向量資料庫文件中看到「餘弦距離」。這只是簡單地計算為 (1 - 餘弦相似度)。使用餘弦距離:
- 接近 0 的值表示高相似度
- 較大的值表示較低的相似度
這種調整使得數字在許多情境下更容易解讀。
步驟 6:建立最終提示
最後,我們取得使用者的問題和我們找到的最相關文字區塊,將它們組合成一個提示,並將其傳送給 Claude 以取得回應。
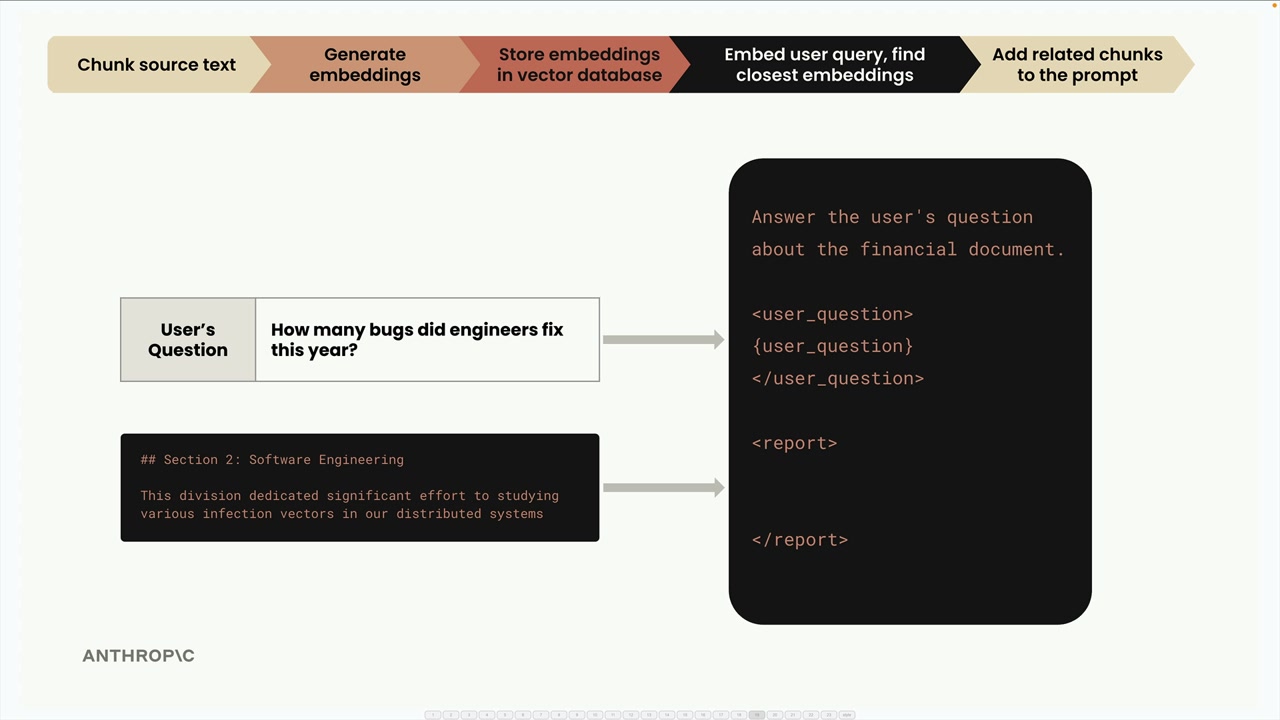
提示可能看起來像這樣:
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>這就是完整的 RAG 流程!系統成功地根據語義相似度檢索到最相關的資訊,並將其作為生成準確回應的上下文提供。