在建構提示評估工作流程時,評分系統提供關於輸出品質的客觀訊號。評分器(grader)接收模型輸出並回傳某種可衡量的回饋——通常是 1 到 10 之間的數字,其中 10 代表高品質,1 代表低品質。
評分器的類型
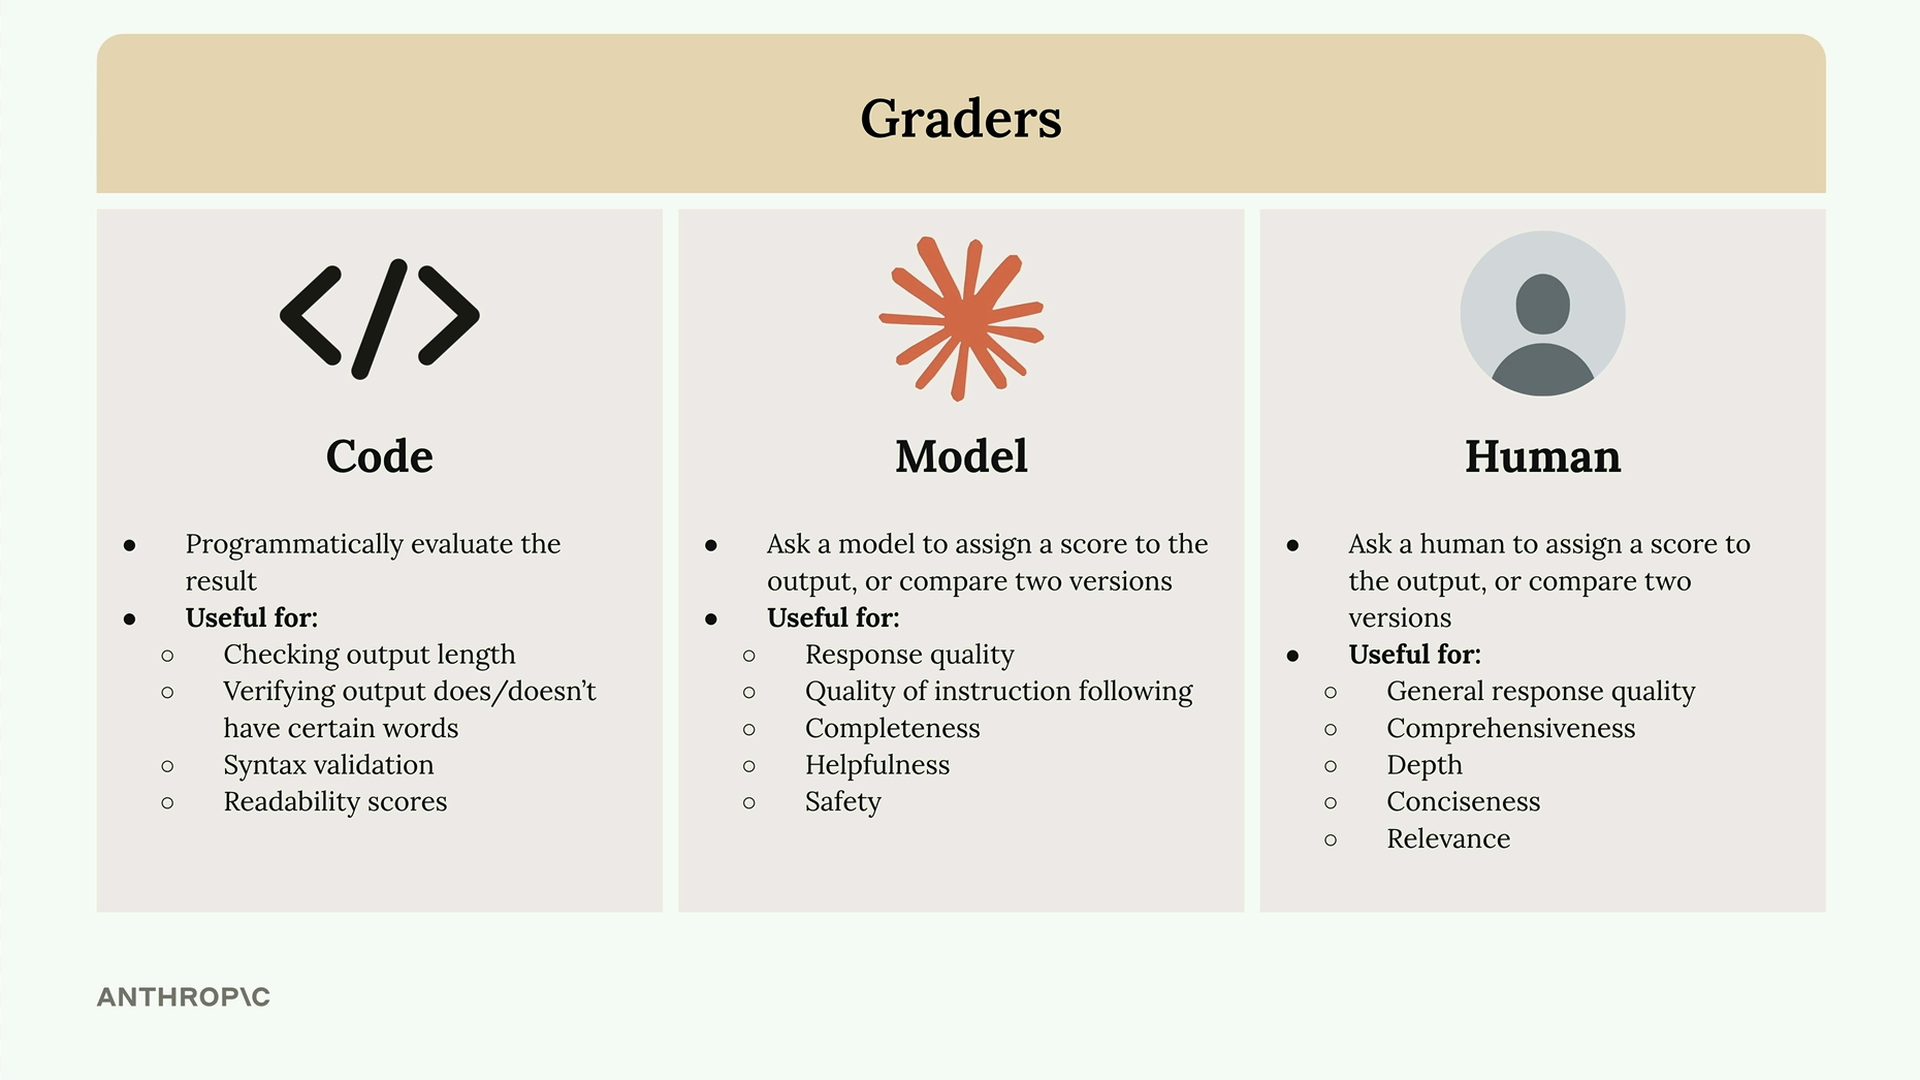
評估模型輸出主要有三種方法:
- 程式碼評分器(Code graders) - 使用自訂邏輯以程式化方式評估輸出
- 模型評分器(Model graders) - 使用另一個 AI 模型來評估品質
- 人工評分器(Human graders) - 由人員手動審查並評分輸出
程式碼評分器
程式碼評分器讓您能夠實作任何您能想到的程式化檢查。常見用途包括:
- 檢查輸出長度
- 驗證輸出是否包含(或不包含)特定字詞
- JSON、Python 或正規表達式的語法驗證
- 可讀性評分
唯一的要求是您的程式碼要回傳某種可用的訊號——通常是 1 到 10 之間的數字。
模型評分器
模型評分器將您的原始輸出餵入另一個 API 呼叫以進行評估。這種方法在評估以下項目時提供了極大的靈活性:
- 回應品質
- 指令遵循的品質
- 完整性
- 有幫助性
- 安全性
人工評分器
人工評分器提供最大的靈活性,但耗時且繁瑣。它們適用於評估:
- 整體回應品質
- 全面性
- 深度
- 簡潔性
- 相關性
定義評估標準
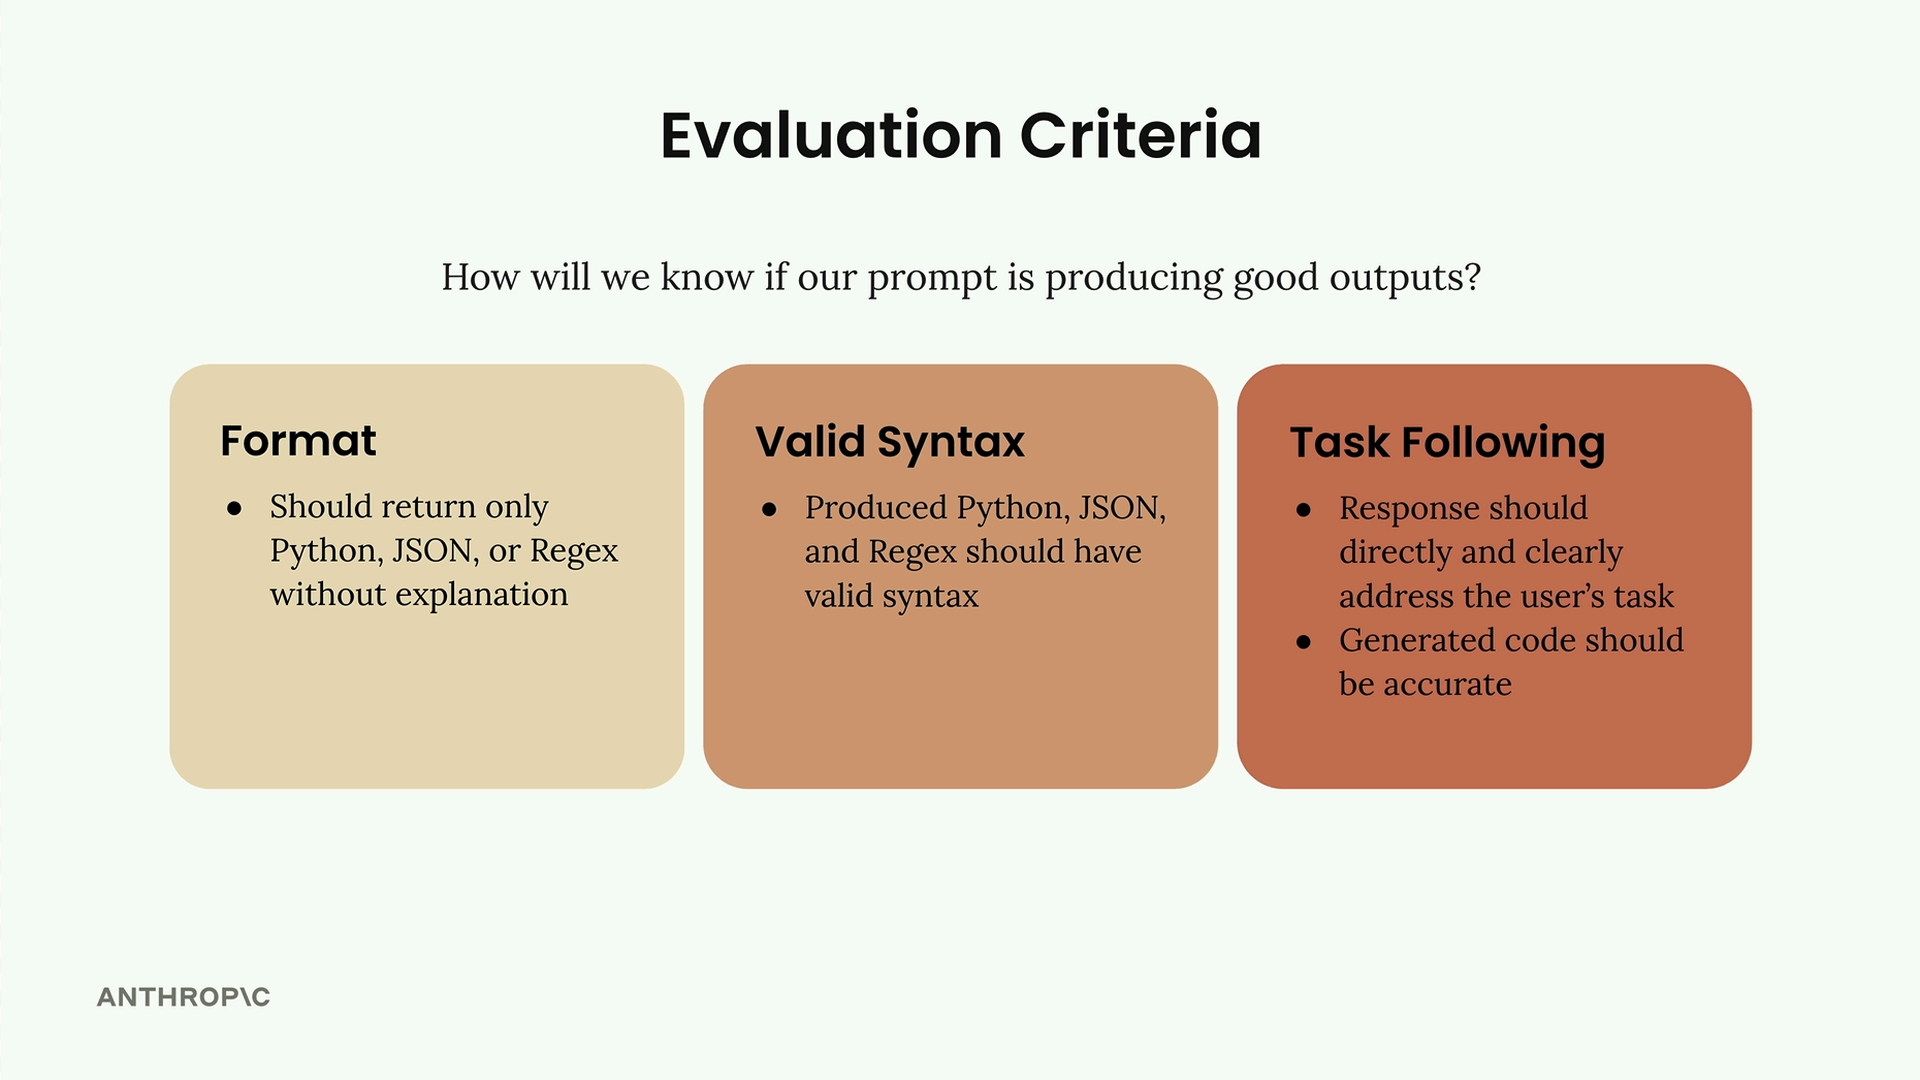
在實作任何評分器之前,您需要明確的評估標準。對於程式碼生成提示,您可能會關注:
- 格式 - 應僅回傳 Python、JSON 或正規表達式,不含說明
- 有效語法 - 產生的程式碼應具有有效語法
- 任務遵循 - 回應應以準確的程式碼直接回應使用者的任務
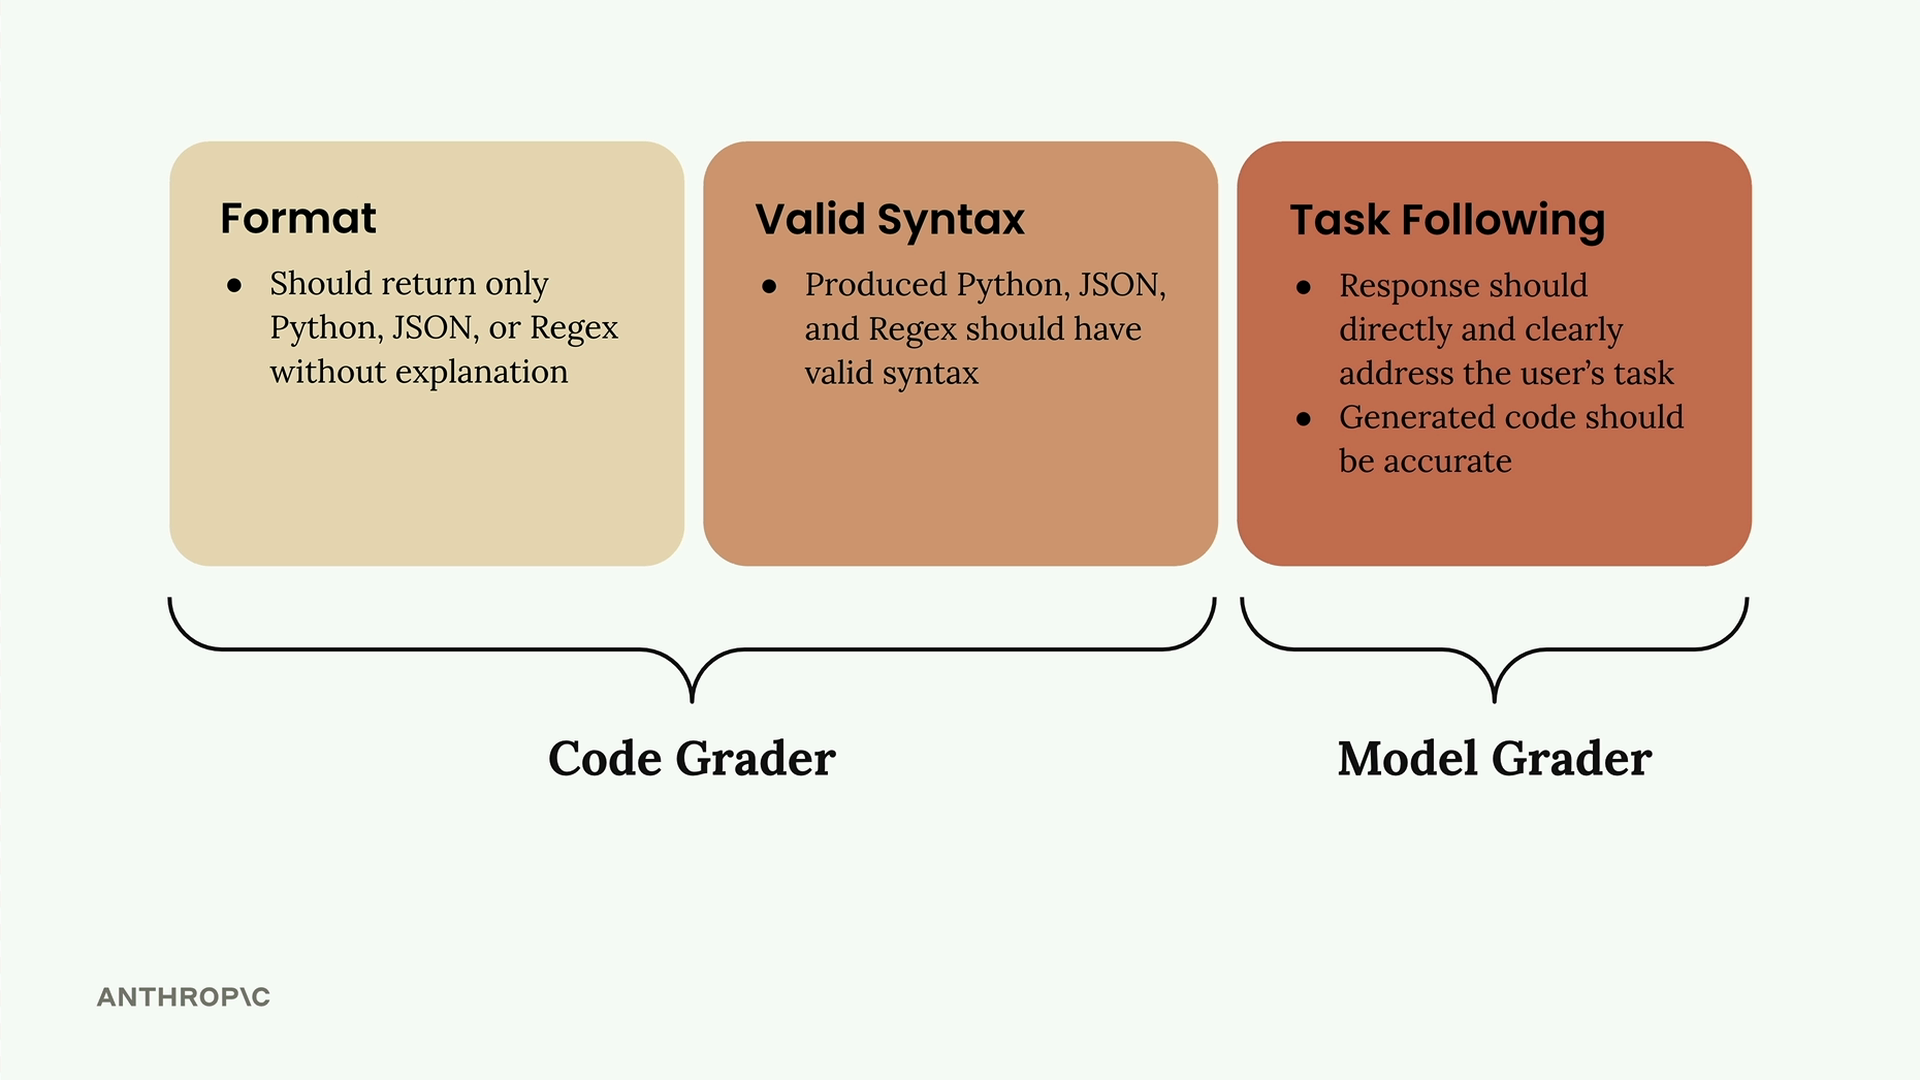
前兩項標準適合使用程式碼評分器,而任務遵循則因其靈活性更適合使用模型評分器。
實作模型評分器
以下是建構模型評分器函式的方法:
def grade_by_model(test_case, output):
    # 建立評估提示
    eval_prompt = """
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {task}
    Solution: {solution}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")

    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)
關鍵的洞見是在評分的同時要求提供優點、缺點和推理過程。若沒有這些背景資訊,模型往往會預設給出大約 6 分左右的中等分數。 ## 將評分整合到您的工作流程中 更新您的測試案例執行器以呼叫評分器: ``` def run_test_case(test_case): output = run_prompt(test_case) # Grade the output model_grade = grade_by_model(test_case, output) score = model_grade["score"] reasoning = model_grade["reasoning"] return \{ "output": output, "test_case": test_case, "score": score, "reasoning": reasoning \} ``` `` 最後,計算所有測試案例的平均分數: ``` from statistics import mean def run_eval(dataset): results = [] for test_case in dataset: result = run_test_case(test_case) results.append(result) average_score = mean([result["score"] for result in results]) print(f"Average score: \{average_score\}") return results ``` ` 這為您提供了一個客觀的指標,可在您迭代提示時追蹤。雖然模型評分器可能有些反覆無常,但它們為衡量改進提供了一致的基準。 ` ``