在建構 RAG 管線時,您很快就會發現,僅靠語意搜尋並不總能返回最佳結果。有時您需要精確的詞彙匹配,而這正是語意搜尋可能會遺漏的。解決方案是使用一種稱為 BM25 的技術,將語意搜尋與詞彙搜尋結合起來。
僅靠語意搜尋的問題
假設您正在文件中搜尋一個特定的事件編號,例如「INC-2023-Q4-011」。雖然語意搜尋擅長理解上下文和含義,但它可能會返回在語意上相關、但實際上並不包含您要尋找的確切詞彙的段落。
在上面的範例中,語意搜尋返回了網路安全章節(確實包含該事件編號),但也返回了一個完全沒有提及該事件的財務分析章節。這是因為語意搜尋專注於概念上的相似性,而非精確的詞彙匹配。
混合搜尋策略
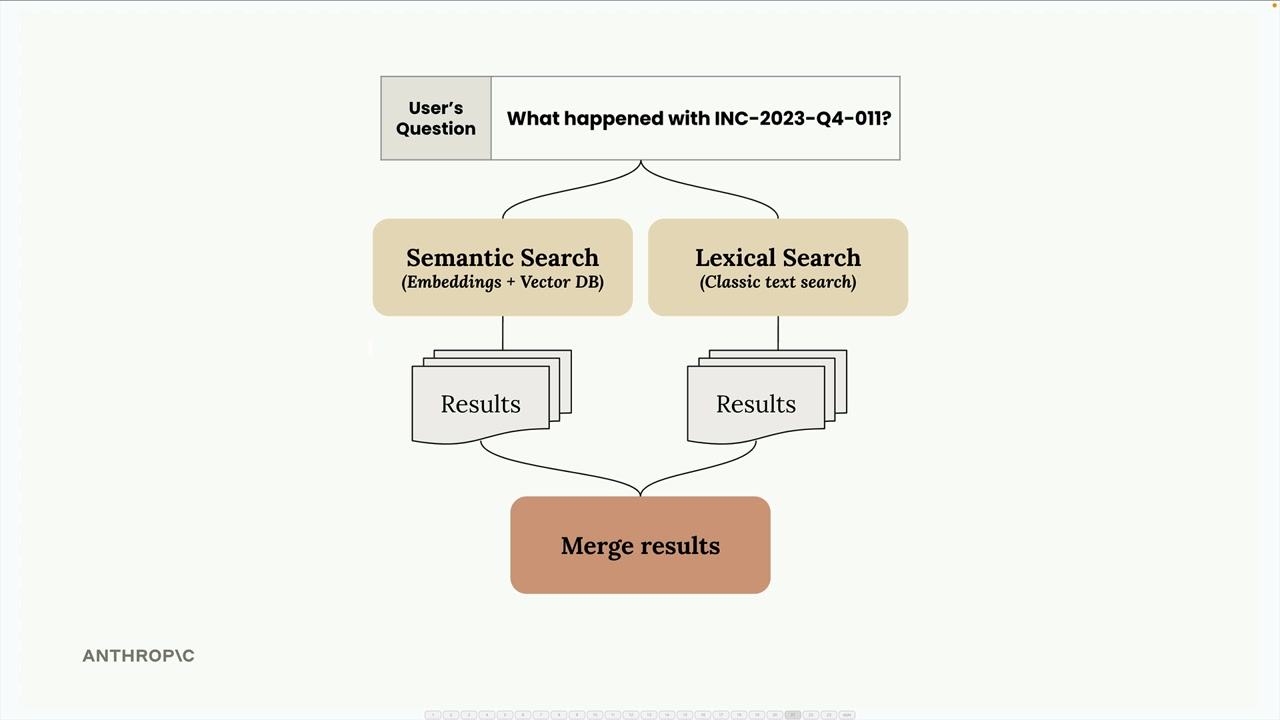
解決方案是並行執行語意搜尋和詞彙搜尋,然後合併結果。這樣可以兼得兩者的優點:
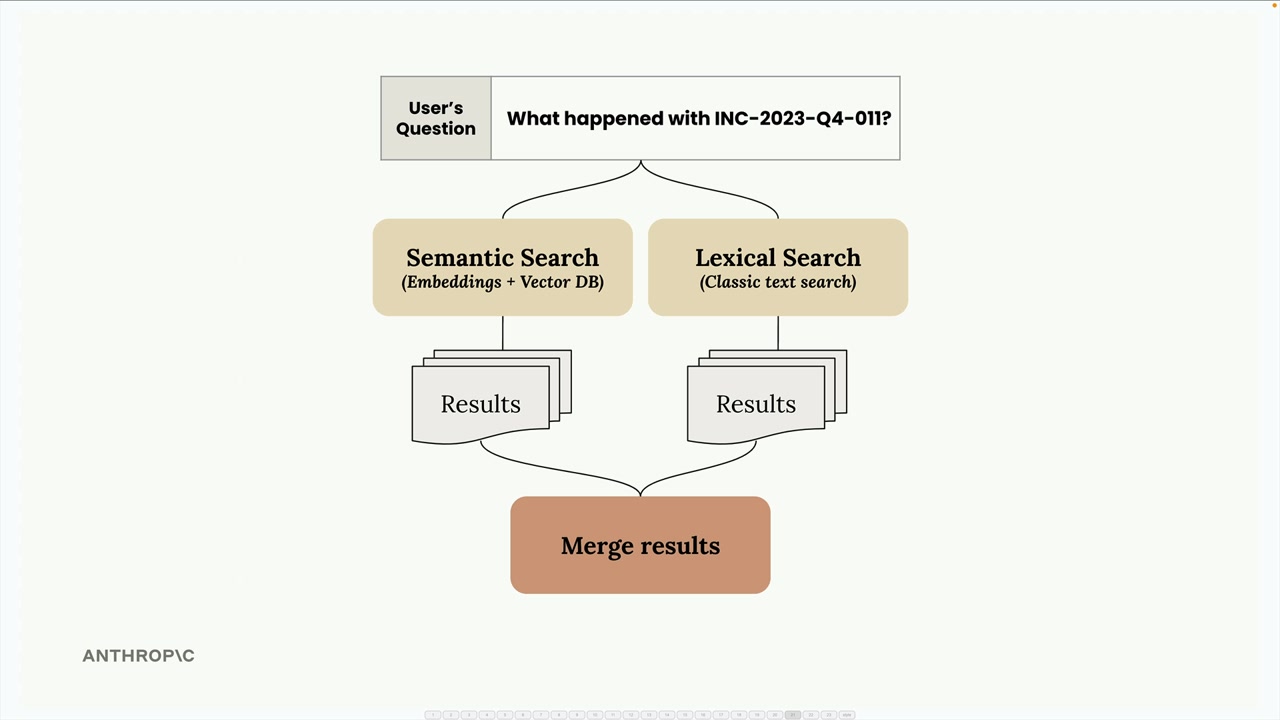
- 語意搜尋使用嵌入向量找出概念上相關的內容
- 詞彙搜尋使用傳統文字搜尋找出精確的詞彙匹配
- 合併結果結合兩種方法以獲得更好的準確性
BM25 的運作方式
BM25(Best Match 25)是 RAG 系統中一種常用的詞彙搜尋演算法。以下是它處理搜尋查詢的方式:
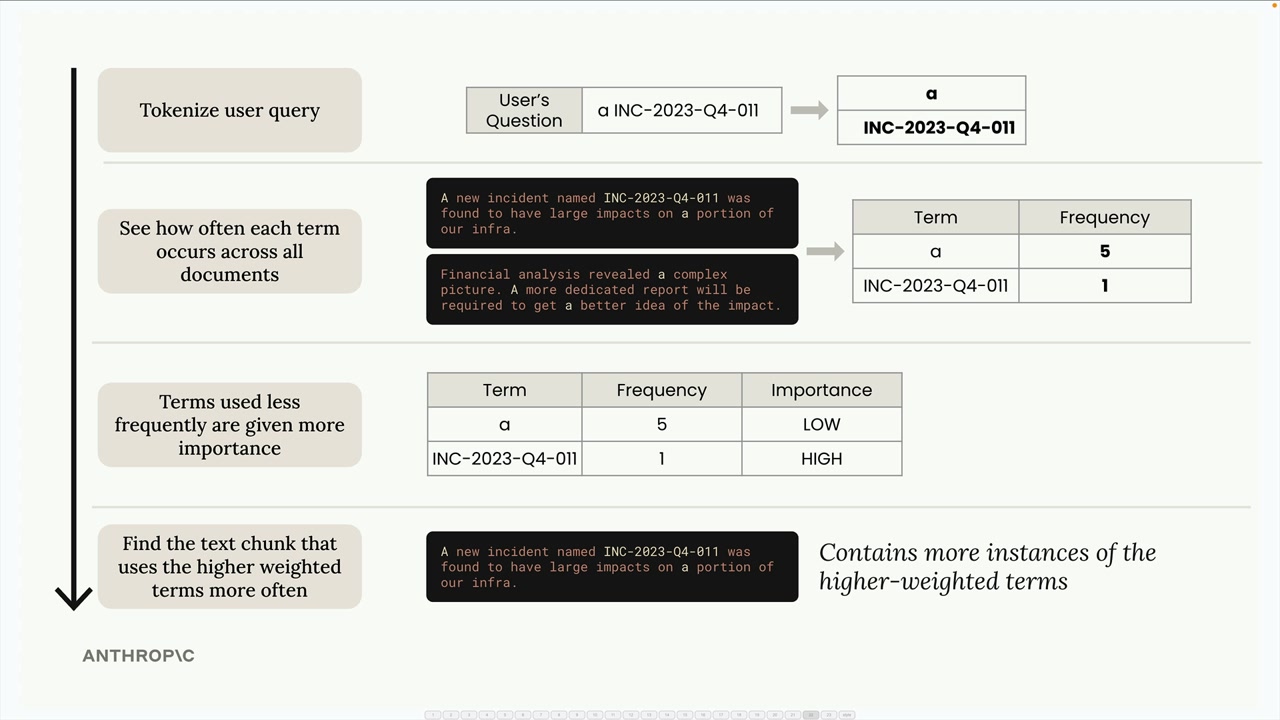
步驟 1:將查詢分詞 將使用者的問題拆分成個別的詞彙。例如,「a INC-2023-Q4-011」會變成 ["a", "INC-2023-Q4-011"]。
步驟 2:計算詞頻 查看每個詞彙在您所有文件中出現的頻率。常見詞彙如「a」可能出現 5 次,而特定詞彙如「INC-2023-Q4-011」可能只出現一次。
步驟 3:依重要性為詞彙加權 出現頻率較低的詞彙會獲得較高的重要性分數。「a」這個詞因為很常見而獲得較低的重要性,而「INC-2023-Q4-011」因為很罕見而獲得較高的重要性。
步驟 4:找出最佳匹配 返回包含較多高權重詞彙實例的文件。
實作 BM25 搜尋
以下是如何建立一個基本的 BM25 搜尋系統:
# 1. 依章節分割您的文字
chunks = chunk_by_section(text)

# 2. 建立 BM25 儲存庫並加入文件
store = BM25Index()
for chunk in chunks:
    store.add_document({"content": chunk})

# 3. 搜尋儲存庫
results = store.search("What happened with INC-2023-Q4-011?", 3)

# 列印結果
for doc, distance in results:
    print(distance, "\n", doc["content"][:200], "\n----\n")
當您執行此搜尋時,您會得到比僅使用語意搜尋好得多的結果。BM25 演算法會優先處理實際包含您特定搜尋詞彙的段落,尤其是像事件編號這類罕見的詞彙。
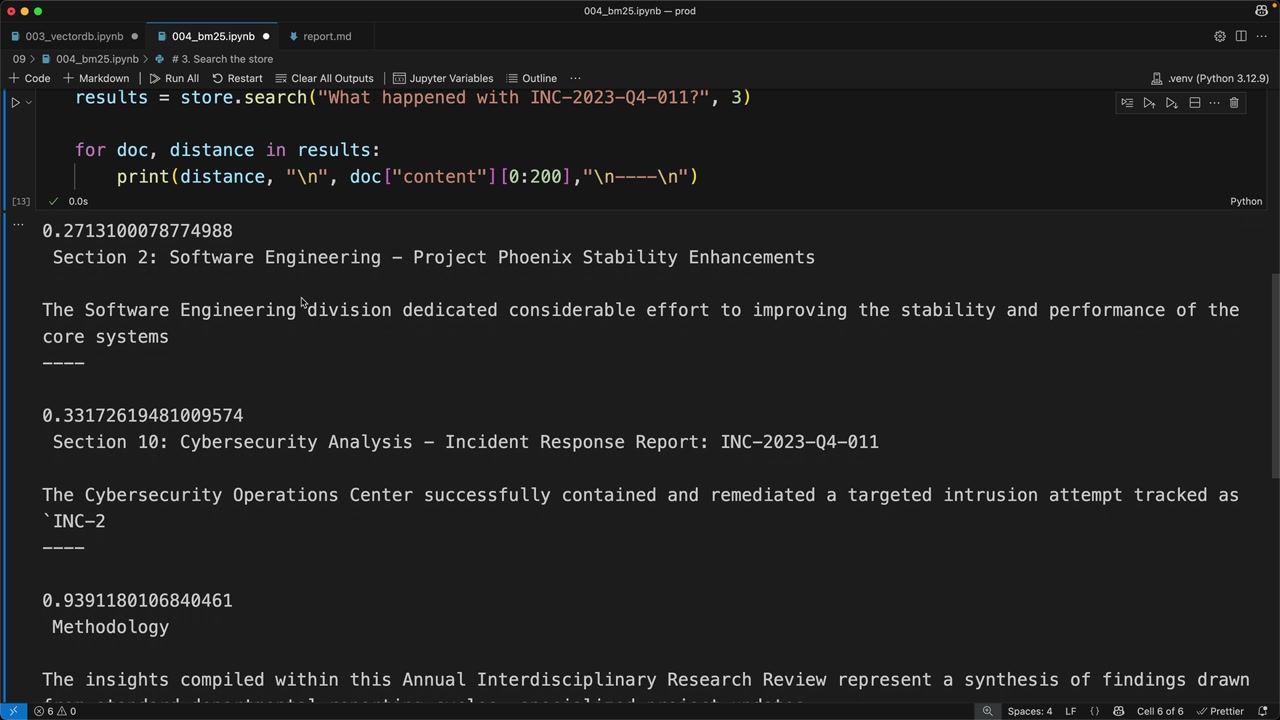
請注意,現在的結果正確地優先顯示了軟體工程章節和網路安全章節——這兩個章節都確實包含您正在搜尋的事件編號。
為什麼這種方法效果更好
BM25 擅長找出精確匹配,因為它:
- 對罕見、特定的詞彙給予較高的權重
- 忽略不會增加搜尋價值的常見詞彙
- 專注於詞頻而非語意含義
- 特別適用於技術術語、編號和特定片語
關鍵的洞見是,這兩種搜尋方法具有互補的優勢。語意搜尋理解上下文和含義,而詞彙搜尋則確保您不會錯過精確的詞彙匹配。透過結合兩者,您可以建立一個更強健的搜尋系統,有效處理概念性查詢和特定查找。
在下一步中,您將學習如何合併這兩種搜尋系統的結果,以建立統一的混合搜尋體驗。