Claude 可以直接讀取和分析 PDF 檔案,使其成為文件處理的強大工具。此功能的運作方式與圖像處理類似,但在程式碼結構上有一些關鍵差異。
設定 PDF 處理
要使用 Claude 處理 PDF 檔案,您將使用與處理圖像幾乎相同的程式碼。主要差異在於檔案類型規格以及為求清晰而使用的變數名稱。
以下是如何修改您現有的圖像處理程式碼以處理 PDF:
python
with open("earth.pdf", "rb") as f:
    file_bytes = base64.standard_b64encode(f.read()).decode("utf-8")

messages = []

add_user_message(
    messages,
    [
        {
            "type": "document",
            "source": {
                "type": "base64",
                "media_type": "application/pdf",
                "data": file_bytes,
            },
        },
        {"type": "text", "text": "Summarize the document in one sentence"},
    ],
)

chat(messages)
與圖像處理的主要差異
在將您的圖像處理程式碼調整為 PDF 時,您需要更新幾個元素:
- 將檔案副檔名從
.png改為.pdf - 將變數名稱從
image_bytes改為file_bytes以求清晰 - 將類型設定為
"document"而非"image" - 將媒體類型改為
"application/pdf"而非"image/png"
Claude 可以從 PDF 中提取什麼
Claude 的 PDF 處理能力不僅限於簡單的文字提取。它可以分析和理解:
- 整份文件中的文字內容
- 嵌入在 PDF 中的圖像和圖表
- 表格及其數據關係
- 文件結構和格式
這使得 Claude 基本上成為從 PDF 文件中提取任何類型資訊的一站式解決方案,無論您需要摘要、數據分析還是特定內容提取。
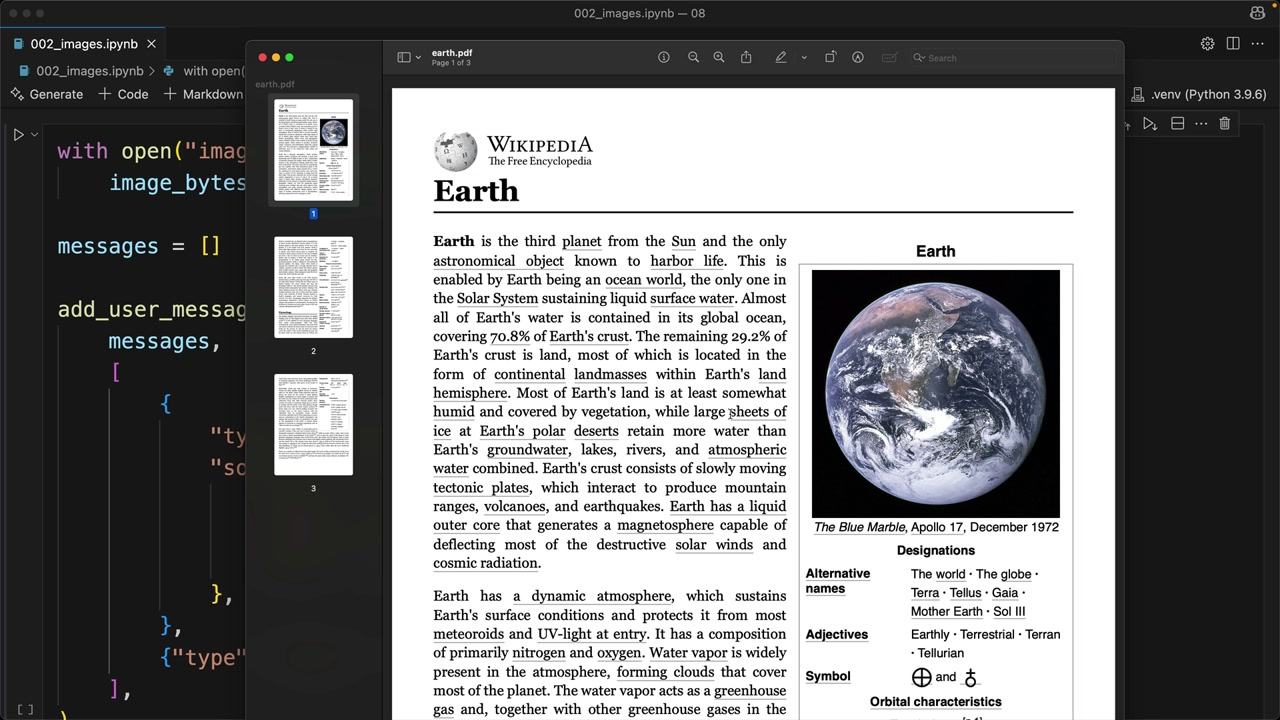
上面的範例顯示 Claude 成功處理了一篇關於地球的 Wikipedia 文章(該文章已儲存為 PDF),展示了它如何能夠在一句話中理解並總結複雜的文件內容。