在將文件分割成區塊之後,RAG 管線的下一步是找出哪些區塊與使用者的問題最相關。這本質上是一個搜尋問題——您需要瀏覽所有的文字區塊,並找出與使用者所詢問內容相關的區塊。
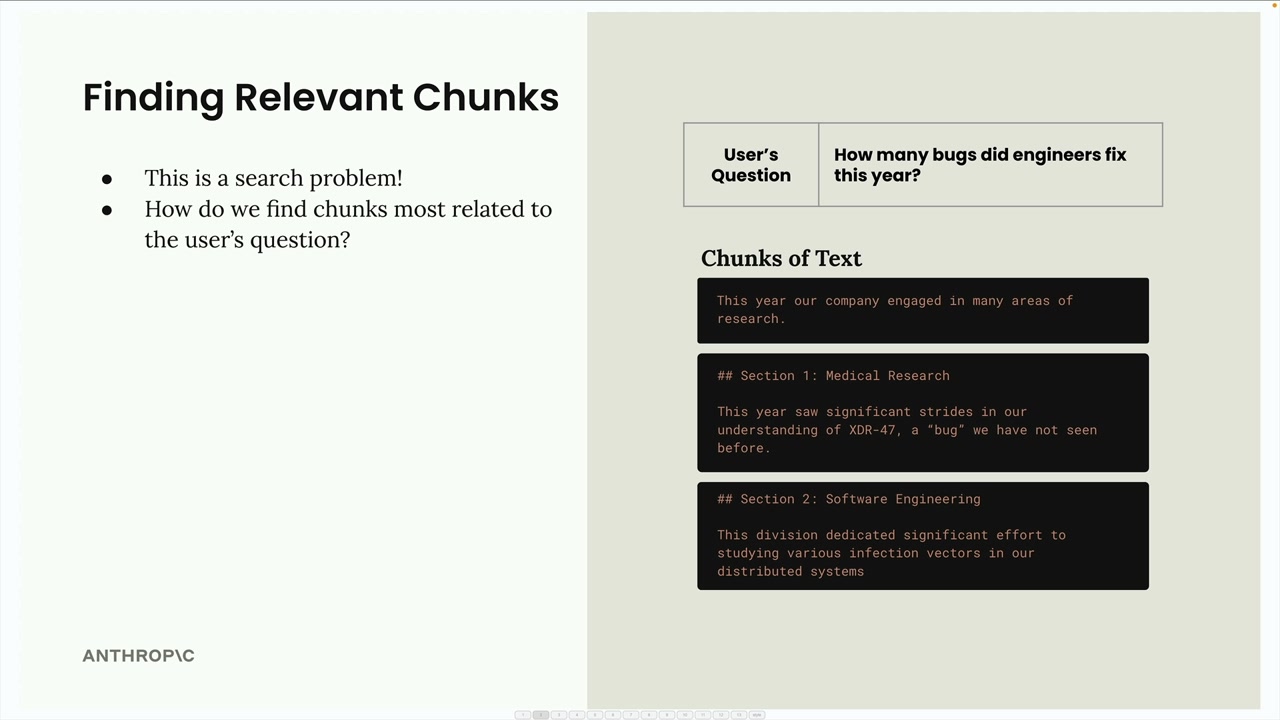
語意搜尋
尋找相關區塊最常見的方法是語意搜尋。與尋找精確字詞匹配的關鍵字搜尋不同,語意搜尋使用文字嵌入來理解使用者問題與每個文字區塊的意義和上下文。
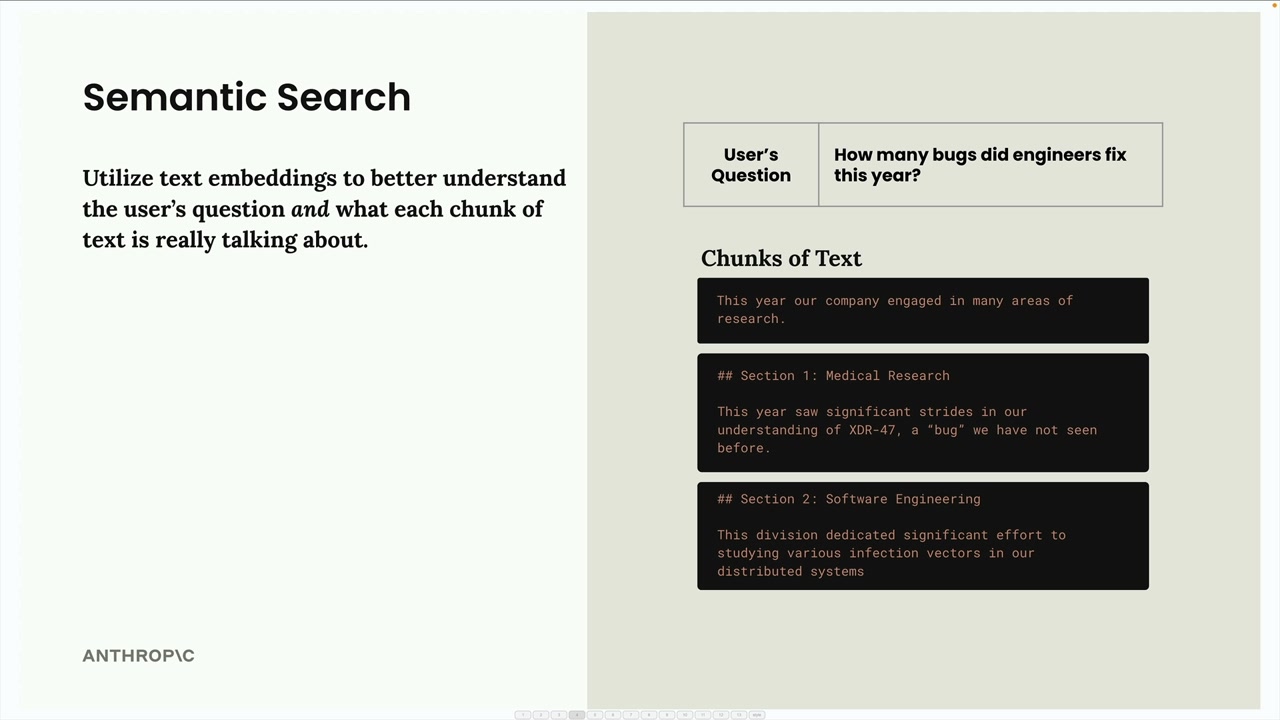
文字嵌入
文字嵌入是某段文字中所包含意義的數值表示。可以將其視為將文字和句子轉換成電腦能夠以數學方式處理的格式。
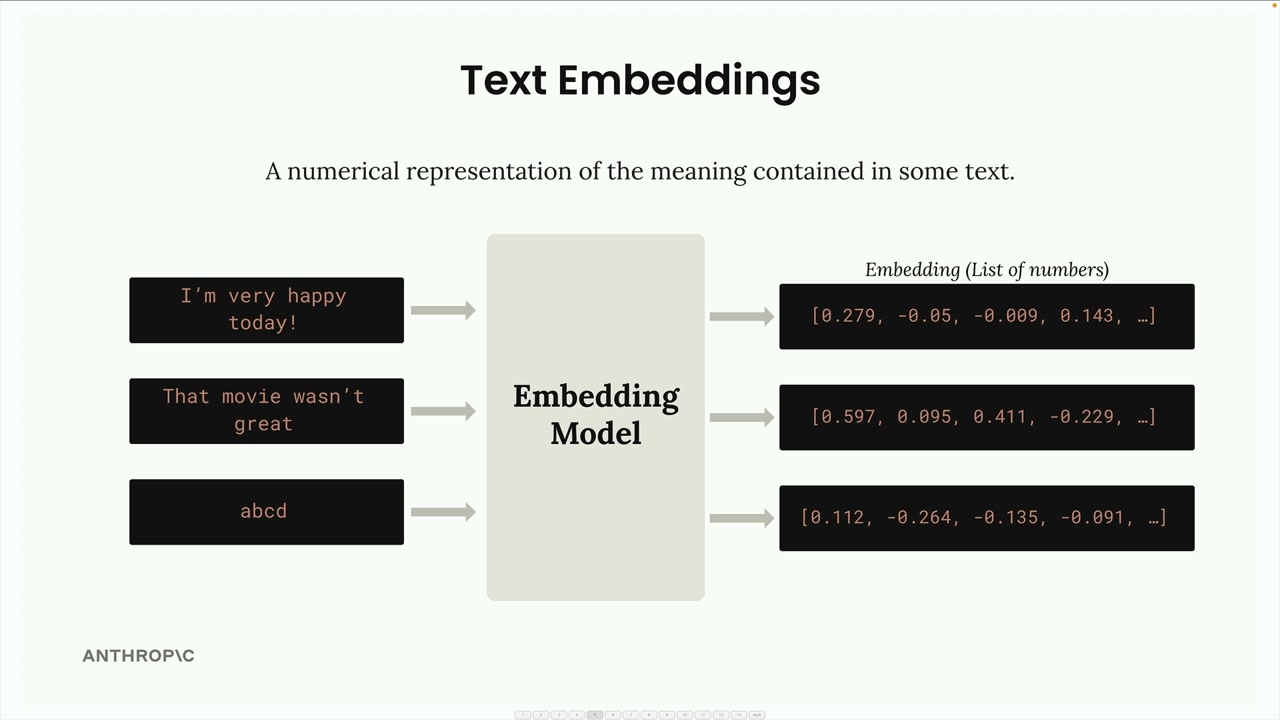
以下是這個過程的運作方式:
- 您將文字輸入嵌入模型
- 模型輸出一長串數字(即嵌入)
- 每個數字的範圍從 -1 到 +1
- 這些數字代表輸入文字的不同特質或特徵
理解這些數字
嵌入中的每個數字本質上是輸入文字某種特質的「分數」。然而,這裡有個重要的警示:我們並不確切知道每個數字代表什麼。
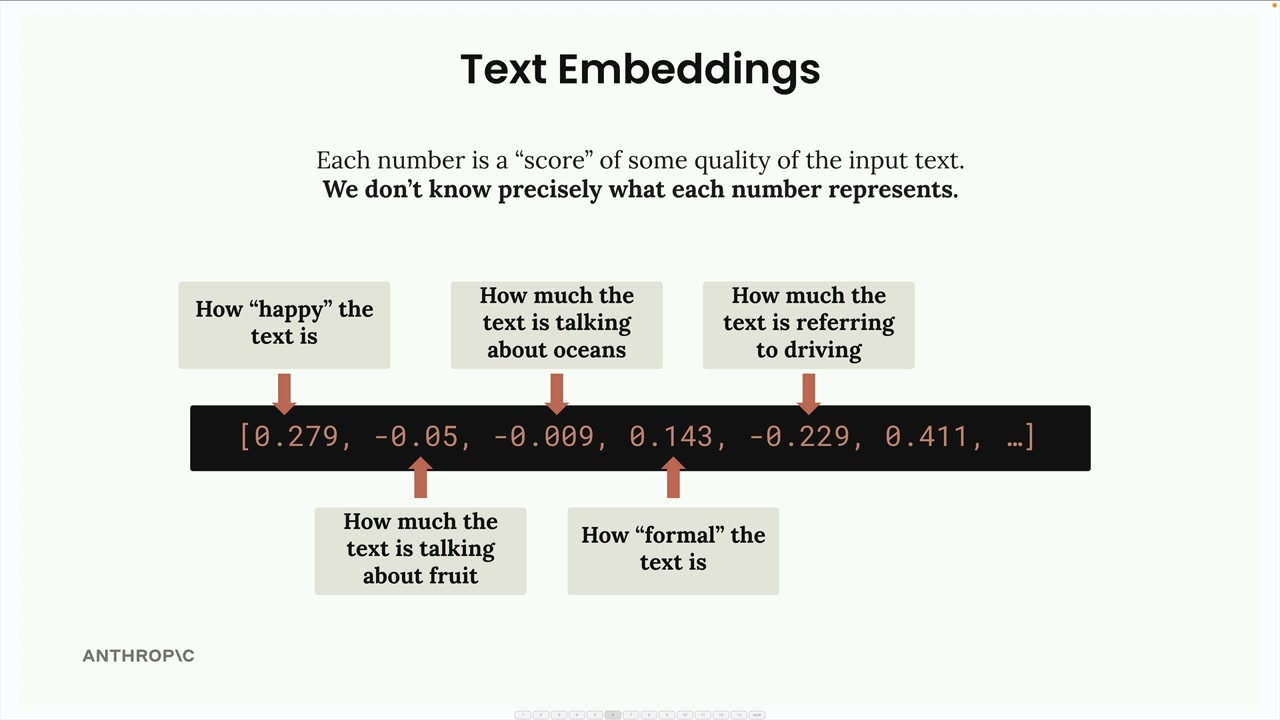
雖然想像某個數字可能代表「這段文字有多快樂」或「這段文字談論海洋的程度」會有所幫助,但這些只是概念性的範例。每個維度的實際意義是模型在訓練過程中學習到的,並非人類可以直接解讀的。
使用 VoyageAI 進行嵌入
由於 Anthropic 目前不提供嵌入生成功能,建議的供應商是 VoyageAI。您需要:
- 註冊一個獨立的 VoyageAI 帳戶
- 取得一個 API 金鑰(免費開始使用)
- 將金鑰加入您的環境變數
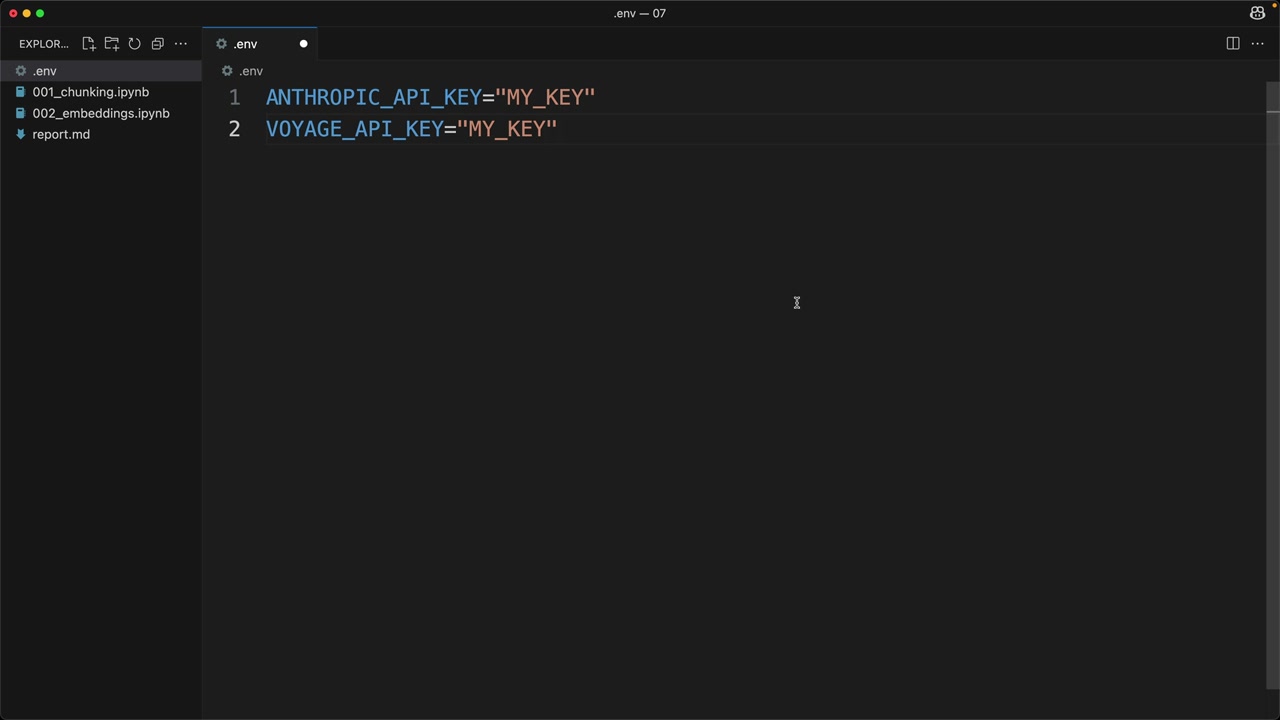
在您的 .env 檔案中,加入:
bash
VOYAGE_API_KEY="your_key_here"實作
首先,安裝 VoyageAI 函式庫:
bash
%pip install voyageai然後設定客戶端並建立一個函式來生成嵌入:
python
from dotenv import load_dotenv
import voyageai

load_dotenv()
client = voyageai.Client()

def generate_embedding(text, model="voyage-3-large", input_type="query"):
    result = client.embed([text], model=model, input_type=input_type)
    return result.embeddings[0]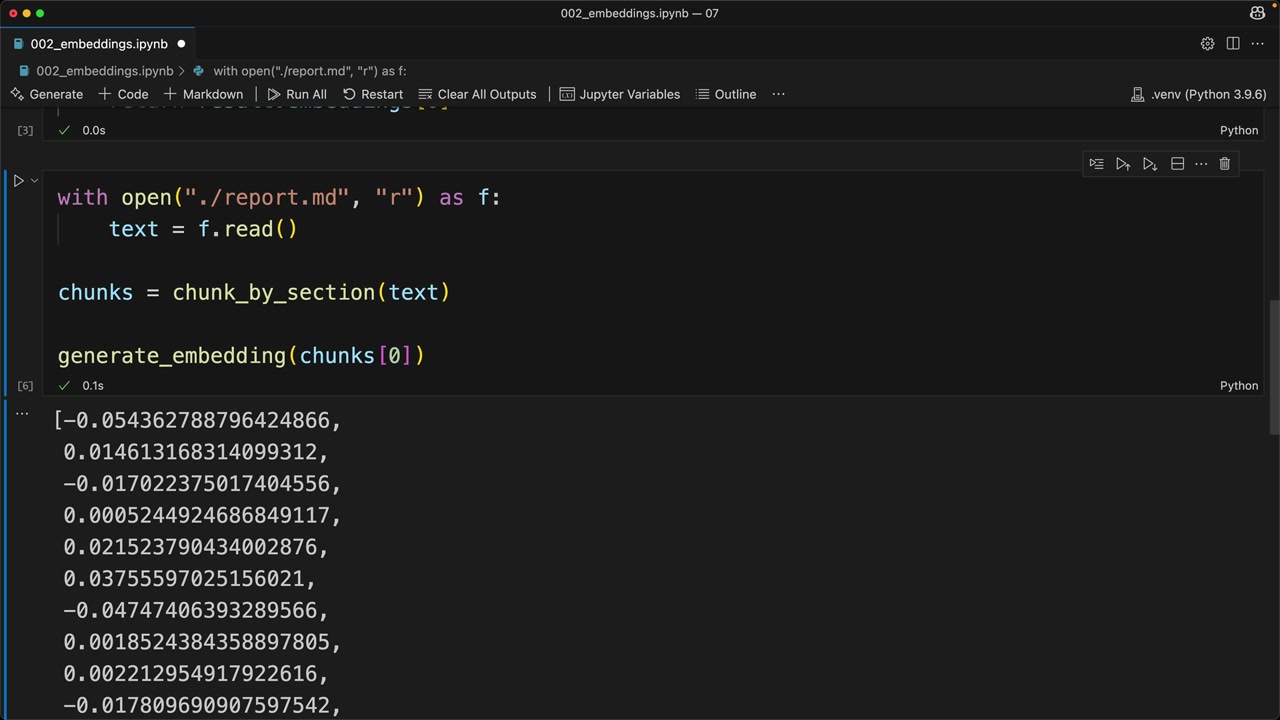
當您對一個文字區塊執行此函式時,您會得到一串代表嵌入的浮點數。這個過程快速且直接——真正的挑戰在於理解如何在您的 RAG 管線中有效地使用這些嵌入,以找出最相關的內容。
下一步是學習如何比較嵌入,以判斷哪些區塊與使用者的問題最相似,這構成了語意搜尋過程的核心。