在評估生成程式碼的 AI 模型時,您需要的不僅僅是檢查回應是否合理。您還需要驗證生成的程式碼是否確實具有有效的語法並遵循正確的格式。這正是基於程式碼的評分發揮作用的地方。
程式碼評分的運作方式
程式碼評分驗證 AI 生成回應的兩個關鍵方面:
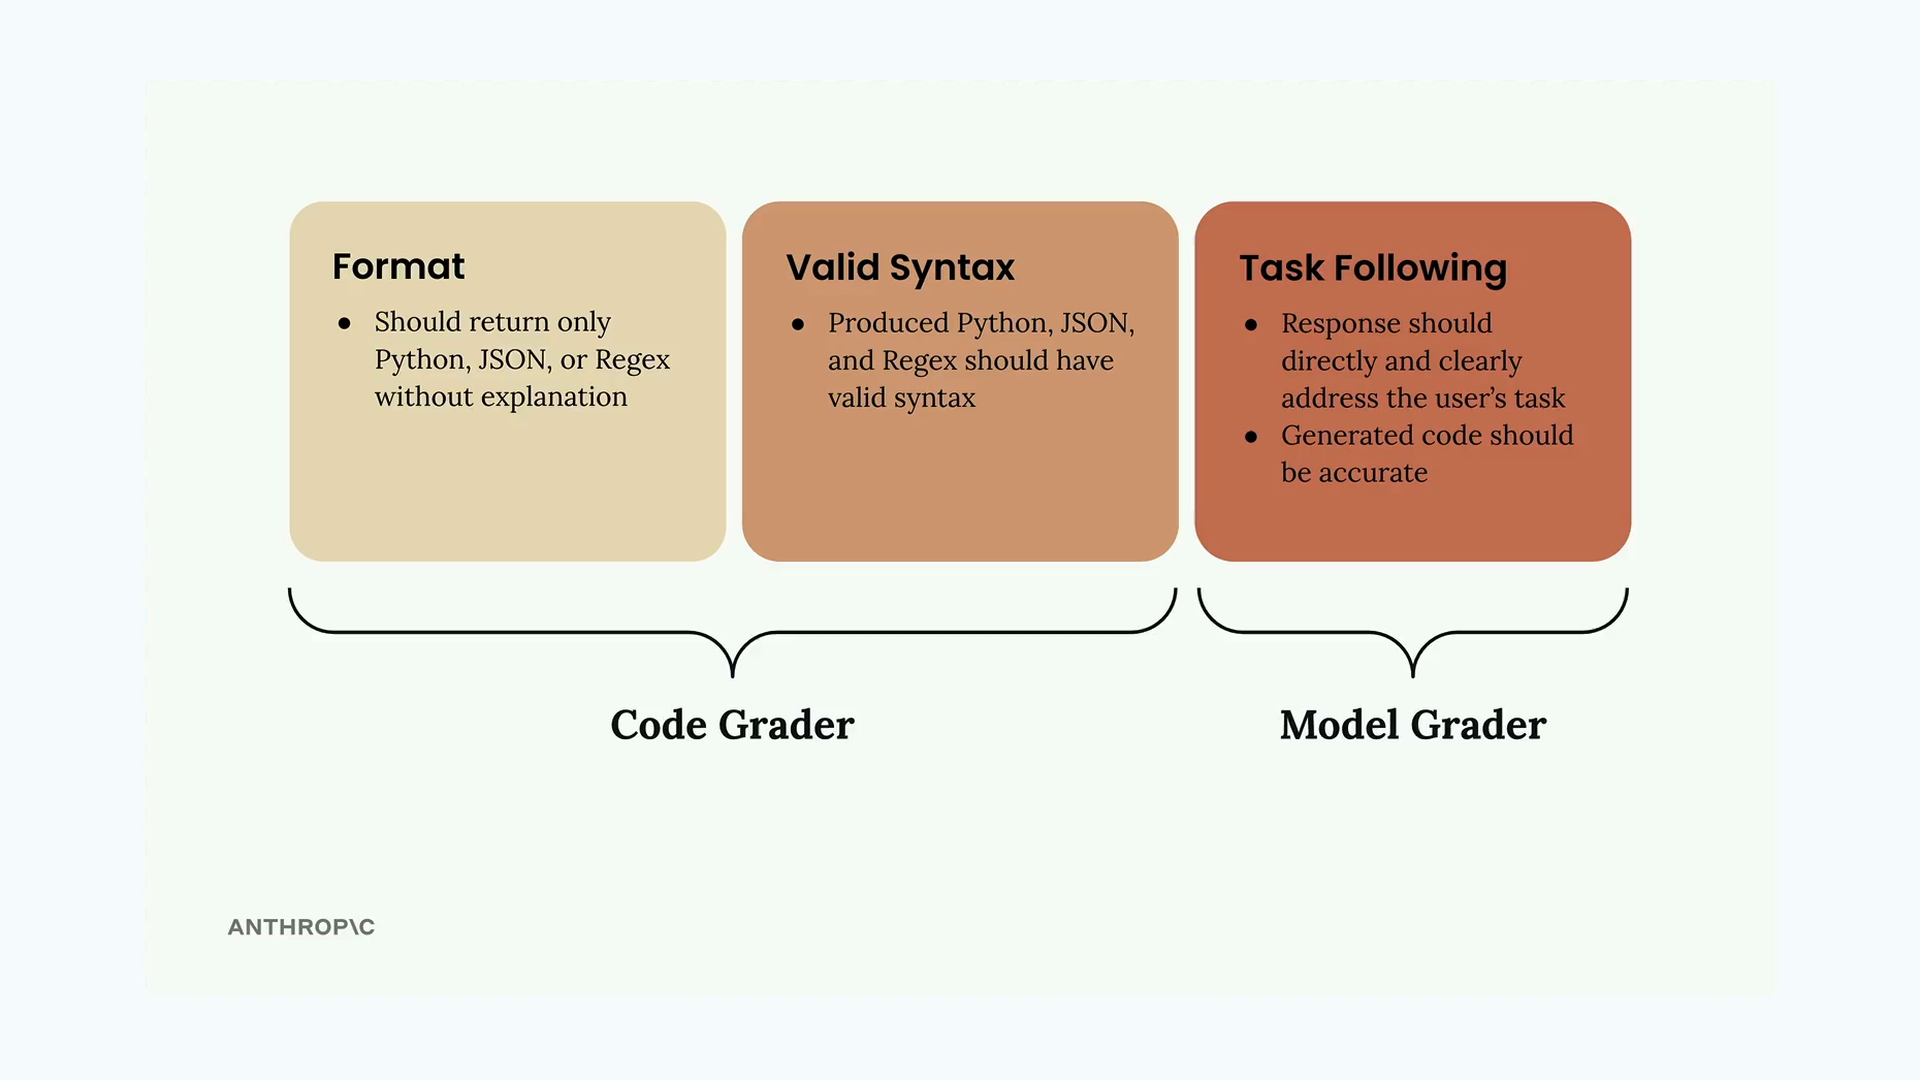
- 格式 - 回應應僅返回所要求的程式碼類型(Python、JSON 或 Regex),不含任何解釋
- 有效語法 - 生成的程式碼應能以預期的語言正確解析
- 任務遵循 - 回應應直接回答所提出的問題並且準確無誤
前兩項標準由程式碼評分器處理,而任務遵循則由模型評分器評估。兩者結合,提供了全面的評估。
語法驗證函式
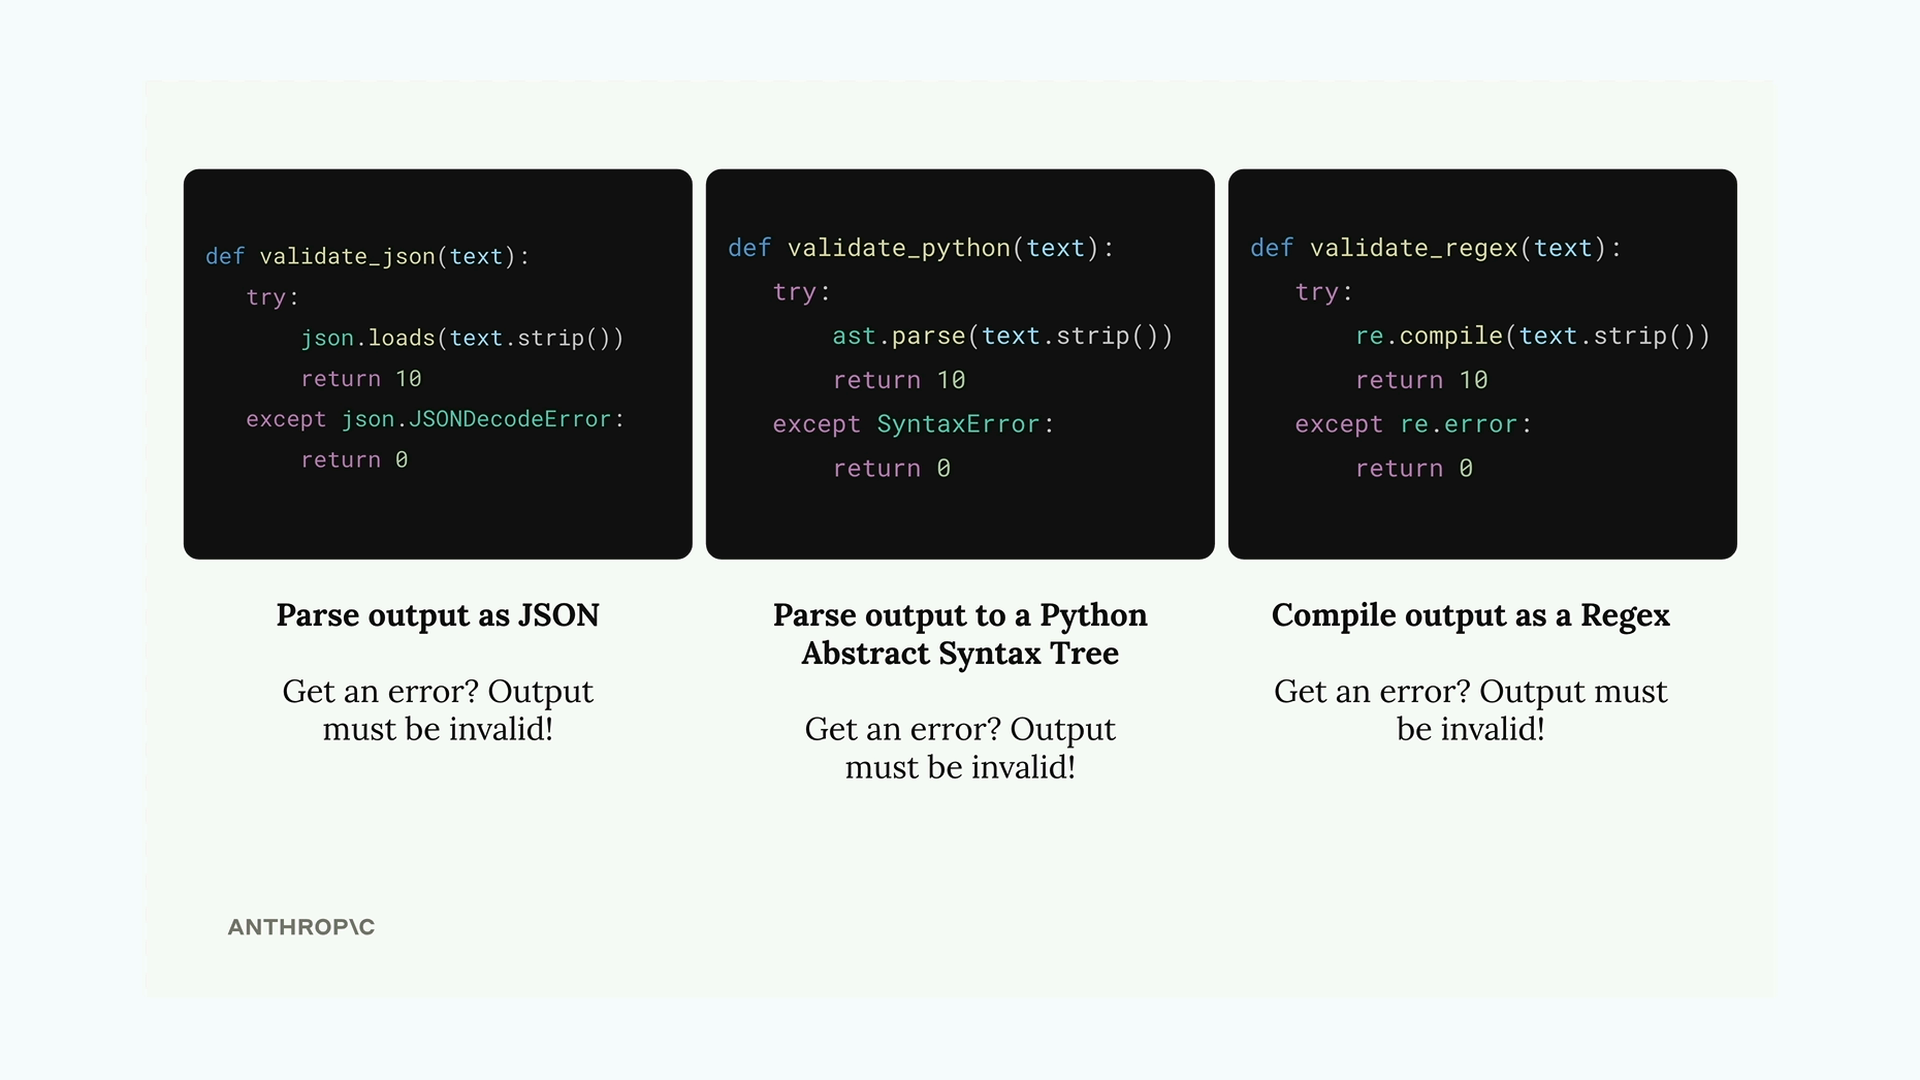
要檢查生成的程式碼是否具有有效語法,您可以建立三個嘗試解析輸出的輔助函式:
python
def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
每個函式都會嘗試將文字解析為其對應的格式。如果解析成功,則返回滿分 10 分。如果解析失敗並出現錯誤,則表示語法無效,返回 0 分。
資料集格式要求
為了讓程式碼評分器知道要使用哪個驗證器,您的測試案例需要指定預期的輸出格式:
json
{
    "task": "Create a Python function to validate an AWS IAM username",
    "format": "python"
}
您可以更新資料集生成提示,透過將此格式欄位加入範例輸出結構中,自動包含此欄位。
提升提示的清晰度
為了從您的 AI 模型獲得更好的結果,請讓您的提示指示更明確地說明預期的輸出格式:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanation您也可以使用帶有程式碼區塊的預填助手訊息,以鼓勵模型僅返回原始程式碼:
python
add_assistant_message(messages, "```code")這會告訴 Claude 開始生成程式碼內容,而不必事先指定它是 Python、JSON 還是 Regex。
合併分數
最後一步是將模型評分器的分數與程式碼評分器的分數合併。一個簡單的方法是取平均值:
python
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
這使內容品質和技術正確性獲得同等的權重。您可以根據您特定使用案例中哪個因素更重要來調整這些權重。
測試您的實作
一旦您實作了程式碼評分,請執行您的評估以取得基準分數。分數本身並非本質上好或壞——重要的是您是否能透過改進提示來提升它。這為您提供了一種量化的方式來衡量提示工程的進展,而不是依賴主觀評估。