Después de dividir un documento en fragmentos, el siguiente paso en un pipeline de RAG es encontrar qué fragmentos son más relevantes para la pregunta de un usuario. Esto es fundamentalmente un problema de búsqueda: necesitas revisar todos tus fragmentos de texto e identificar los que se relacionan con lo que el usuario está preguntando.
Encontrar fragmentos relevantes
El desafío es determinar qué fragmentos están "relacionados" con la pregunta de un usuario. Esto no es tan simple como la coincidencia de palabras clave: necesitas comprender el significado y el contexto tanto de la pregunta como de los fragmentos.
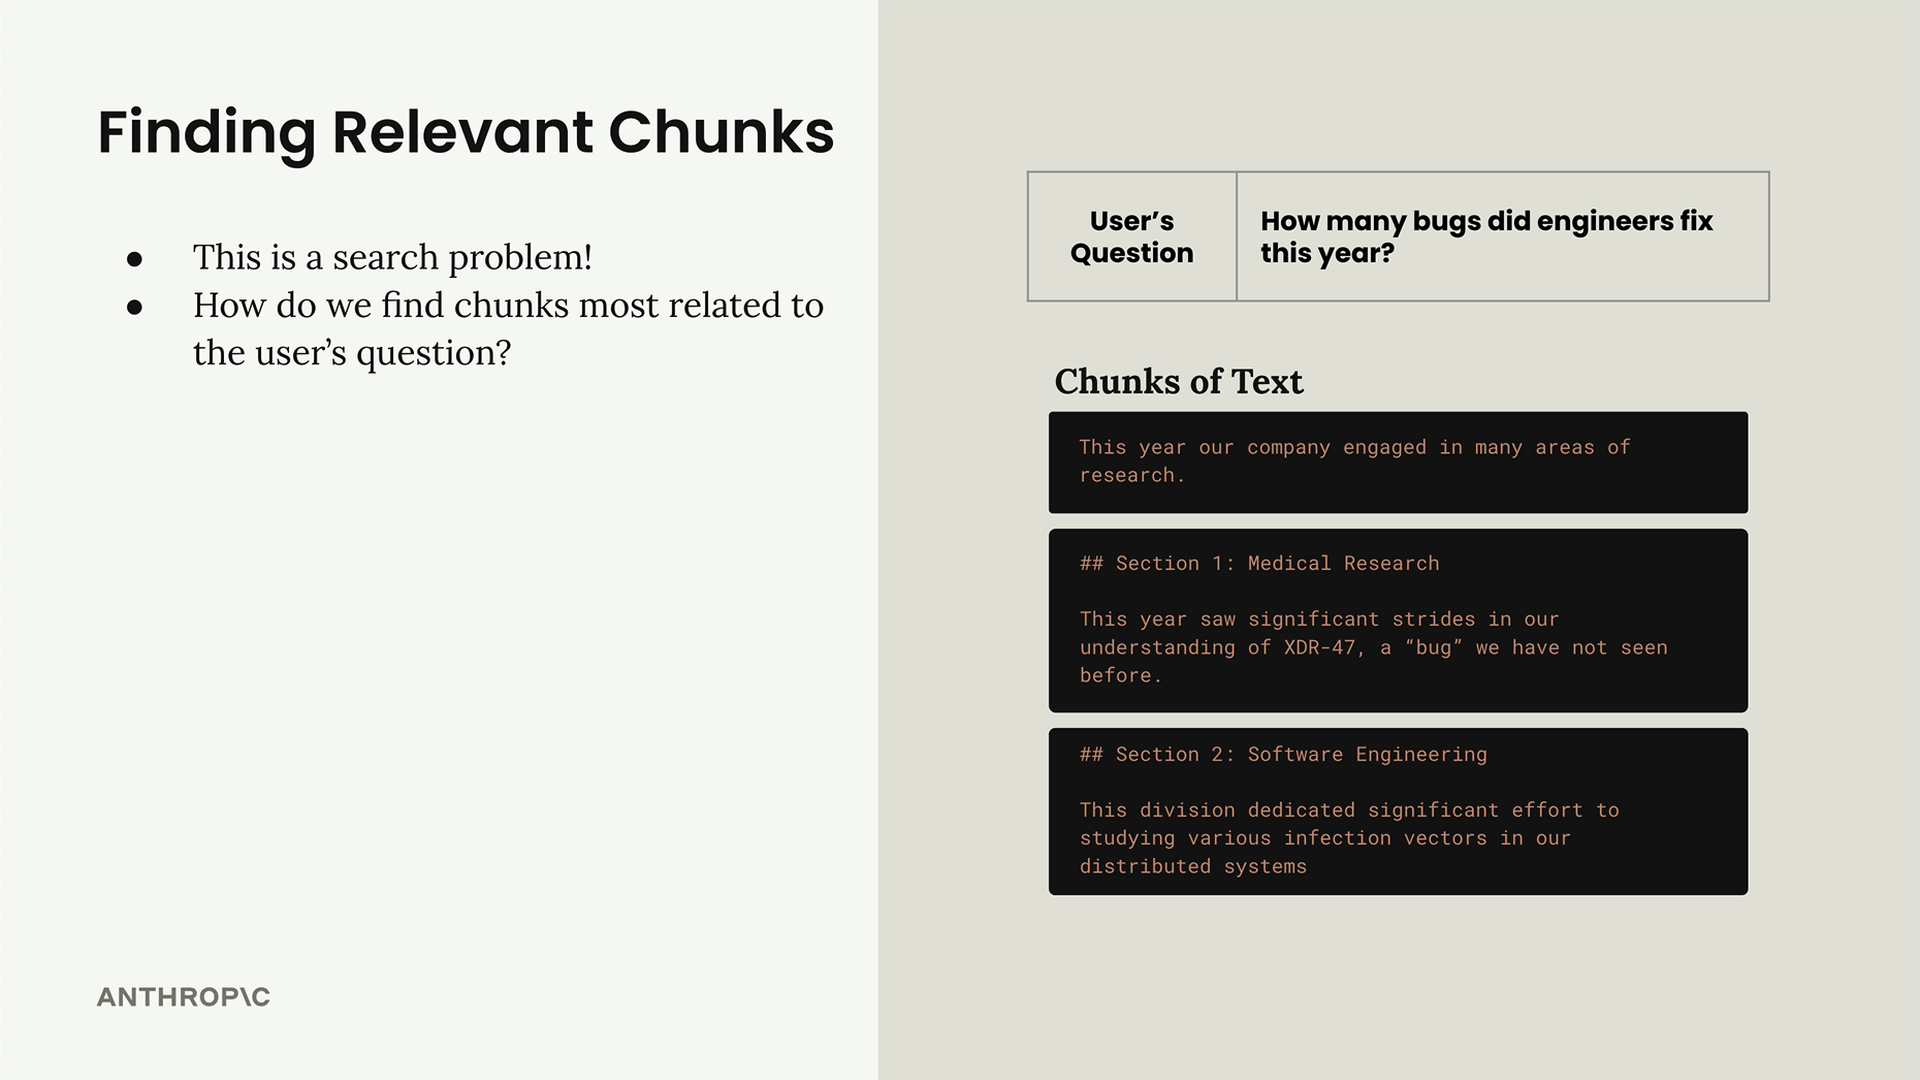
La solución más común es la búsqueda semántica, que utiliza embeddings de texto para entender de qué trata realmente cada fragmento de texto, en lugar de simplemente buscar coincidencias exactas de palabras.
¿Qué son los embeddings de texto?
Un embedding de texto es una representación numérica del significado contenido en un texto. Piénsalo como convertir palabras y oraciones en un formato con el que las computadoras pueden trabajar matemáticamente.
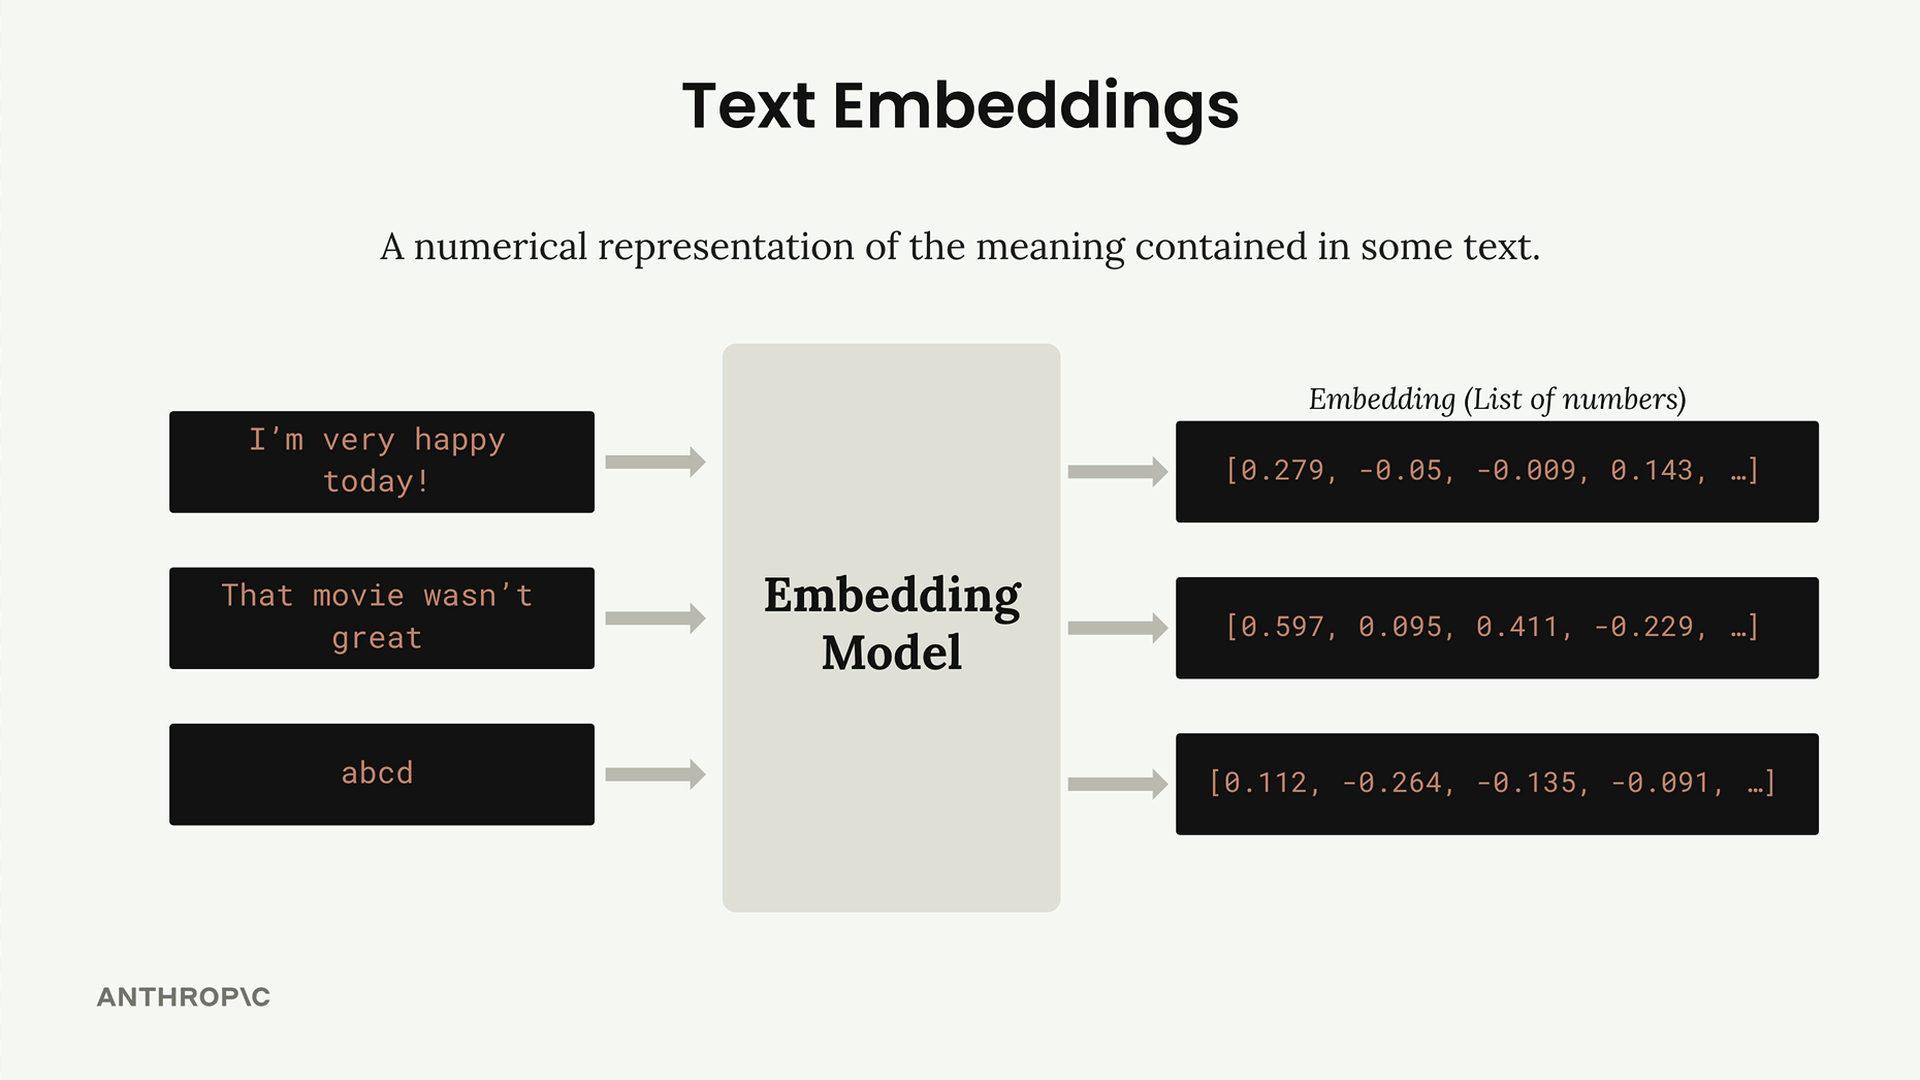
Así es como funciona:
- Alimentas texto a un modelo de embeddings
- El modelo genera una larga lista de números (típicamente 1024 números)
- Cada número representa una "puntuación" para alguna cualidad del texto de entrada
- Los números van de -1 a +1
Entendiendo los números
Cada número en un embedding es como una puntuación para algún aspecto del texto. Aunque no sabemos exactamente qué representa cada posición, es útil pensar en ellos como medidas de diferentes cualidades.
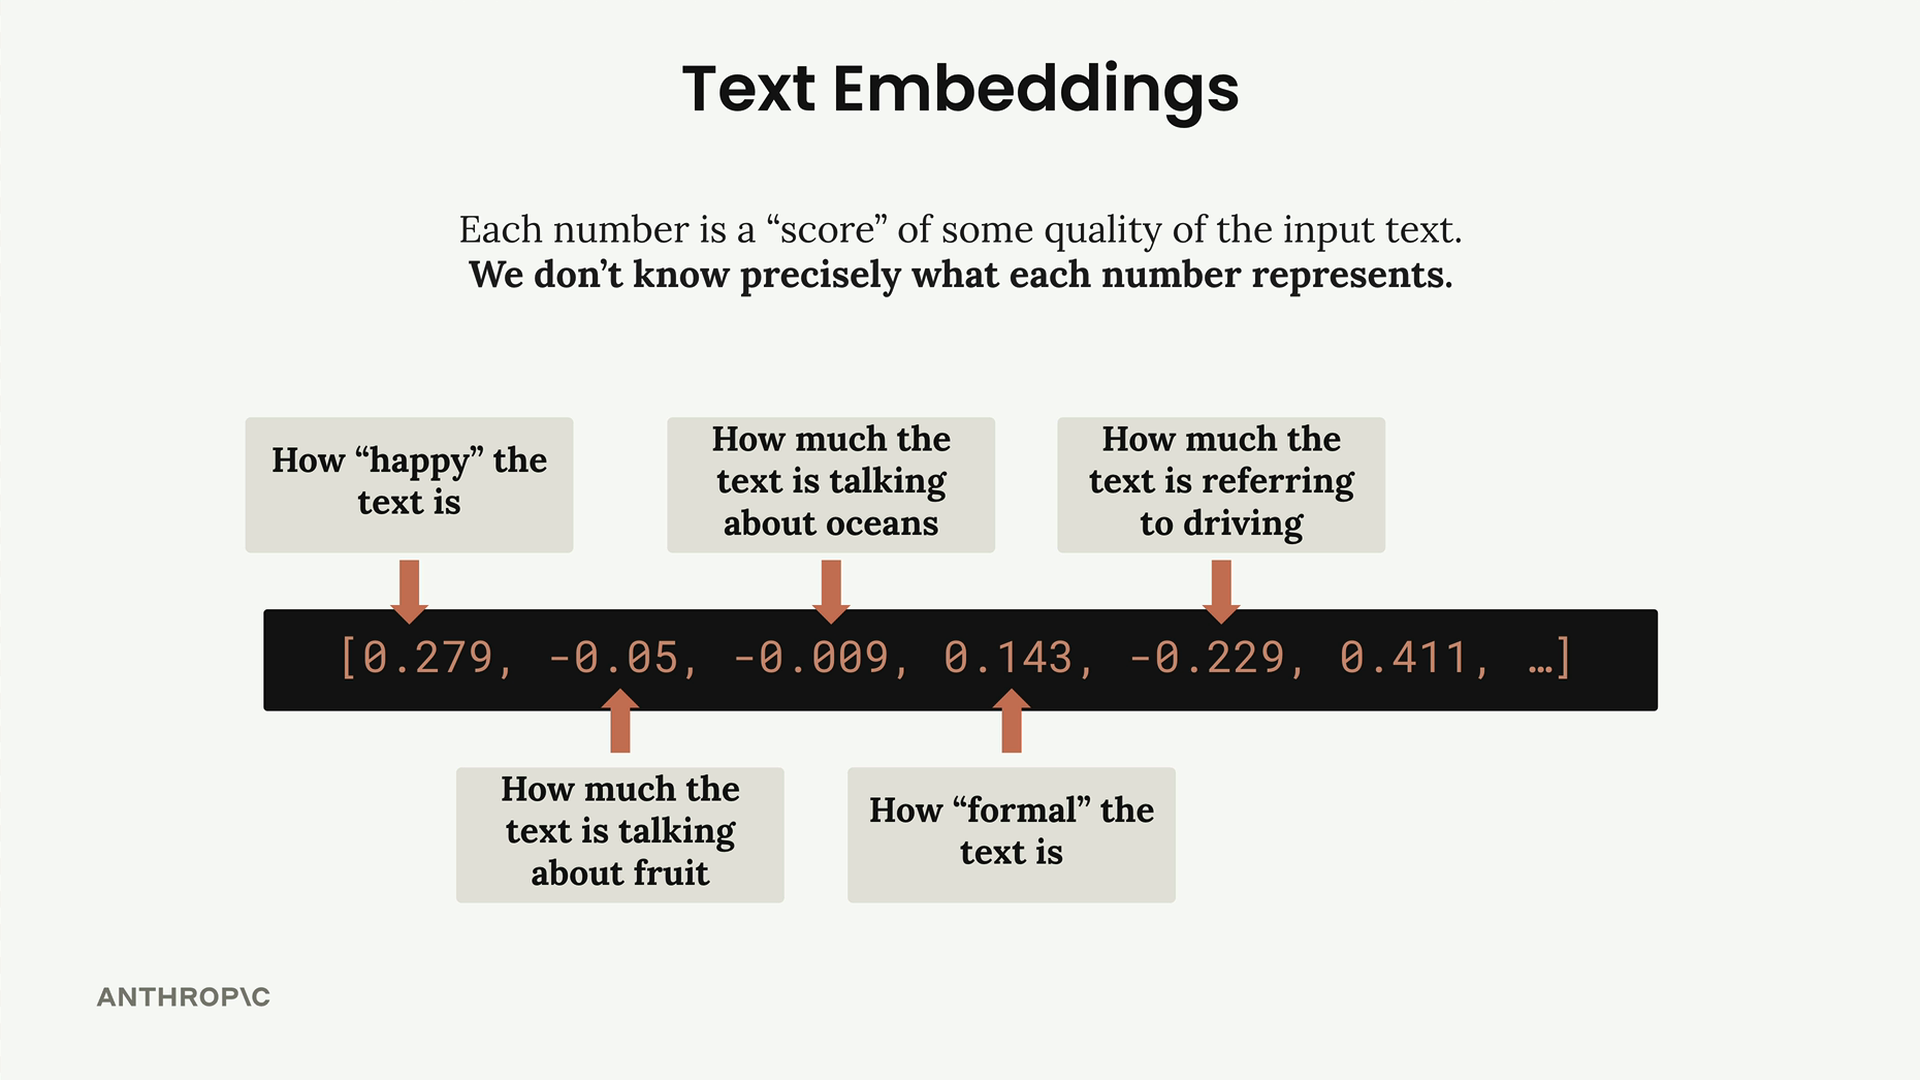
Por ejemplo, un número podría puntuar "qué tan feliz es el texto" mientras que otro podría medir "cuánto habla el texto sobre océanos". El punto clave es que en realidad no sabemos qué representa cada número: el modelo de embeddings aprende estos patrones durante el entrenamiento, y no son interpretables por humanos.
Generando embeddings con código
Crear embeddings es sencillo. Aquí está el proceso básico:
def generate_embedding(
    text,
    embedding_model_id="amazon.titan-embed-text-v2:0",
    dimensions=1024,
    normalize=True,
):
    request_body = {
        "inputText": text,
        "dimensions": dimensions,
        "normalize": normalize,
    }

    request_json = json.dumps(request_body)
    response = client.invoke_model(
        modelId=embedding_model_id,
        body=request_json,
        accept="application/json",
        contentType="application/json",
    )

    response_body = json.loads(response.get("body").read())
    return response_body["embedding"]
Cuando ejecutas esta función en un fragmento de texto, obtienes una lista de 1024 números que representan el significado semántico de ese texto.
Ten en cuenta que es posible que necesites solicitar acceso al modelo de embeddings Titan en la consola de AWS Bedrock. Si la versión 2 no está disponible, la versión 1 funciona igual de bien para fines de aprendizaje.
Por qué los embeddings son importantes para RAG
El poder de los embeddings se vuelve claro cuando te das cuenta de que los textos similares tendrán valores de embedding similares. Esto significa que puedes comparar matemáticamente la pregunta de un usuario con los fragmentos de tu documento y encontrar los más semánticamente similares, incluso si no comparten exactamente las mismas palabras.
Esta representación numérica es lo que hace posible la búsqueda semántica y mucho más efectiva que la simple coincidencia de palabras clave para encontrar contexto relevante en sistemas RAG.