La fragmentación de texto (text chunking) es uno de los pasos más críticos al construir un pipeline de RAG (Retrieval Augmented Generation). La forma en que divides tus documentos impacta directamente la calidad de todo tu sistema. Una estrategia de fragmentación deficiente puede llevar a que se inserte contexto irrelevante en tus prompts, causando que tu IA dé respuestas completamente incorrectas.
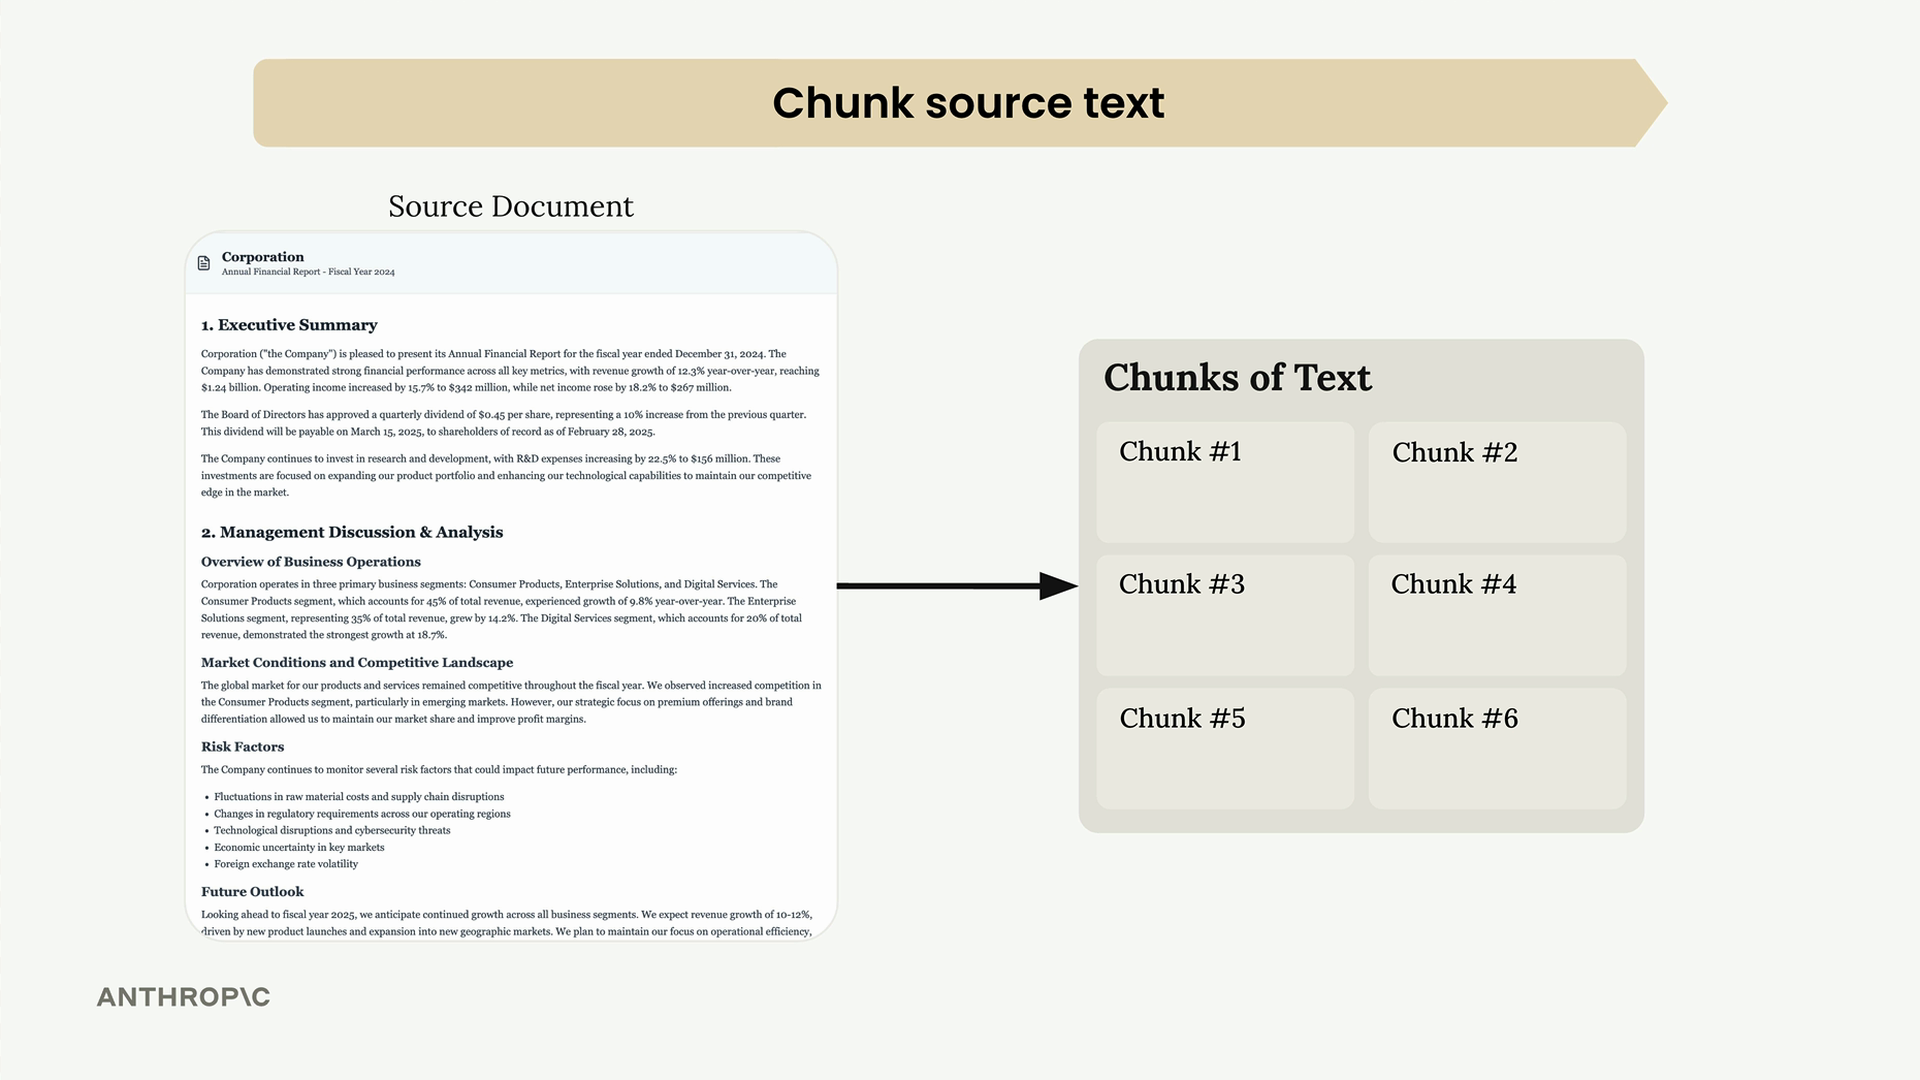
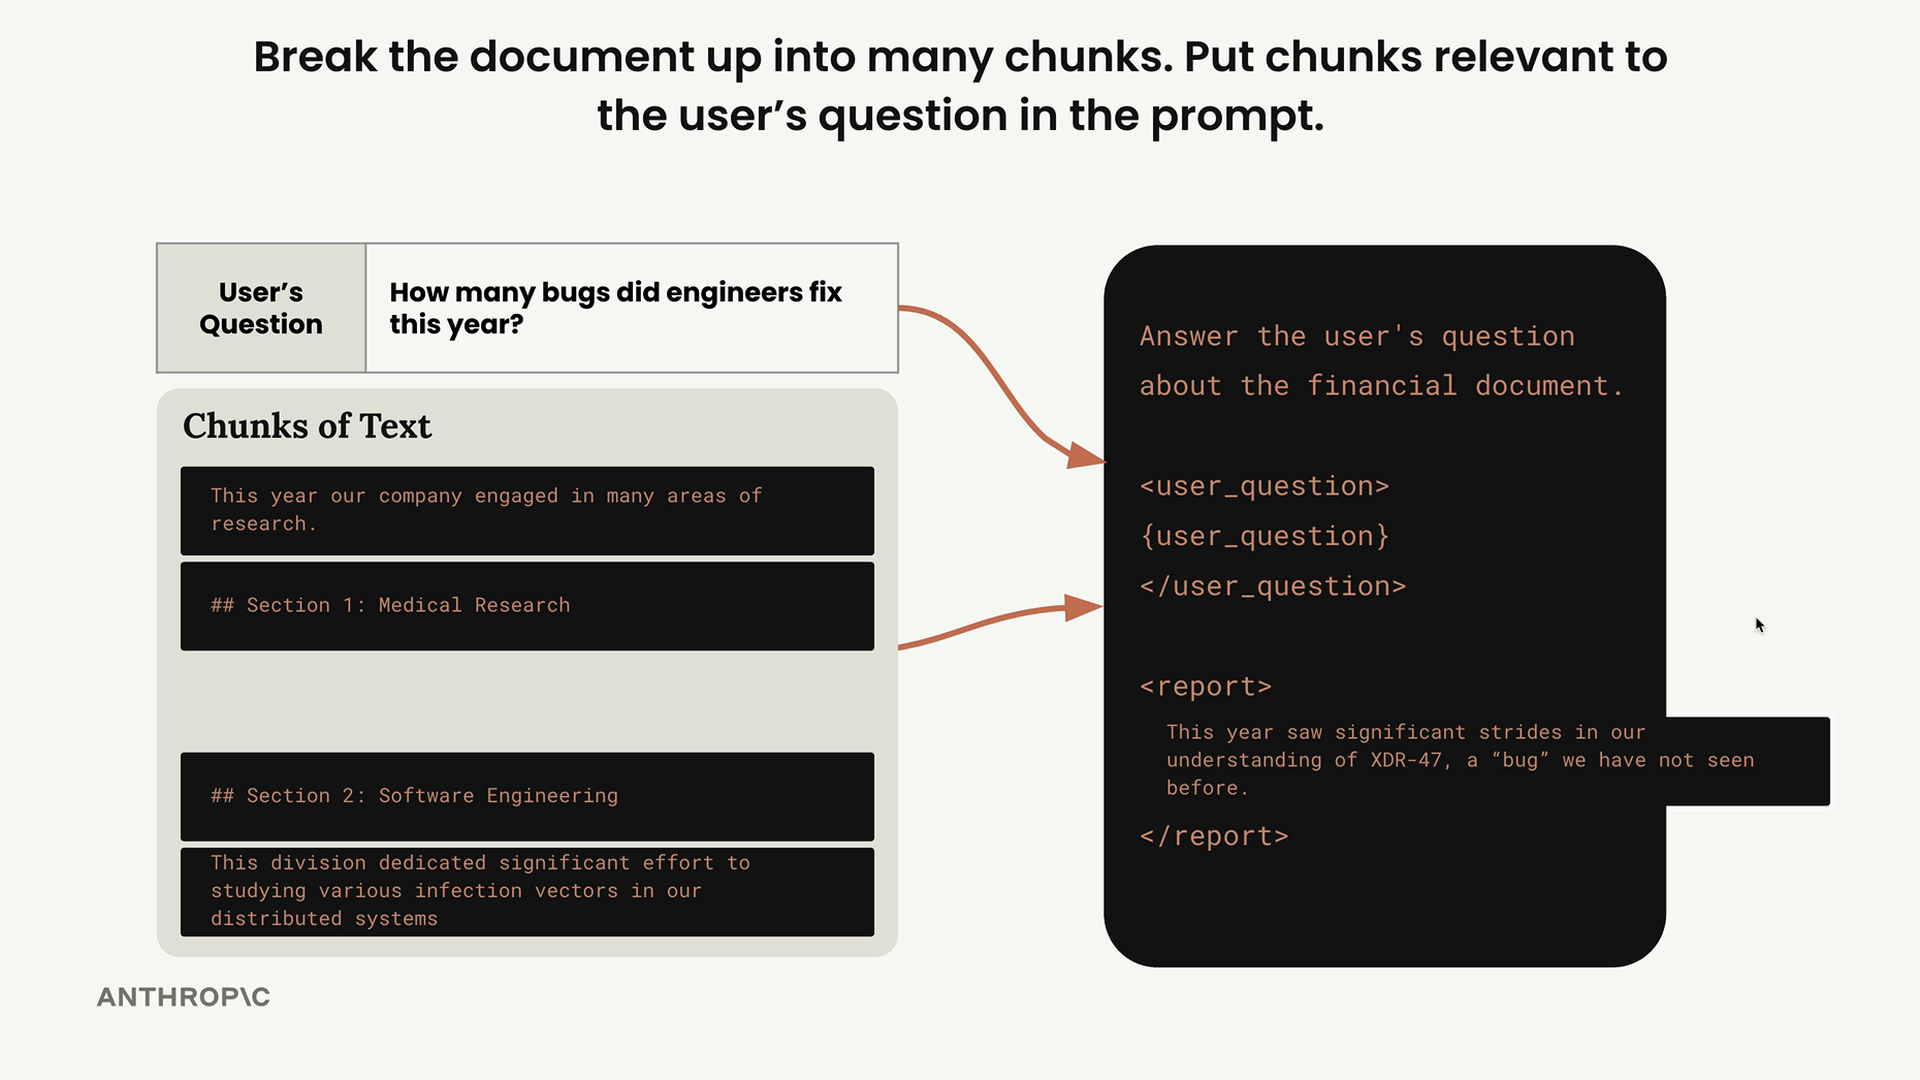
Considera este ejemplo: tienes un documento con secciones sobre investigación médica e ingeniería de software. Si fragmentas mal, un usuario que pregunte "¿Cuántos bugs corrigieron los ingenieros este año?" podría obtener información sobre investigación médica en lugar de ingeniería de software, simplemente porque la sección médica contenía la palabra "bug" en un contexto diferente.
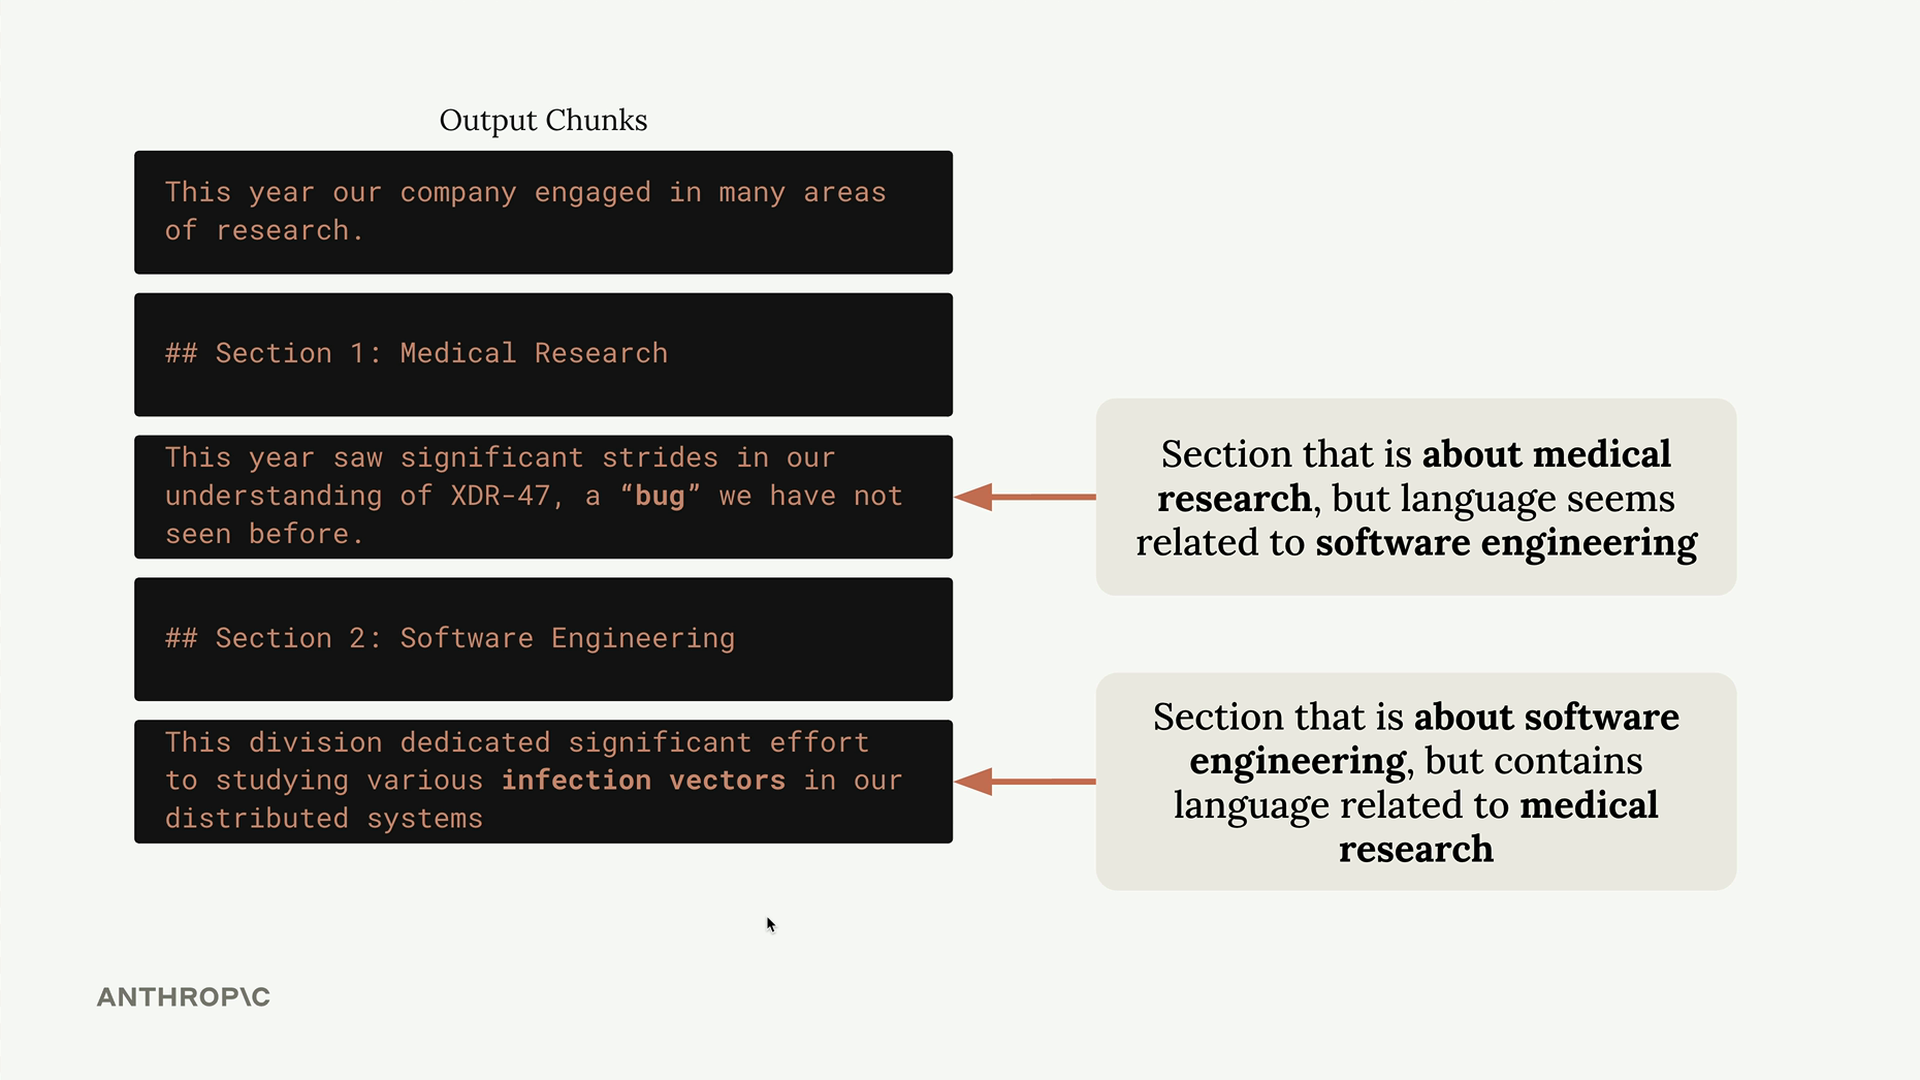
Esto demuestra por qué la estrategia de fragmentación importa tanto. El objetivo es crear fragmentos que mantengan coherencia semántica y proporcionen contexto útil cuando se recuperen.
Tres estrategias principales de fragmentación
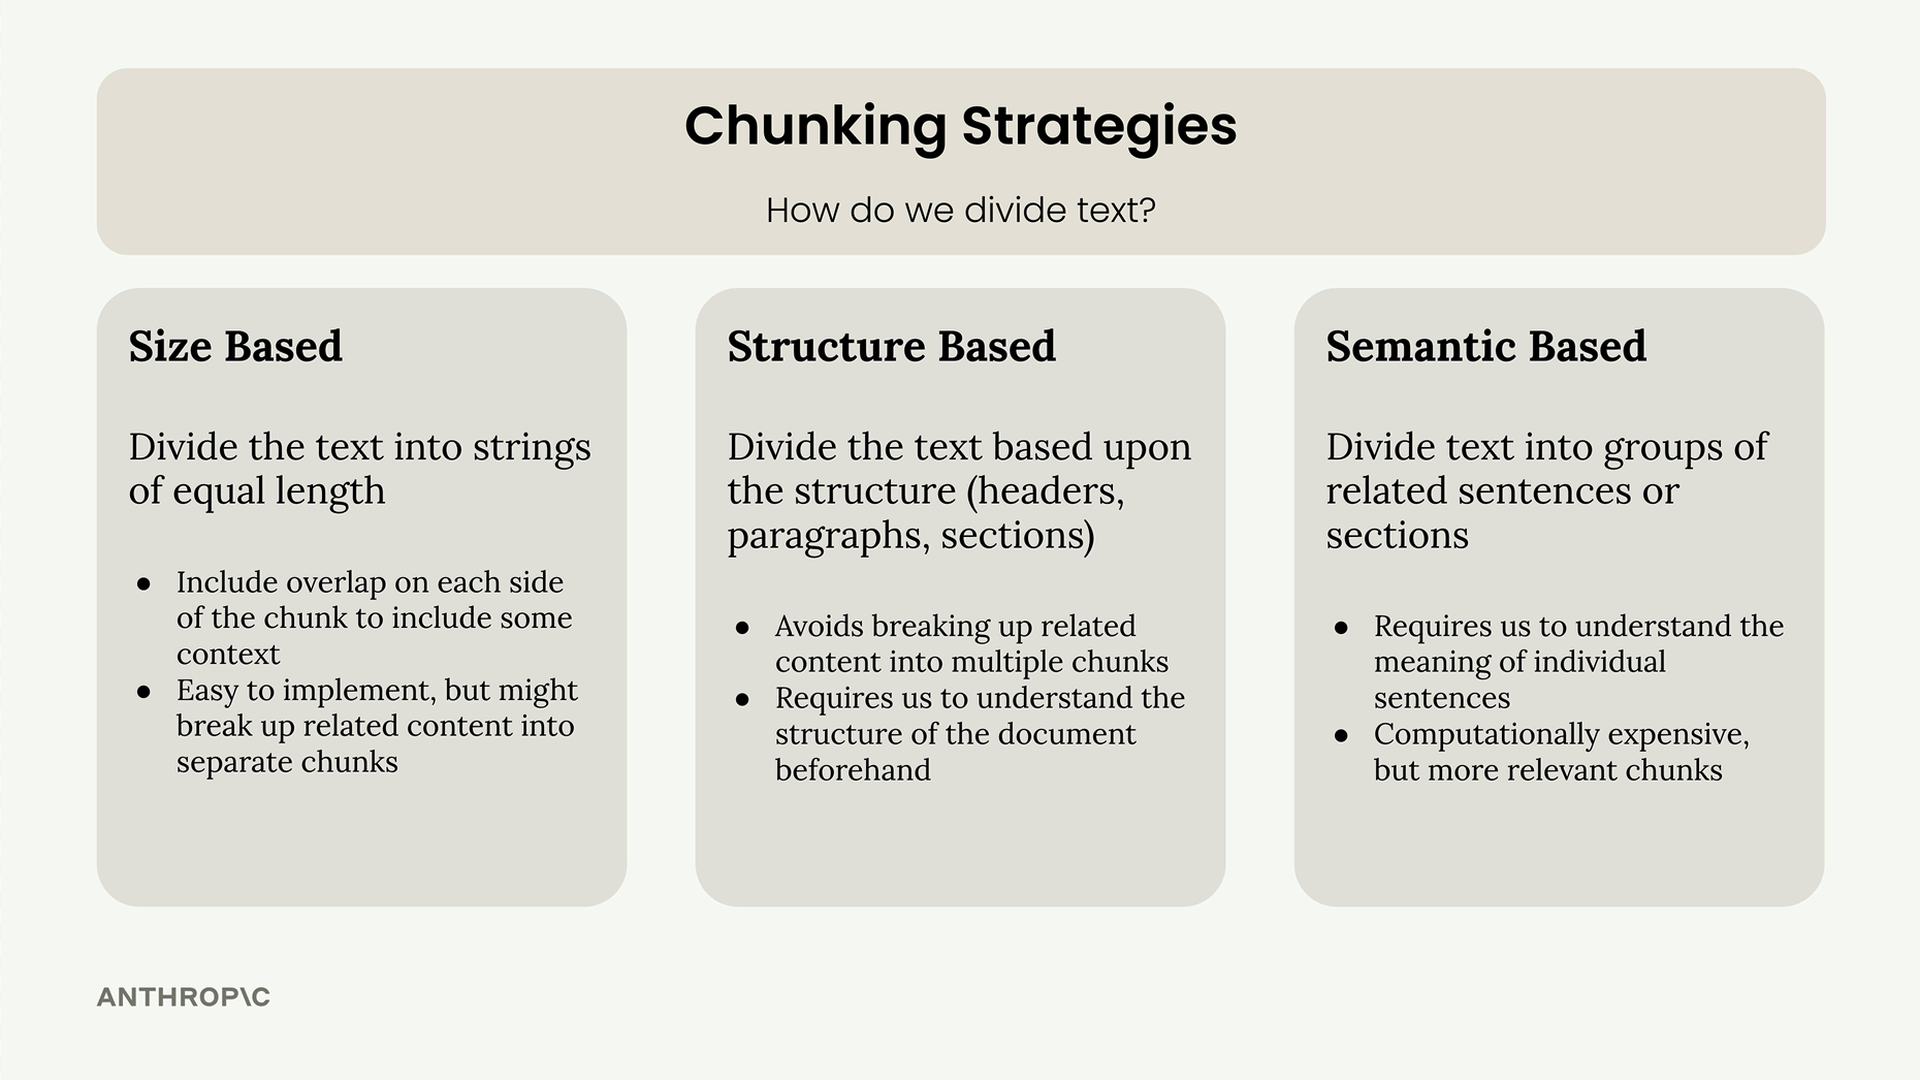
Existen tres enfoques principales para dividir texto en fragmentos:
- Basado en tamaño: Divide el texto en cadenas de longitud igual
- Basado en estructura: Divide según la estructura del documento (encabezados, párrafos, secciones)
- Basado en semántica: Agrupa oraciones o secciones relacionadas usando técnicas de NLP
Fragmentación basada en tamaño
La fragmentación basada en tamaño es el enfoque más sencillo. Simplemente divides tu documento en fragmentos de una cantidad de caracteres o palabras aproximadamente igual. Es fácil de implementar y funciona de manera confiable en diferentes tipos de documentos.
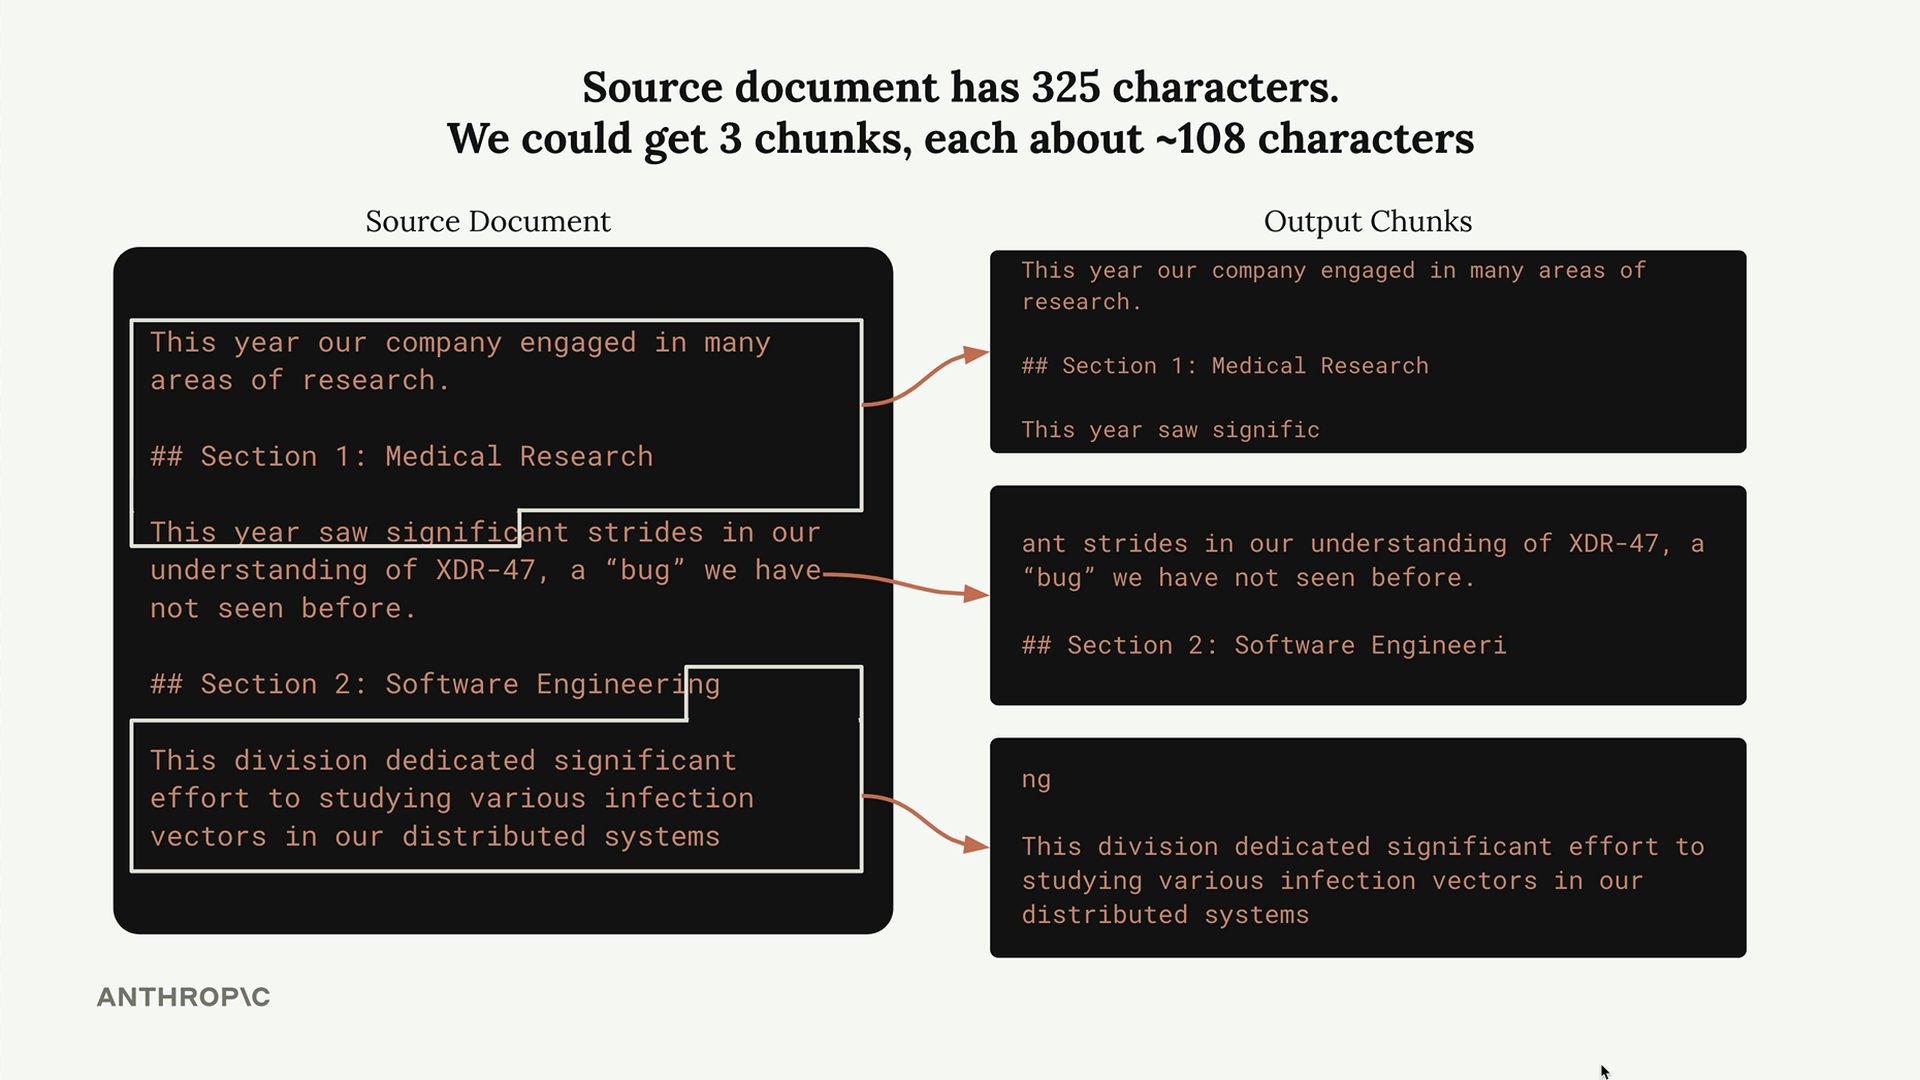
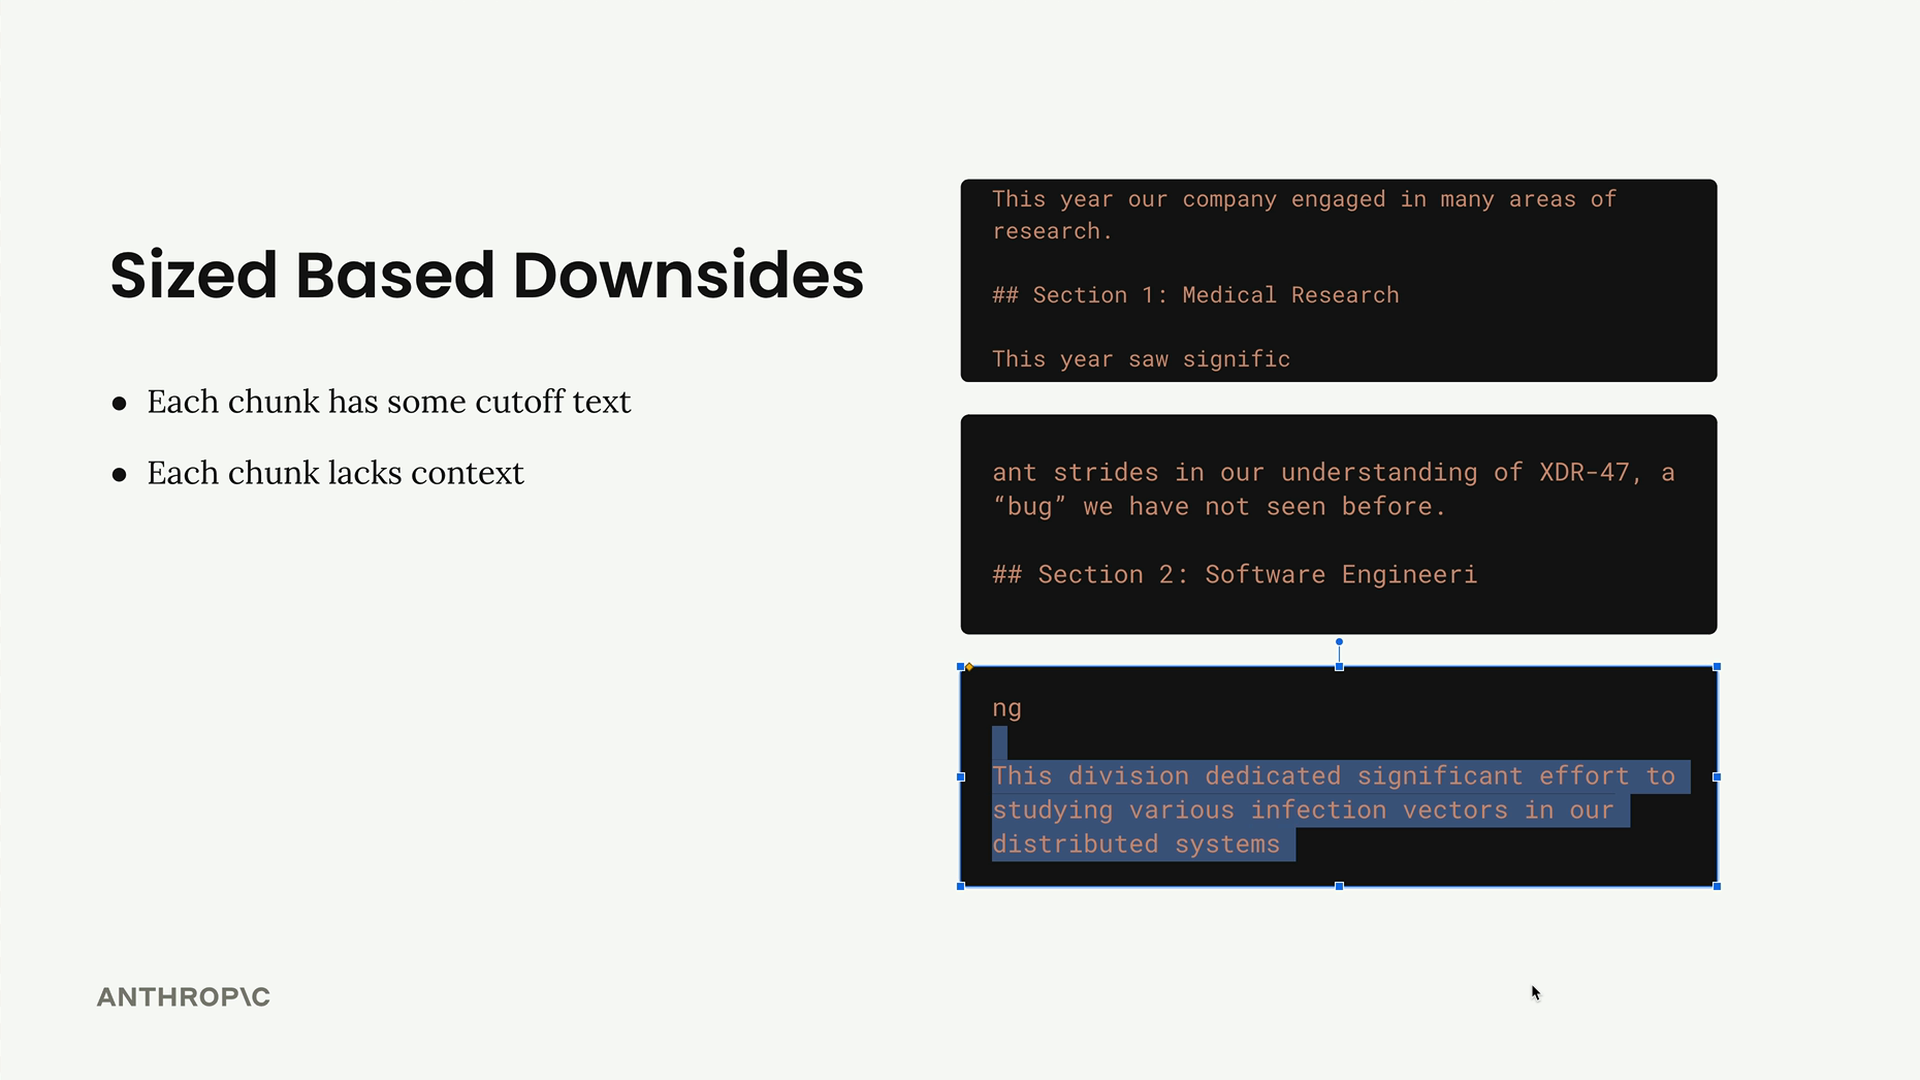
Sin embargo, este enfoque tiene desventajas claras:
- Las palabras se cortan a mitad de oración
- Los fragmentos pierden contexto importante del texto circundante
- El contenido relacionado puede dividirse entre múltiples fragmentos
Agregando superposición
Para abordar el problema del contexto, puedes implementar una estrategia de superposición (overlap). Cada fragmento incluye algunos caracteres de los fragmentos vecinos, proporcionando contexto adicional y asegurando que no se pierda información importante en los límites de los fragmentos.
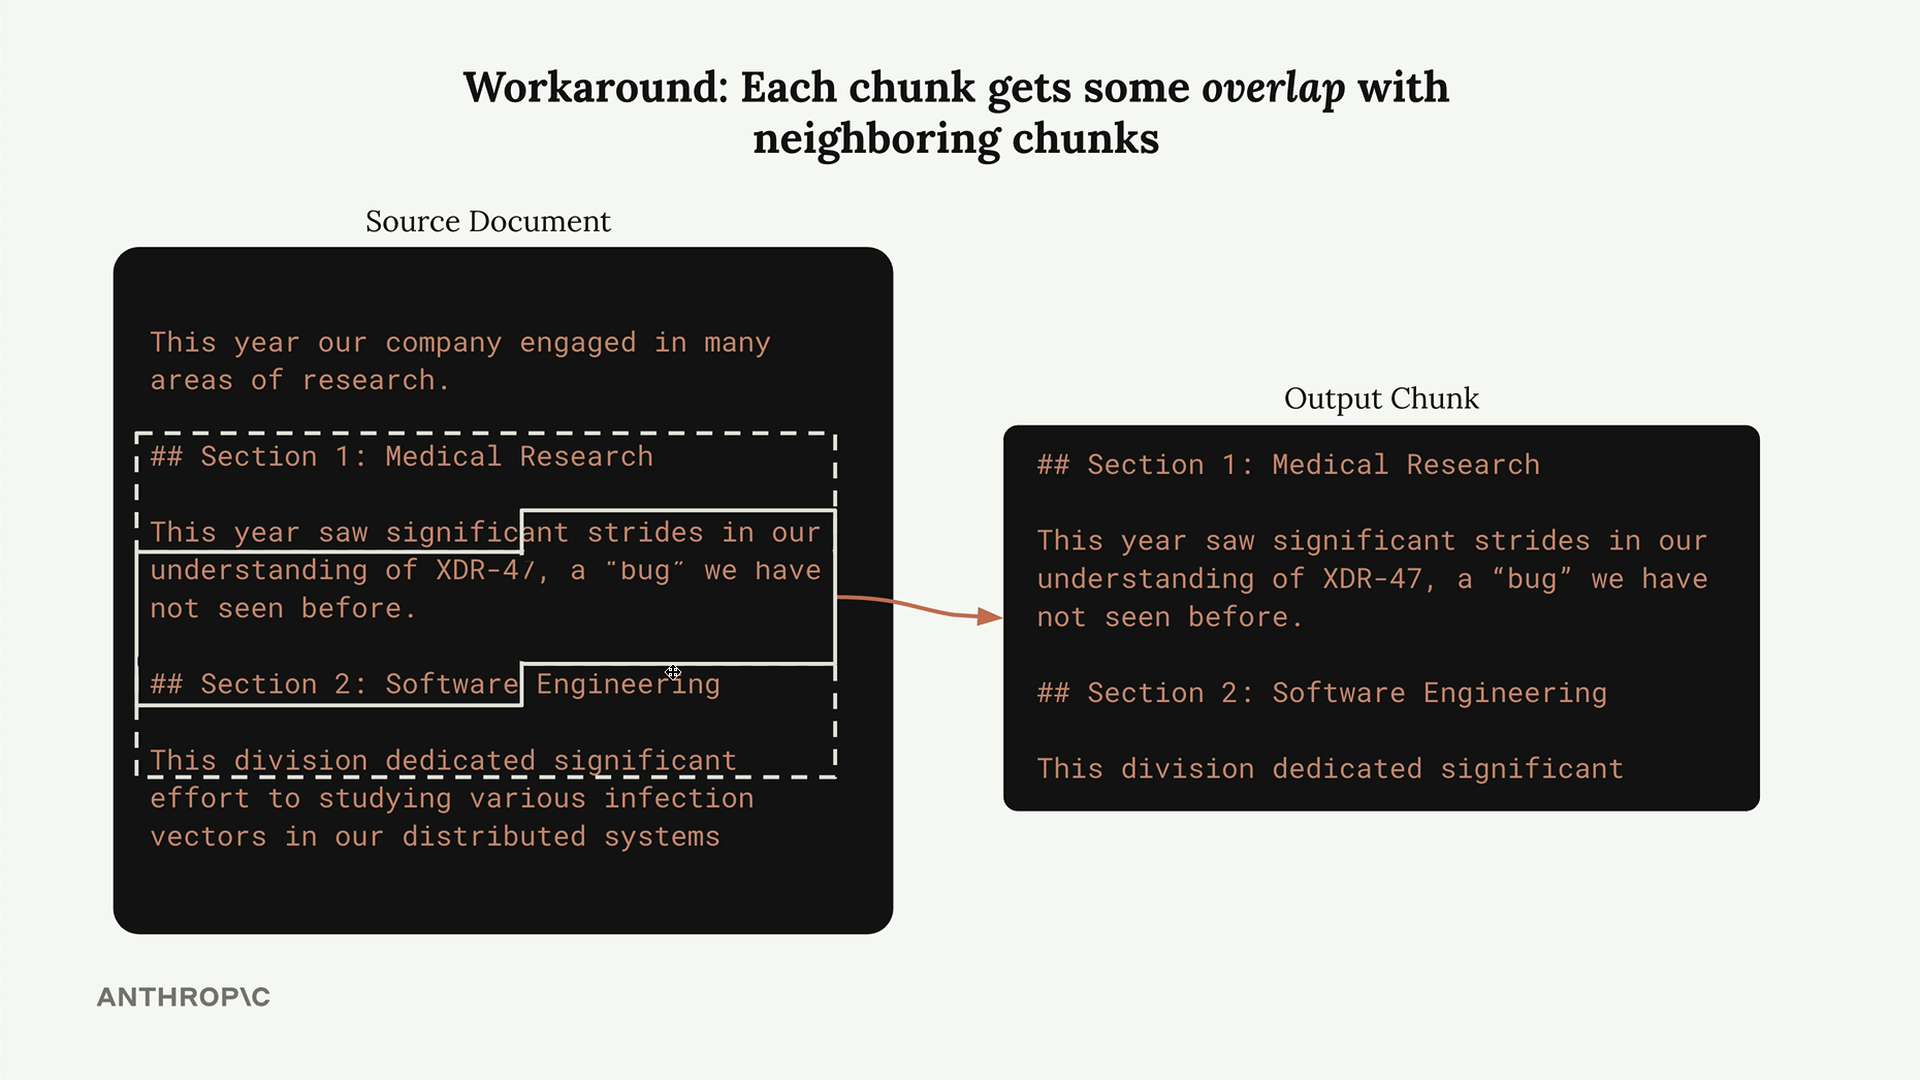
Aunque esto crea cierta duplicación, la compensación generalmente vale la pena por el contexto mejorado que recibe cada fragmento.
Fragmentación basada en estructura
Cuando tus documentos tienen un formato consistente (como markdown con encabezados claros), la fragmentación basada en estructura puede producir excelentes resultados. Divides según elementos estructurales como encabezados, creando fragmentos que se alinean con la organización natural del documento.
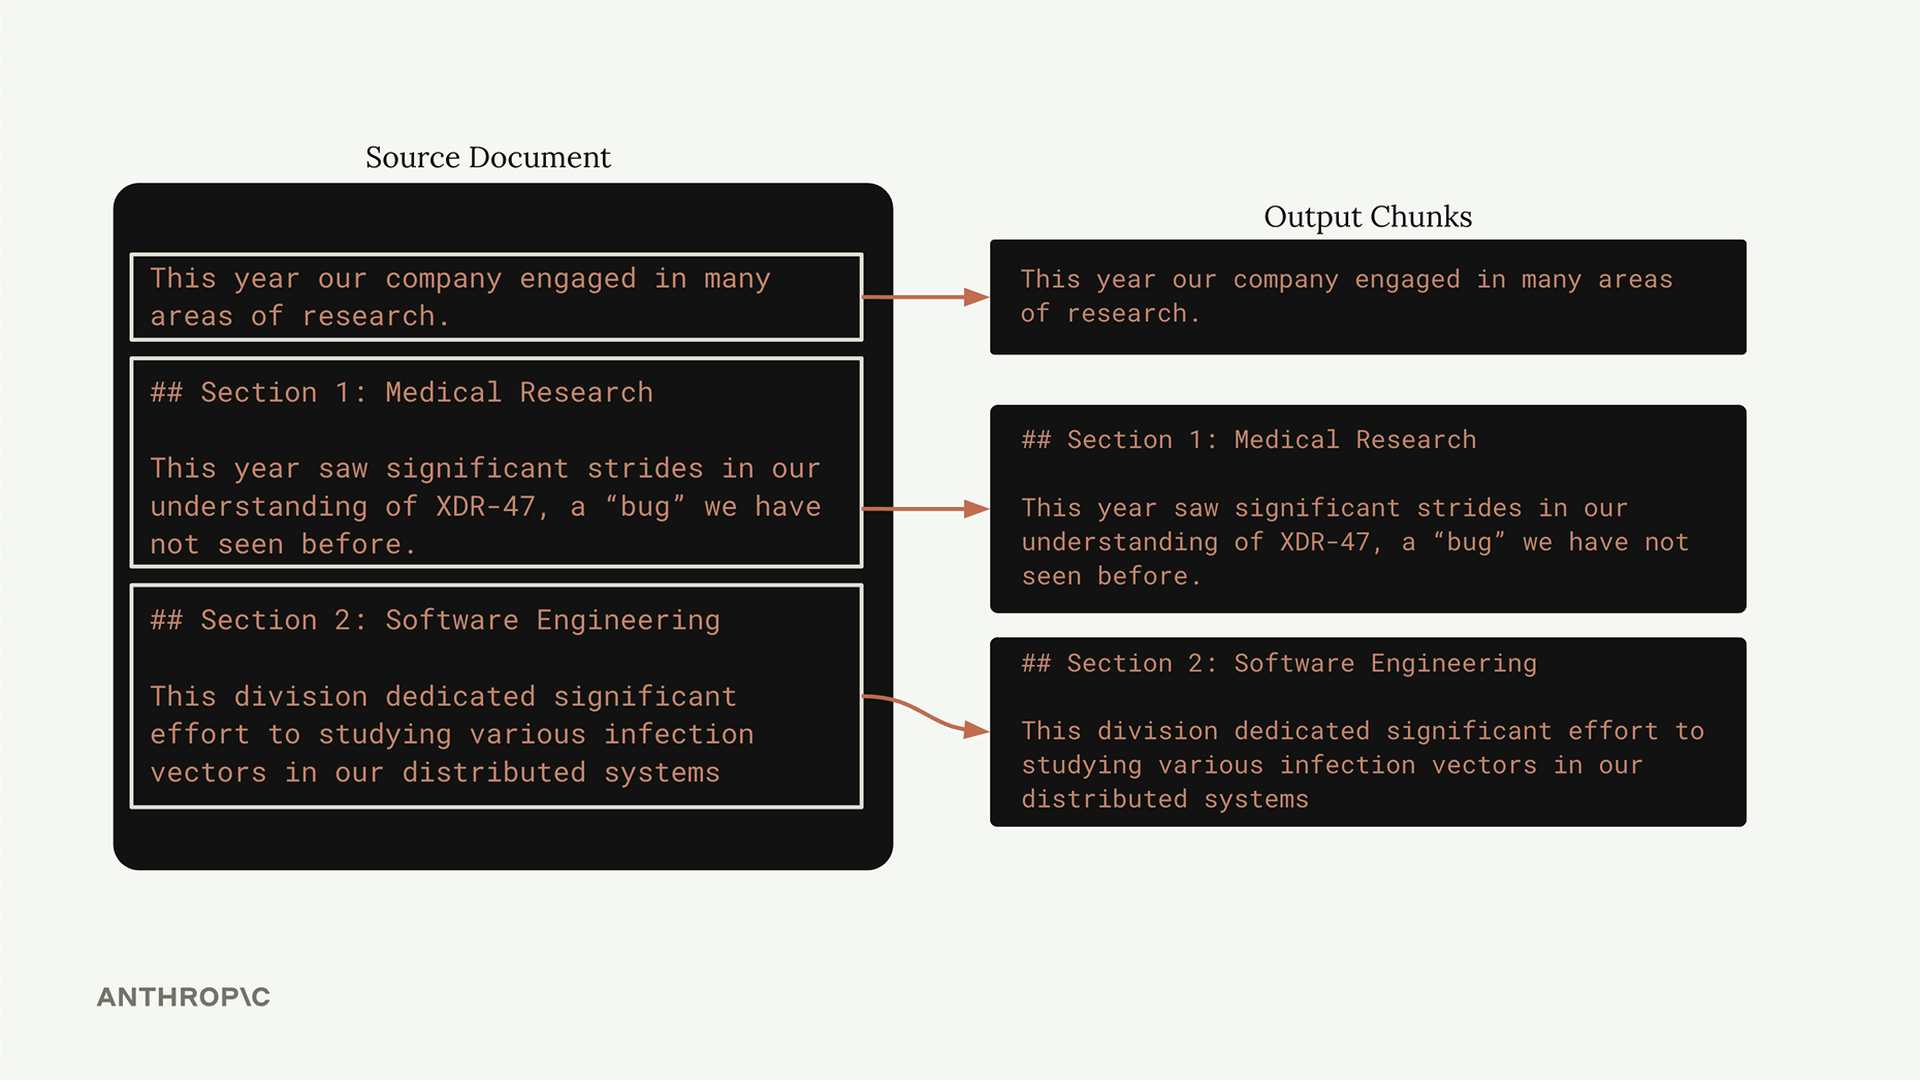
Esto funciona maravillosamente para documentos bien formateados, pero requiere garantías sobre la estructura del documento. No funcionará de manera confiable con archivos de texto plano o documentos formateados de manera inconsistente.
Ejemplos de implementación
Aquí hay tres funciones prácticas de fragmentación que puedes implementar:
Fragmentación basada en caracteres
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
Fragmentación basada en oraciones
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
Fragmentación basada en secciones
def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
Elegir la estrategia correcta
Tu elección de estrategia de fragmentación depende completamente de tu caso de uso específico:
- Basada en caracteres: La alternativa más confiable, funciona con cualquier tipo de documento
- Basada en oraciones: Buen equilibrio de contexto y significado para prosa
- Basada en secciones: Excelentes resultados cuando tienes documentos estructurados
Para documentos subidos por usuarios sin garantías de formato, la fragmentación basada en caracteres suele ser tu opción más segura. Para documentos internos bien estructurados, la fragmentación basada en secciones puede proporcionar resultados superiores. La fragmentación basada en oraciones funciona bien para la mayoría de la prosa, pero puede tener dificultades con código o documentos técnicos que usan puntos de manera inesperada.
Recuerda que la fragmentación suele ser un proceso iterativo. Comienza con un enfoque simple, pruébalo con tus documentos y casos de uso específicos, y luego refínalo según la calidad de los resultados que estés obteniendo de tu sistema RAG.