Al construir un pipeline de RAG, rápidamente descubrirás que la búsqueda semántica por sí sola no siempre devuelve los mejores resultados. A veces necesitas coincidencias exactas de palabras clave que la búsqueda semántica podría pasar por alto. La solución es combinar la búsqueda semántica con la búsqueda léxica usando una técnica llamada BM25.
El problema con la búsqueda semántica por sí sola
Supongamos que estás buscando un ID de incidente específico como "INC-2023-Q4-011" en un documento. Aunque este término exacto aparece varias veces en secciones relevantes, la búsqueda semántica podría devolver secciones no relacionadas que parecen semánticamente similares pero que en realidad no contienen la información específica que necesitas.
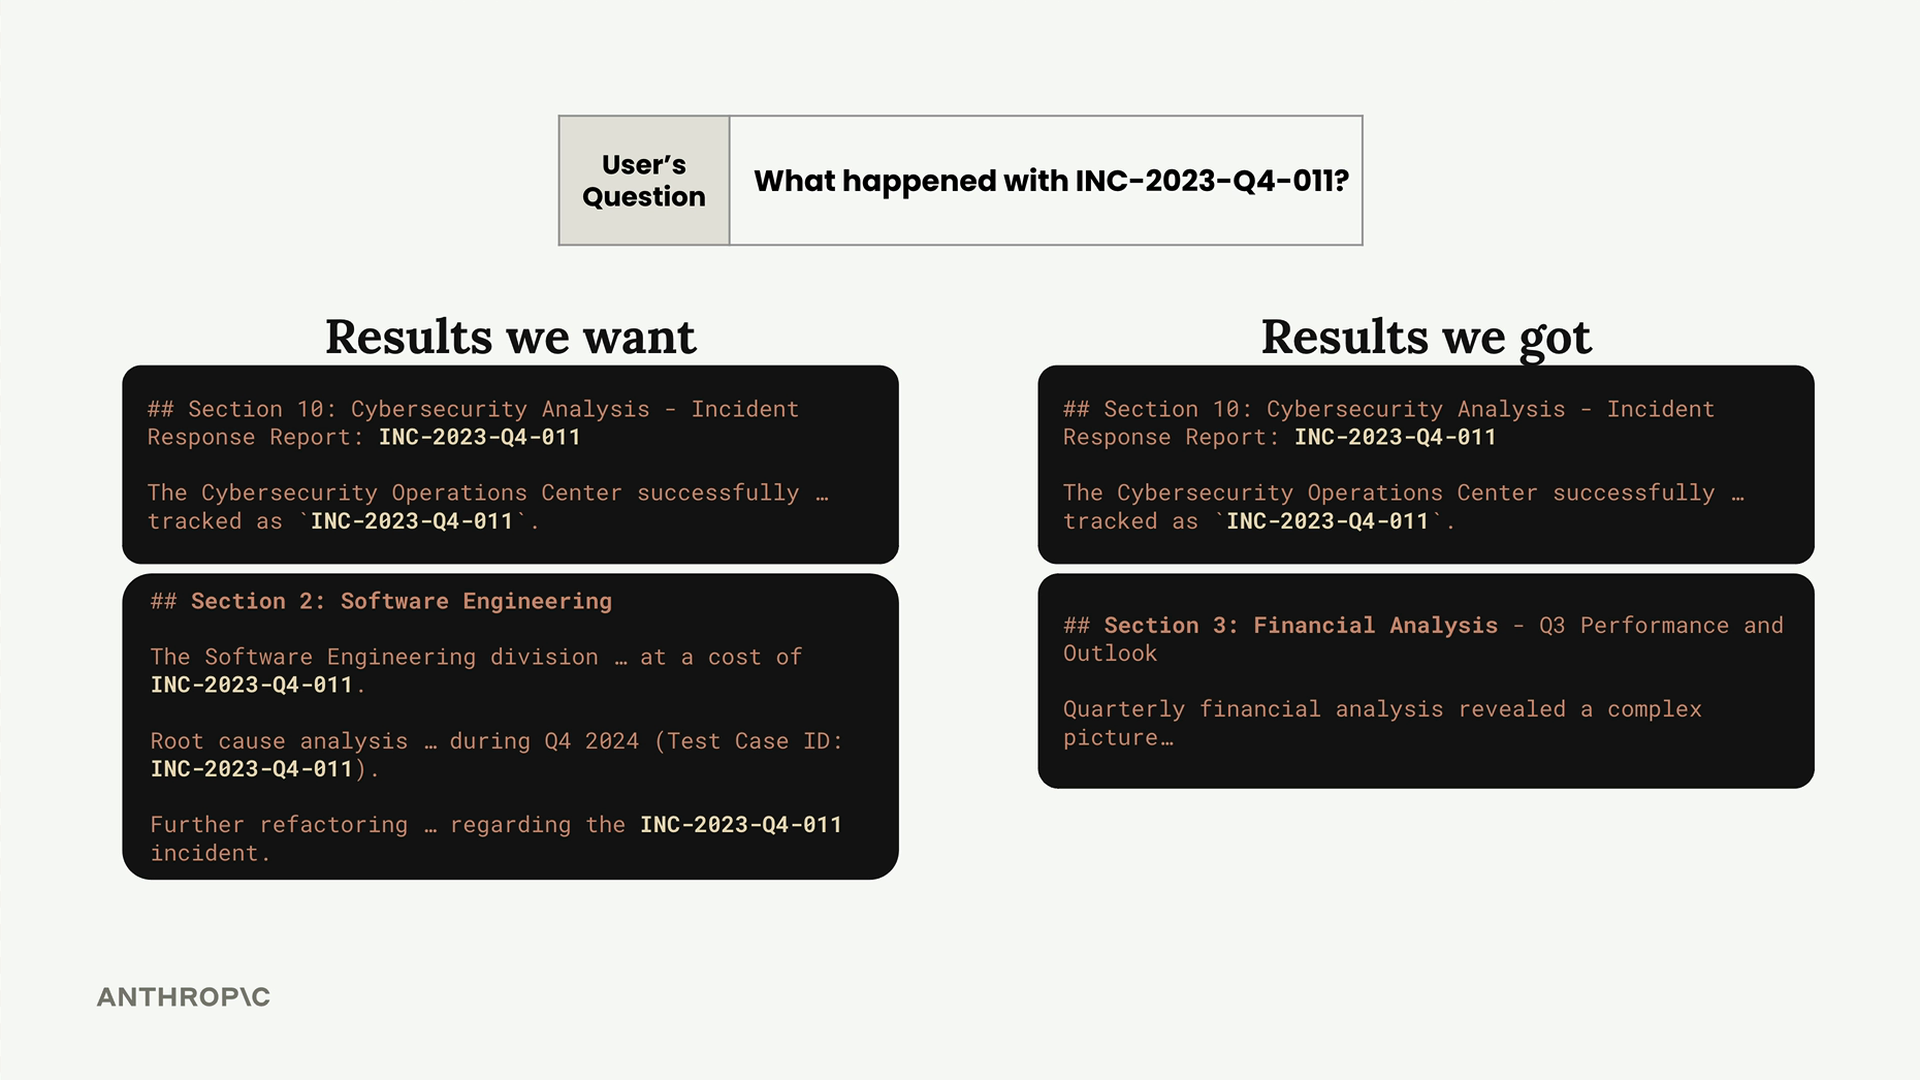
Esto sucede porque la búsqueda semántica se enfoca en el significado en lugar de las coincidencias exactas de texto. Cuando necesitas una coincidencia precisa de palabras clave, necesitas un enfoque diferente.
Estrategia de búsqueda híbrida
La solución es ejecutar tanto búsquedas semánticas como léxicas en paralelo, y luego combinar los resultados. Esto te da lo mejor de ambos mundos:
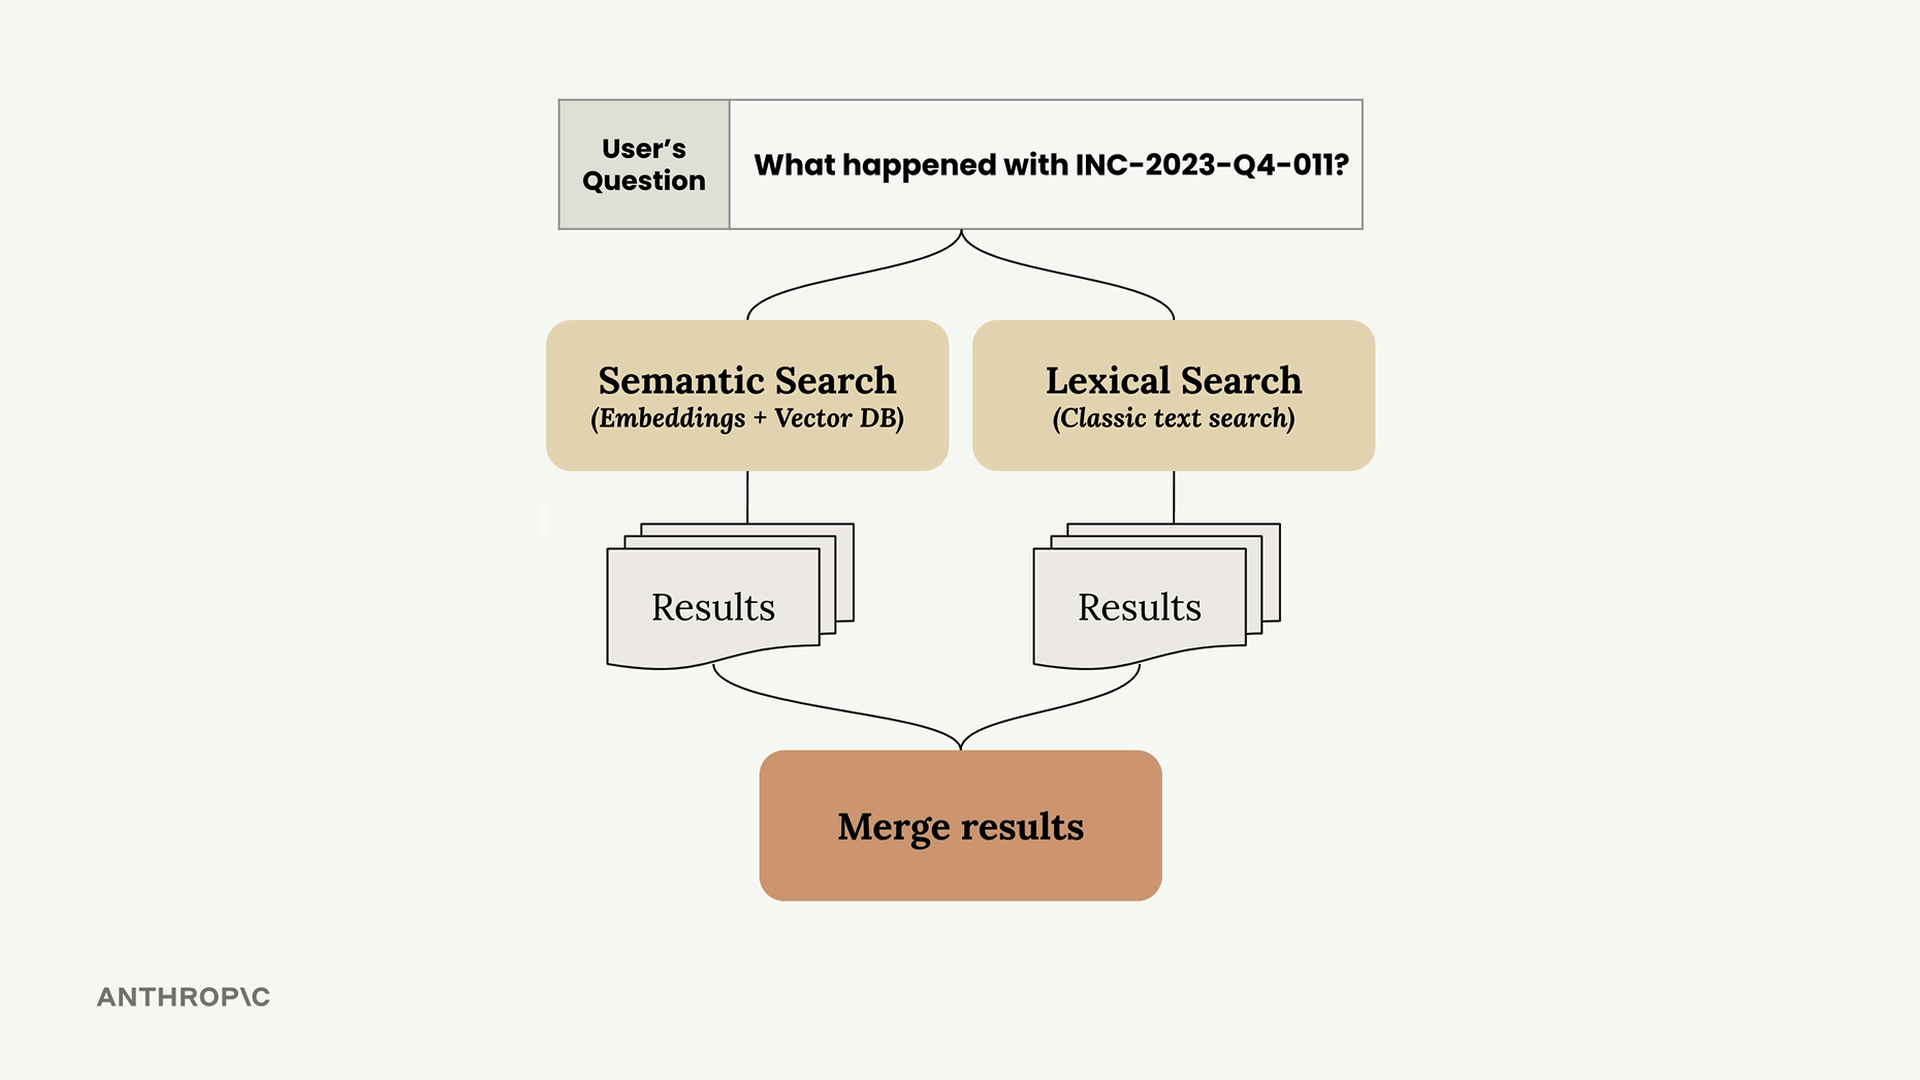
- Búsqueda semántica - Encuentra contenido conceptualmente relacionado usando embeddings
- Búsqueda léxica - Encuentra coincidencias exactas de palabras clave usando búsqueda de texto clásica
- Resultados combinados - Combina ambos enfoques para una mejor relevancia general
Cómo funciona BM25
BM25 (Best Match 25) es un algoritmo popular para la búsqueda léxica en pipelines de RAG. Así es como procesa una consulta de búsqueda:
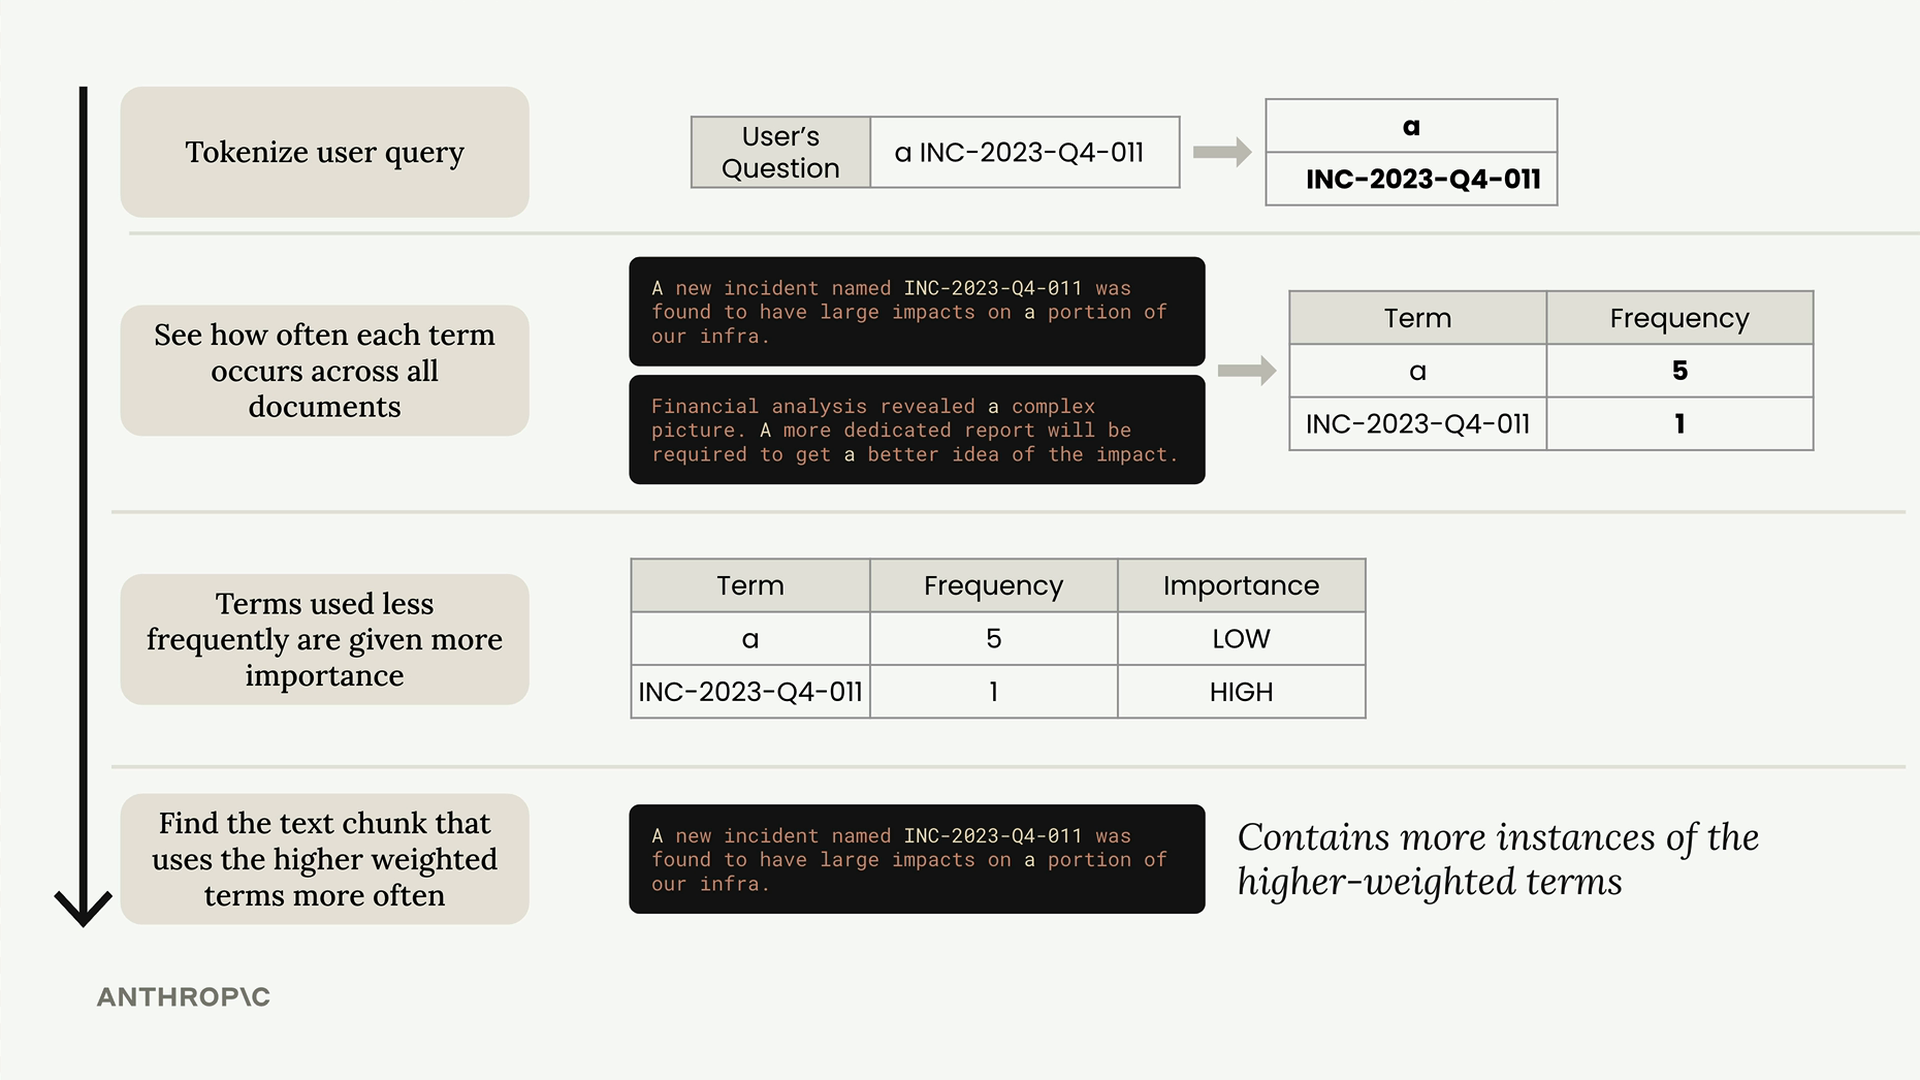
El algoritmo sigue estos pasos clave:
- Tokenizar la consulta - Divide la pregunta del usuario en términos individuales
- Contar la frecuencia de términos - Observa con qué frecuencia aparece cada término en todos los documentos
- Ponderar términos por rareza - Los términos usados con menos frecuencia obtienen puntuaciones de importancia más altas
- Puntuar documentos - Encuentra fragmentos de texto que contengan más instancias de los términos con mayor ponderación
La idea clave es que los términos raros como "INC-2023-Q4-011" son mucho más importantes para la relevancia de la búsqueda que palabras comunes como "un" o "el".
Implementando la búsqueda BM25
Así es como se configura un sistema de búsqueda BM25:
# Crear un almacén BM25
store = BM25Index()

# Agregar documentos al almacén
for chunk in chunks:
    store.add_document({"content": chunk})

# Buscar en el almacén
results = store.search("What happened with INC-2023-Q4-011?", 3)
La implementación de BM25 mantiene una API similar a tu almacén de vectores, con los métodos add_document() y search(). Esta consistencia facilita el uso de ambos sistemas juntos.
Mejores resultados de búsqueda
Cuando ejecutas la misma consulta a través de BM25 que falló con la búsqueda semántica por sí sola, obtienes resultados mucho mejores. El algoritmo prioriza correctamente las secciones que contienen el ID de incidente exacto, clasificándolas más alto que las secciones que podrían estar semánticamente relacionadas pero que no contienen el término específico que estás buscando.
Los resultados de búsqueda ahora muestran correctamente la sección de Ingeniería de Software y la sección de Ciberseguridad que realmente discuten el incidente, en lugar de devolver contenido no relacionado como Análisis Financiero.
Próximos pasos
Ahora que tienes sistemas de búsqueda semántica y léxica funcionando de forma independiente, el siguiente paso es combinar sus resultados. Este enfoque híbrido te dará la comprensión semántica de los embeddings combinada con la precisión de la coincidencia de palabras clave, creando una experiencia de búsqueda más robusta para tu pipeline de RAG.