Al construir interfaces de chat con modelos de IA, los usuarios esperan ver las respuestas aparecer de inmediato en lugar de esperar 10-30 segundos por una respuesta completa. La función converse_stream resuelve esto transmitiendo el texto a medida que se genera, creando una experiencia de usuario mucho mejor.
Cómo funciona el streaming
En lugar de esperar a que se genere toda la respuesta, el streaming envía fragmentos de texto tan pronto como están disponibles. Así es como cambia el flujo:
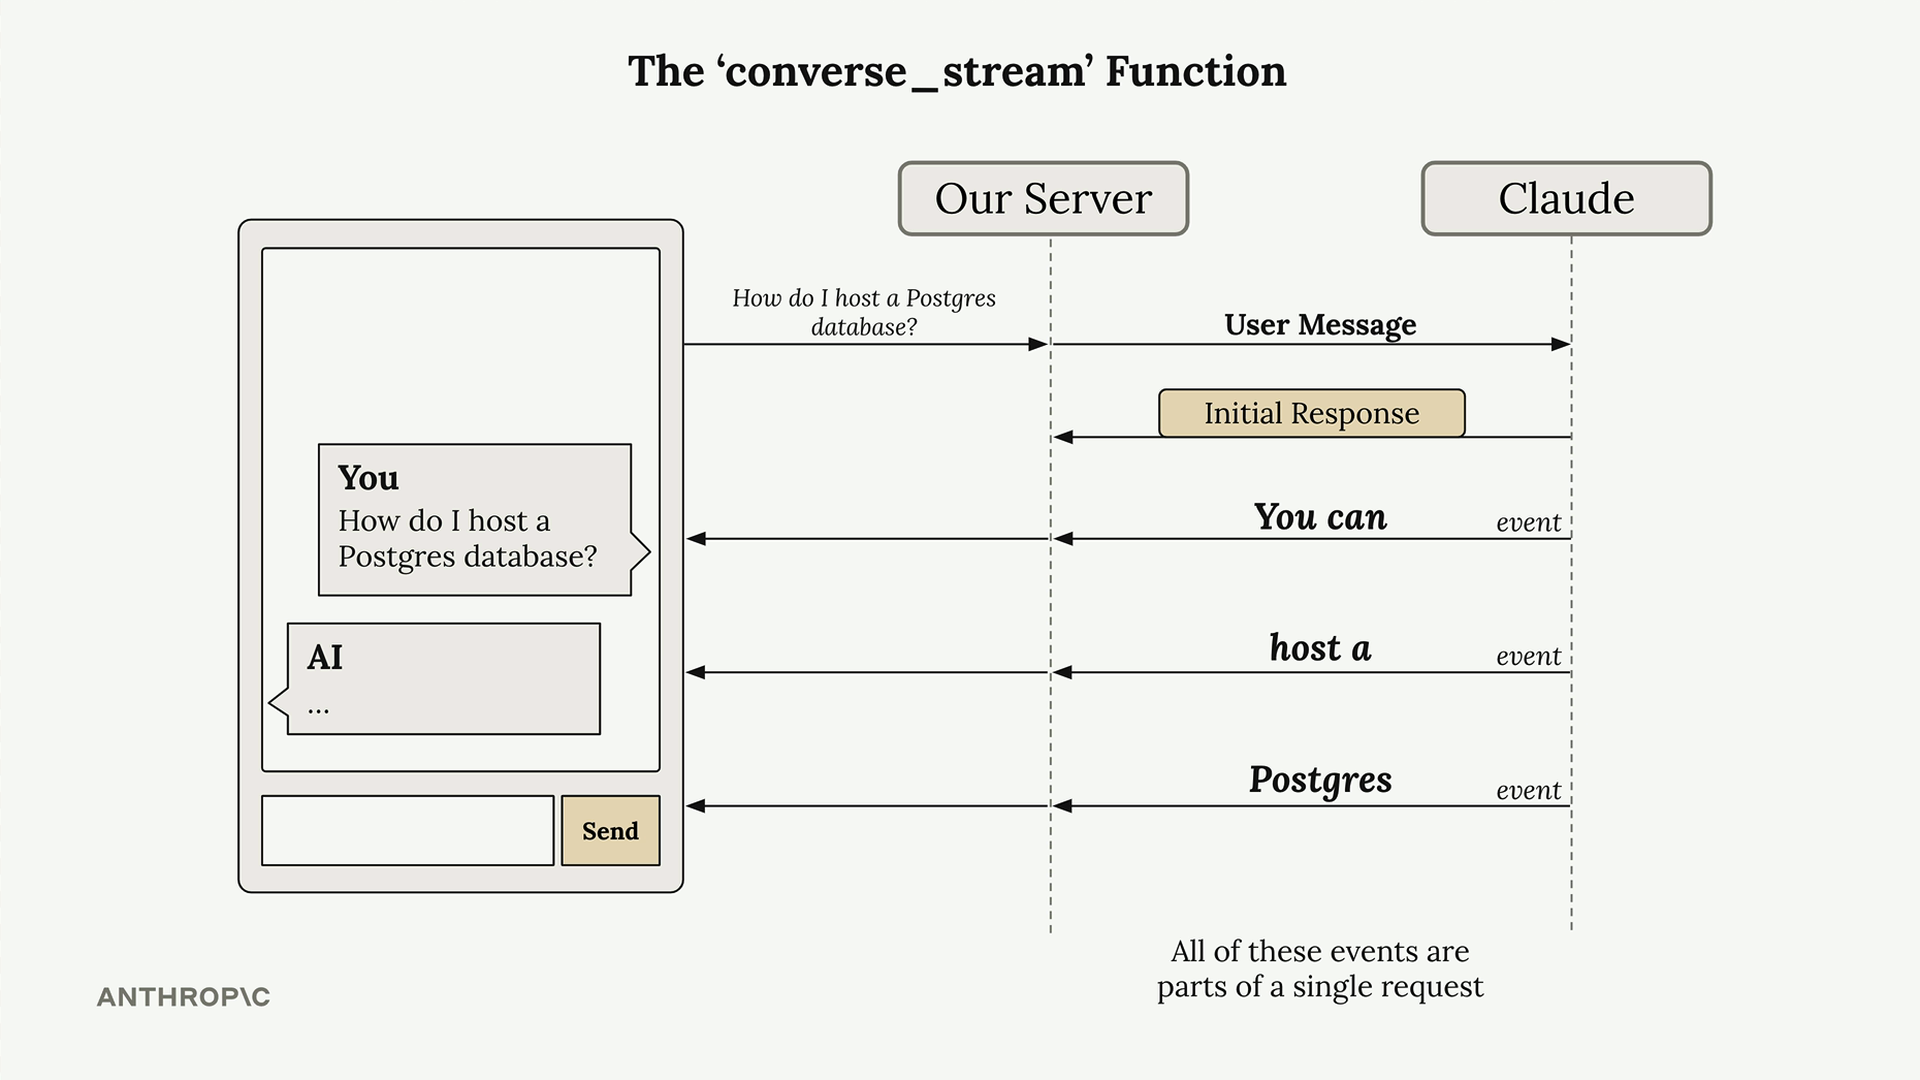
Cuando llamas a converse_stream, obtienes de inmediato una respuesta inicial que contiene un objeto stream. Este stream es un generador que produce eventos a medida que el modelo genera texto. Cada evento contiene un pequeño fragmento de la respuesta general.
Implementación básica
Así es como se usa converse_stream en tu código:
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")
response = client.converse_stream(messages=messages, modelId=model_id)

for event in response["stream"]:
    print(event)
Esto imprimirá todos los diferentes eventos a medida que llegan. Verás que la respuesta llega en fragmentos en lugar de toda de una vez.
Entendiendo los eventos del stream
El stream produce varios tipos de eventos, cada uno con un propósito diferente:
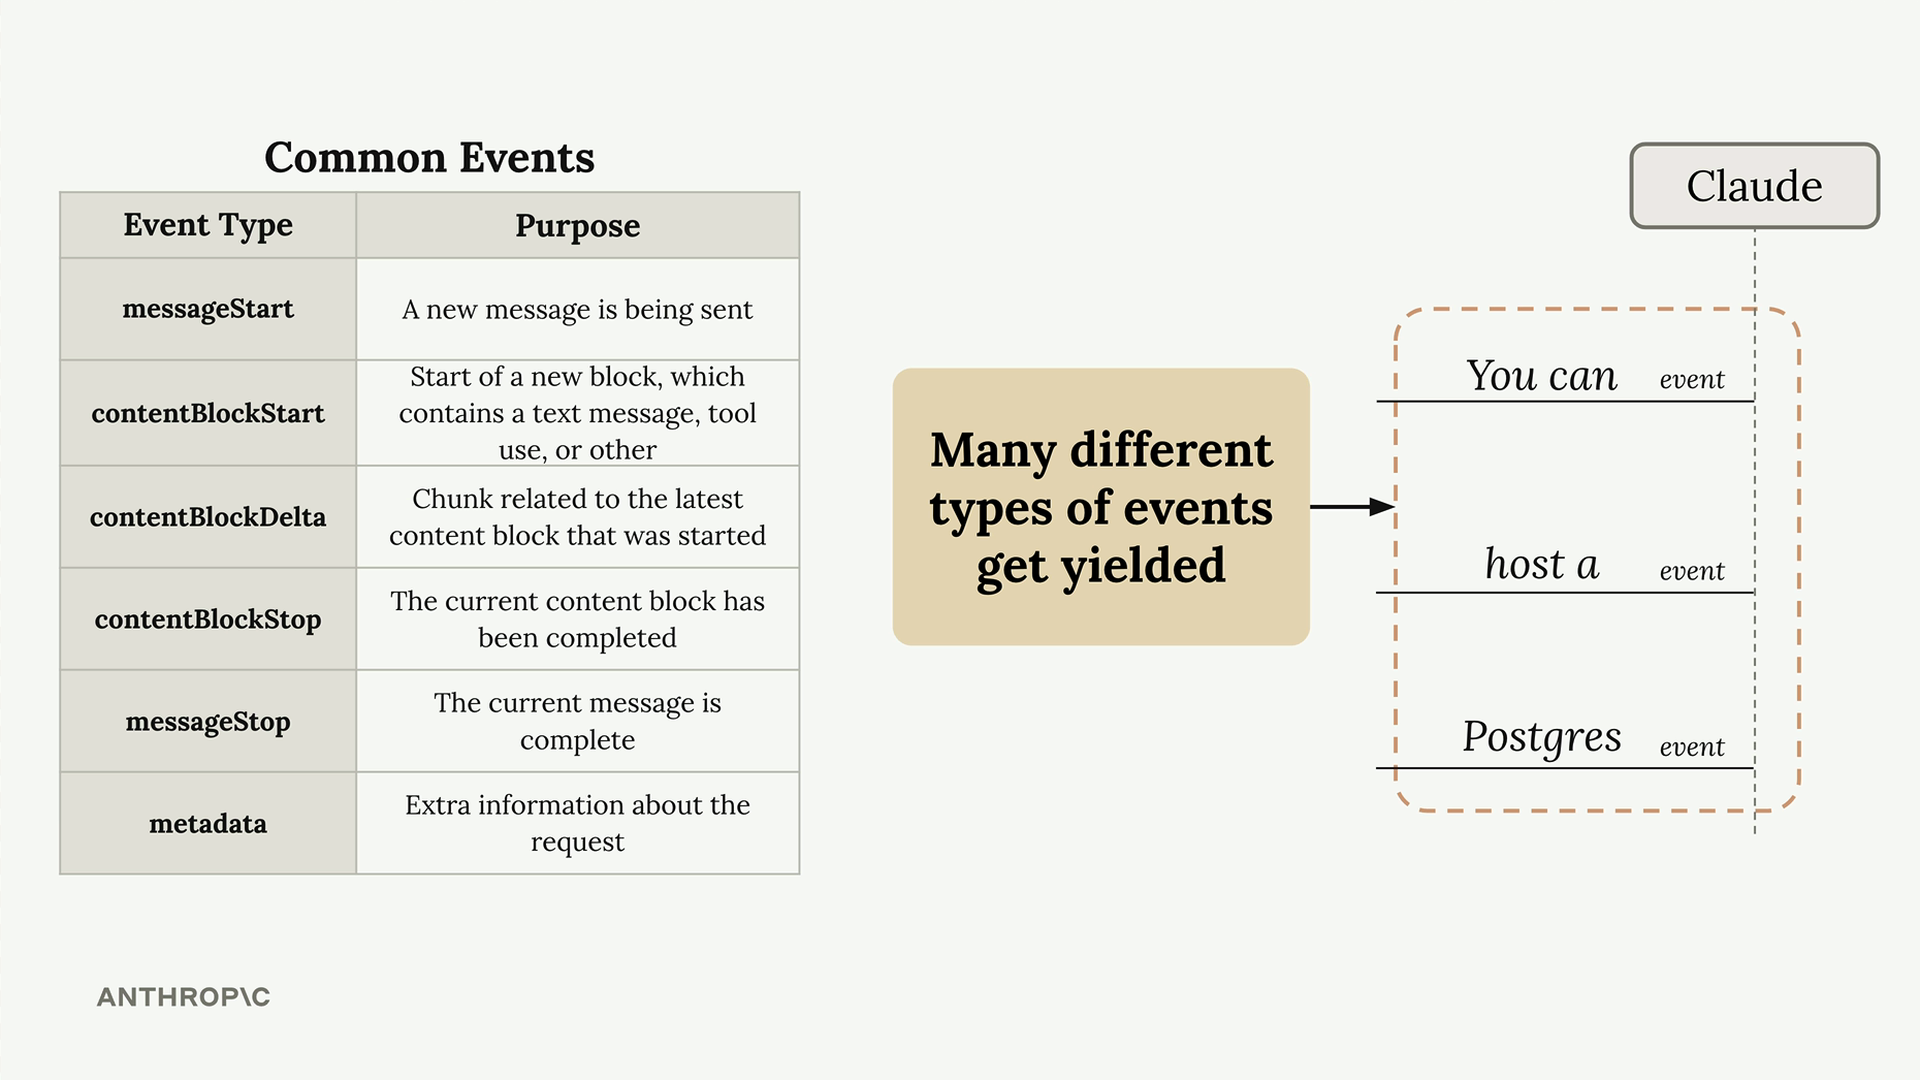
Para la generación básica de texto, solo necesitas preocuparte por los eventos contentBlockDelta. Estos contienen los fragmentos de texto generado reales que quieres mostrar a los usuarios.
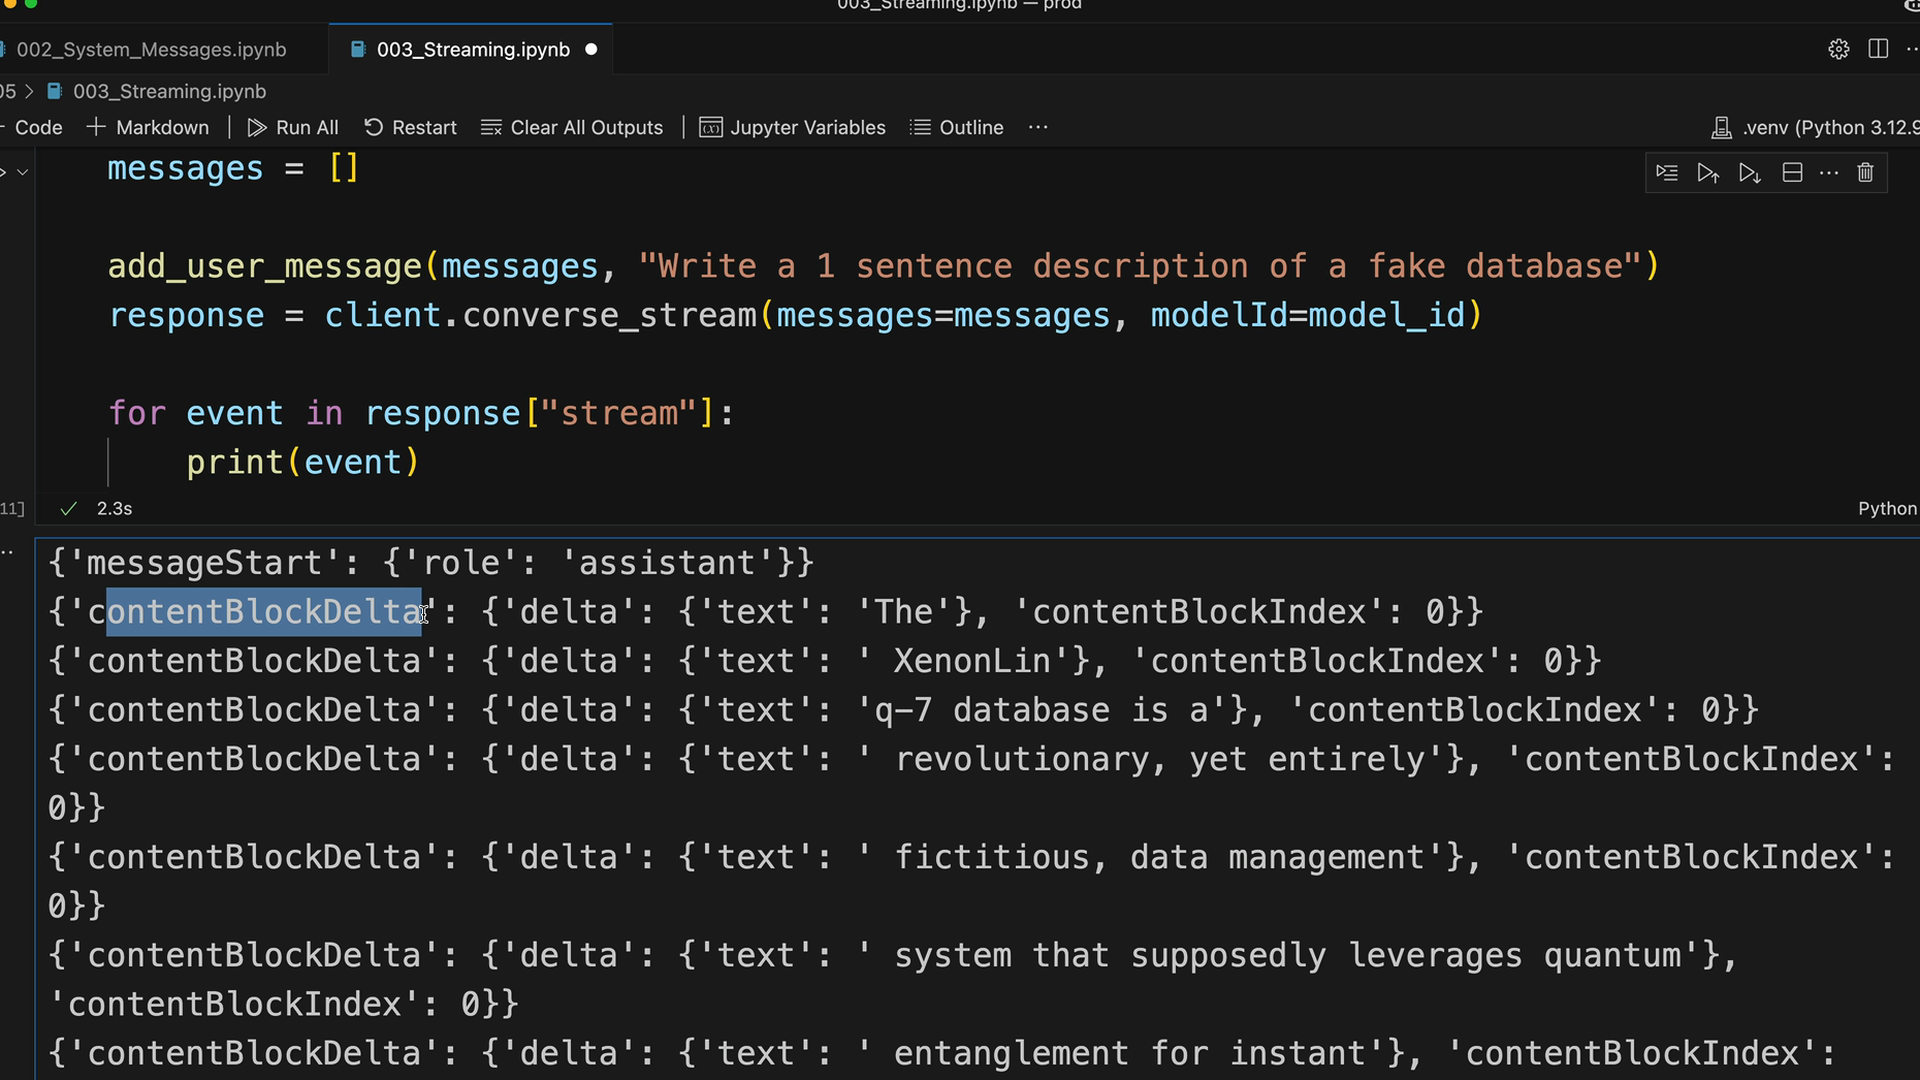
Los eventos siempre llegan en un orden predecible: messageStart, múltiples eventos contentBlockDelta que contienen tu texto, luego contentBlockStop, messageStop, y finalmente metadata.
Extrayendo el texto
Para obtener solo el texto generado de cada fragmento, filtra los eventos contentBlockDelta y extrae el texto:
text = ""
for event in response["stream"]:
    if "contentBlockDelta" in event:
        chunk = event["contentBlockDelta"]["delta"]["text"]
        print(chunk, end="")
        text += chunk

print("\n\nTotal Message:\n" + text)
El parámetro end="" elimina el salto de línea automático que la función print de Python agrega, haciendo que el texto en streaming aparezca de forma más natural.
Aplicaciones prácticas
En una aplicación real, en lugar de imprimir cada fragmento, normalmente harías lo siguiente:
- Enviar cada fragmento a tu frontend mediante WebSockets o Server-Sent Events
- Actualizar la interfaz de usuario para mostrar la respuesta creciente en tiempo real
- Almacenar el mensaje completo una vez que finalice el streaming
- Manejar cualquier error que pueda ocurrir durante el streaming
Este enfoque de streaming transforma la experiencia del usuario de "enviar y esperar" a "enviar y ver la respuesta aparecer", haciendo que tus aplicaciones impulsadas por IA se sientan mucho más receptivas y atractivas.