La ingeniería de prompts consiste en tomar un prompt que has escrito y mejorarlo para obtener resultados más confiables y de mayor calidad. Este proceso implica escribir un prompt inicial, evaluar su rendimiento y luego aplicar sistemáticamente técnicas de ingeniería para mejorarlo paso a paso.
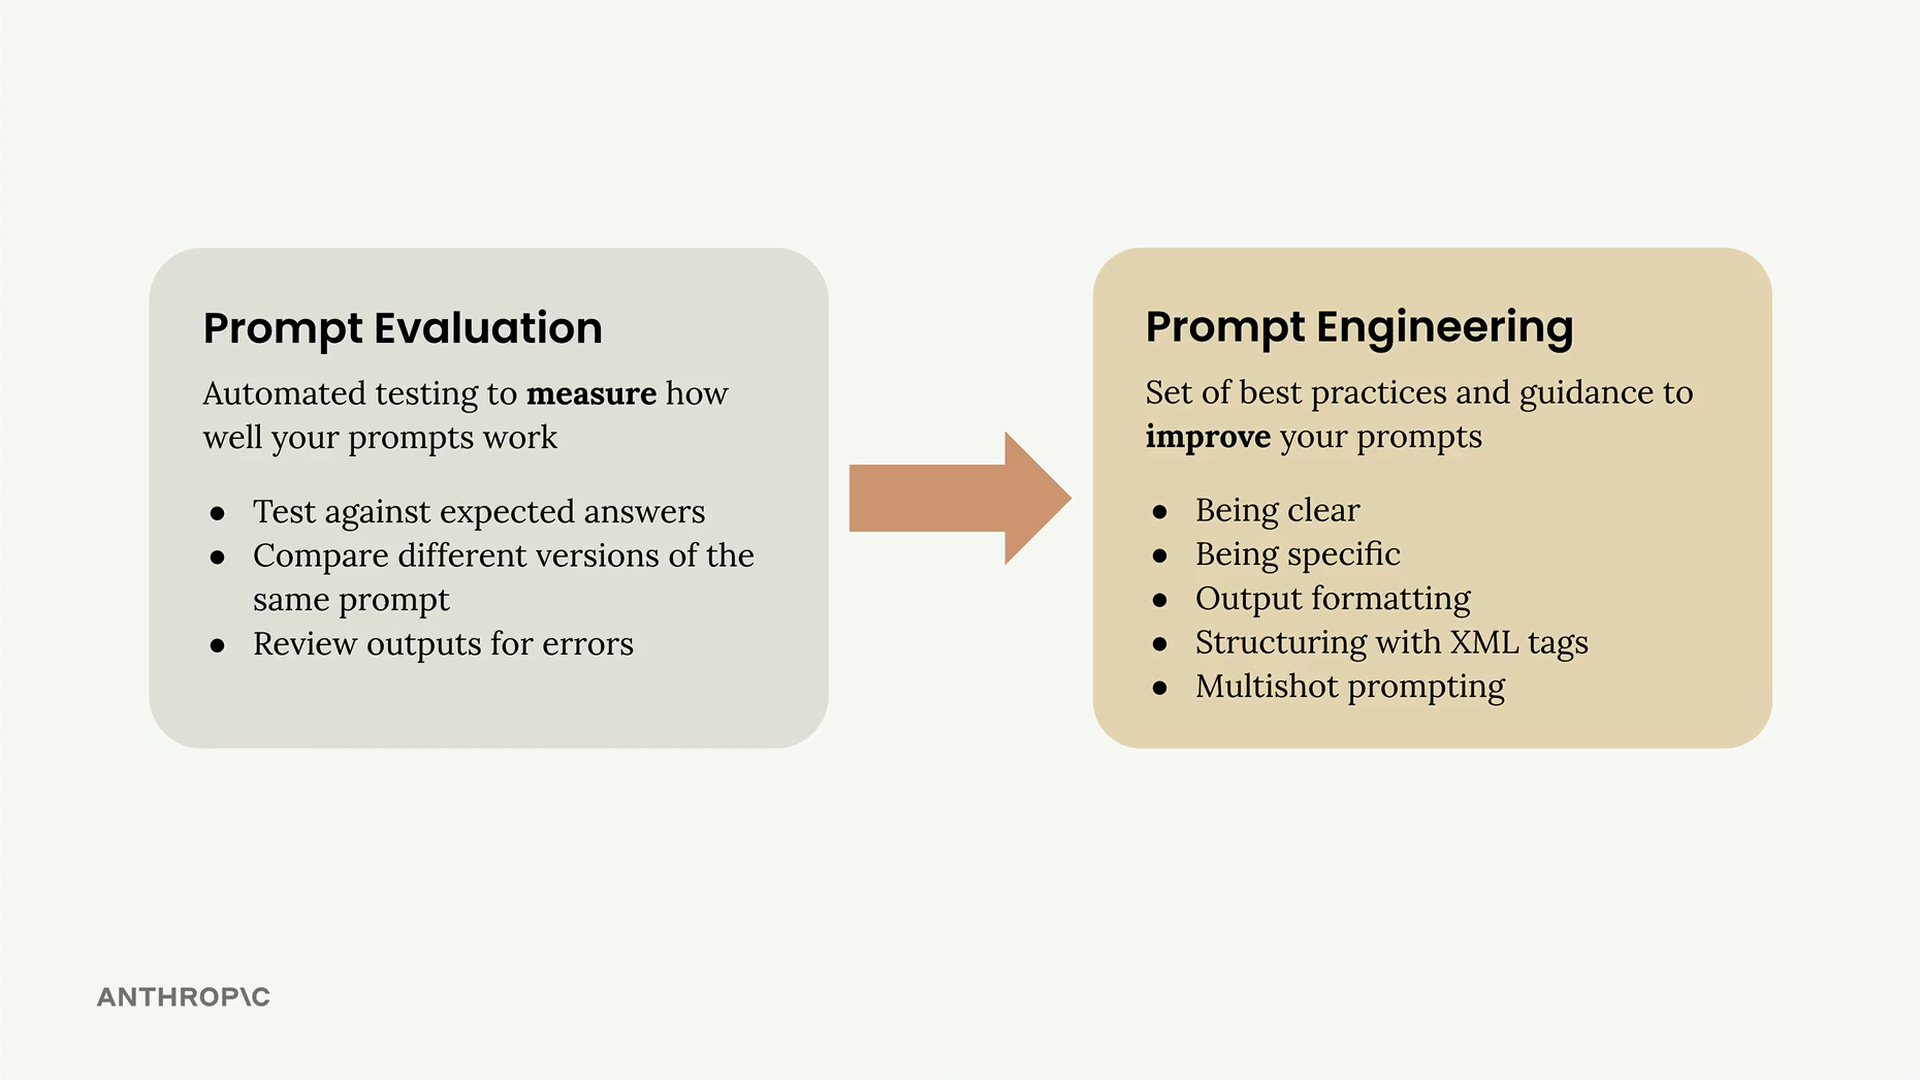
El proceso de mejora iterativa
El enfoque sigue un ciclo claro: establecer un objetivo, escribir un prompt inicial, evaluarlo, aplicar una técnica de ingeniería de prompts y luego volver a evaluar para verificar un mejor rendimiento. Este ciclo se repite mientras refinas tu prompt.
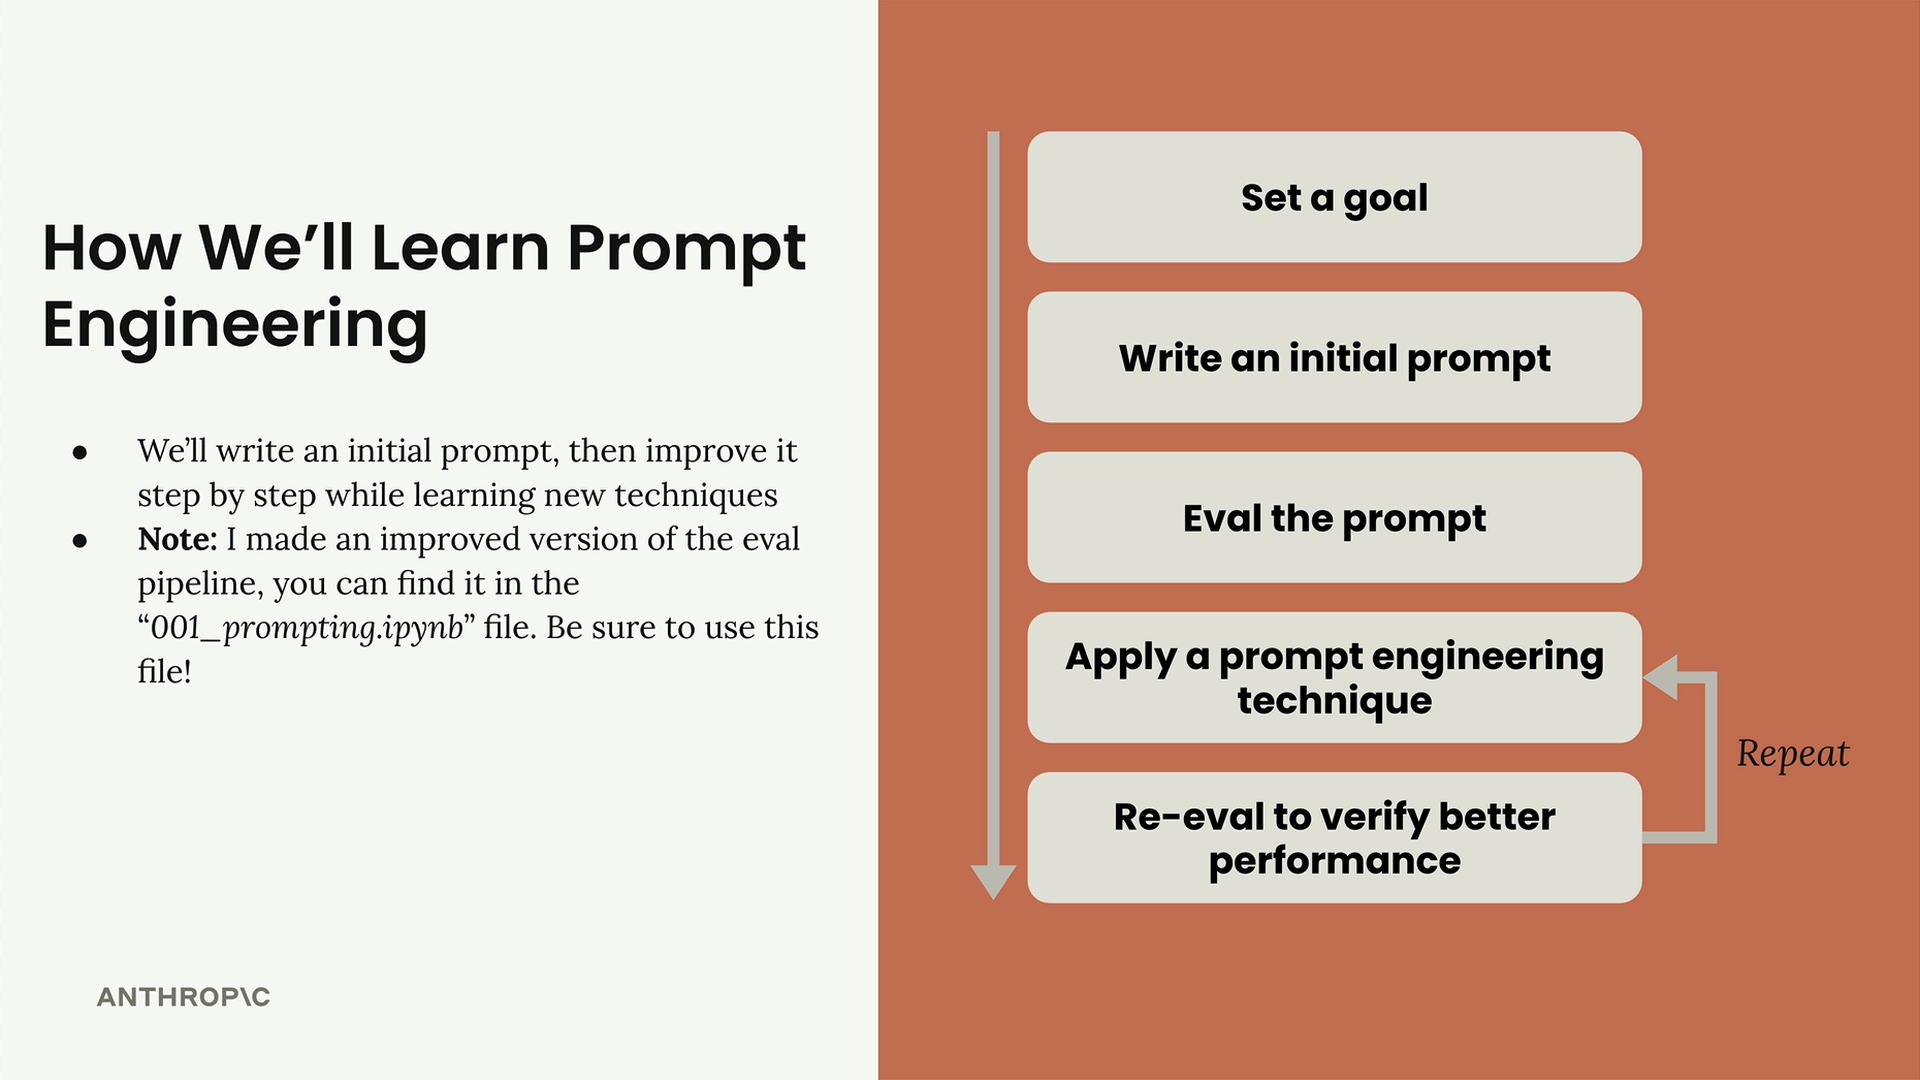
Para esta serie de tutoriales, trabajaremos en un ejemplo práctico: crear un prompt que genere planes de comidas de un día para atletas según su altura, peso, objetivos físicos y restricciones dietéticas.
Configuración del pipeline de evaluación
La evaluación utiliza una versión mejorada del pipeline de módulos anteriores, envuelta en una clase PromptEvaluator que gestiona la generación de conjuntos de datos y la calificación del modelo. La clase admite concurrencia para acelerar el proceso de evaluación:
evaluator = PromptEvaluator(max_concurrent_tasks=5)Comienza con un valor de concurrencia bajo (como 3) para evitar errores de límite de velocidad. Puedes ajustar esto según tu cuota de API.
Generación de datos de prueba
El método generate_dataset crea casos de prueba para tu prompt. Debes especificar:
- Una descripción de la tarea que explique qué debe hacer tu prompt
- Una especificación de las entradas que requiere tu prompt
- La cantidad de casos de prueba a generar
Para el ejemplo de planificación de comidas:
dataset = evaluator.generate_dataset(
    task_description="Write a compact, concise 1 day meal plan for a single athlete",
    prompt_inputs_spec={
        "height": "Athlete's height in cm",
        "weight": "Athlete's weight in kg",
        "goal": "Goal of the athlete",
        "restrictions": "Dietary restrictions of the athlete"
    },
    num_cases=3
)
Escribiendo tu prompt inicial
Comienza con un prompt simple e ingenuo para establecer una línea base. La función run_prompt recibe las entradas del caso de prueba y debe devolver la respuesta del modelo:
def run_prompt(prompt_inputs):
    prompt = f"""
    What should this person eat?

    - Height: {prompt_inputs["height"]}
    - Weight: {prompt_inputs["weight"]}
    - Goal: {prompt_inputs["goal"]}
    - Dietary restrictions: {prompt_inputs["restrictions"]}
    """

    messages = []
    add_user_message(messages, prompt)
    return chat(messages)
Ejecutando la evaluación
El proceso de evaluación compara la salida de tu prompt con los criterios esperados. Puedes agregar criterios adicionales para guiar la calificación:
results = evaluator.run_evaluation(
    run_prompt_function=run_prompt,
    dataset_file="dataset.json",
    extra_criteria="""
    The output should include:
    - Daily caloric total
    - Macronutrient breakdown
    - Meals with exact foods, portions, and timing
    """
)
Analizando los resultados
La evaluación genera un archivo output.html que puedes abrir en tu navegador. Este informe muestra resultados detallados para cada caso de prueba, incluyendo puntuaciones, razonamiento y la salida real generada por tu prompt.
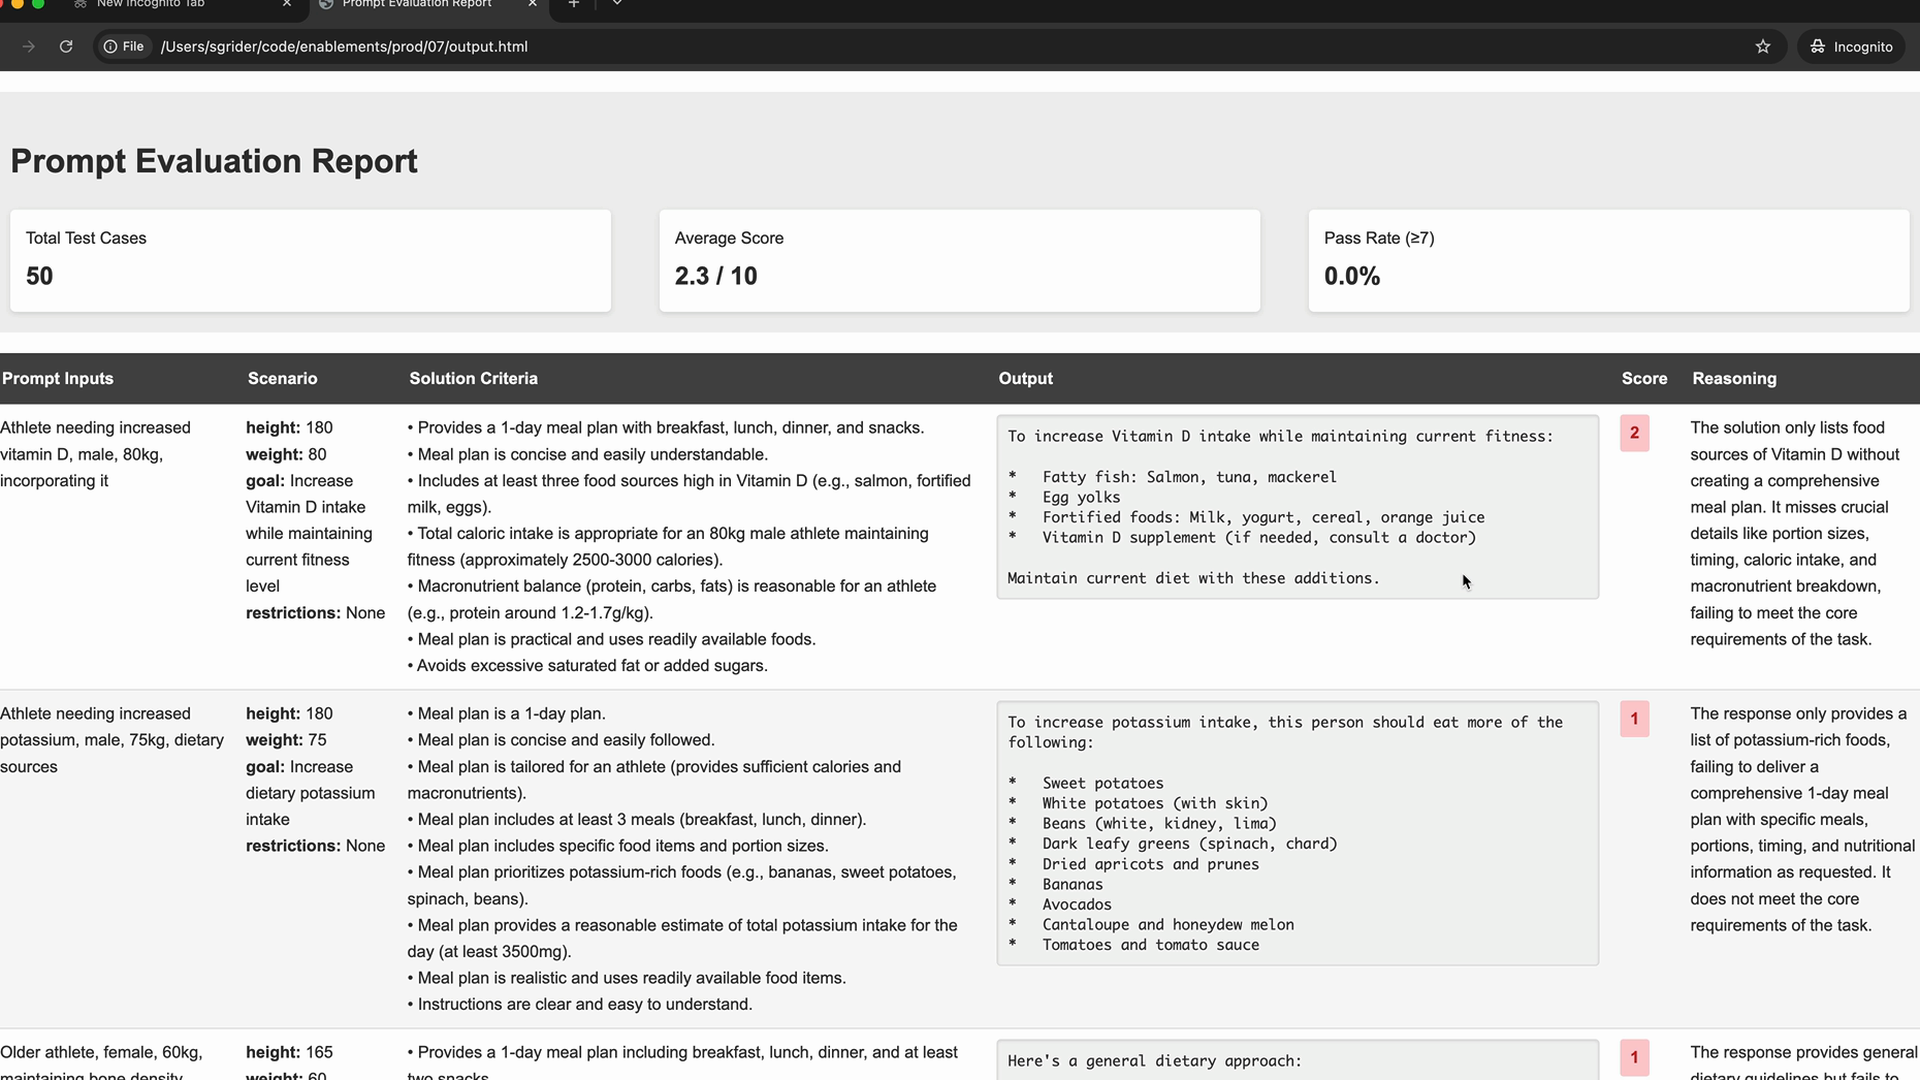
No te desanimes por las puntuaciones iniciales bajas: ¡eso es de esperar! El prompt inicial en este ejemplo obtuvo solo 2.3 de 10, pero esto te da una línea base clara a partir de la cual mejorar.
Qué sigue
Con tu línea base establecida, ahora puedes aplicar sistemáticamente técnicas de ingeniería de prompts como ser más específico, agregar requisitos de formato de salida, usar prompts estructurados e implementar ejemplos multi-shot. Cada técnica debería mejorar tu puntuación de evaluación, dándote un progreso medible hacia tu objetivo.