Este recorrido demuestra la implementación completa de RAG (Retrieval-Augmented Generation) usando un ejemplo práctico. Construiremos una base de datos vectorial desde cero y ejecutaremos los cinco pasos del flujo de trabajo de RAG usando un documento de informe de muestra.
Configurando la base de datos vectorial
La implementación usa una clase personalizada VectorIndex que se encarga de almacenar embeddings y realizar búsquedas de similitud. Esta clase proporciona la funcionalidad principal que necesitamos para nuestras operaciones de base de datos vectorial.
La implementación de RAG en cinco pasos
Paso 1: Dividir el texto por sección
Primero, cargamos y dividimos nuestro documento fuente usando el mismo enfoque de división basado en secciones que vimos anteriormente:
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
Esto divide nuestro informe en secciones lógicas que pueden procesarse de forma independiente.
Paso 2: Generar embeddings para cada fragmento
A continuación, creamos embeddings para cada fragmento usando una comprensión de listas:
embeddings = [generate_embedding(chunk) for chunk in chunks]Este paso implica múltiples llamadas a la API, por lo que tarda algo de tiempo en completarse. Cada fragmento se convierte en una representación vectorial numérica.
Paso 3: Almacenar embeddings en la base de datos vectorial
Ahora creamos nuestro almacén vectorial y lo poblamos tanto con los embeddings como con su texto asociado:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
La idea clave aquí es que almacenamos tanto el embedding como el texto original. Obtener solo una lista de números no es útil: necesitamos el contenido de texto real que corresponde a esos embeddings. Estos metadatos nos permiten recuperar resultados significativos más adelante.
Paso 4: Generar el embedding de la consulta del usuario
Cuando un usuario hace una pregunta, la convertimos al mismo formato de embedding:
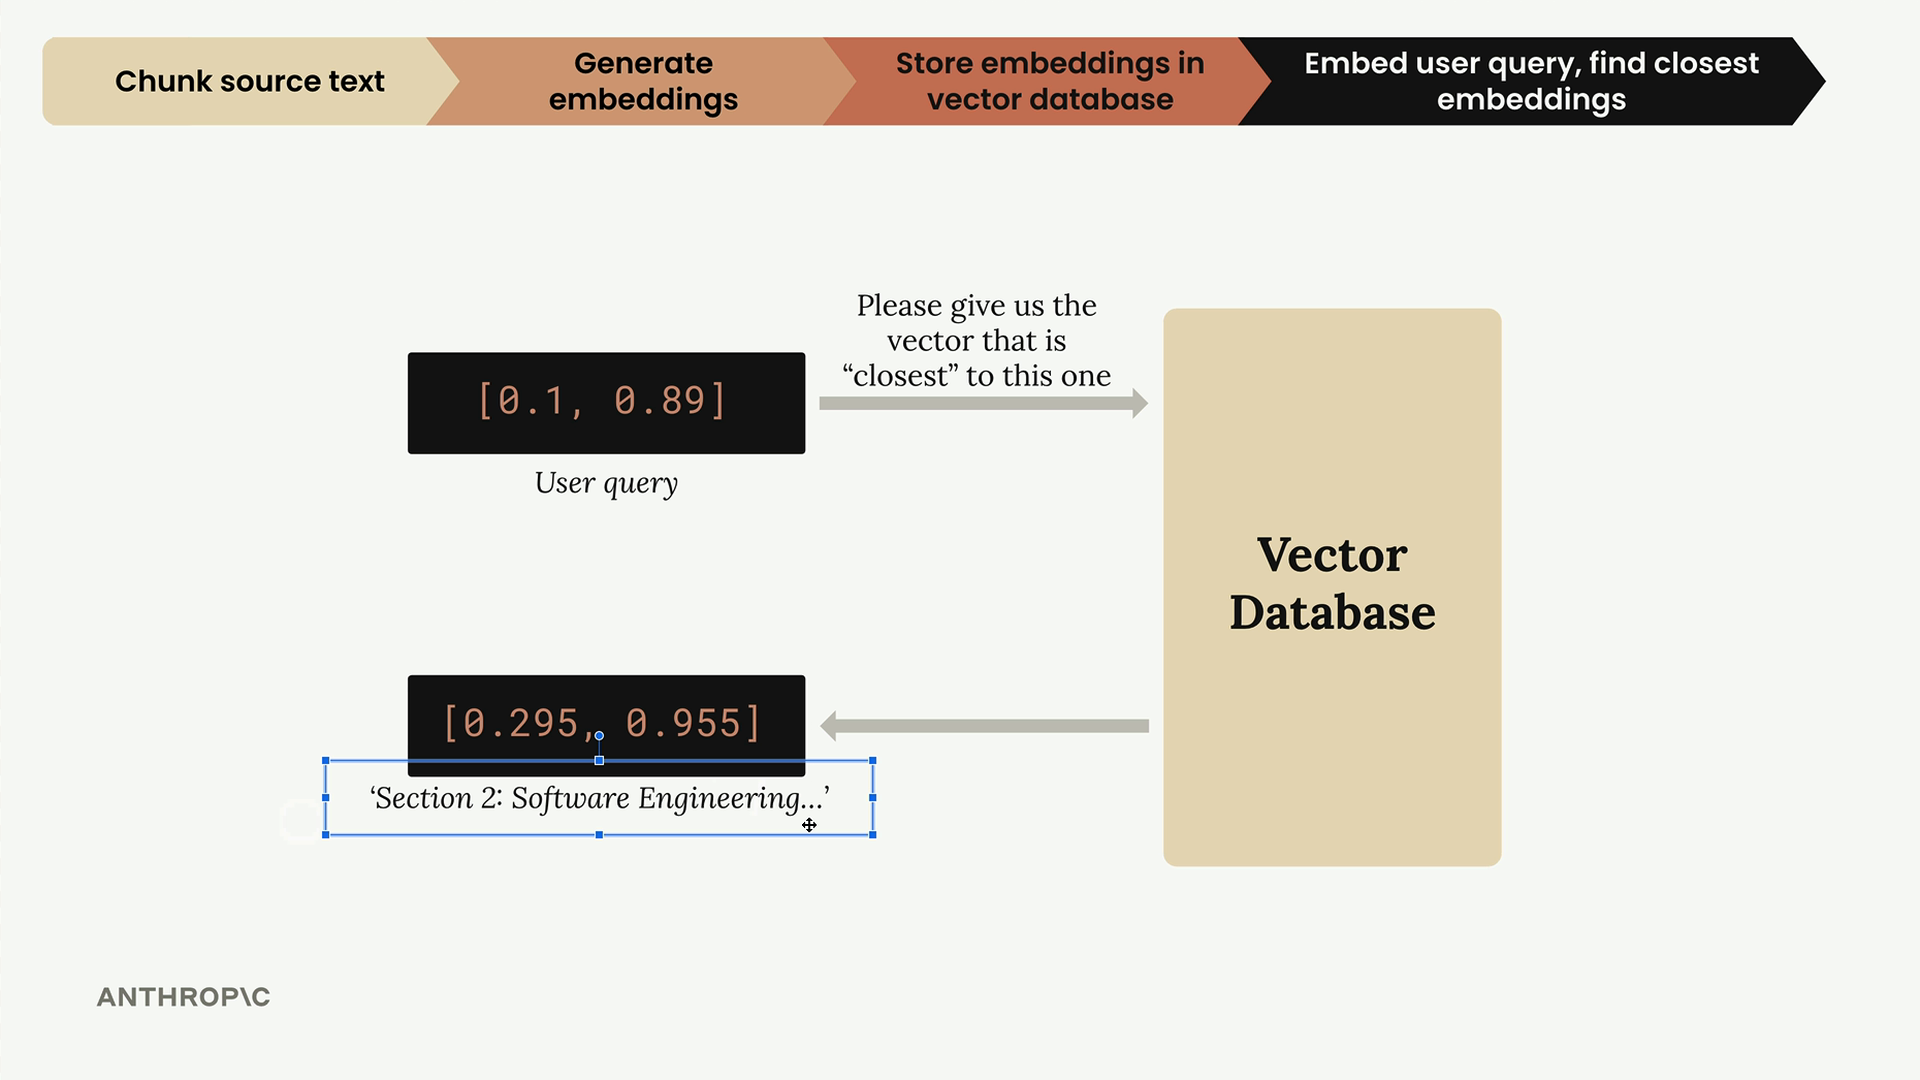
user_embedding = generate_embedding("What did the software engineering dept do last year?")Esto crea una representación vectorial de la pregunta del usuario que puede compararse con nuestros embeddings almacenados.
Paso 5: Buscar y recuperar fragmentos relevantes
Finalmente, buscamos en nuestro almacén vectorial para encontrar el contenido más similar:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Esto devuelve los dos fragmentos más relevantes junto con sus puntuaciones de distancia coseno. Distancias más bajas indican mayor similitud.
Entendiendo los resultados
La búsqueda devuelve resultados clasificados por relevancia. En nuestro ejemplo, la sección de ingeniería de software tuvo la distancia más baja (0.71), lo que la convierte en la coincidencia más relevante. La sección de metodología quedó en segundo lugar con una distancia de 0.72.
La métrica de distancia te ayuda a entender qué tan confiado está el sistema sobre la relevancia de cada resultado. Distancias más cercanas significan mejores coincidencias con la consulta del usuario.
Por qué almacenar texto junto con los embeddings
Una decisión de diseño crucial es almacenar el texto original junto a cada embedding. Sin esto, solo obtendrías arreglos de números, que no son útiles para generar respuestas. Al incluir el texto fuente, puedes usar inmediatamente los fragmentos recuperados para proporcionar contexto a tu modelo de lenguaje.
Esto completa el flujo de trabajo principal de RAG, aunque existen optimizaciones y mejoras adicionales que pueden potenciar el rendimiento en escenarios del mundo real.