La evaluación basada en código añade una capa adicional de validación a tus evaluaciones de prompts al verificar si la salida del modelo sigue el formato correcto y tiene una sintaxis válida. Esto es especialmente útil cuando le pides a los modelos que generen código, JSON o expresiones regulares.
Cómo funciona la evaluación de código
El evaluador de código evalúa dos criterios principales:
- Cumplimiento del formato - ¿La salida contiene únicamente el formato solicitado (Python, JSON o regex) sin explicaciones?
- Sintaxis válida - ¿Se puede analizar o compilar la salida correctamente?
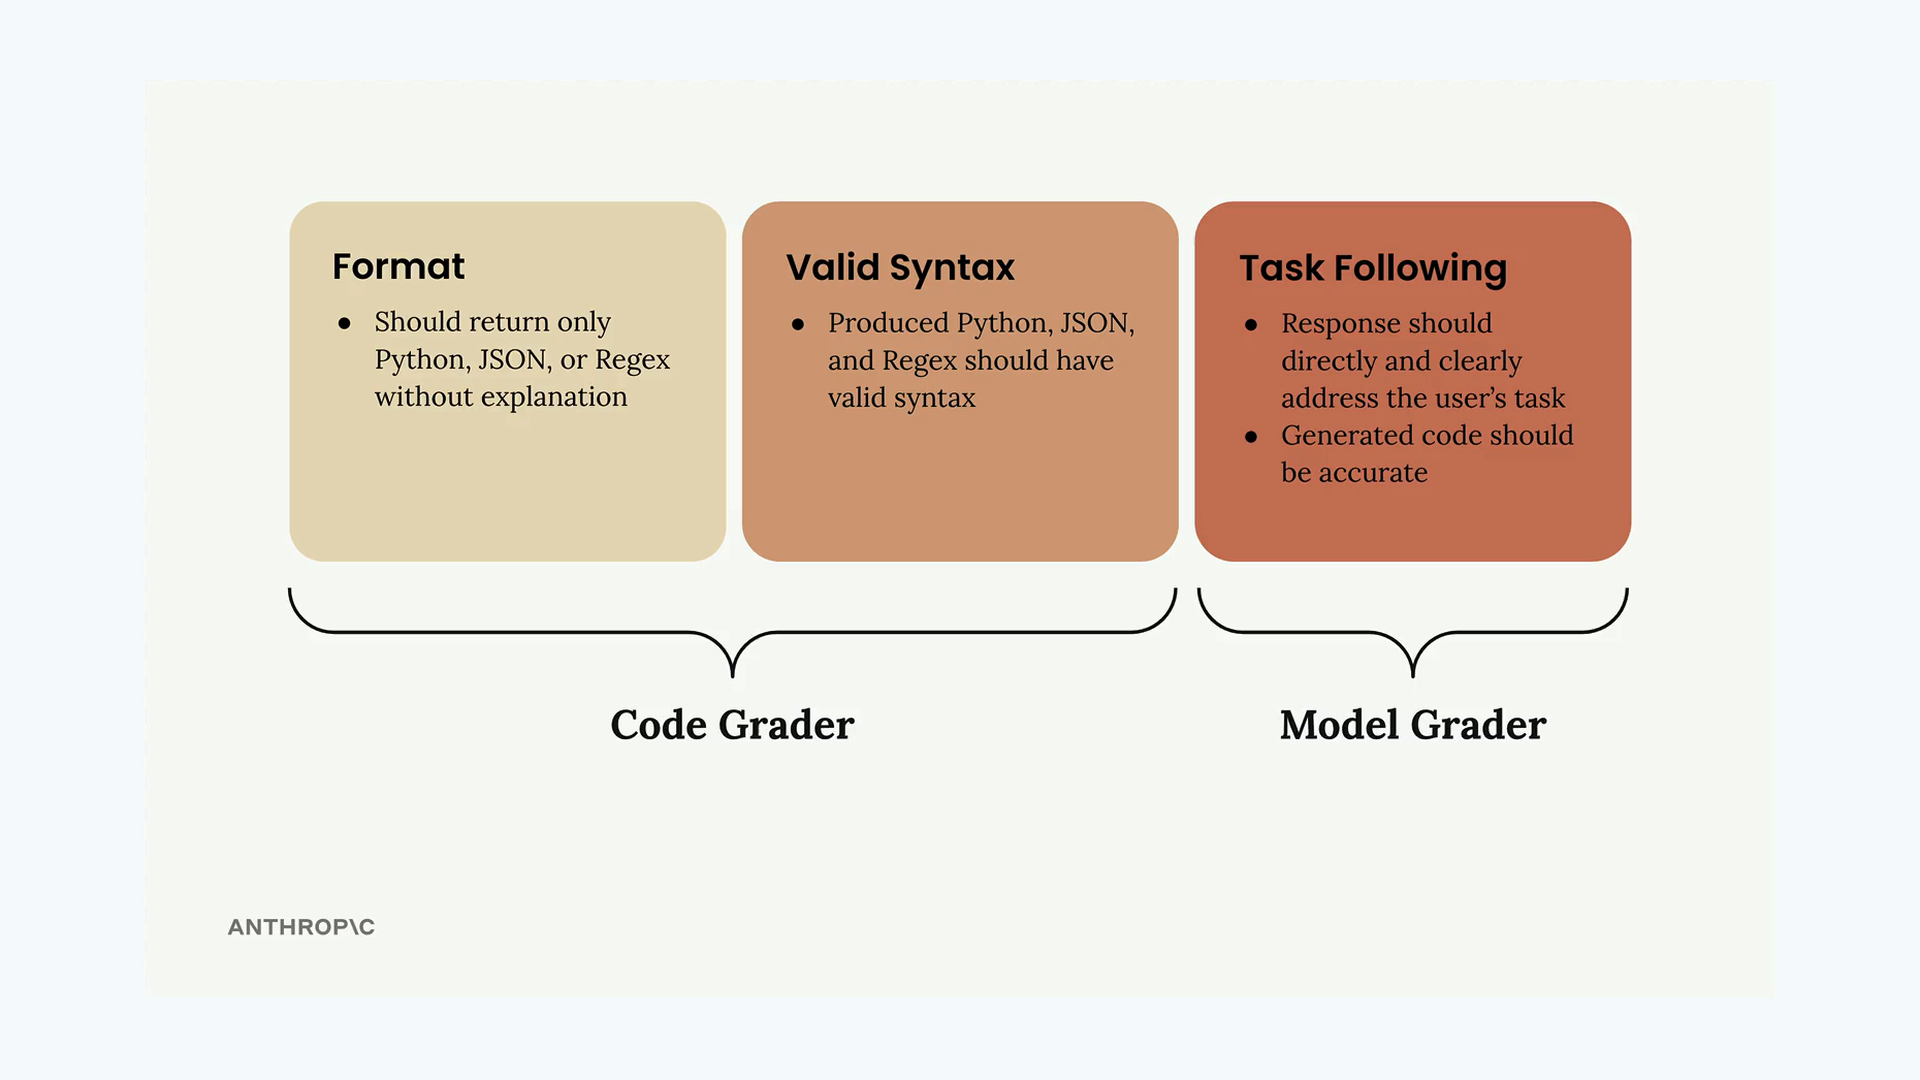
El sistema utiliza funciones de validación separadas para cada tipo de formato. Si el código se analiza correctamente, obtiene una puntuación perfecta de 10. Si el análisis falla con un error, obtiene una puntuación de 0.
Configuración de las funciones de validación
Necesitarás tres funciones auxiliares para validar diferentes tipos de salida:
def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
Estas funciones utilizan las capacidades de análisis integradas de Python para verificar la validez de la sintaxis. La función json.loads() valida JSON, ast.parse() crea un árbol de sintaxis abstracta de Python, y re.compile() valida expresiones regulares.
Agregar información de formato a los casos de prueba
Tu conjunto de datos de prueba necesita especificar el formato de salida esperado para cada tarea. Actualiza tu prompt de generación de conjunto de datos para incluir un campo de formato:
{
    "task": "Description of task",
    "format": "python"
}
El campo de formato debe contener "json", "python" o "regex" dependiendo del tipo de salida que esperas de esa tarea en particular.
Mejorar tu prompt
Para obtener mejores resultados del evaluador de código, haz que las instrucciones de tu prompt sean más específicas:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationTambién puedes usar un mensaje de asistente prellenado con bloques de código y secuencias de detención para garantizar un formato de salida limpio.
Combinación de puntuaciones
El paso final es combinar la puntuación de tu evaluador de modelo con la puntuación del evaluador de sintaxis. Un enfoque simple es tomar el promedio de ambas puntuaciones:
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
Esto le da el mismo peso tanto a la calidad del contenido (del evaluador de modelo) como a la corrección técnica (del evaluador de código). Puedes ajustar esta ponderación según lo que sea más importante para tu caso de uso específico.
Interpretación de resultados
Una vez que ejecutes tu evaluación, obtendrás una puntuación combinada que refleja tanto la calidad semántica como la corrección técnica del código generado. Recuerda que una sola puntuación aislada no te dice mucho: el verdadero valor proviene de comparar puntuaciones a medida que iteras en el diseño de tu prompt.
Usa esta puntuación de referencia para probar mejoras en el prompt y ver si tus cambios realmente conducen a una generación de código mejor y más confiable.