Más allá de crear mejores prompts, existen dos técnicas poderosas para controlar la salida de Claude: los mensajes de asistente prellenados y las secuencias de parada. Estos métodos te dan control preciso sobre cómo responde Claude y cuándo deja de generar texto.
Mensajes de asistente prellenados
El prellenado de mensajes te permite proporcionar el inicio de la respuesta de Claude, lo cual influye fuertemente en la dirección de su respuesta. En lugar de dejar que Claude decida cómo comenzar su respuesta, le das una apertura específica que orienta la conversación.
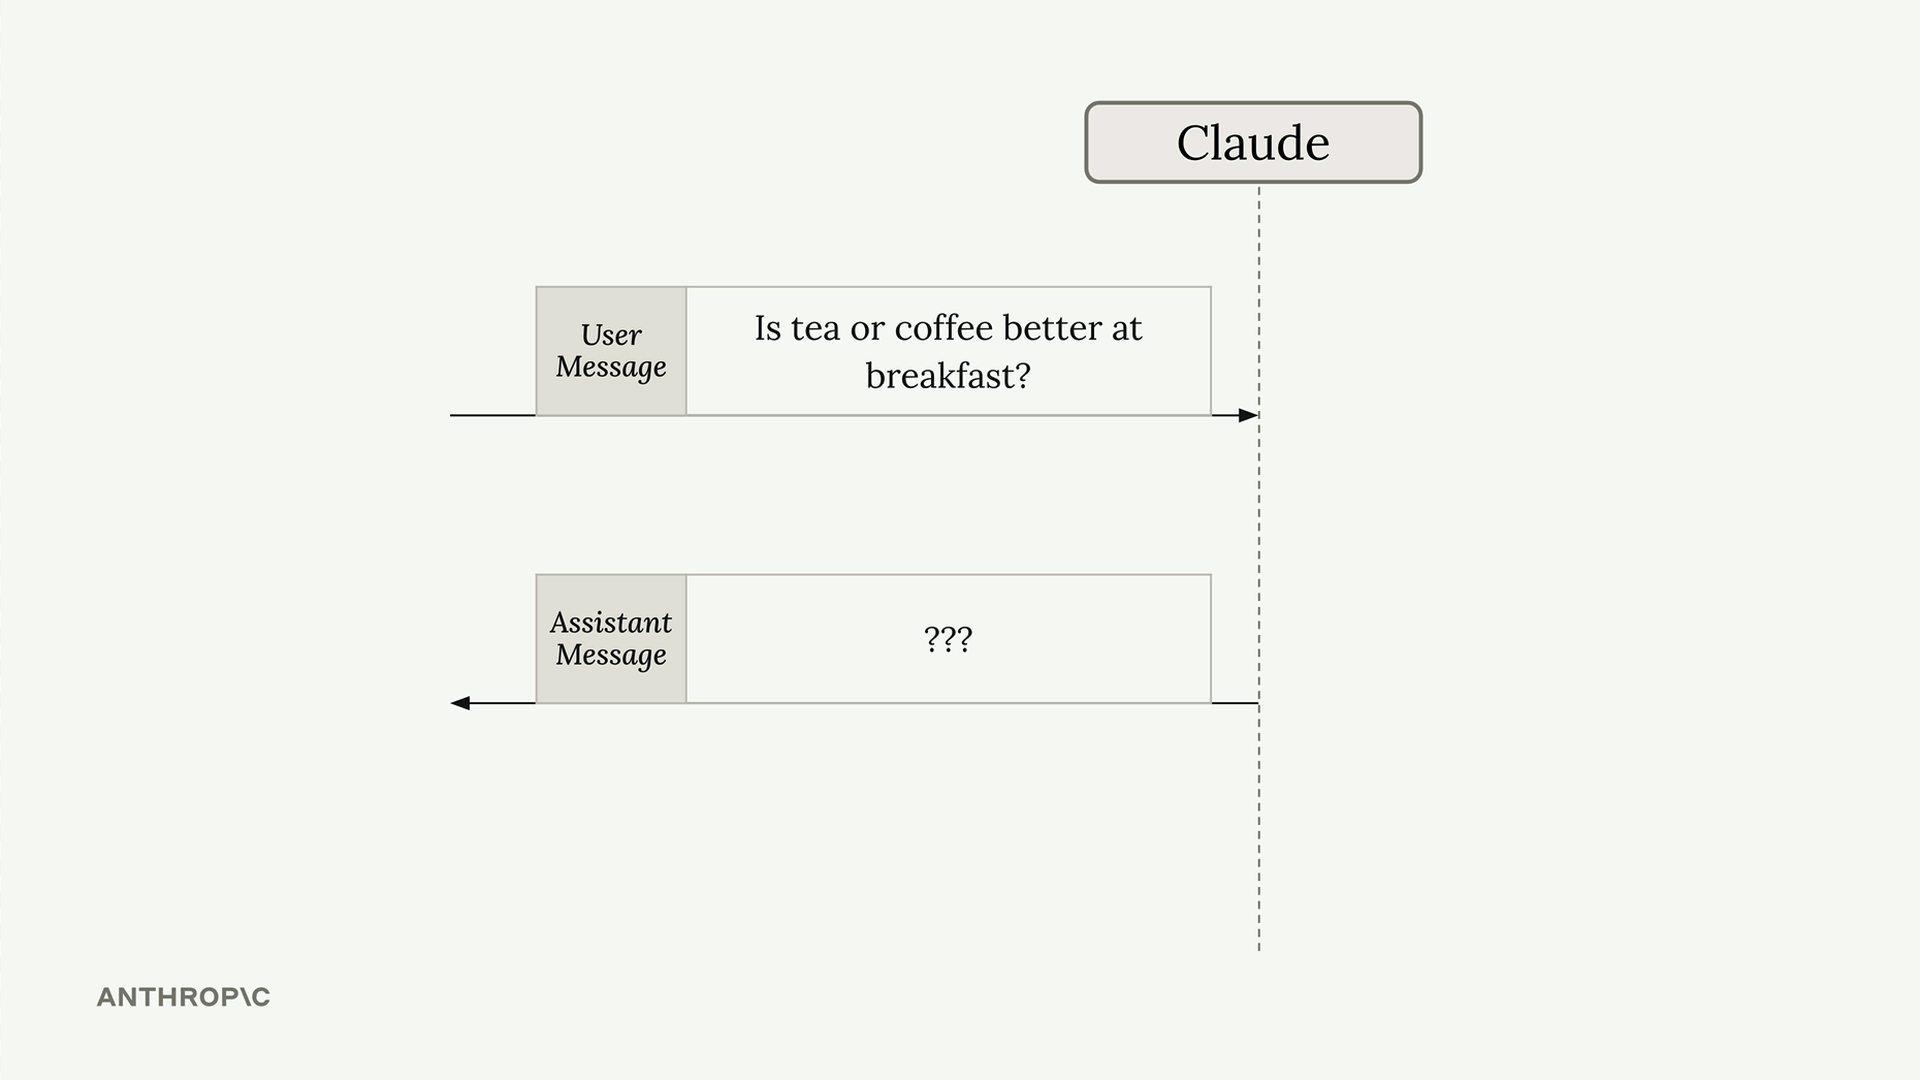
Así es como funciona: construyes tu lista normal de mensajes con la pregunta del usuario, pero luego agregas un mensaje de asistente al final que contiene el inicio de la respuesta que deseas. Cuando Claude procesa esto, ve el mensaje de asistente y piensa "ya he comenzado a responder esta pregunta, así que debería continuar desde donde lo dejé."
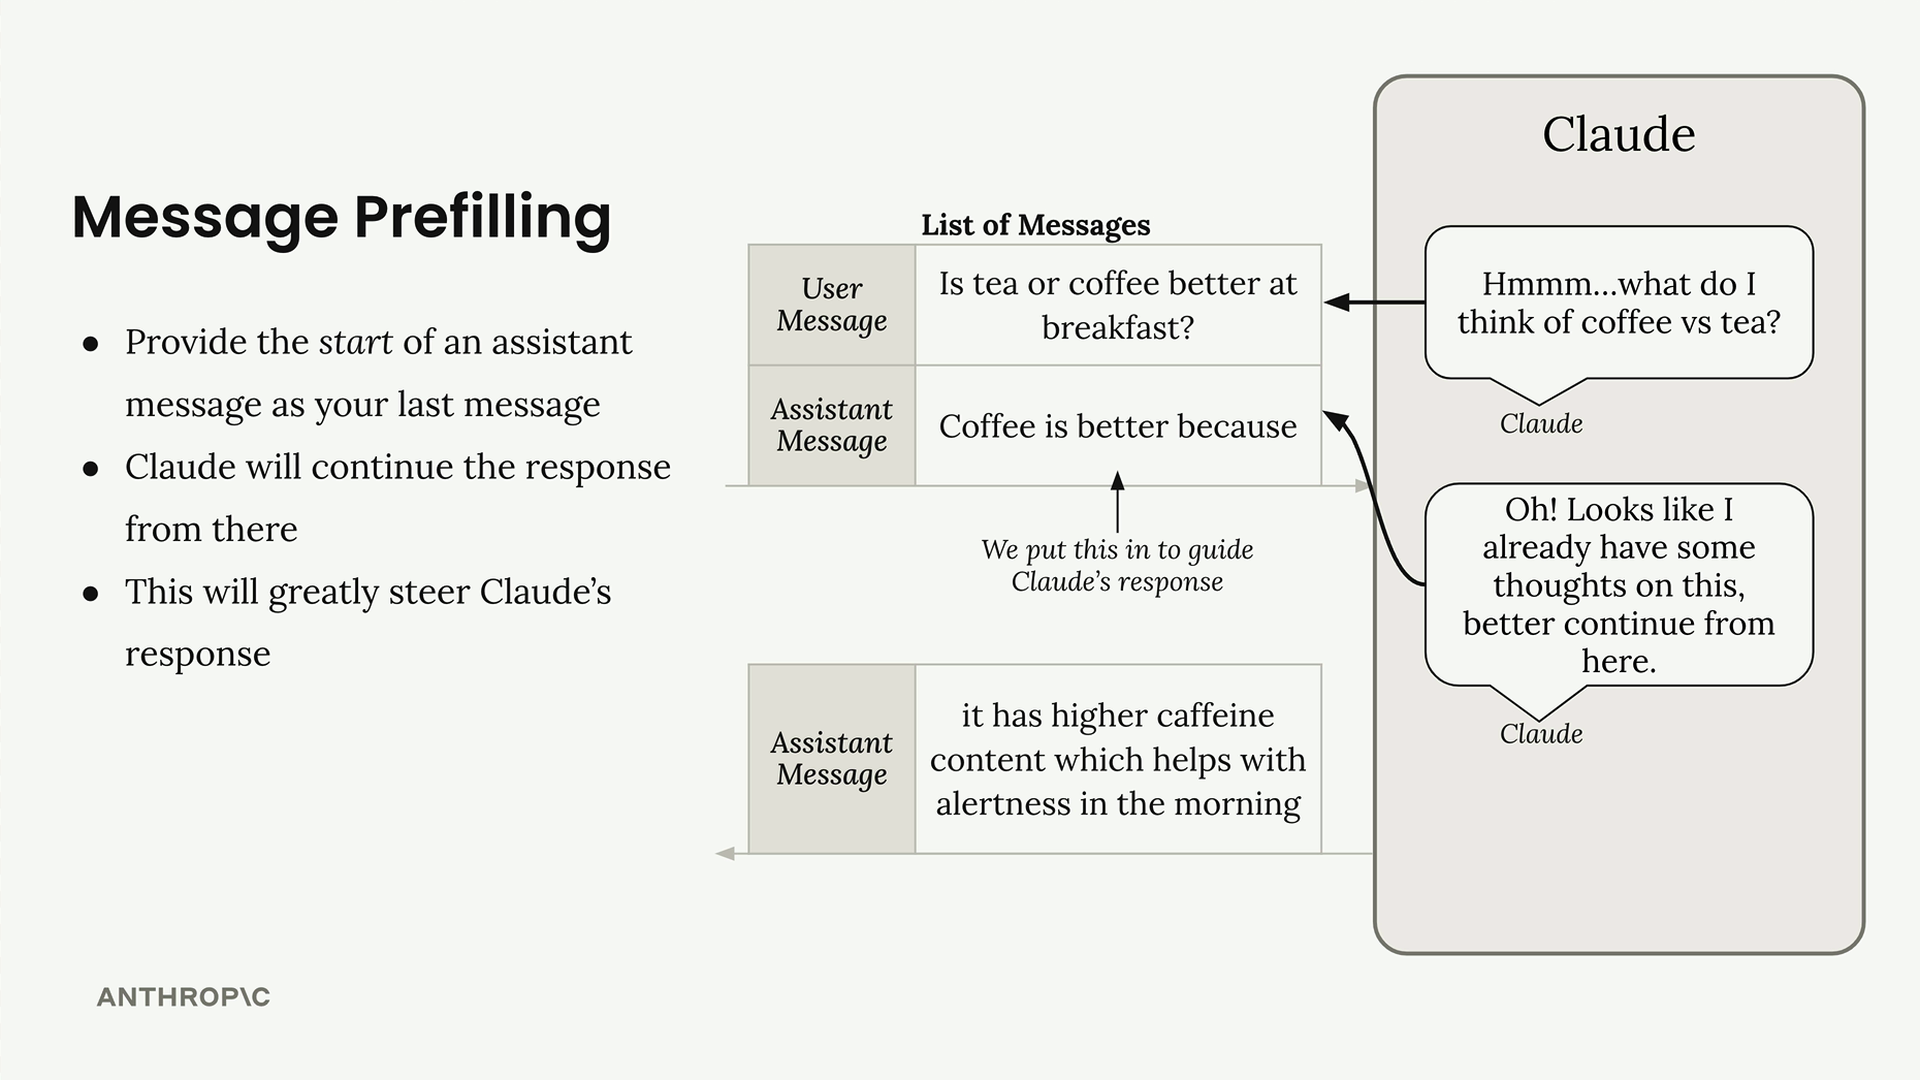
Por ejemplo, si preguntas "¿Es mejor el té o el café en el desayuno?" y prellenas con "El café es mejor porque", Claude continuará desde ese punto y construirá una respuesta a favor del café. La idea clave es que Claude continuará exactamente desde donde termina tu texto prellenado; no repetirá lo que ya escribiste.
Veamos esto en la práctica:
messages = []
add_user_message(messages, "Is coffee or tea better for breakfast?")
add_assistant_message(messages, "Coffee is better because")

chat(messages)
Esto devuelve algo como "tiene más cafeína." Observa que Claude continúa directamente desde tu texto prellenado, por lo que necesitarás combinar ambas partes para obtener la respuesta completa: "El café es mejor porque tiene más cafeína."
Puedes orientar a Claude en cualquier dirección cambiando tu texto prellenado:
"El té es mejor porque"- orienta hacia el té"Son iguales porque"- crea una respuesta neutral
Secuencias de parada
Las secuencias de parada obligan a Claude a finalizar su respuesta inmediatamente cuando genera un texto específico. Esto es útil cuando quieres truncar la salida en un punto particular o evitar que Claude continúe más allá de un marcador determinado.
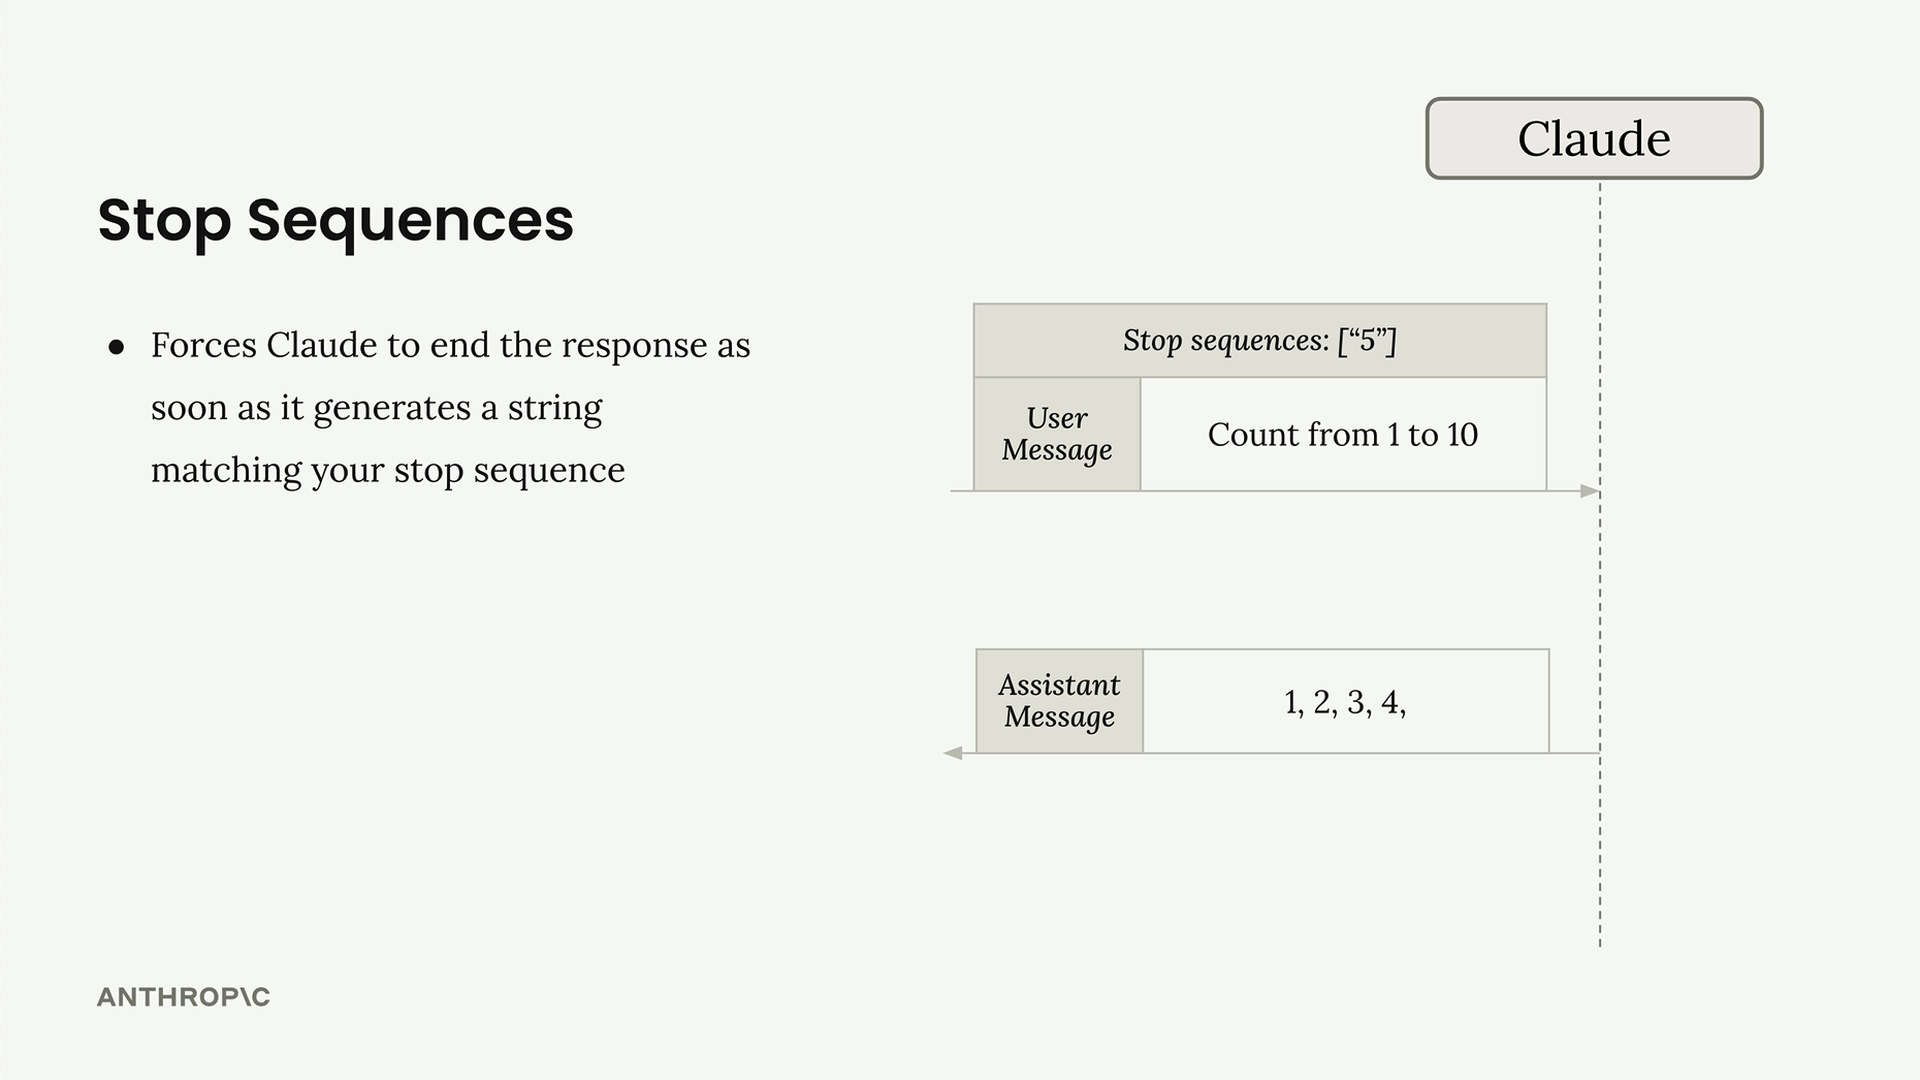
El concepto es sencillo: proporcionas una lista de cadenas de texto, y en cuanto Claude genera cualquiera de esas cadenas, se detiene y devuelve lo que haya generado hasta ese momento. La secuencia de parada en sí no se incluye en la respuesta.
Para usar secuencias de parada, necesitas modificar tu función de chat para que las acepte como parámetro:
def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "modelId": model_id,
        "messages": messages,
        "inferenceConfig": {
            "temperature": temperature,
            "stopSequences": stop_sequences
        },
    }
Aquí tienes un ejemplo práctico:
messages = []
add_user_message(messages, "Count from 1 to 10")

chat(messages, stop_sequences=["5"])
Esto devuelve "1, 2, 3, 4," y se detiene antes de incluir el "5". Puedes especificar múltiples secuencias de parada, y Claude se detendrá en la que encuentre primero:
chat(messages, stop_sequences=["5", "3, 4"])Las secuencias de parada son particularmente útiles para:
- Controlar la longitud de las respuestas
- Detenerse en puntos de quiebre naturales dentro de una salida estructurada
- Evitar que Claude continúe más allá de marcadores o delimitadores específicos
Ambas técnicas te dan un control detallado sobre el comportamiento de Claude, permitiéndote moldear las respuestas de maneras que el simple prompting por sí solo no puede lograr.