El pensamiento extendido es la función avanzada de Claude que le da al modelo tiempo para razonar a través de problemas complejos antes de generar una respuesta final. Piensa en ello como el monólogo interno de Claude: puedes ver cómo aborda tu problema paso a paso.
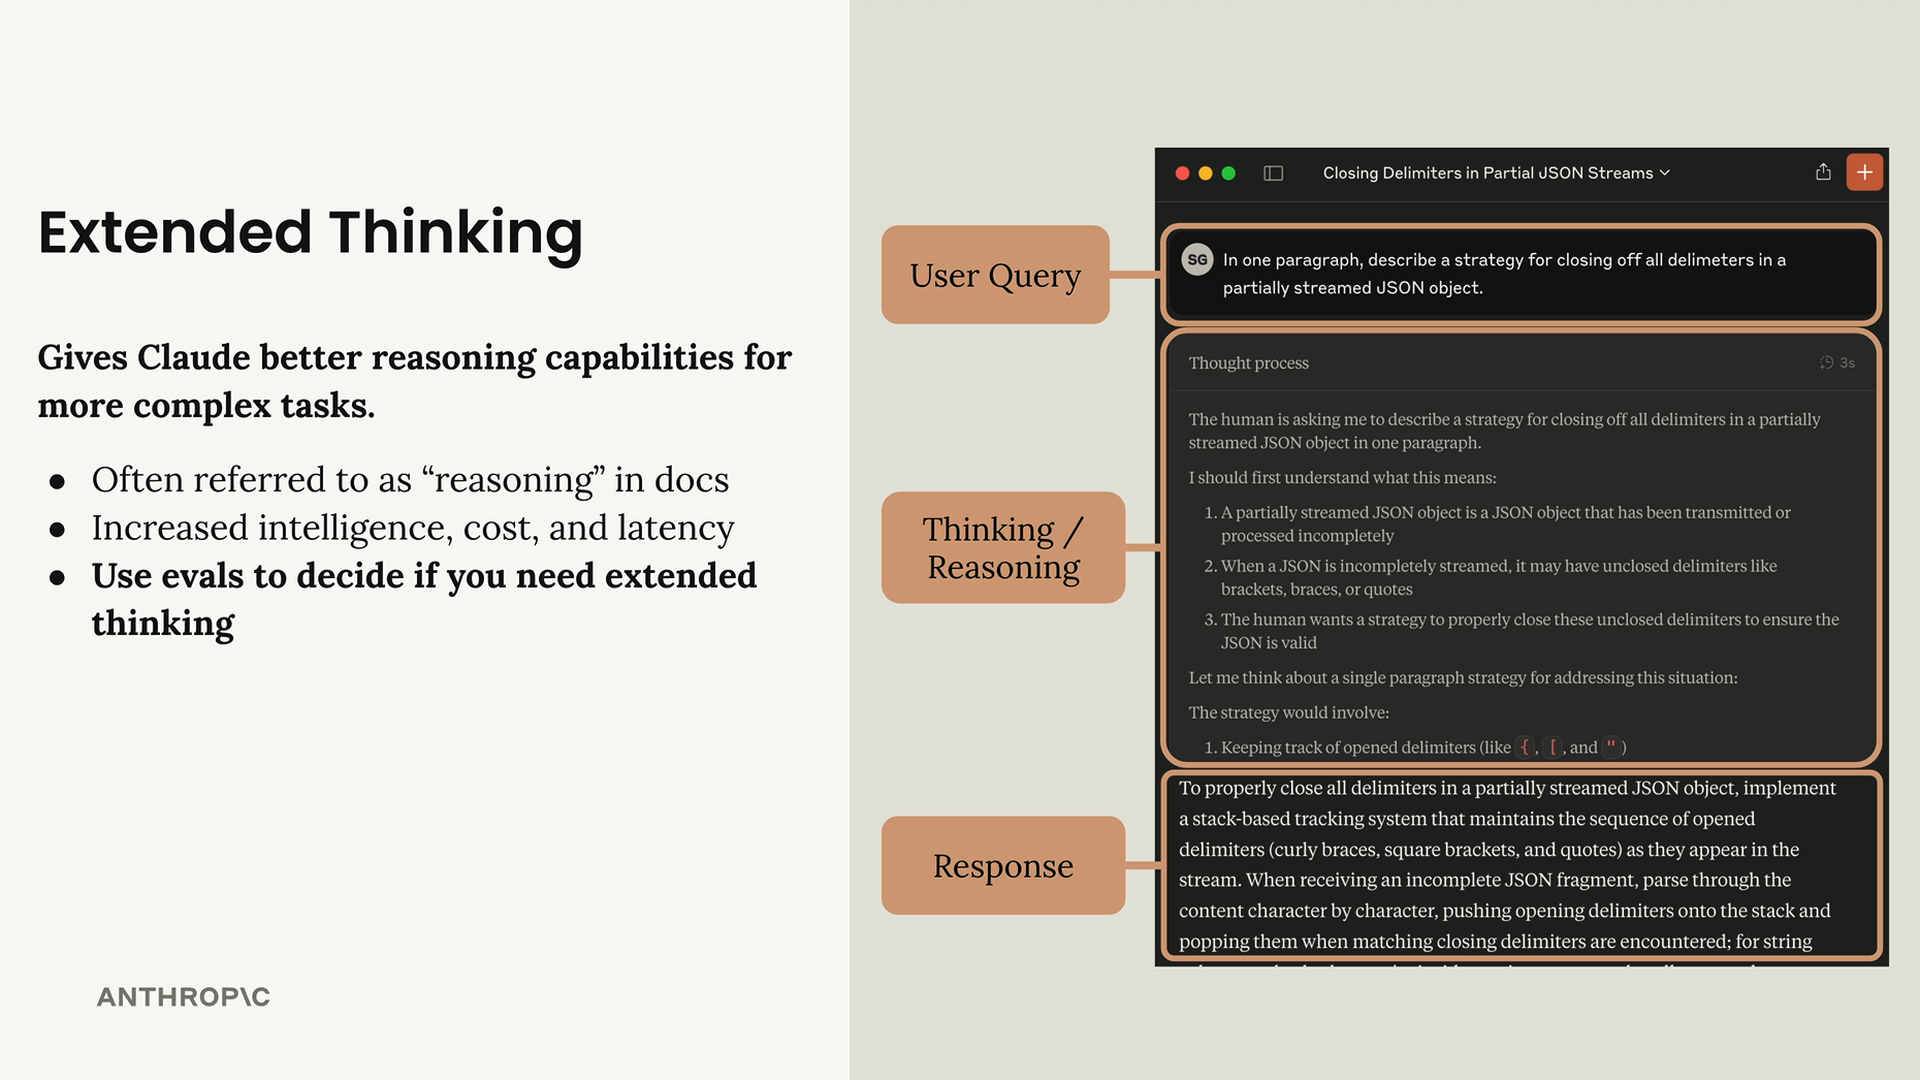
Cómo funciona el pensamiento extendido
Cuando habilitas el pensamiento extendido, la respuesta de Claude incluye dos partes en lugar de una:
- Parte de contenido de razonamiento - El proceso de pensamiento interno de Claude
- Parte de texto - La respuesta final que realmente querías
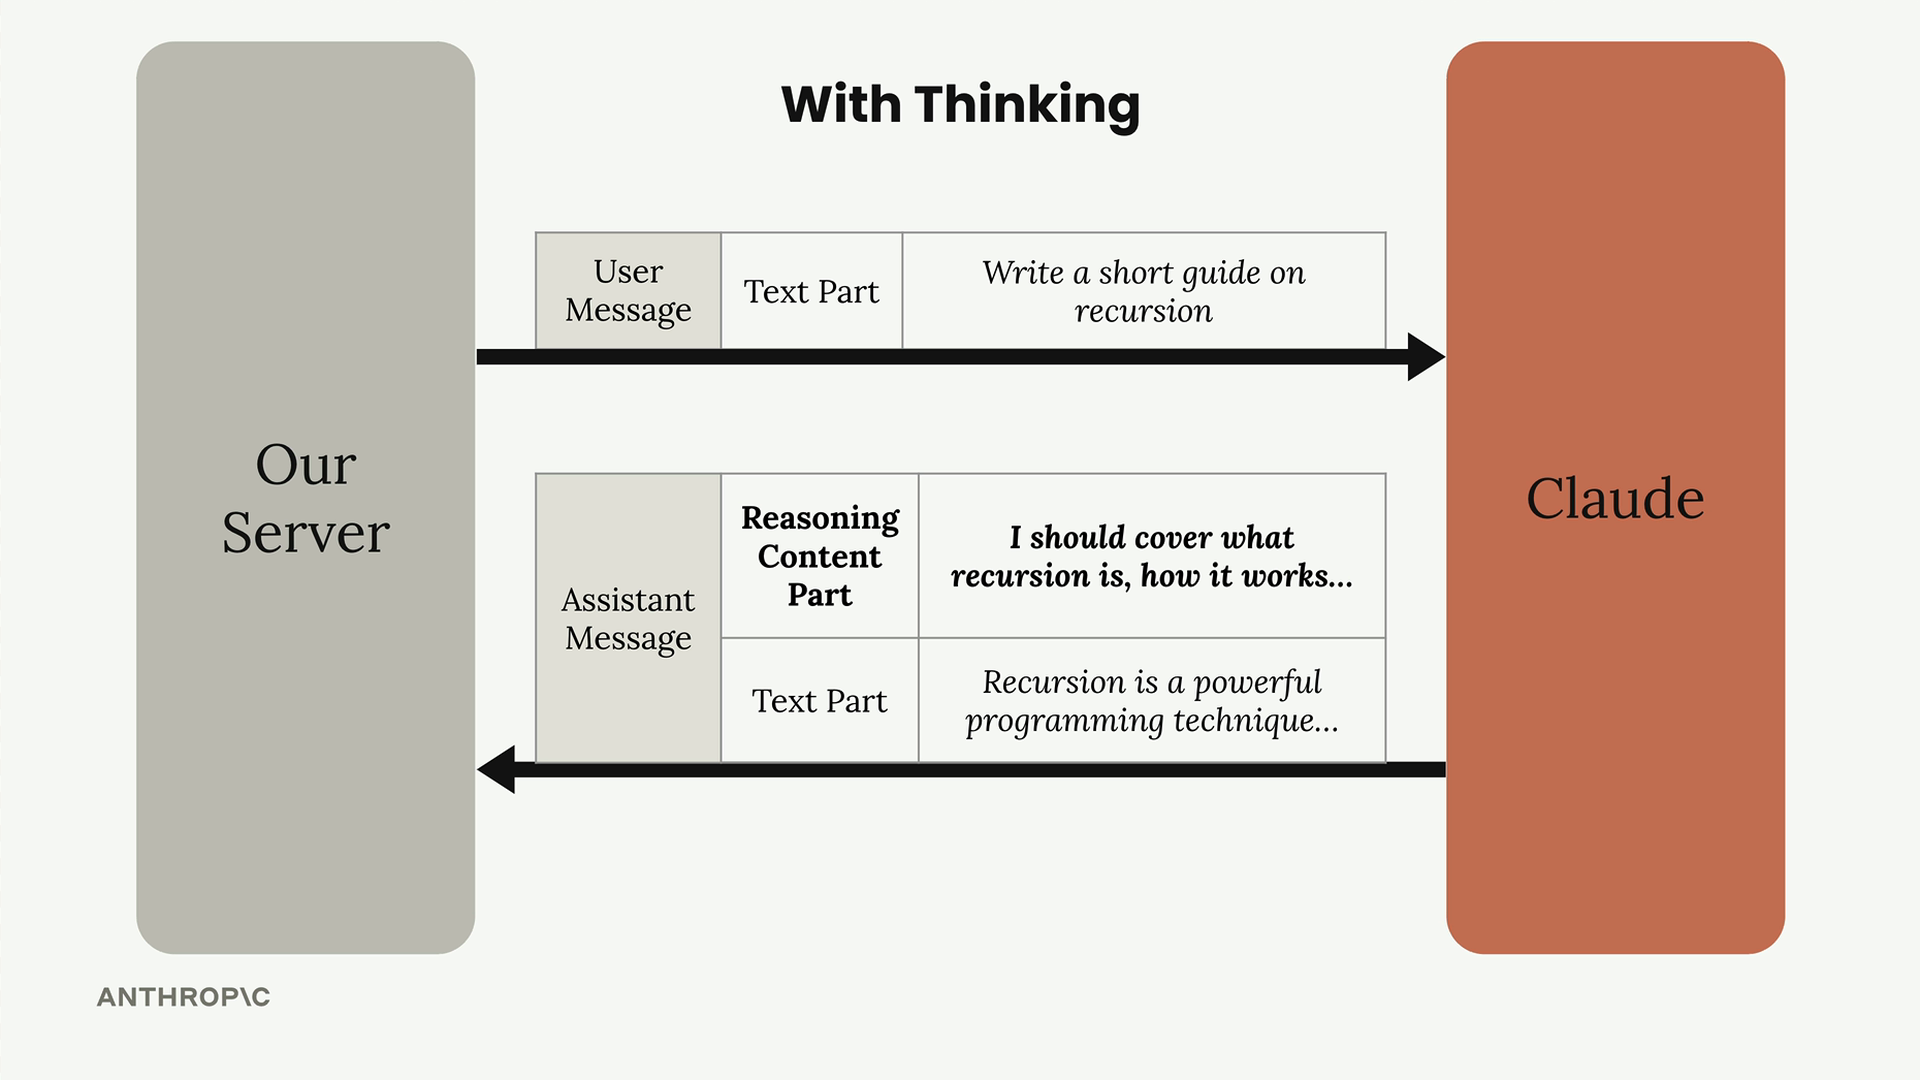
El contenido de razonamiento te muestra exactamente cómo Claude descompone tu problema, qué considera y cómo llega a su respuesta final. Esta transparencia puede ser increíblemente valiosa para entender y depurar tareas complejas.
Compensaciones a considerar
El pensamiento extendido viene con beneficios y costos claros:
- Mejor precisión en tareas complejas
- Mayor costo - pagas por todos los tokens de pensamiento
- Mayor latencia - pensar toma tiempo
El punto de decisión clave es simple: usa tus evaluaciones. Si ya has optimizado tu indicación pero aún no obtienes la precisión que necesitas, es entonces cuando el pensamiento extendido se vuelve digno de considerar.
El sistema de firma
Un detalle importante que notarás de inmediato es la firma criptográfica adjunta al contenido de razonamiento:
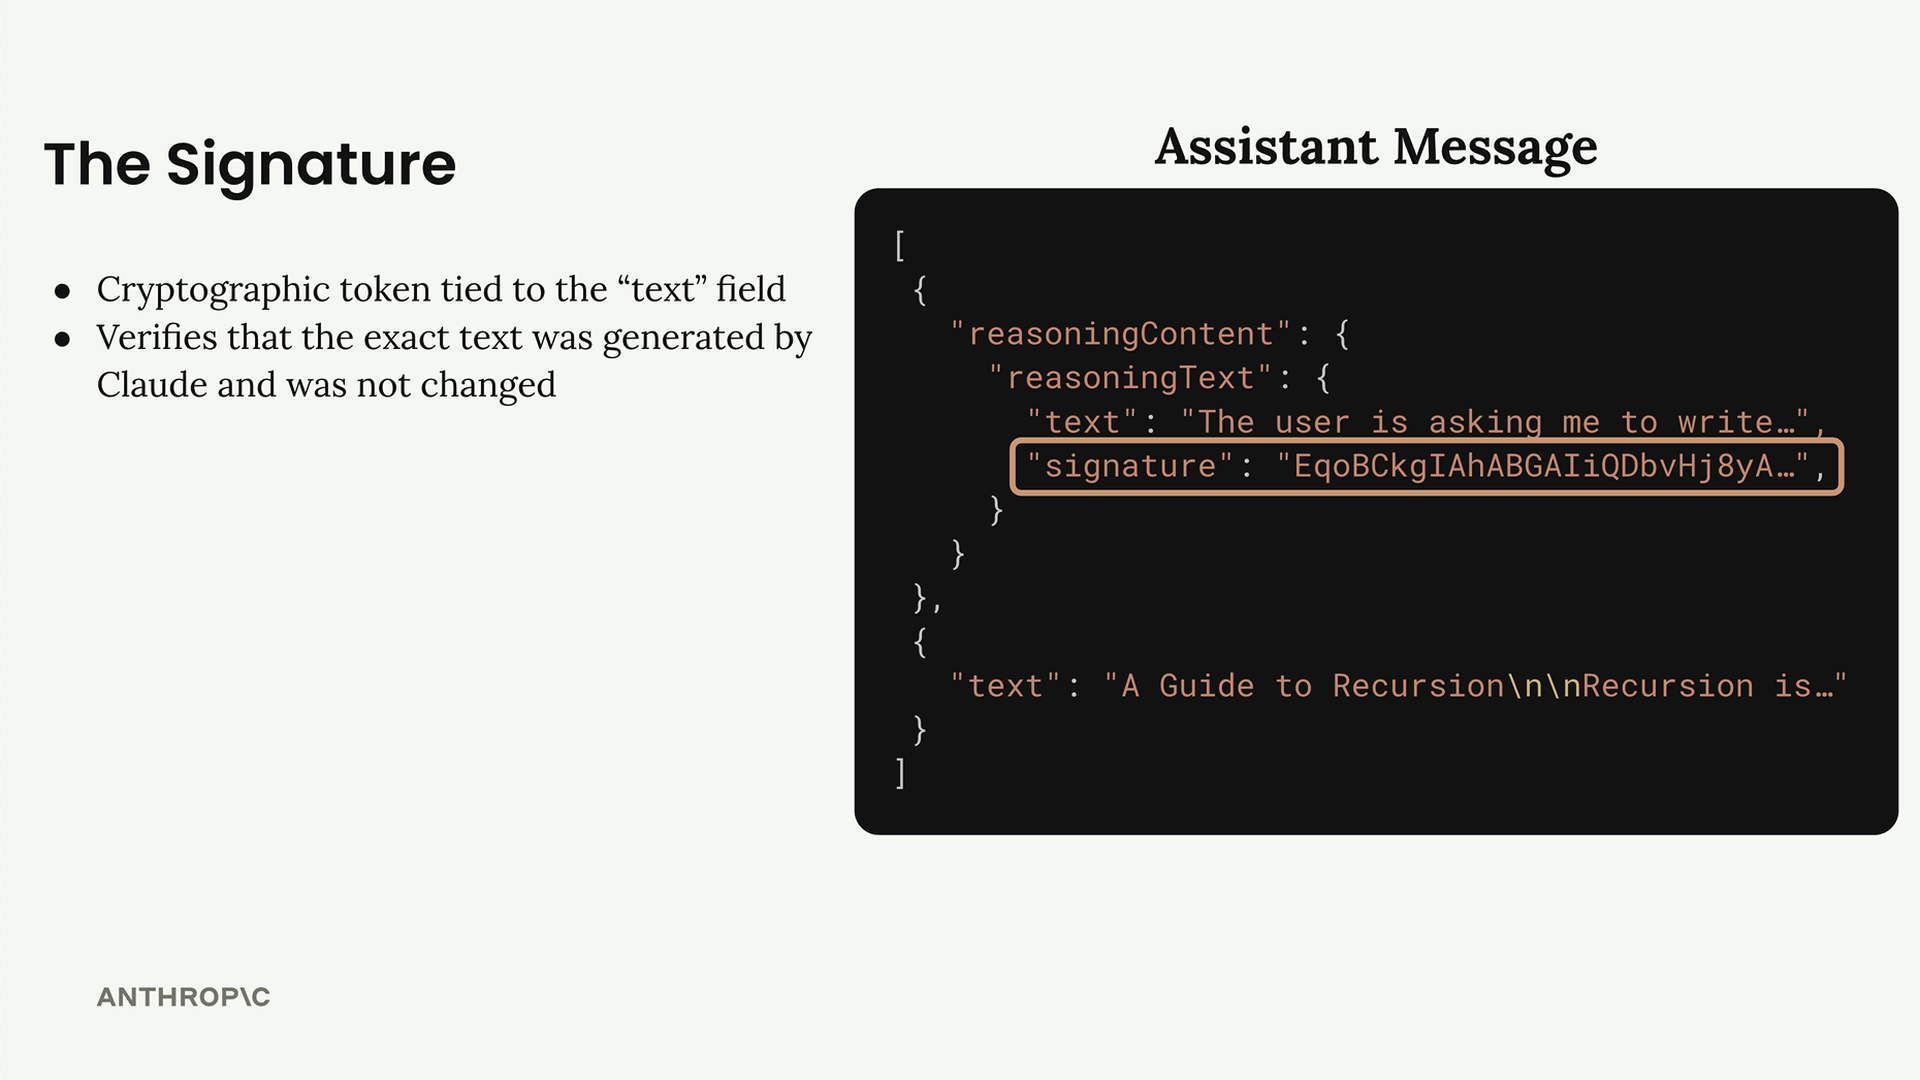
Esta firma garantiza que no puedas modificar el texto de pensamiento. Si quieres incluir el razonamiento previo de Claude en una conversación de seguimiento, la firma verifica que el contenido no haya sido manipulado. Esto previene posibles problemas de seguridad derivados de texto de razonamiento modificado.
Contenido redactado
A veces el pensamiento de Claude es marcado por los sistemas de seguridad. Cuando esto sucede, recibirás un campo redactedContent en lugar de texto de pensamiento legible:
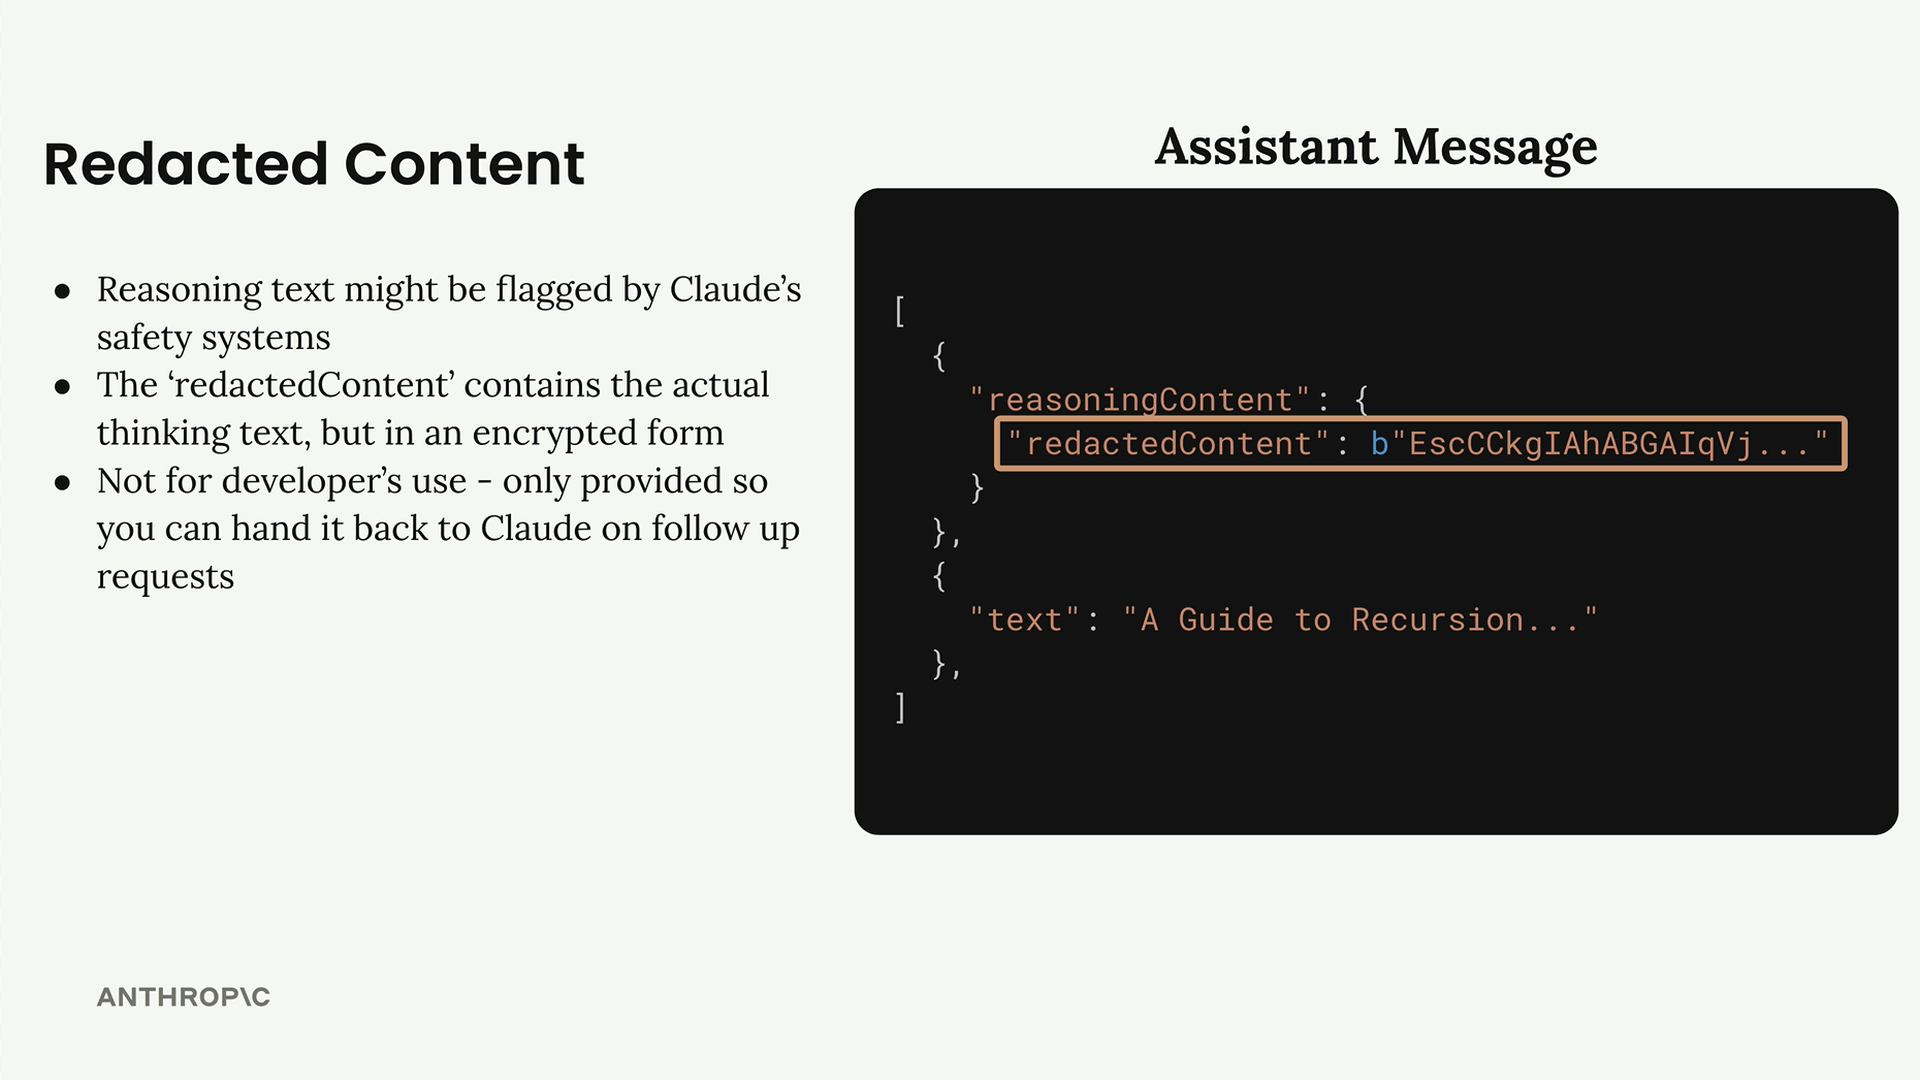
El contenido redactado está cifrado pero sigue siendo funcional: puedes devolvérselo a Claude en conversaciones futuras sin perder contexto. Simplemente no es legible para ti como desarrollador.
Implementación
En los modelos actuales de Claude, como Claude Opus 5 y Claude Sonnet 5, el pensamiento se ejecuta como pensamiento adaptativo y está activado por defecto: Claude decide cuánto razonamiento necesita cada solicitud, sin presupuesto de tokens que gestionar. Estos modelos omiten el texto de razonamiento a menos que lo solicites, así que configura display en summarized para verlo:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
Con el pensamiento adaptativo activado, las preguntas simples suelen responderse rápidamente mientras que las más difíciles obtienen más tiempo de razonamiento. Para guiar cuánto piensa Claude, puedes combinar el pensamiento adaptativo con el parámetro effort. El nivel de esfuerzo actúa como una guía suave para la asignación de pensamiento de Claude, y ocupa el lugar del presupuesto manual de tokens que de otro modo tendrías que gestionar.
Si has usado el pensamiento extendido antes, ten en cuenta que la configuración manual se está eliminando gradualmente: thinking.type: "enabled" con budget_tokens está obsoleto en Claude Opus 4.6 y Claude Sonnet 4.6, y Claude Opus 4.7 y modelos posteriores, incluyendo Claude Opus 5 y Claude Sonnet 5, no lo admiten y rechazan dichas solicitudes con un error 400. Usa thinking.type: "adaptive" con el parámetro effort en su lugar.
Modelos sin pensamiento adaptativo
Los modelos Claude 4.5 (Claude Haiku 4.5, Claude Sonnet 4.5 y Claude Opus 4.5) y modelos anteriores no admiten el pensamiento adaptativo. En esos modelos habilitas el pensamiento extendido con un presupuesto manual de tokens:
additional_model_fields["thinking"] = {
    "type": "enabled",
    "budget_tokens": thinking_budget
}
El thinking_budget controla cuántos tokens puede gastar Claude en razonamiento. El mínimo es 1024 tokens, pero podrías necesitar más para problemas complejos. Como con todo lo demás en Claude, usa tus evaluaciones para encontrar el presupuesto adecuado para tu caso de uso.
Así es como se ve la función de chat actualizada:
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    tool_choice="auto",
    text_editor=None,
    thinking=False,
    thinking_budget=1024
):
Probando tu implementación
Al construir aplicaciones que manejan pensamiento extendido, querrás probar tanto escenarios de contenido de razonamiento normal como de contenido redactado. De hecho, existe una cadena de prueba especial que obliga a Claude a devolver contenido redactado, útil para asegurarte de que tu código maneje ambos casos correctamente.
La conclusión más importante sobre el pensamiento extendido es que la decisión de usarlo siempre debe basarse en datos. Ejecuta tus evaluaciones primero, optimiza tus indicaciones y solo entonces considera el pensamiento extendido si necesitas ese impulso adicional en precisión para tareas complejas. Esa disciplina se basa en un hábito simple: decide cómo se ve el éxito antes de recurrir a más capacidad. Cuando sabes la precisión que tu tarea necesita, puedes saber si el pensamiento extendido justifica su costo en lugar de adivinar.
Práctica: ejecuta el pensamiento adaptativo tú mismo
El pensamiento adaptativo se entiende más fácilmente observándolo tomar decisiones. En el código donde has estado construyendo la función de chat, actívalo:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
Ahora envía dos solicitudes a través de esta misma configuración. Primero haz una pregunta factual rápida cuya respuesta ya conoces. Luego haz una genuinamente difícil, como un problema de análisis de varios pasos de tu propio trabajo. Si estás trabajando con un modelo que no admite el pensamiento adaptativo, habilita el pensamiento con la configuración manual de budget_tokens de la sección anterior y ejecuta las mismas dos solicitudes.
Verifica qué hizo el pensamiento
Activar la bandera solo demuestra que la solicitud fue aceptada. Estas verificaciones te dicen qué hizo el pensamiento:
- Confirma que el pensamiento se activó. Cada respuesta ahora debería contener dos partes, el contenido de razonamiento y el texto final, en lugar de solo texto. La única excepción es el contenido redactado, que viste antes: un campo
redactedContentsignifica que el pensamiento se ejecutó pero el texto está cifrado. - Lee el contenido de razonamiento. Verifica que realmente razone sobre la pregunta que hiciste en lugar de simplemente repetirla. Esta es la misma transparencia en la que confiarás al depurar tareas complejas más adelante.
- Compara las dos solicitudes. La pregunta simple normalmente volverá rápidamente con poco razonamiento, mientras que la difícil obtiene notablemente más. Esa diferencia es el pensamiento adaptativo tomando la decisión de asignación por ti.
- Sopesa el costo. Pagas por cada token de pensamiento, así que verifica si la respuesta más difícil es mejor que lo que obtienes sin pensamiento. Tus evaluaciones son el juez de eso, y ver aparecer el texto de razonamiento no es un sustituto de ellas.
El comportamiento que vale la pena conservar de esta lección: cada vez que habilites el pensamiento extendido en una tarea nueva, lee el contenido de razonamiento en algunas solicitudes representativas y vuelve a ejecutar tus evaluaciones antes de decidir si la configuración se mantiene.