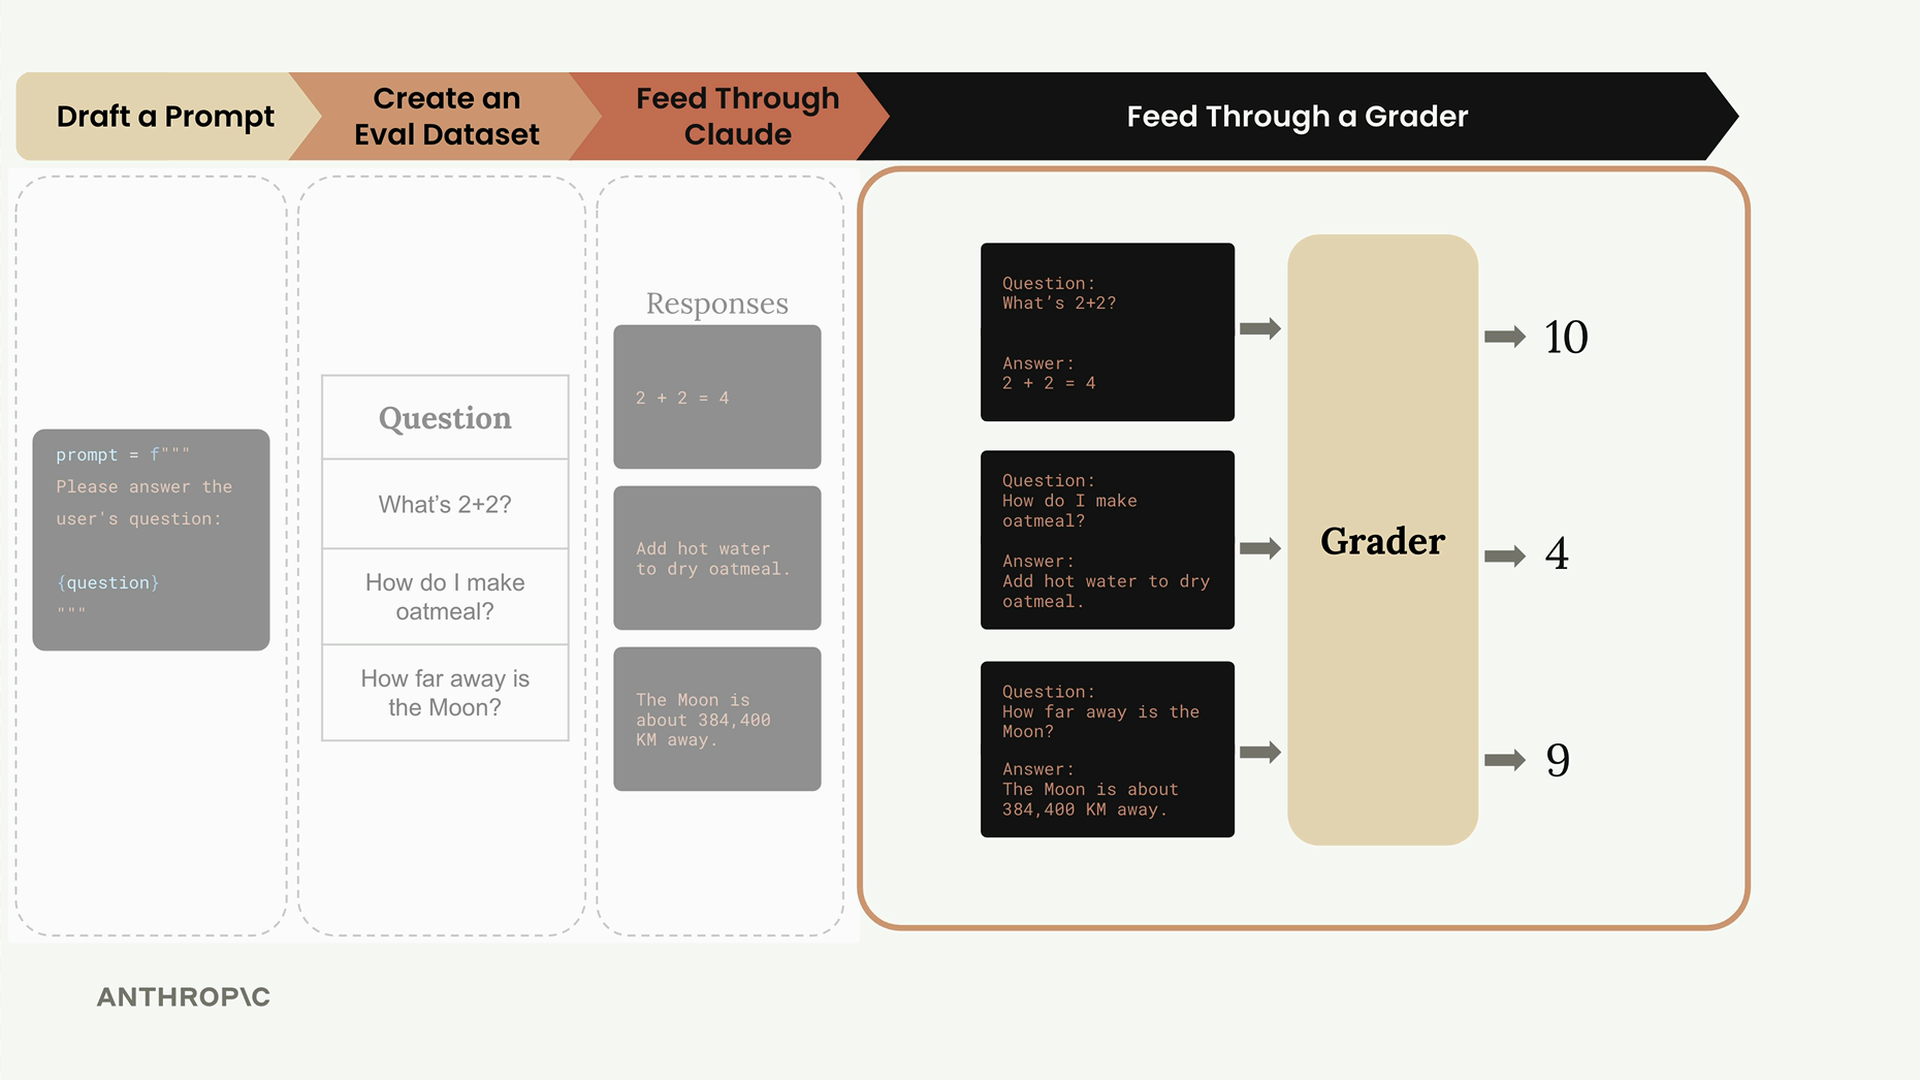
Ahora que tenemos nuestro conjunto de datos de evaluación listo, es momento de construir el pipeline de evaluación principal. Esto implica tomar cada caso de prueba, combinarlo con nuestro prompt, enviarlo a Claude y luego calificar los resultados.
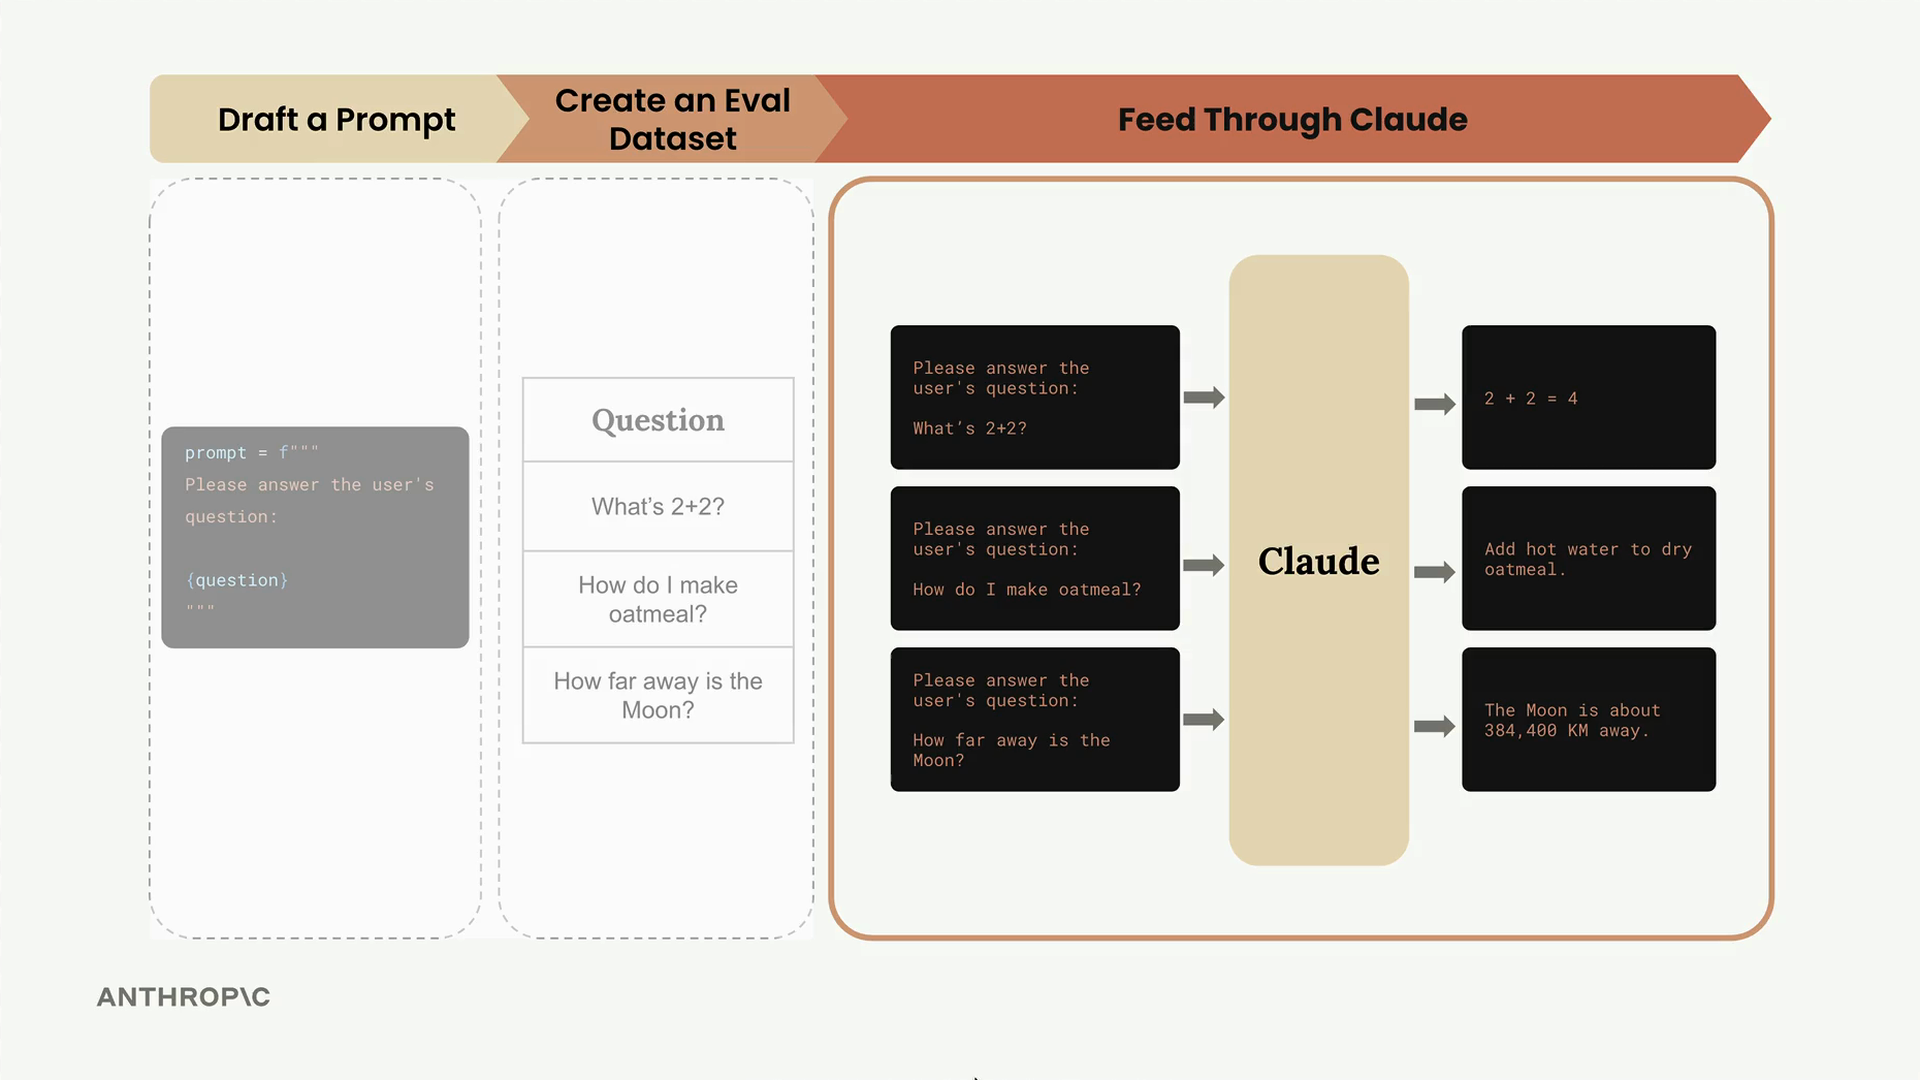
El proceso de evaluación sigue un flujo de trabajo claro: tomamos nuestro conjunto de datos de casos de prueba, combinamos cada uno con nuestra plantilla de prompt, lo enviamos a Claude para su procesamiento y luego evaluamos el resultado usando un sistema de calificación.
Construyendo las funciones principales
El pipeline de evaluación consta de tres funciones principales, cada una con una responsabilidad específica. Comencemos con la más simple: la función que maneja la ejecución de prompts individuales.
La función run_prompt
Esta función toma un caso de prueba y lo combina con nuestra plantilla de prompt:
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
Por ahora, mantenemos el prompt extremadamente simple. No estamos incluyendo ninguna instrucción de formato, lo que significa que Claude probablemente devolverá una salida más extensa de lo que necesitamos. Refinaremos esto más adelante mientras iteramos en nuestro proceso de evaluación.
La función run_test_case
Esta función orquesta la ejecución de un solo caso de prueba y la calificación del resultado:
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - Calificación
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
Por ahora, estamos usando una puntuación fija de 10. La lógica de calificación es donde dedicaremos tiempo significativo en las próximas secciones, pero este marcador de posición nos permite probar la estructura general del pipeline.
La función run_eval
Este es el orquestador principal que procesa todo el conjunto de datos:
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
Esta función recorre cada caso de prueba en nuestro conjunto de datos, procesa cada uno y recopila todos los resultados en una sola lista.
Ejecutando la evaluación
Para ejecutar nuestro pipeline de evaluación, cargamos el conjunto de datos y llamamos a nuestra función principal:
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
La primera vez que ejecutes esto, espera que tome algo de tiempo; incluso con Claude Haiku, procesar un conjunto de datos completo puede tardar más de 30 segundos. Cubriremos técnicas de optimización más adelante, pero por ahora, la paciencia es clave.
Examinando los resultados
Una vez que la evaluación se completa, puedes inspeccionar los resultados con una salida JSON formateada:
print(json.dumps(results, indent=2))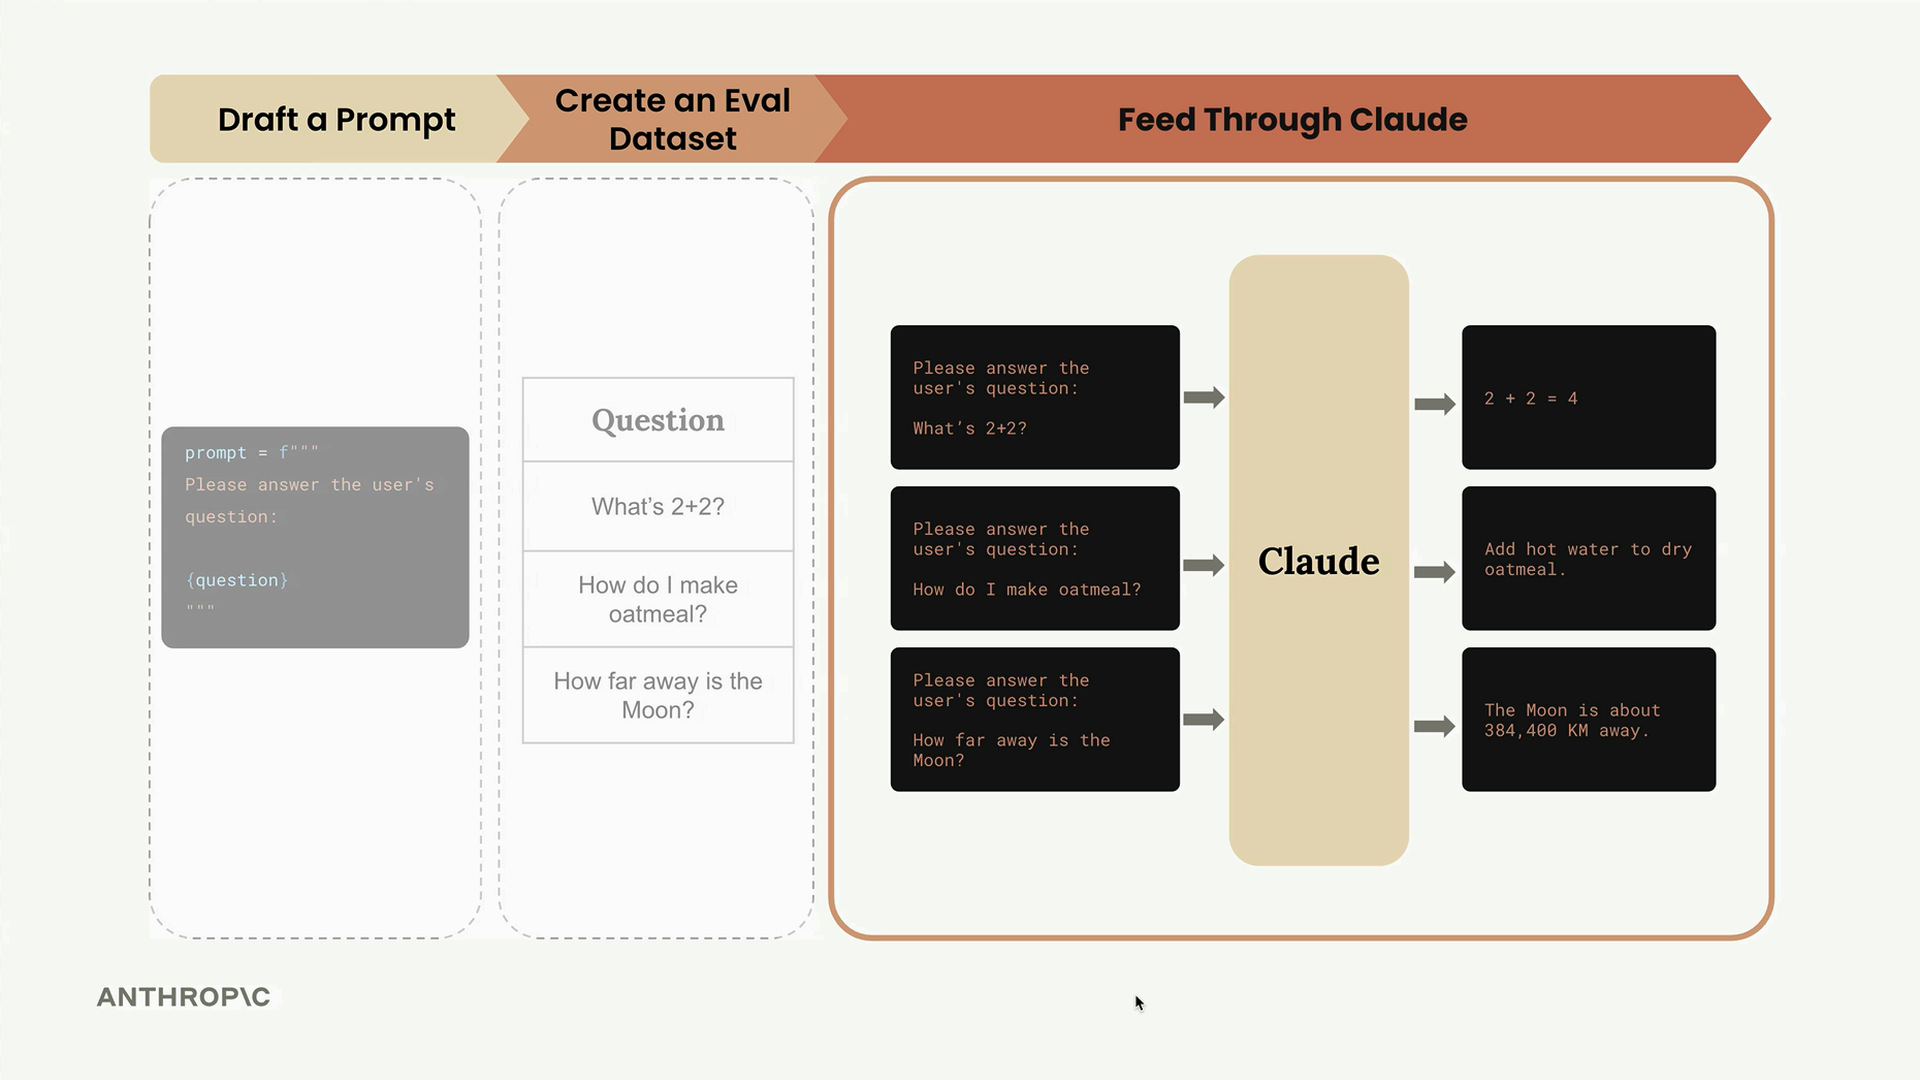
La estructura de resultados contiene un arreglo de objetos, donde cada objeto representa la ejecución de un caso de prueba. Verás la salida de Claude (que tiende a ser bastante extensa sin restricciones de formato), la definición original del caso de prueba y la puntuación.
Lo que hemos logrado
En este punto, hemos implementado con éxito el pipeline de evaluación principal. Podemos:
- Tomar casos de prueba de nuestro conjunto de datos
- Combinarlos con plantillas de prompt
- Obtener respuestas de Claude
- Recopilar y organizar todos los resultados
La pieza que falta es la calificación inteligente: en este momento solo estamos asignando una puntuación fija a cada respuesta. El siguiente paso es construir calificadores que realmente puedan evaluar si las salidas de Claude son correctas, que es donde entra en juego la verdadera sofisticación de los sistemas de evaluación.
Esta estructura de pipeline puede parecer simple, pero representa la base sobre la que se construyen la mayoría de los sistemas de evaluación de IA. La complejidad está en la lógica de calificación y la optimización de prompts, no en la orquestación básica de la ejecución de pruebas.