Nachdem ein Dokument in Chunks aufgeteilt wurde, besteht der nächste Schritt in einer RAG-Pipeline darin, herauszufinden, welche Chunks für die Frage eines Nutzers am relevantesten sind. Dies ist grundsätzlich ein Suchproblem - du musst alle deine Text-Chunks durchsuchen und diejenigen identifizieren, die sich auf das beziehen, wonach der Nutzer fragt.
Relevante Chunks finden
Die Herausforderung besteht darin, zu bestimmen, welche Chunks mit der Frage eines Nutzers „verwandt" sind. Das ist nicht so einfach wie ein Keyword-Abgleich - du musst die Bedeutung und den Kontext sowohl der Frage als auch der Chunks verstehen.
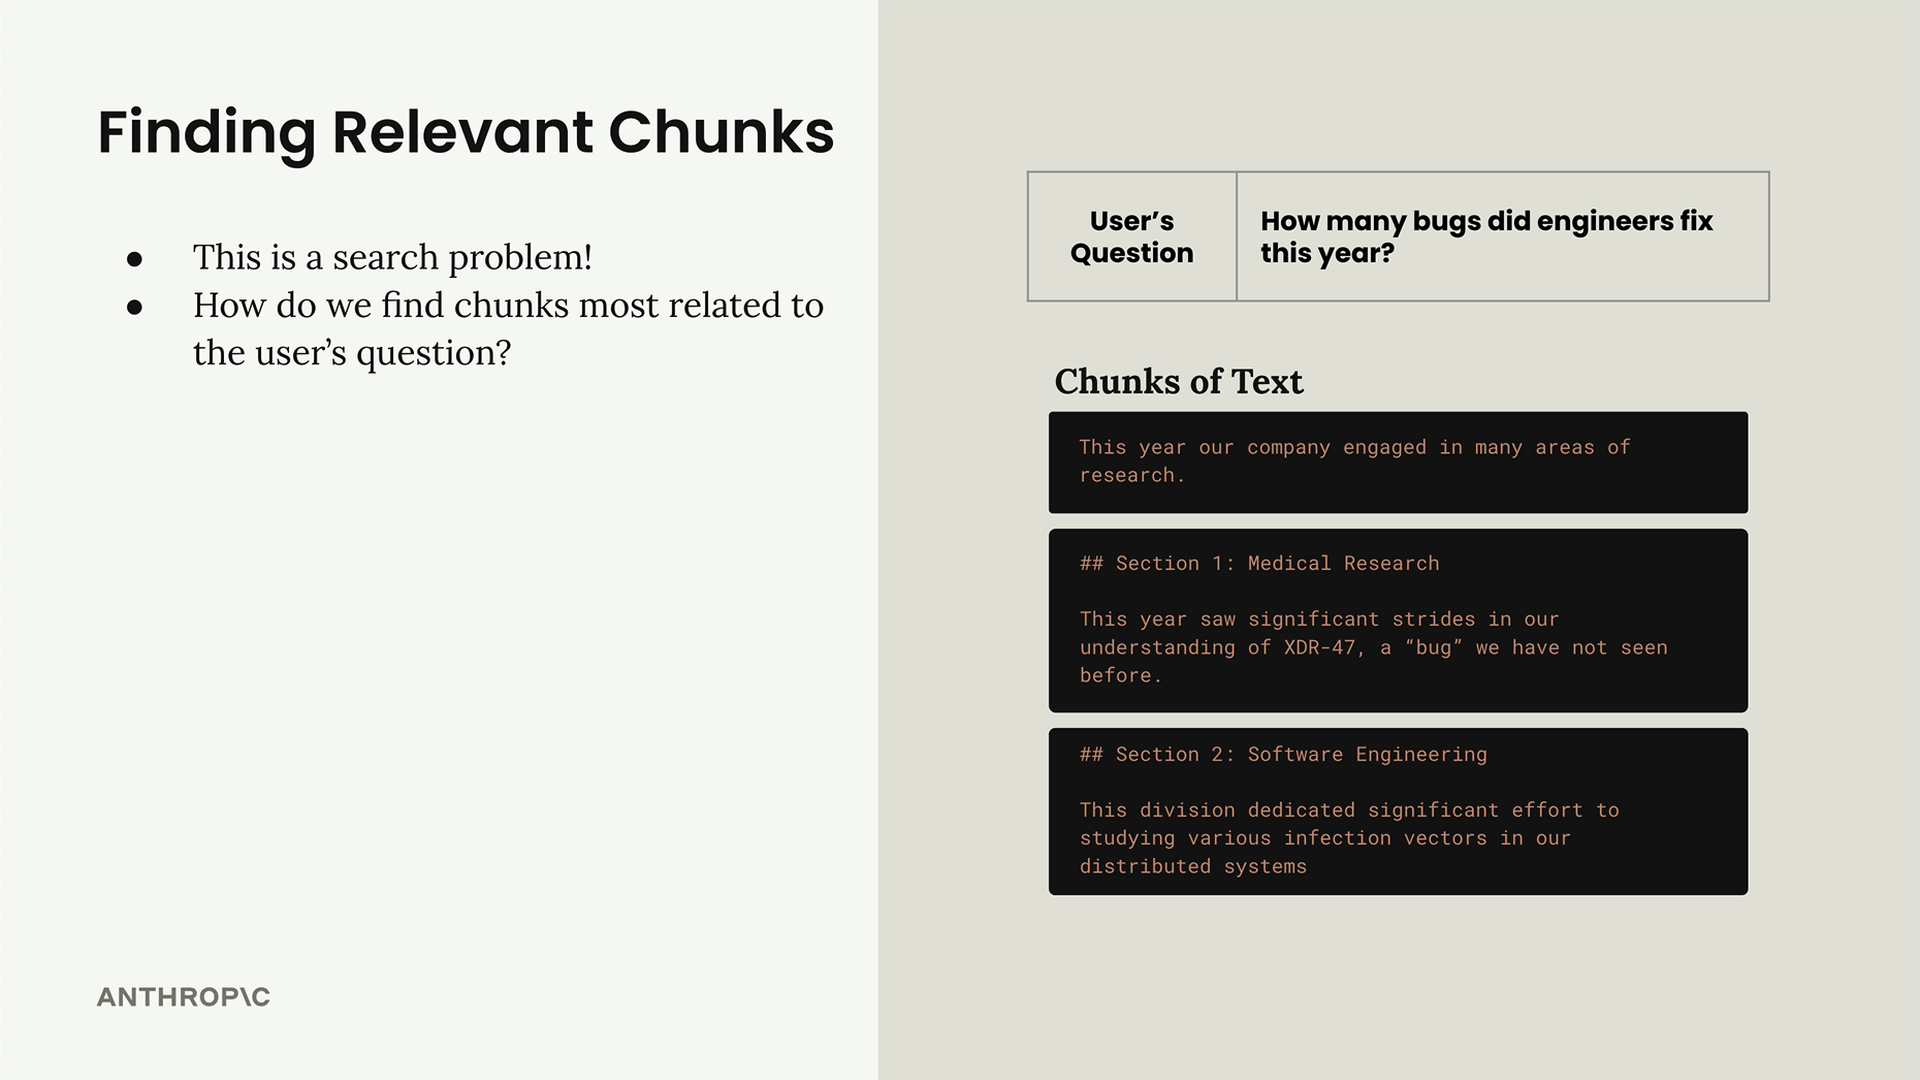
Die gängigste Lösung ist die semantische Suche, die Text-Embeddings verwendet, um zu verstehen, worum es in jedem Textabschnitt tatsächlich geht, anstatt nur nach exakten Wortübereinstimmungen zu suchen.
Was sind Text-Embeddings?
Ein Text-Embedding ist eine numerische Darstellung der Bedeutung, die in einem Text enthalten ist. Stell es dir vor wie die Umwandlung von Wörtern und Sätzen in ein Format, mit dem Computer mathematisch arbeiten können.
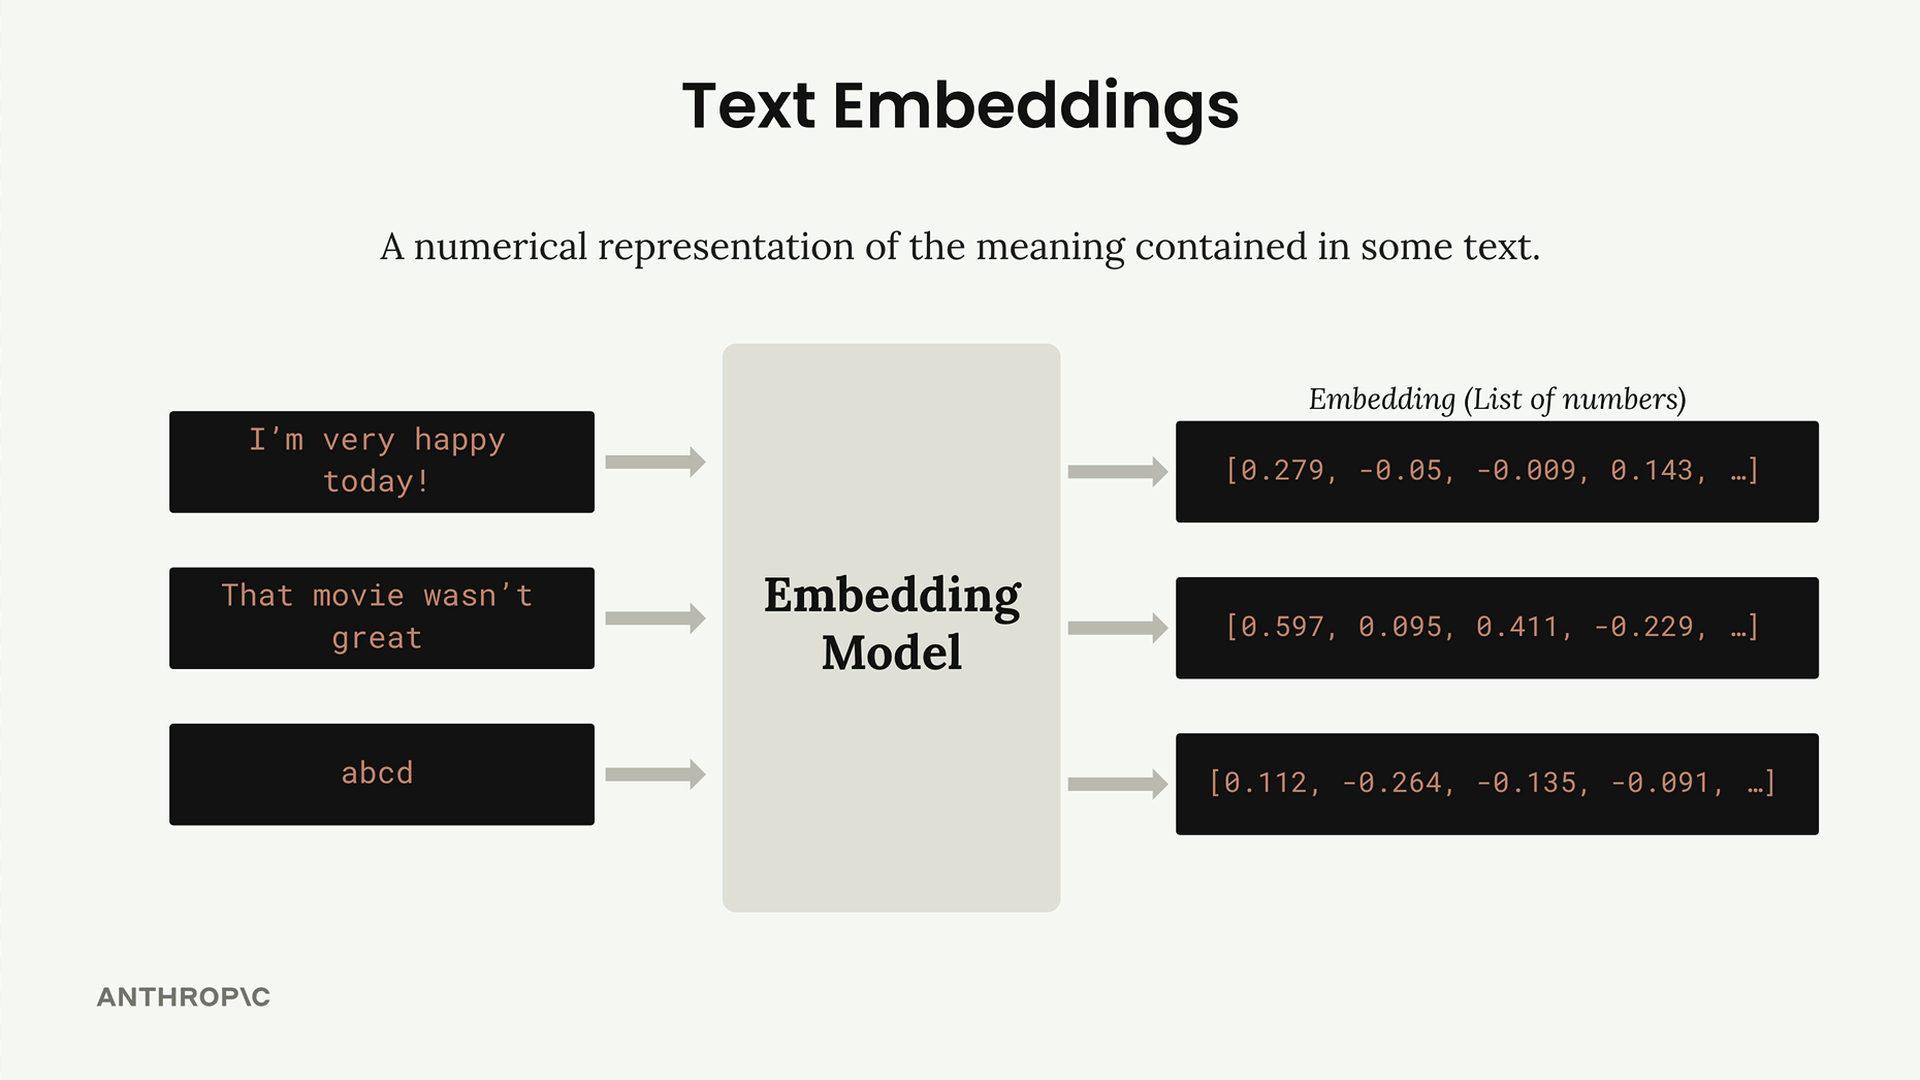
So funktioniert es:
- Du gibst Text in ein Embedding-Modell ein
- Das Modell gibt eine lange Liste von Zahlen aus (typischerweise 1024 Zahlen)
- Jede Zahl stellt einen „Score" für eine bestimmte Eigenschaft des Eingabetexts dar
- Die Zahlen liegen im Bereich von -1 bis +1
Die Zahlen verstehen
Jede Zahl in einem Embedding ist wie ein Score für einen bestimmten Aspekt des Texts. Obwohl wir nicht genau wissen, was jede Position repräsentiert, ist es hilfreich, sie sich als Messung unterschiedlicher Eigenschaften vorzustellen.
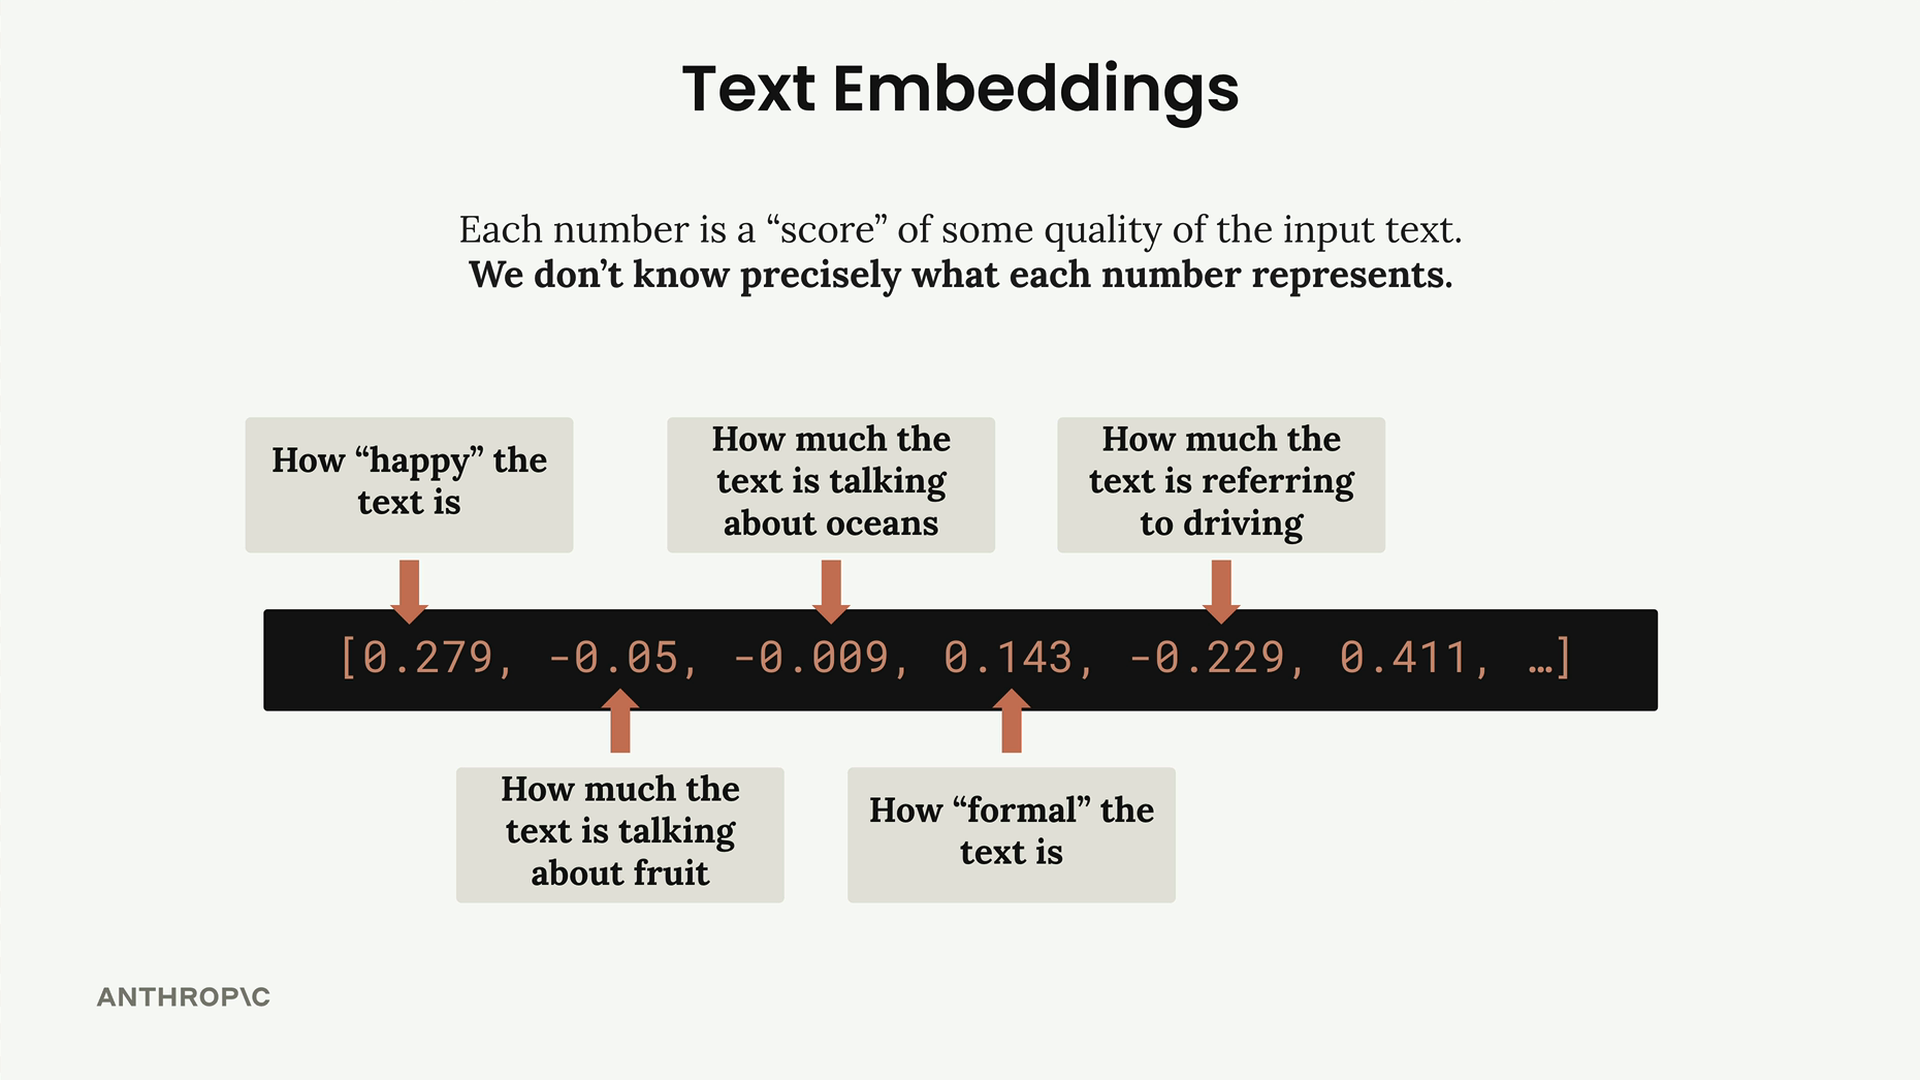
Zum Beispiel könnte eine Zahl bewerten, „wie fröhlich der Text ist", während eine andere messen könnte, „wie viel der Text über Ozeane spricht". Der entscheidende Punkt ist, dass wir eigentlich nicht wissen, was jede Zahl repräsentiert - das Embedding-Modell lernt diese Muster während des Trainings, und sie sind nicht menschlich interpretierbar.
Embeddings mit Code generieren
Das Erstellen von Embeddings ist unkompliziert. Hier ist der grundlegende Prozess:
def generate_embedding(
    text,
    embedding_model_id="amazon.titan-embed-text-v2:0",
    dimensions=1024,
    normalize=True,
):
    request_body = {
        "inputText": text,
        "dimensions": dimensions,
        "normalize": normalize,
    }

    request_json = json.dumps(request_body)
    response = client.invoke_model(
        modelId=embedding_model_id,
        body=request_json,
        accept="application/json",
        contentType="application/json",
    )

    response_body = json.loads(response.get("body").read())
    return response_body["embedding"]
Wenn du diese Funktion auf einen Text-Chunk anwendest, erhältst du eine Liste von 1024 Zahlen zurück, die die semantische Bedeutung dieses Texts darstellen.
Beachte, dass du möglicherweise Zugriff auf das Titan-Embedding-Modell in der AWS-Bedrock-Konsole anfordern musst. Wenn Version 2 nicht verfügbar ist, funktioniert Version 1 für Lernzwecke genauso gut.
Warum Embeddings für RAG wichtig sind
Die Stärke von Embeddings wird deutlich, wenn man erkennt, dass ähnliche Texte ähnliche Embedding-Werte haben. Das bedeutet, dass du die Frage eines Nutzers mathematisch mit deinen Dokument-Chunks vergleichen und die semantisch ähnlichsten finden kannst - selbst wenn sie nicht genau dieselben Wörter teilen.
Diese numerische Darstellung ist es, was semantische Suche ermöglicht und sie viel effektiver macht als einfacher Keyword-Abgleich, um relevanten Kontext in RAG-Systemen zu finden.