Ein typischer Workflow zur Prompt-Evaluierung folgt einem systematischen Ansatz, um deine Prompts objektiv zu messen und zu verbessern. Es gibt viele verschiedene Möglichkeiten, diese Workflows zusammenzustellen, und es stehen verschiedene Open-Source- und kostenpflichtige Tools zur Verfügung, aber das Verständnis des Kernprozesses hilft dir, klein anzufangen und bei Bedarf zu skalieren.
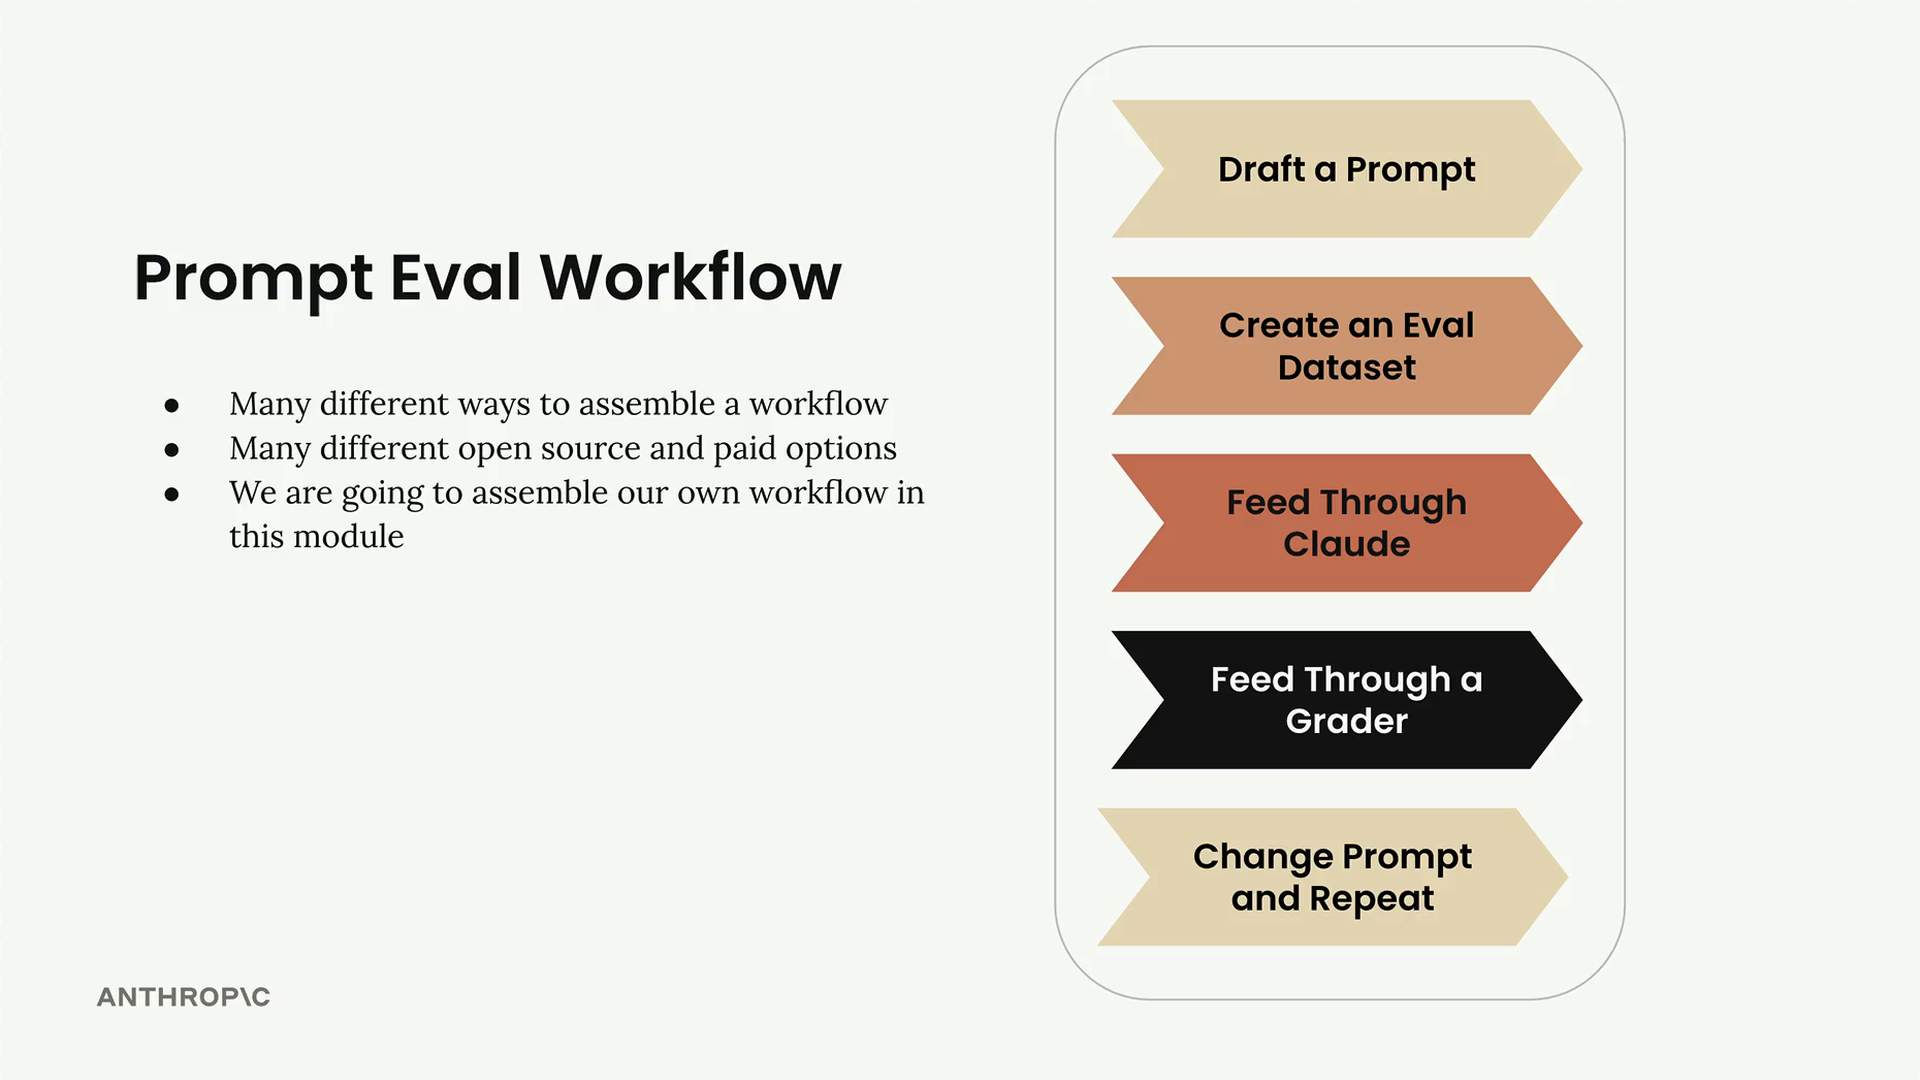
Schritt 1: Entwerfe deinen ersten Prompt
Beginne damit, einen einfachen Prompt zu schreiben, den du verbessern möchtest. Für dieses Beispiel verwenden wir eine einfache Prompt-Struktur:
prompt = f"""
Please answer the user's question:

{question}
"""
Das gibt uns eine Ausgangsbasis, mit der wir arbeiten können. Wir werden nicht wissen, ob er effektiv ist, bis wir ihn mit einer objektiven Methodik evaluieren.
Schritt 2: Erstelle einen Evaluierungsdatensatz
Dein Evaluierungsdatensatz enthält Beispiel-Eingaben, die du in deinen Prompt einspeisen wirst. Da unser Prompt nur eine Eingabe hat (die Frage des Nutzers), benötigen wir eine Sammlung verschiedener Fragen, mit denen wir testen können.
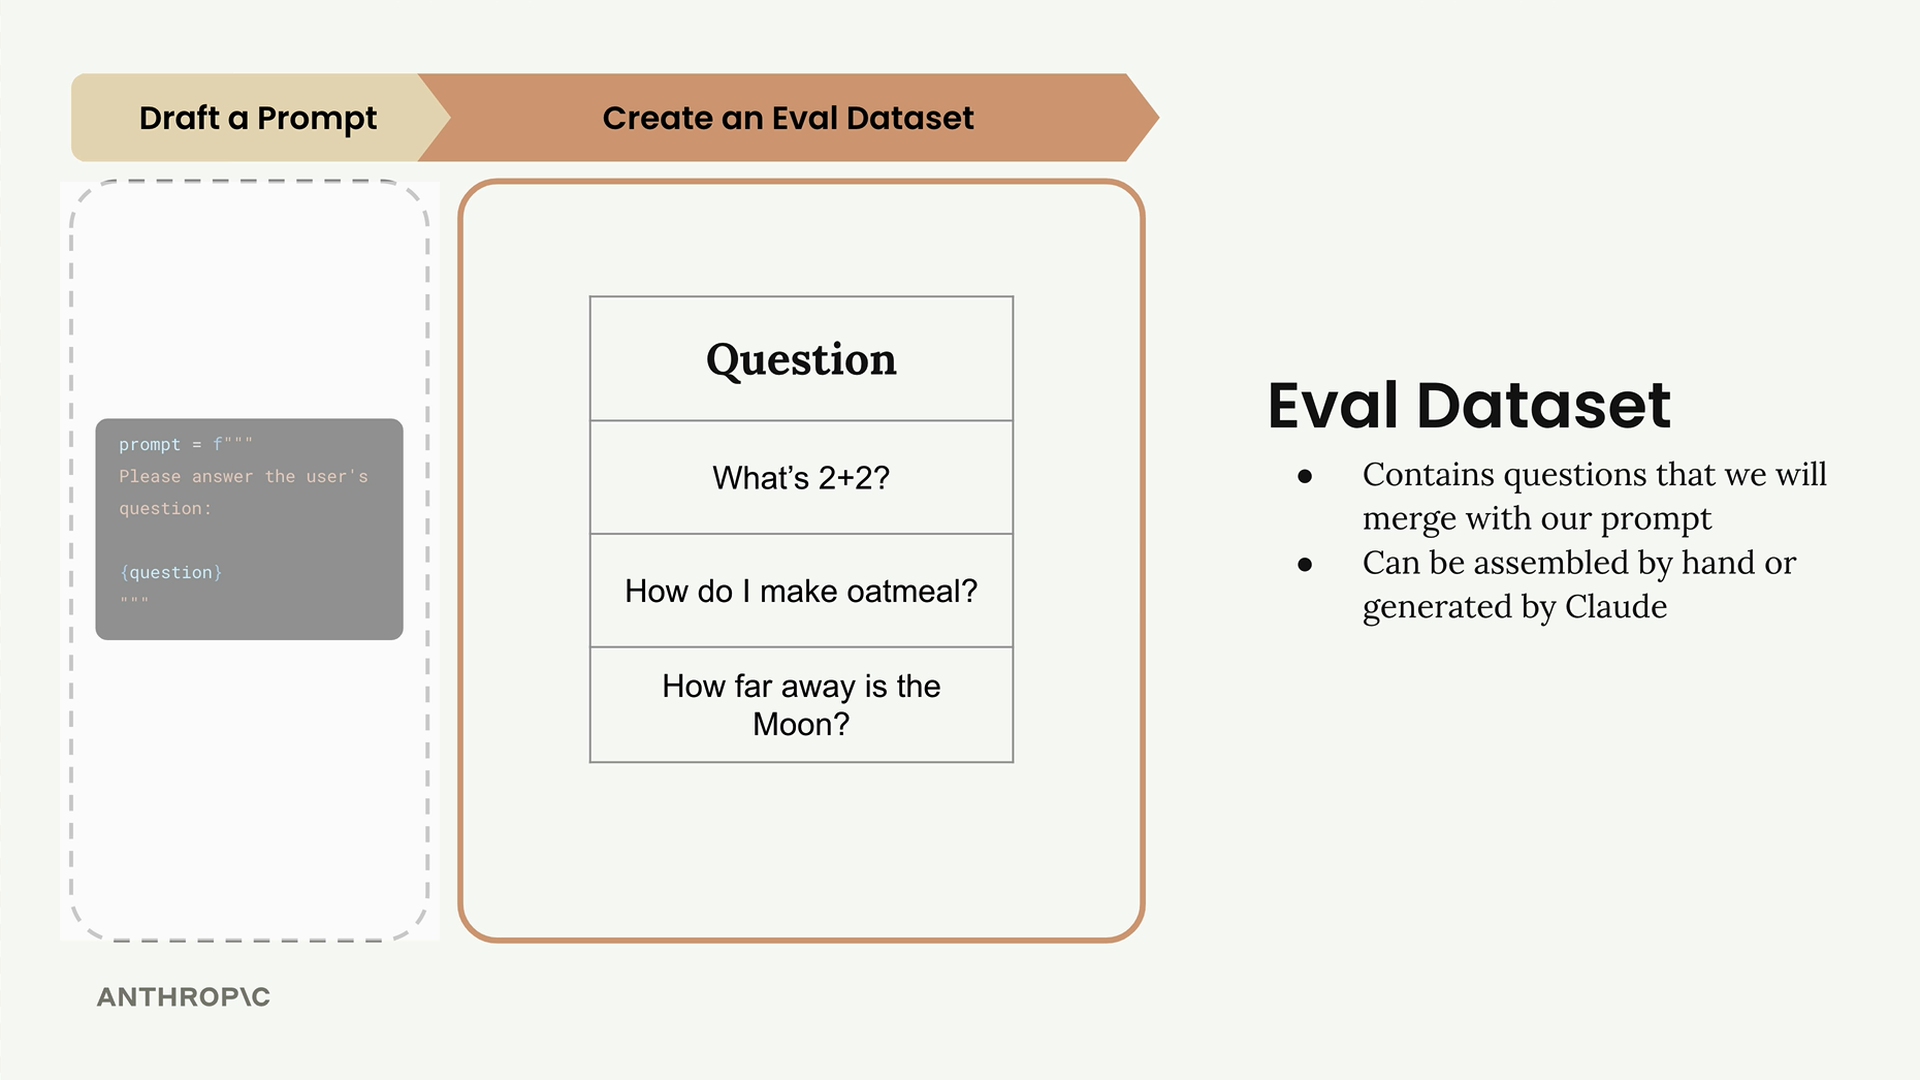
Der Datensatz enthält Fragen, die wir mit unserem Prompt zusammenführen werden. Du kannst diese Datensätze von Hand zusammenstellen oder sie mit Claude generieren. In realen Evaluierungen hast du vielleicht Dutzende, Hunderte oder sogar Tausende verschiedener Datensätze, aber wir beginnen für dieses Beispiel mit nur drei Fragen:
- Was ist 2+2?
- Wie mache ich Haferbrei?
- Wie weit ist der Mond entfernt?
Schritt 3: Durch Claude laufen lassen
Nimm jede Frage aus deinem Datensatz und führe sie mit deiner Prompt-Vorlage zusammen, um vollständige Prompts zu erstellen. Sende dann jeden einzelnen an Claude und sammle die Antworten.
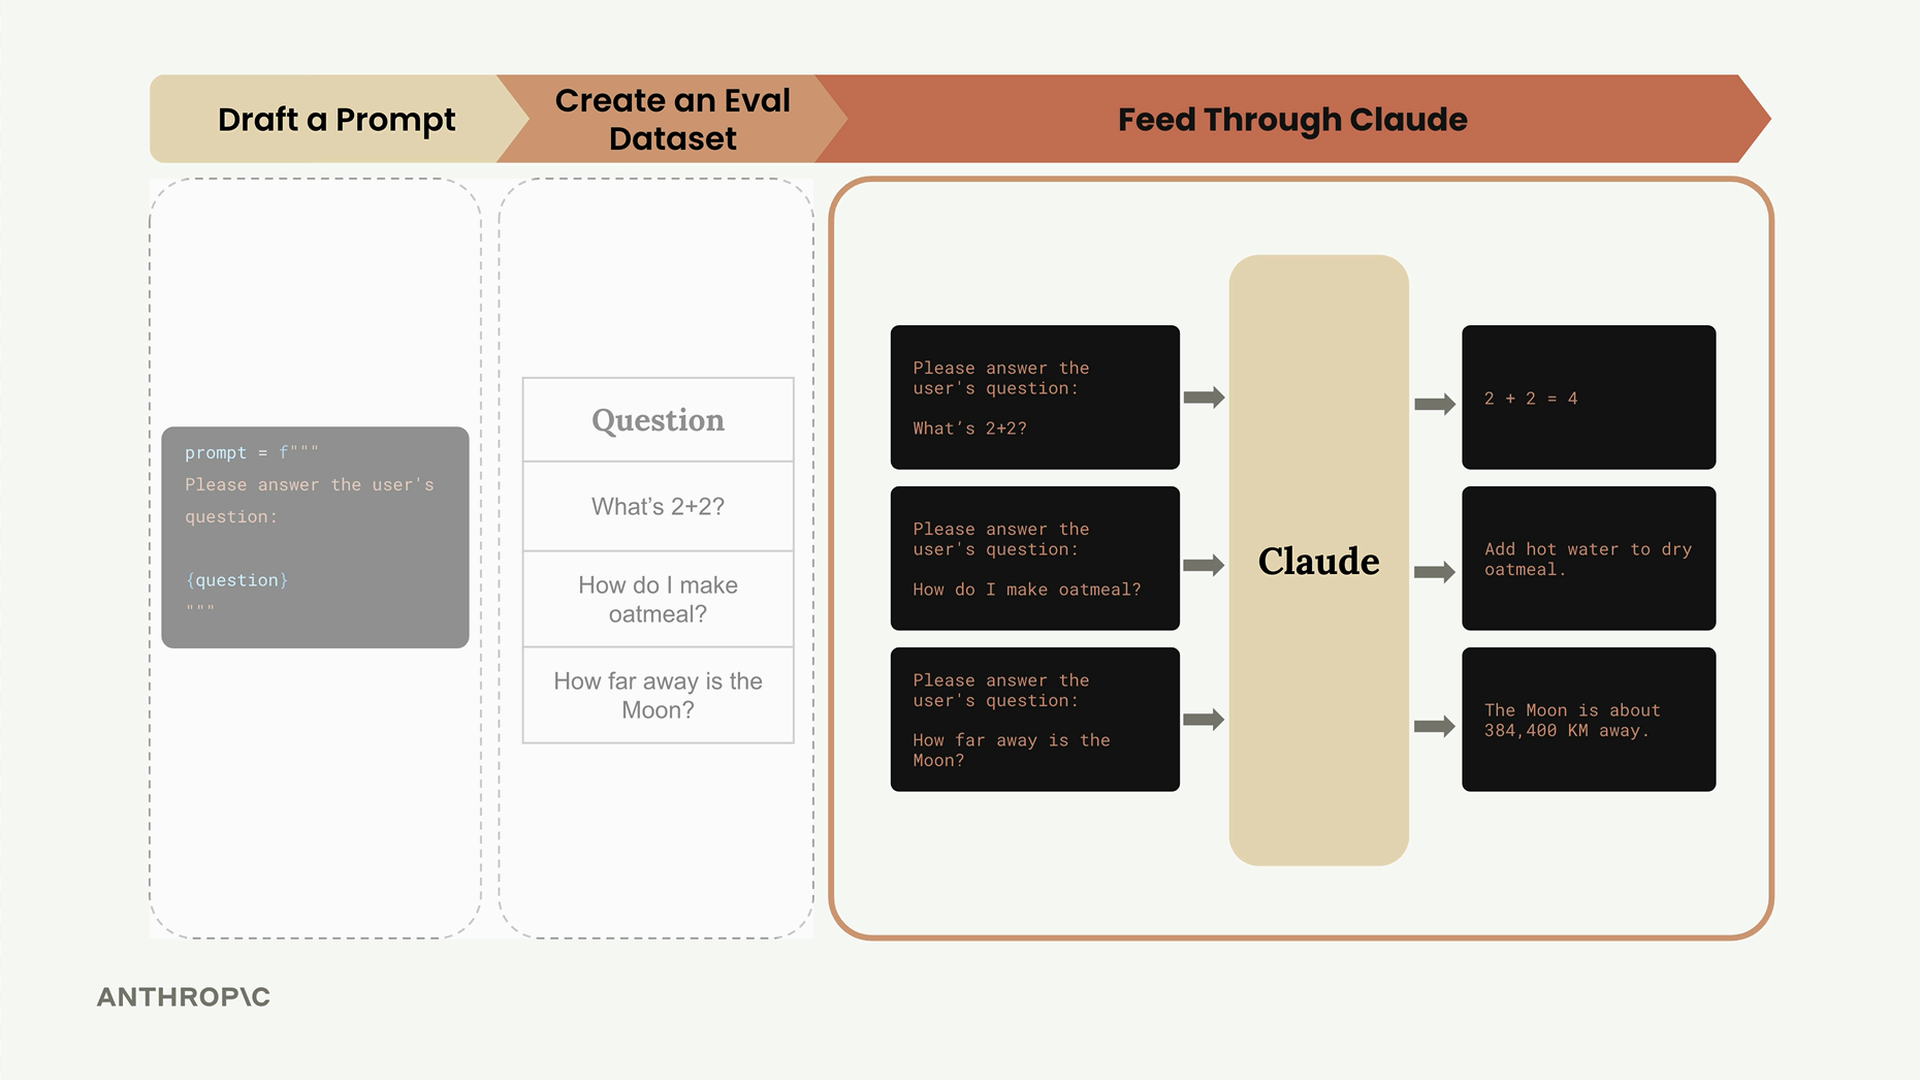
Zum Beispiel wird die erste Frage zu einem vollständigen Prompt, auf den Claude antworten kann. Du wiederholst diesen Prozess für alle Datensätze in deinem Datensatz und erhältst Antworten wie „2 + 2 = 4", detaillierte Anleitungen für Haferbrei und Informationen über die Entfernung des Mondes.
Schritt 4: Durch einen Grader laufen lassen
Jetzt kommt der entscheidende Schritt: die objektive Bewertung von Claudes Antworten. Nimm jedes Frage-Antwort-Paar und speise es in einen Grader ein, der die Qualität von Claudes Antwort bewertet.
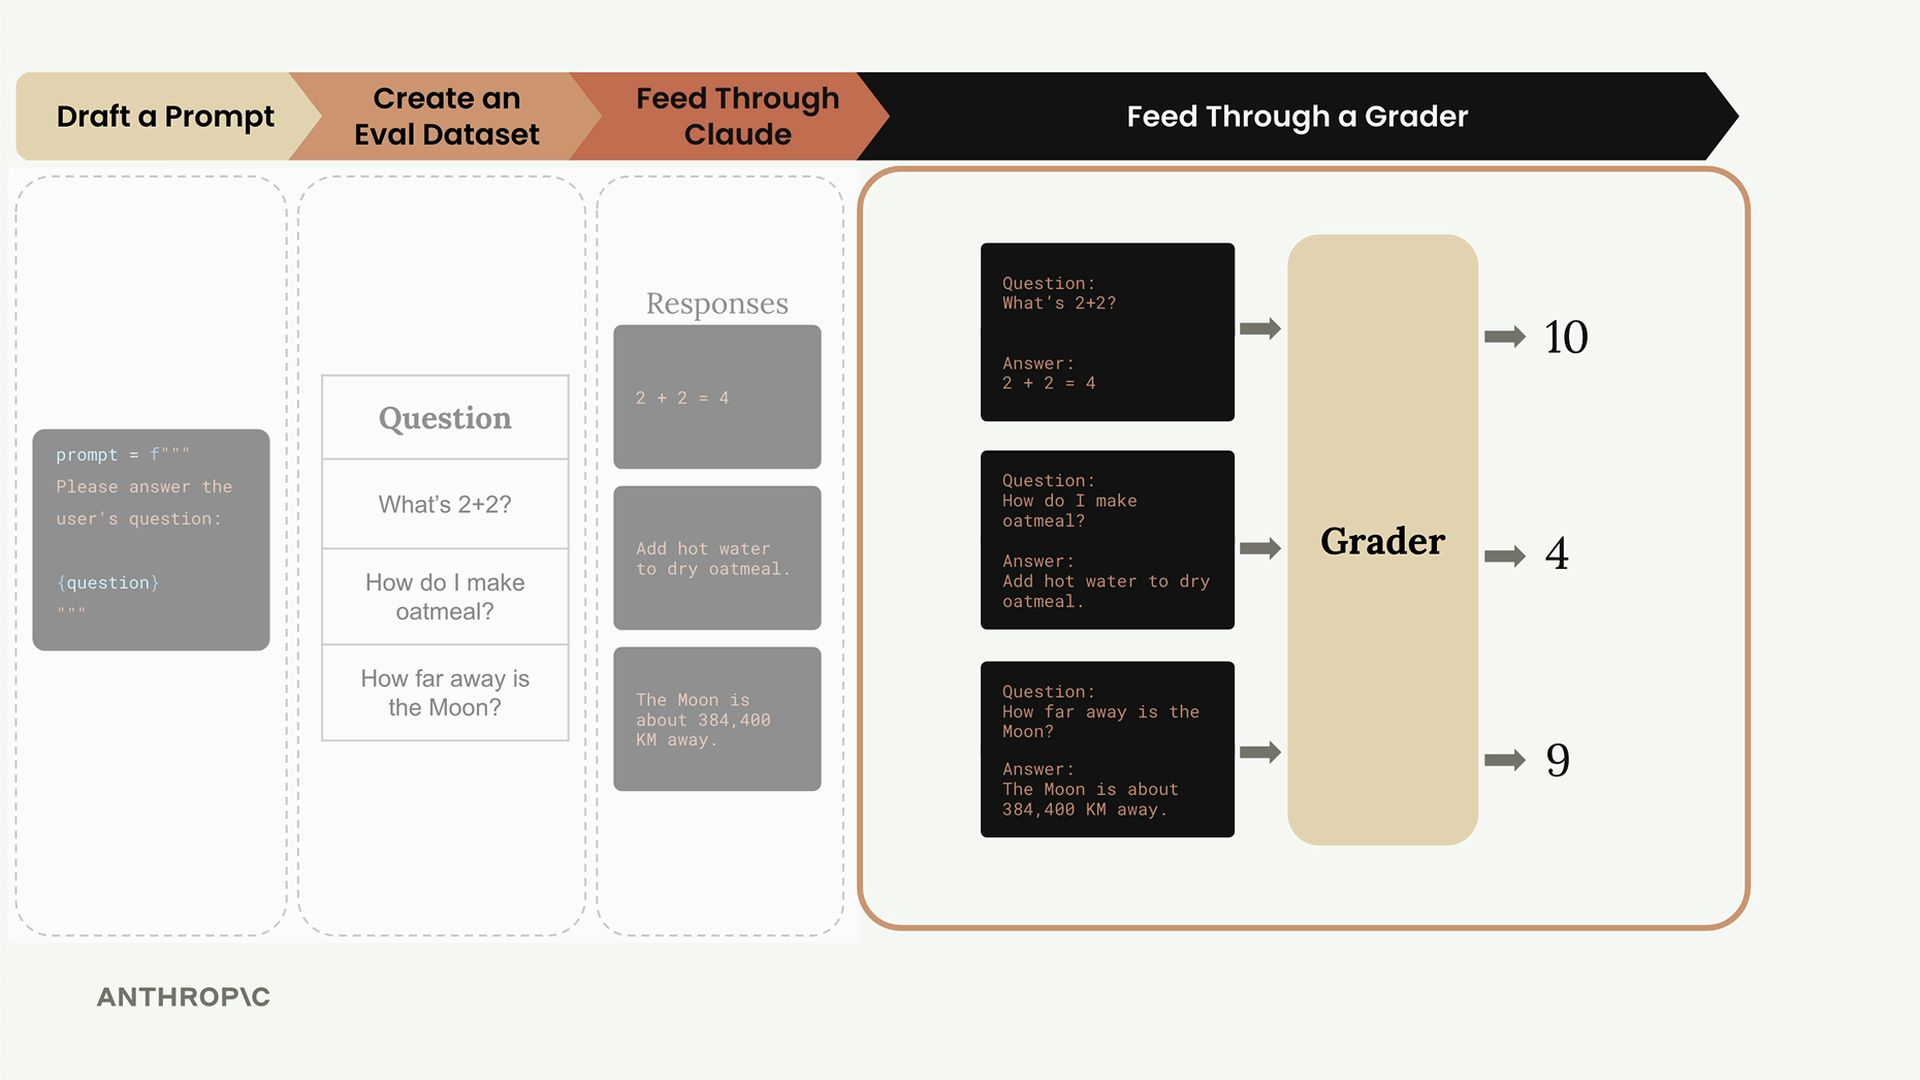
Der Grader vergibt Punktzahlen (typischerweise 1-10) basierend auf der Qualität der Antwort:
- 10 = Perfekte Antwort, kein Verbesserungsbedarf
- 4 = Definitiv Verbesserungsbedarf
- 1 = Schlechte oder falsche Antwort
In unserem Beispiel könnten die Antworten mit 10, 4 und 9 bewertet werden. Bilde den Durchschnitt dieser Punktzahlen, um eine Gesamtleistungskennzahl zu erhalten: 7,66.
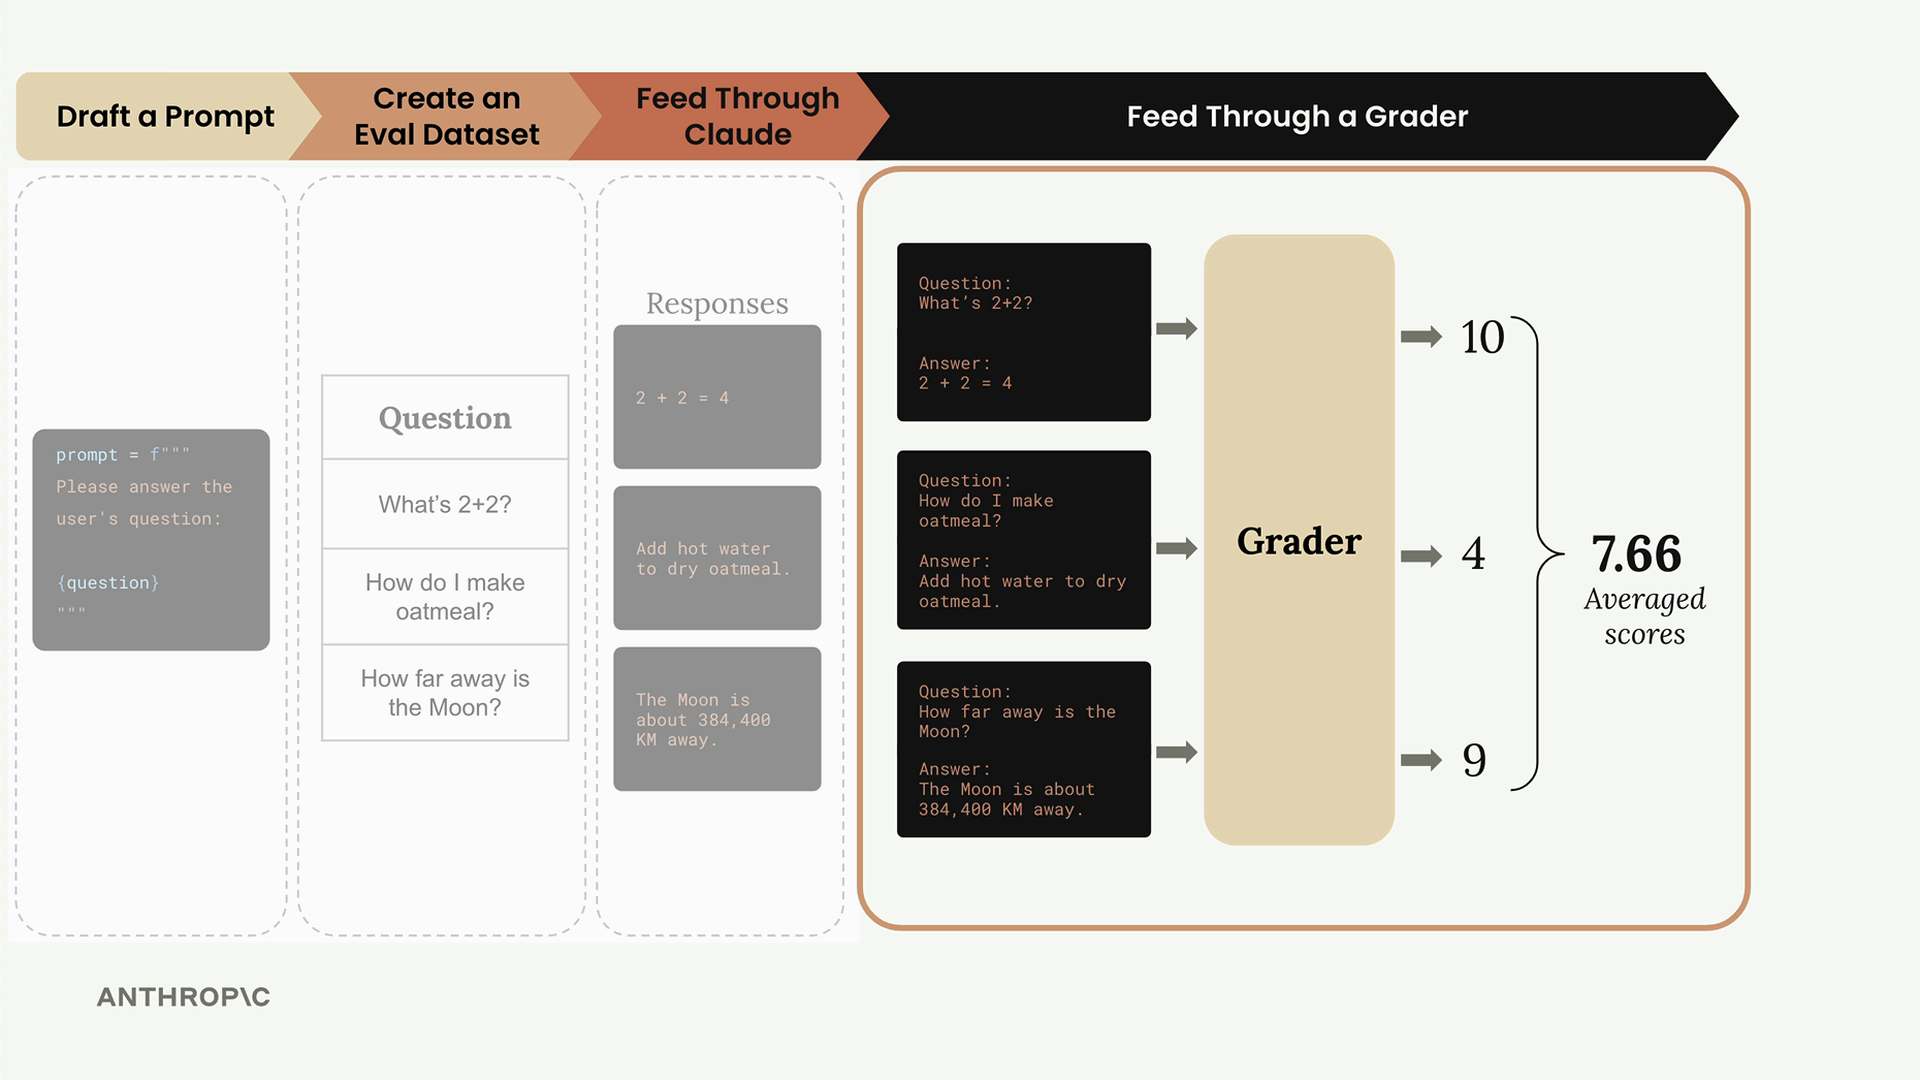
Schritt 5: Prompt ändern und wiederholen
Nachdem du deine Ausgangspunktzahl festgelegt hast, kannst du nun deinen Prompt iterieren. Versuche, spezifischere Anweisungen hinzuzufügen, um Claudes Antworten zu steuern:
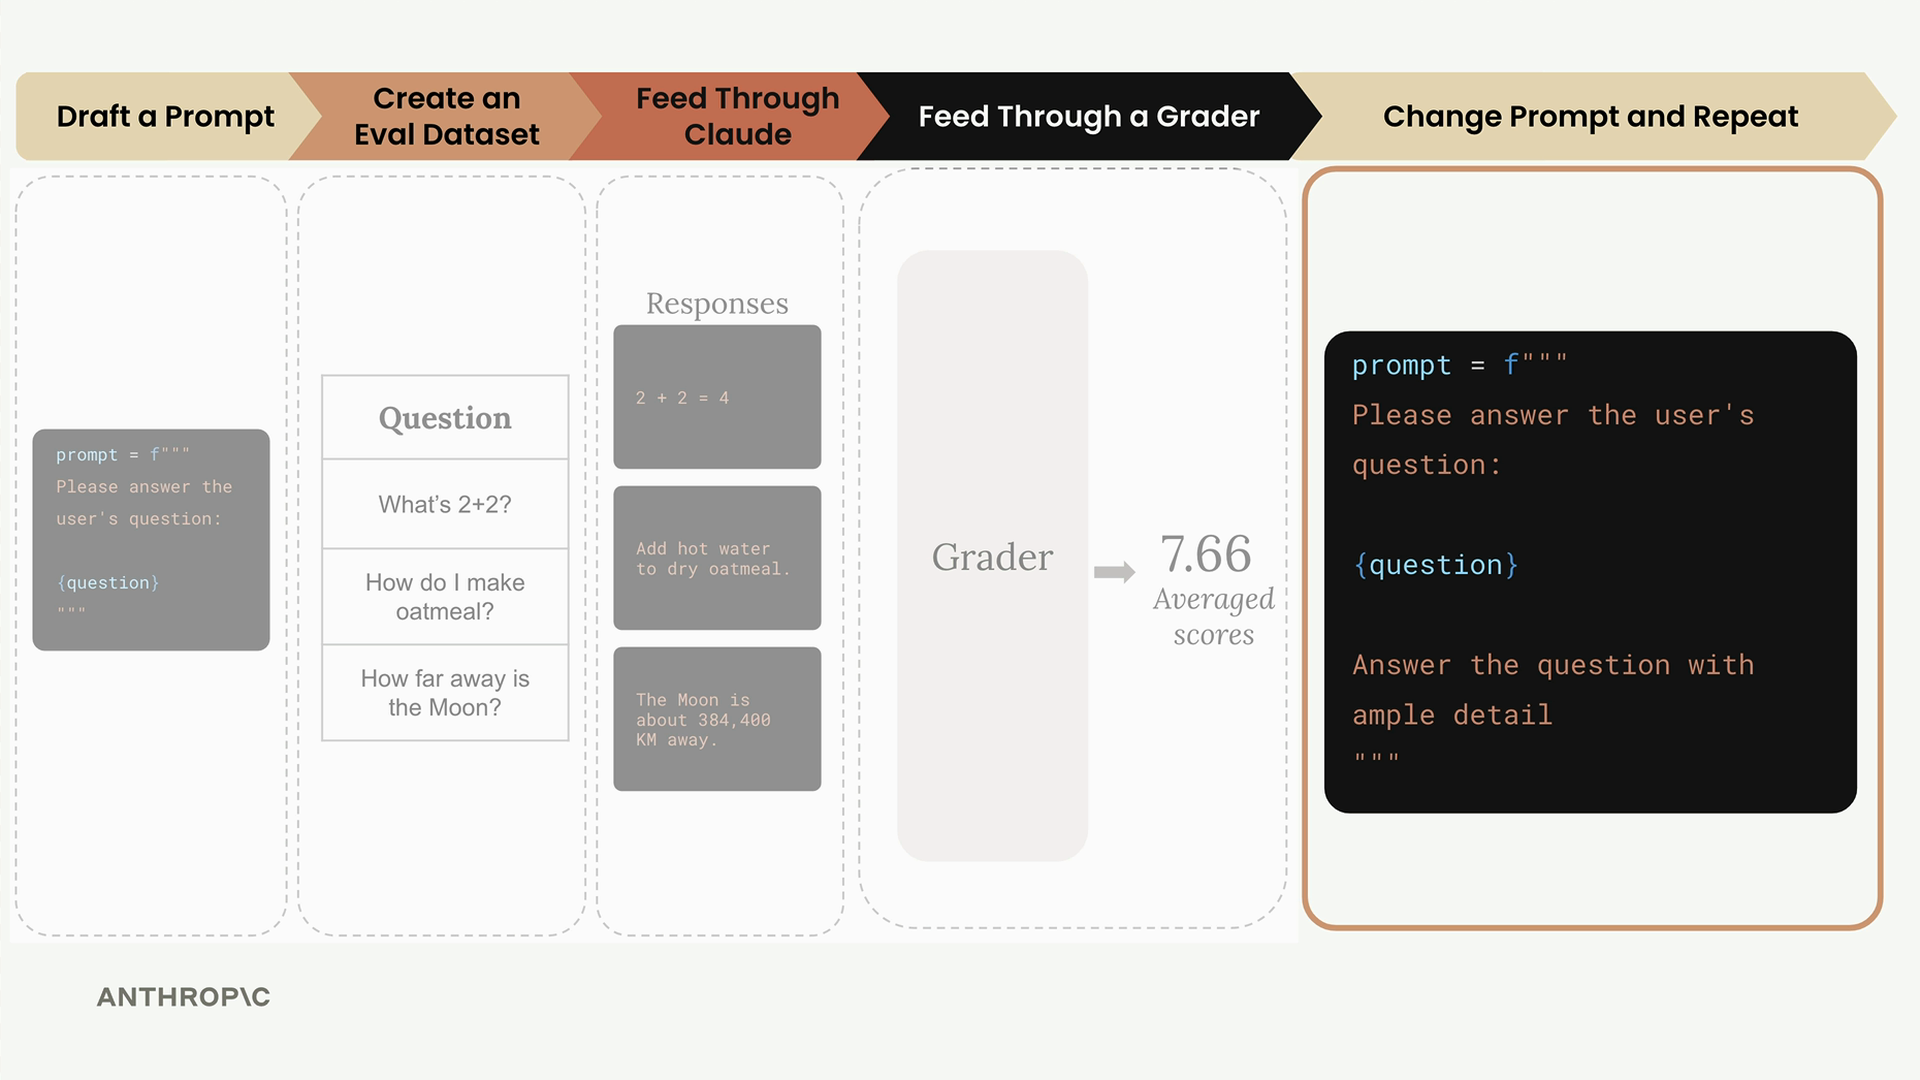
prompt = f"""
Please answer the user's question:

{question}

Answer the question with ample detail
"""
Lass diesen verbesserten Prompt erneut durch die gesamte Evaluierungs-Pipeline laufen. Vergleiche die Punktzahlen, um zu sehen, welche Version besser abschneidet.
Prompt-Bewertung und Iteration
Die Stärke dieses Workflows liegt darin, objektive Messwerte für jede Prompt-Version zu erhalten. Du kannst Punktzahlen über verschiedene Iterationen hinweg vergleichen und die Version mit der besten Leistung verwenden oder weiter iterieren, um noch bessere Ansätze zu finden.
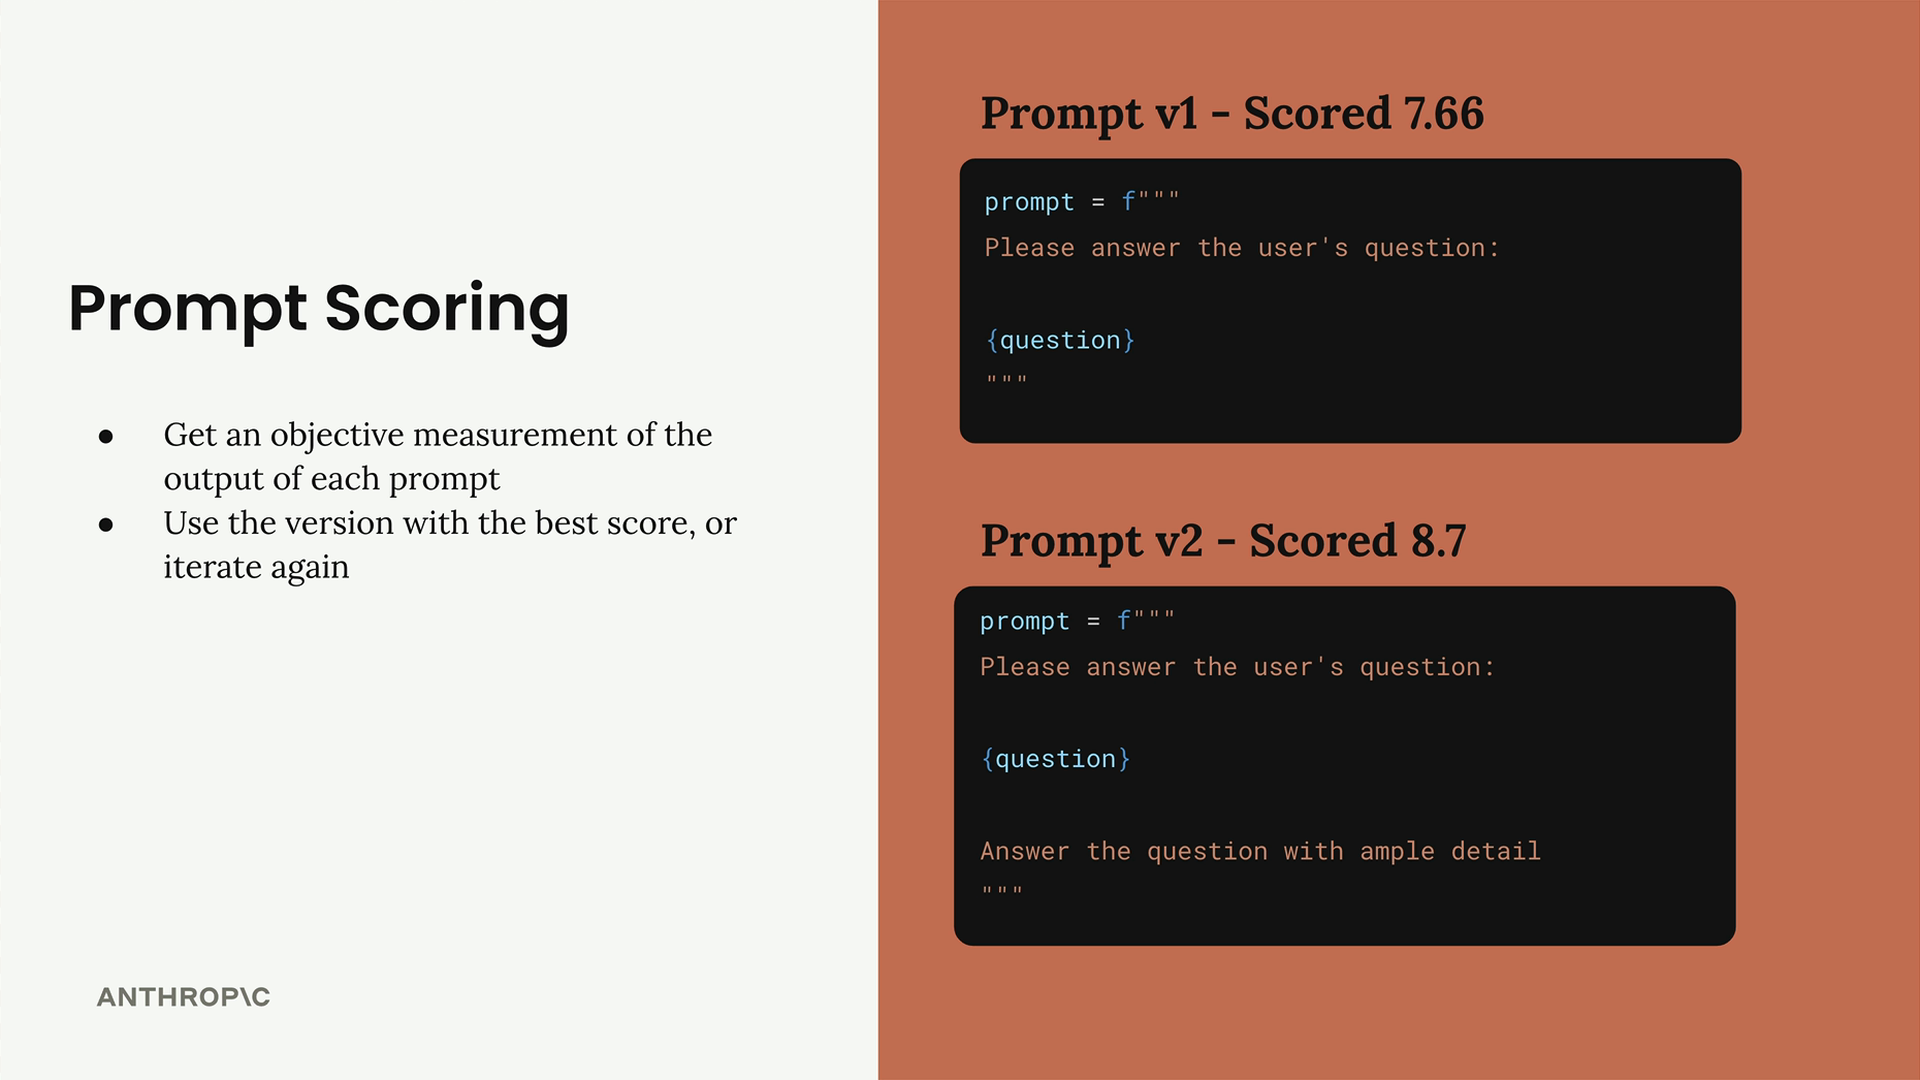
In unserem Beispiel:
- Prompt v1 erzielte 7,66 Punkte
- Prompt v2 erzielte 8,7 Punkte
Die höhere Punktzahl für v2 deutet darauf hin, dass das Hinzufügen von „Beantworte die Frage mit ausreichend Detail" die Leistung des Prompts über unsere Testfälle hinweg verbessert hat.
Dieser systematische Ansatz gibt dir eine objektive Möglichkeit, Prompt-Verbesserungen zu messen, anstatt dich auf subjektives Urteilsvermögen zu verlassen. Du kannst mit einer einfachen Implementierung beginnen und schrittweise ausgefeiltere Evaluierungskriterien hinzufügen, wenn deine Anforderungen wachsen.