Der hybride Retrieval-Ansatz, den wir aufgebaut haben, funktioniert gut, aber es gibt noch einige Unschärfen. Wenn du nach bestimmten Begriffen suchst oder Abkürzungen verwendest, sind die Ergebnisse möglicherweise nicht perfekt sortiert. Wenn du beispielsweise fragst „Was hat das Engineering-Team mit INC-2023-Q4-011 gemacht?", könnte zuerst der Abschnitt zur Cybersicherheit zurückgegeben werden, obwohl der Abschnitt zur Softwareentwicklung für diese spezifische Anfrage relevanter ist.
LLM-basiertes Re-ranking
Re-ranking fügt einen weiteren Nachbearbeitungsschritt hinzu, nachdem die Ergebnisse aus deinem Vektorindex und BM25-Index zusammengeführt wurden. Das Konzept ist einfach: Nimm deine Suchergebnisse und bitte Claude, sie basierend auf der Relevanz für die Frage des Nutzers neu zu ordnen.
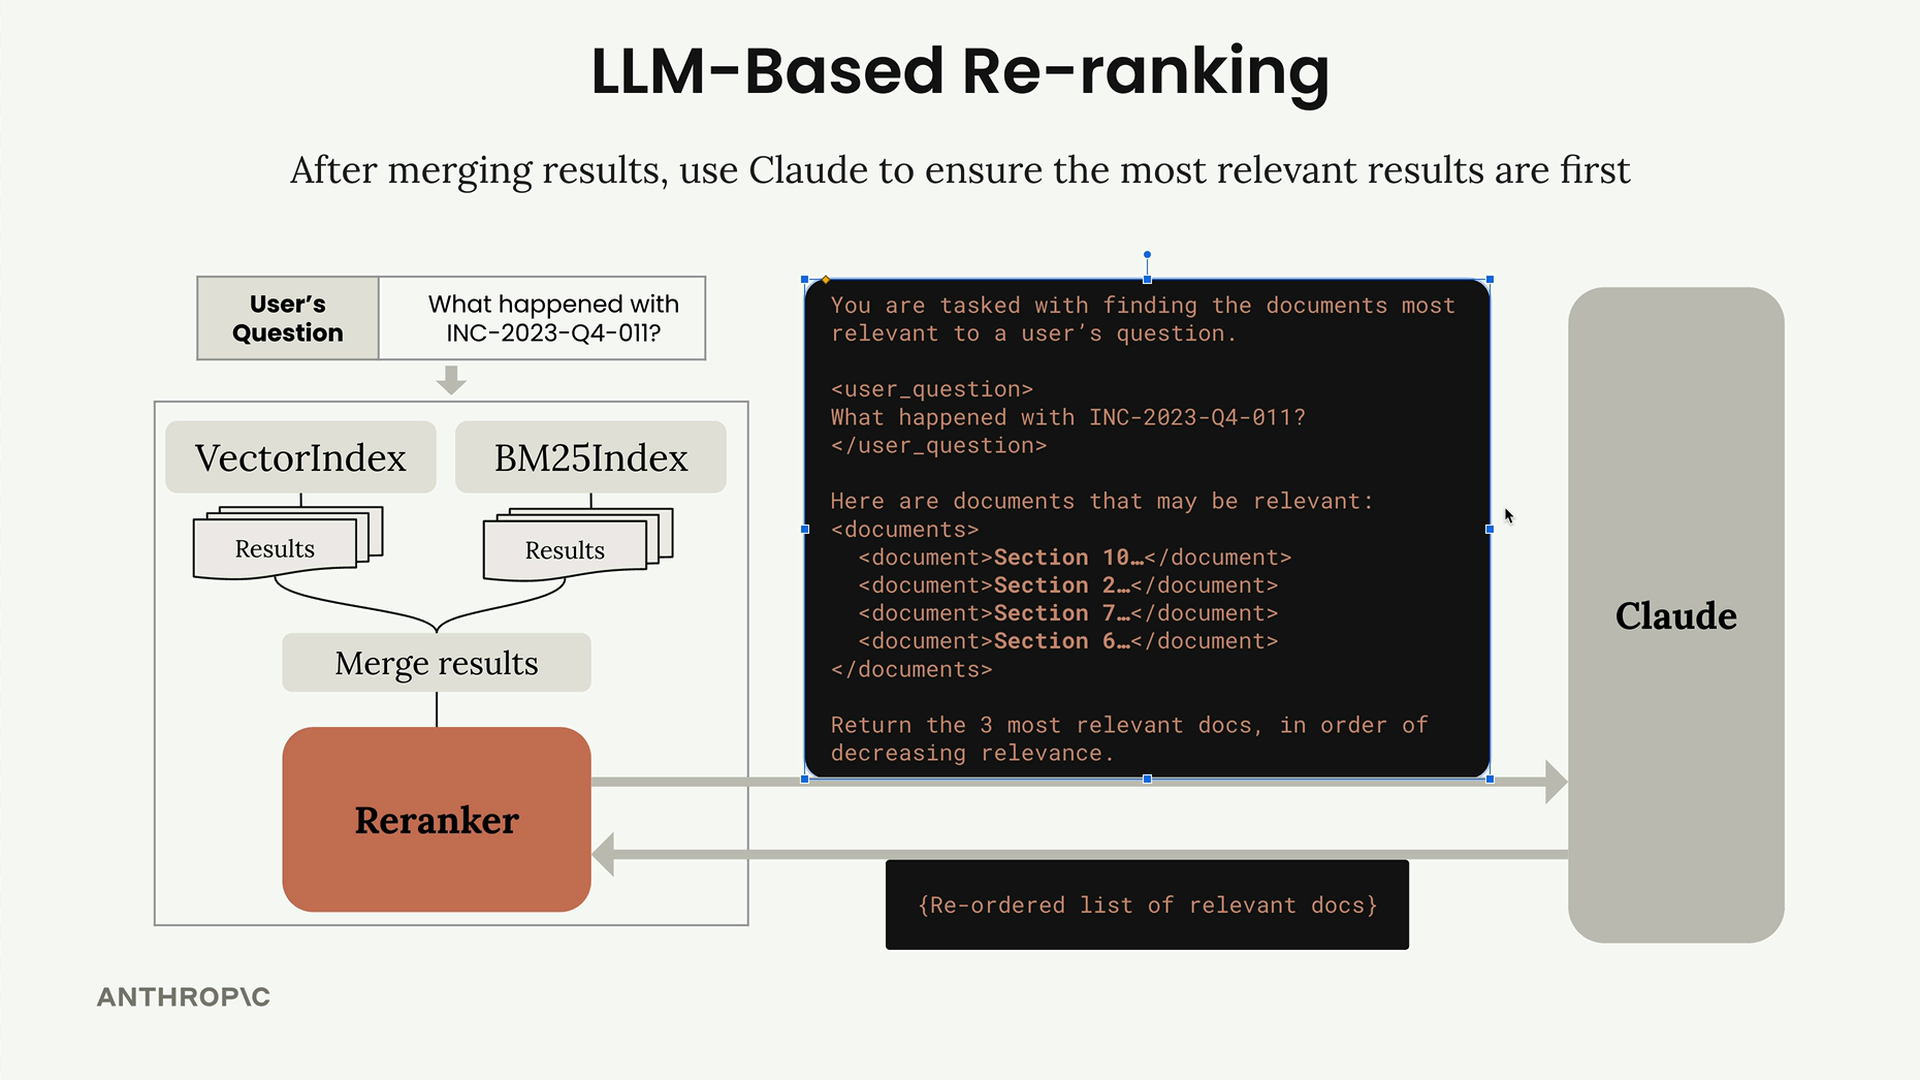
So funktioniert der Prozess:
- Führe deine Hybridsuche (Vektor + BM25) wie gewohnt durch
- Führe die Ergebnisse wie zuvor zusammen
- Übergib die zusammengeführten Ergebnisse an eine Re-ranker-Funktion
- Der Re-ranker sendet alles mit einem spezifischen Prompt an Claude
- Claude gibt eine neu geordnete Liste der relevantesten Dokumente zurück
System-Prompts
Der Re-ranking-Prompt ist darauf ausgelegt, klar und spezifisch zu sein. Du gibst Claude die Frage des Nutzers und alle Dokumente, die relevant erscheinen, und bittest dann um eine einfache Aufgabe: Gib die relevantesten Dokumente in absteigender Reihenfolge der Relevanz zurück.
Eine typische Prompt-Struktur sieht so aus:
You are tasked with finding the documents most relevant to a user's question.

<user_question>
What happened with INC-2023-Q4-011?
</user_question>

Here are documents that may be relevant:
<documents>
<document>Section 10...</document>
<document>Section 2...</document>
<document>Section 7...</document>
<document>Section 6...</document>
</documents>

Return the 3 most relevant docs, in order of decreasing relevance.Effizienzüberlegungen
Claude zu bitten, vollständige Textabschnitte zurückzugeben, wäre ineffizient – du würdest darauf warten, dass Claude große Textmengen kopiert. Weise stattdessen jedem Textabschnitt im Voraus eine eindeutige ID zu. Bitte Claude dann, nur diese IDs in der richtigen Reihenfolge zurückzugeben.
Dieser Ansatz ist viel schneller, da Claude nur eine einfache Liste wie ["1p5g", "51n3", "ab83"] zurückgeben muss, anstatt ganze Dokumentabschnitte zu kopieren.
Implementierung
Die Re-ranker-Funktion wird automatisch von deinem Retriever nach der anfänglichen Hybridsuche aufgerufen. Hier ist die grundlegende Struktur:
def reranker_fn(docs, query_text, k):
    # Dokumente mit IDs formatieren
    joined_docs = "\n".join([
        f"<document><document_id>{doc['id']}</document_id>"
        f"<document_content>{doc['content']}</document_content></document>"
        for doc in docs
    ])

    # Prompt mit Nutzerfrage und Dokumenten erstellen
    prompt = f"""You are about to be given a set of documents...
    {query_text}
    {joined_docs}
    """

    # Antwort von Claude abrufen und Dokument-IDs parsen
    result = chat(messages, stop_sequences=["```"])
    return json.loads(result["text"])["document_ids"]
Ergebnisse
Wenn du den Re-ranker mit Anfragen wie „Was hat das Engineering-Team mit INC-2023-Q4-011 gemacht?" testest, solltest du relevantere Ergebnisse an der Spitze sehen. Claude versteht den Kontext und kann erkennen, dass eine Anfrage zum Engineering-Team den Abschnitt zur Softwareentwicklung gegenüber anderen Abschnitten priorisieren sollte, die den Vorfall nur erwähnen.
Der Kompromiss ist klar: Re-ranking erhöht die Latenz, da du auf Claudes Antwort warten musst, aber es verbessert die Suchgenauigkeit erheblich, indem es Claudes Verständnis von Kontext und Relevanz nutzt.