Jetzt, wo unser Evaluationsdatensatz bereit ist, ist es Zeit, die zentrale Evaluationspipeline zu erstellen. Dabei nehmen wir jeden Testfall, verschmelzen ihn mit unserem Prompt, geben ihn an Claude weiter und bewerten anschließend die Ergebnisse.
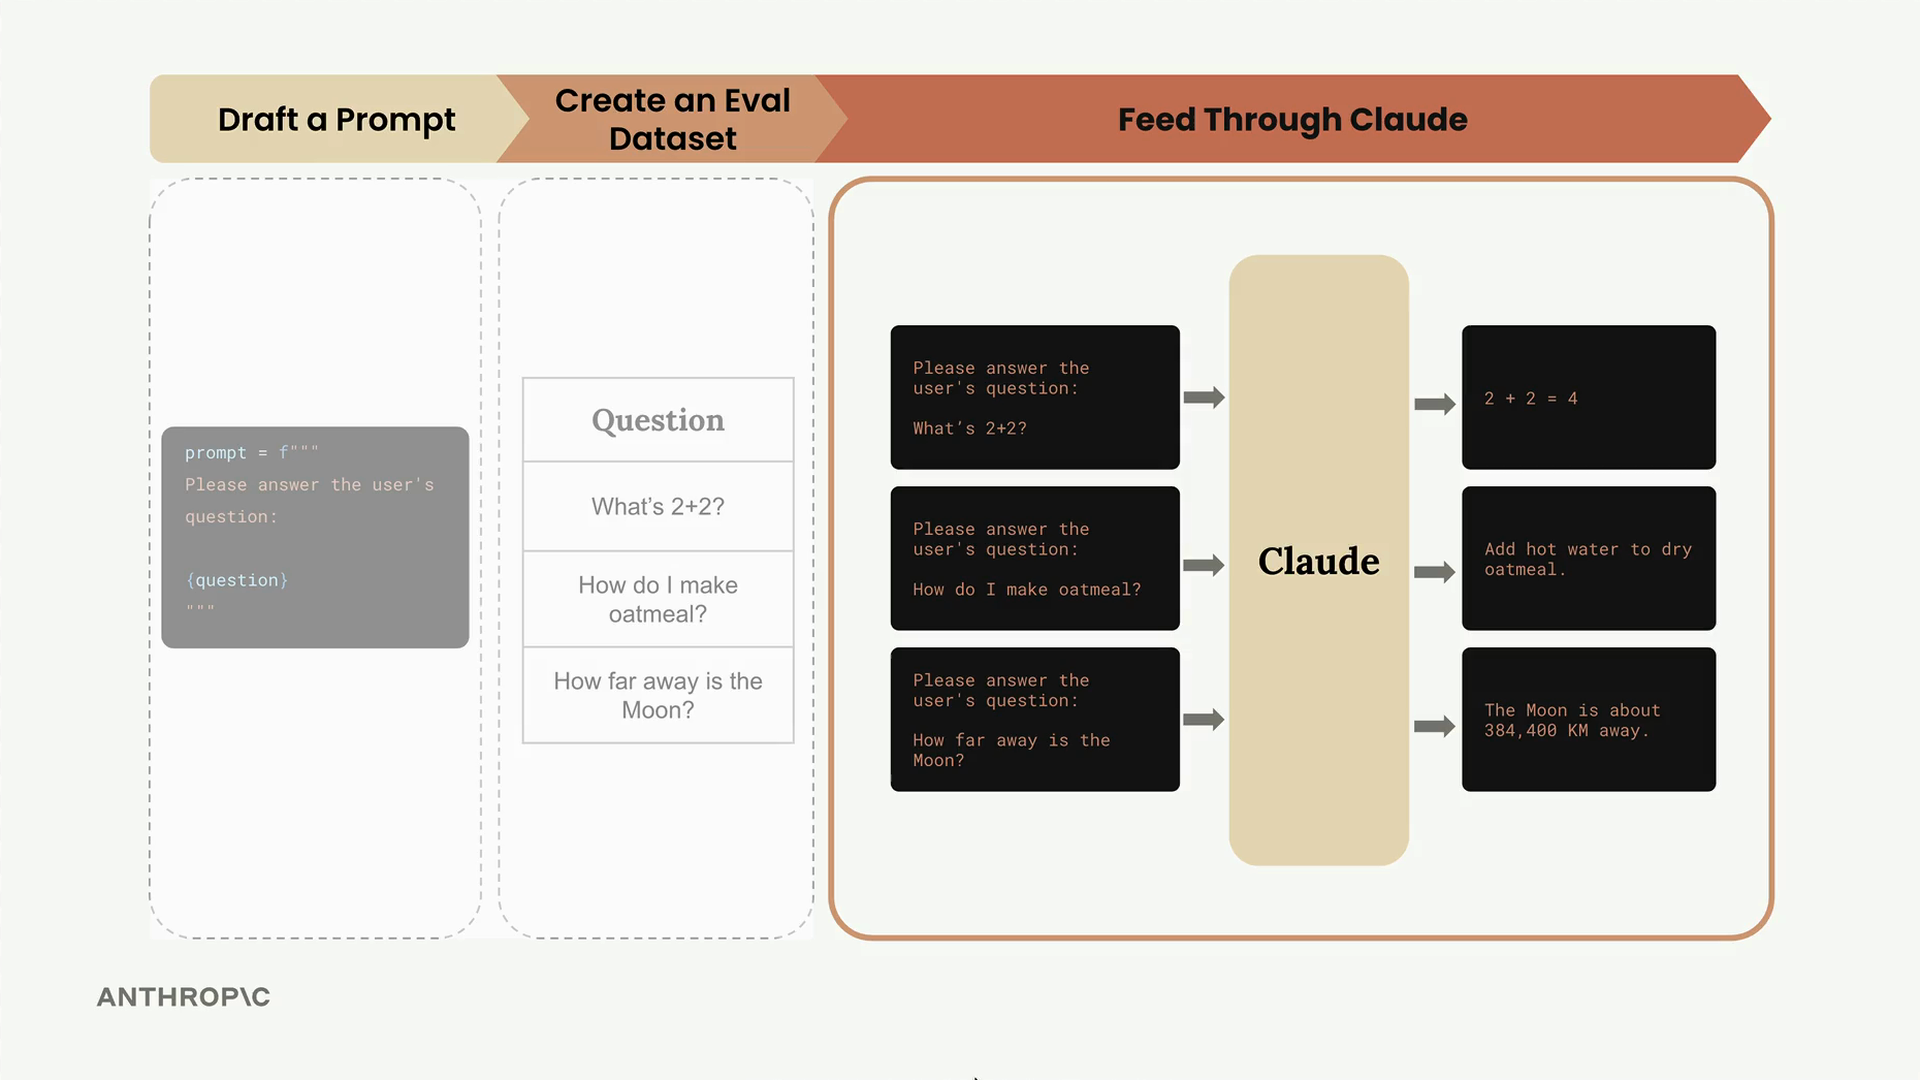
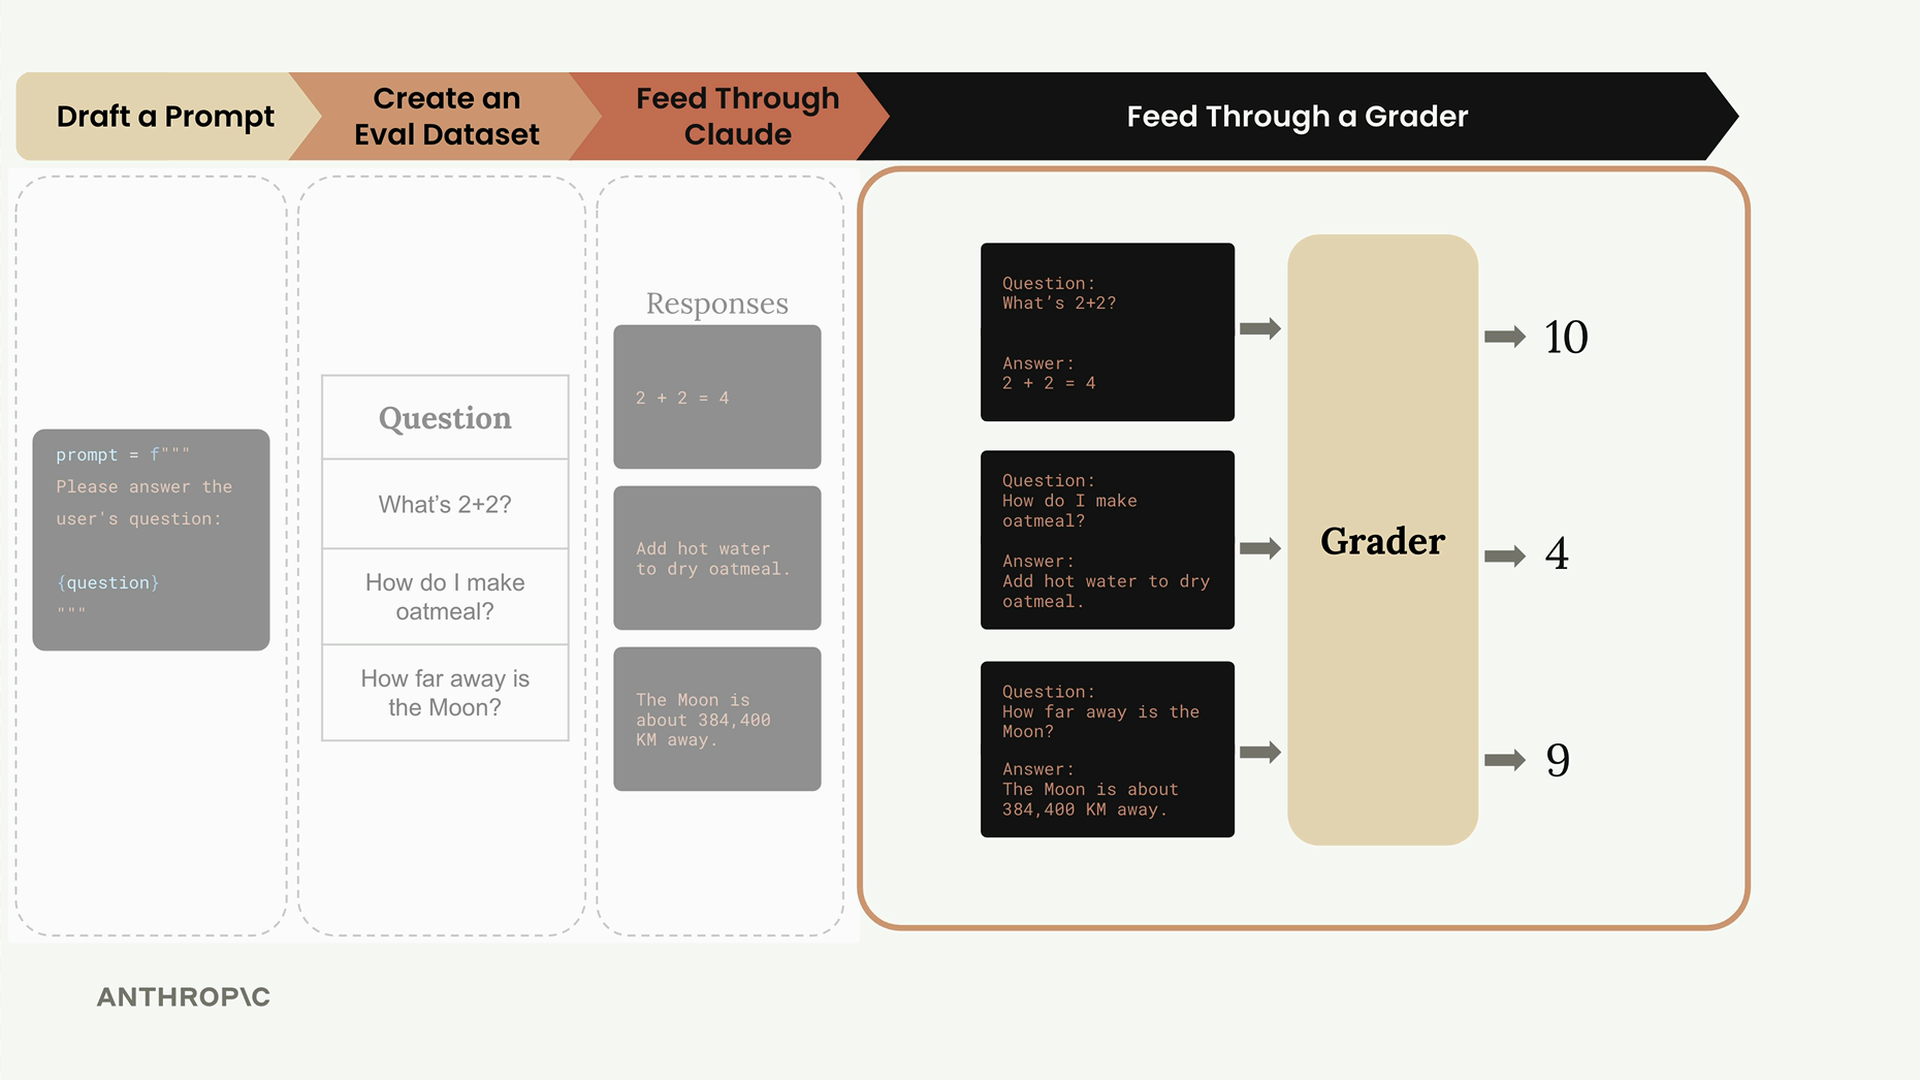
Der Evaluationsprozess folgt einem klaren Ablauf: Wir nehmen unseren Datensatz mit Testfällen, kombinieren jeden davon mit unserer Prompt-Vorlage, senden ihn zur Verarbeitung an Claude und bewerten dann die Ausgabe mithilfe eines Grader-Systems.
Die Kernfunktionen erstellen
Die Evaluationspipeline besteht aus drei Hauptfunktionen, jede mit einer spezifischen Aufgabe. Beginnen wir mit der einfachsten - der Funktion, die die Ausführung einzelner Prompts übernimmt.
Die Funktion run_prompt
Diese Funktion nimmt einen Testfall und verschmilzt ihn mit unserer Prompt-Vorlage:
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
Momentan halten wir den Prompt extrem einfach. Wir fügen keine Formatierungsanweisungen hinzu, was bedeutet, dass Claude wahrscheinlich ausführlichere Ausgaben zurückgibt, als wir benötigen. Wir werden dies später verfeinern, während wir unseren Evaluationsprozess iterieren.
Die Funktion run_test_case
Diese Funktion orchestriert die Ausführung eines einzelnen Testfalls und die Bewertung des Ergebnisses:
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - Bewertung
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
Vorerst verwenden wir einen fest codierten Score von 10. Die Bewertungslogik ist der Bereich, in dem wir in den kommenden Abschnitten erheblich Zeit verbringen werden, aber dieser Platzhalter ermöglicht es uns, die Gesamtstruktur der Pipeline zu testen.
Die Funktion run_eval
Dies ist der Haupt-Orchestrator, der den gesamten Datensatz verarbeitet:
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
Diese Funktion durchläuft jeden Testfall in unserem Datensatz, verarbeitet jeden einzelnen und sammelt alle Ergebnisse in einer einzigen Liste.
Die Evaluation ausführen
Um unsere Evaluationspipeline auszuführen, laden wir den Datensatz und rufen unsere Hauptfunktion auf:
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
Beim ersten Ausführen solltest du damit rechnen, dass es einige Zeit dauert - selbst mit Claude Haiku kann die Verarbeitung eines vollständigen Datensatzes 30+ Sekunden dauern. Wir werden Optimierungstechniken später behandeln, aber vorerst ist Geduld gefragt.
Die Ergebnisse untersuchen
Sobald die Evaluation abgeschlossen ist, kannst du die Ergebnisse mit formatierter JSON-Ausgabe untersuchen:
print(json.dumps(results, indent=2))
Die Ergebnisstruktur enthält ein Array von Objekten, wobei jedes Objekt eine Testfallausführung repräsentiert. Du siehst die Claude-Ausgabe (die ohne Formatierungsbeschränkungen tendenziell recht ausführlich ist), die ursprüngliche Testfalldefinition und den Score.
Was wir erreicht haben
An diesem Punkt haben wir die zentrale Evaluationspipeline erfolgreich implementiert. Wir können:
- Testfälle aus unserem Datensatz nehmen
- Sie mit Prompt-Vorlagen verschmelzen
- Antworten von Claude erhalten
- Alle Ergebnisse sammeln und organisieren
Das fehlende Puzzleteil ist eine intelligente Bewertung - momentan weisen wir jeder Antwort nur einen festen Score zu. Der nächste Schritt besteht darin, Grader zu erstellen, die tatsächlich bewerten können, ob die Ausgaben von Claude korrekt sind, und genau hier kommt die eigentliche Raffinesse von Evaluationssystemen ins Spiel.
Diese Pipeline-Struktur mag einfach erscheinen, aber sie stellt die Grundlage dar, auf der die meisten KI-Evaluationssysteme aufgebaut sind. Die Komplexität liegt in der Bewertungslogik und der Prompt-Optimierung, nicht in der grundlegenden Orchestrierung der Testausführung.