Beim Erstellen von Chat-Oberflächen mit KI-Modellen erwarten Nutzer, dass Antworten sofort erscheinen, anstatt 10-30 Sekunden auf eine vollständige Antwort zu warten. Die Funktion converse_stream löst dieses Problem, indem sie Text streamt, während er generiert wird, was eine deutlich bessere Nutzererfahrung schafft.
Wie Streaming funktioniert
Anstatt auf die Generierung der gesamten Antwort zu warten, sendet Streaming Textabschnitte zurück, sobald sie verfügbar sind. So verändert sich der Ablauf:
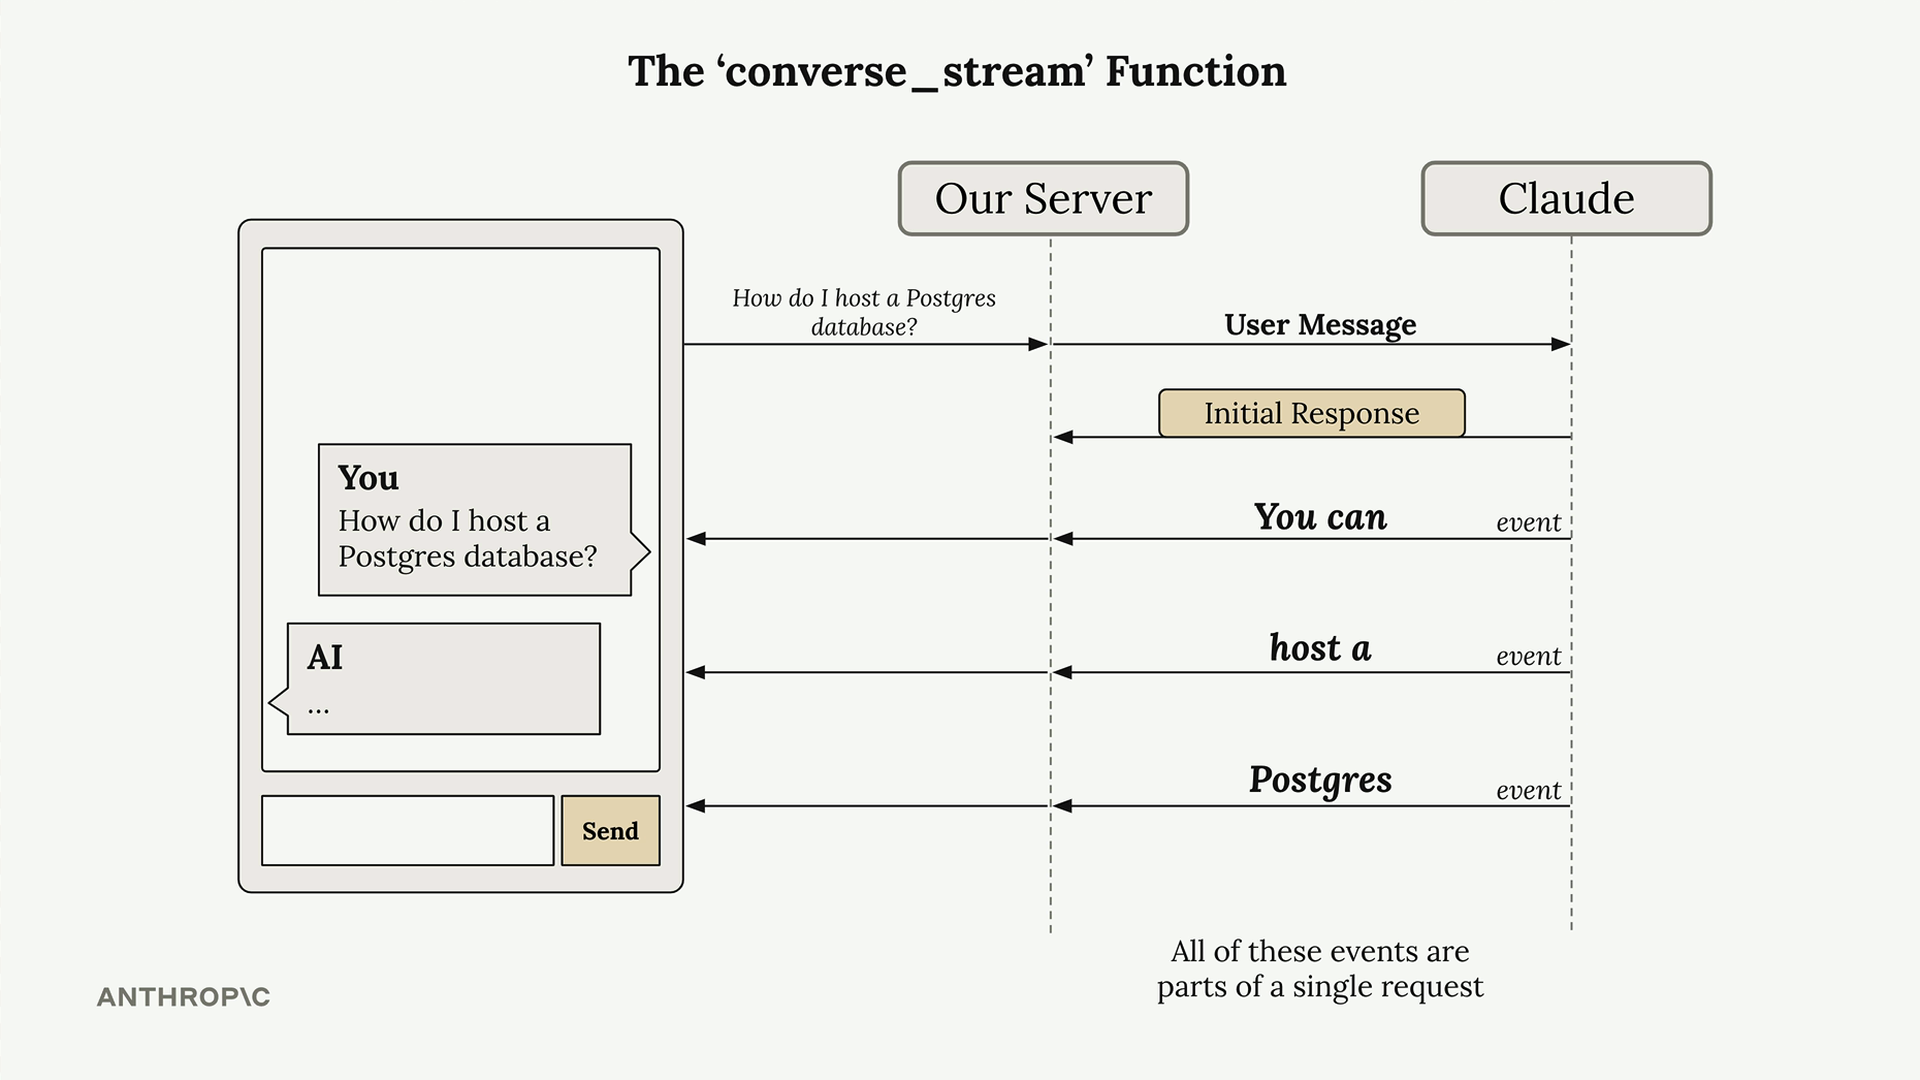
Wenn du converse_stream aufrufst, erhältst du sofort eine erste Antwort zurück, die ein stream-Objekt enthält. Dieser Stream ist ein Generator, der Events ausgibt, während das Modell Text generiert. Jedes Event enthält einen kleinen Abschnitt der Gesamtantwort.
Grundlegende Implementierung
So verwendest du converse_stream in deinem Code:
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")
response = client.converse_stream(messages=messages, modelId=model_id)

for event in response["stream"]:
    print(event)
Dies gibt alle verschiedenen Events aus, sobald sie eintreffen. Du wirst sehen, dass die Antwort in Abschnitten eintrifft, anstatt alles auf einmal.
Stream-Events verstehen
Der Stream gibt mehrere Arten von Events aus, die jeweils einem anderen Zweck dienen:
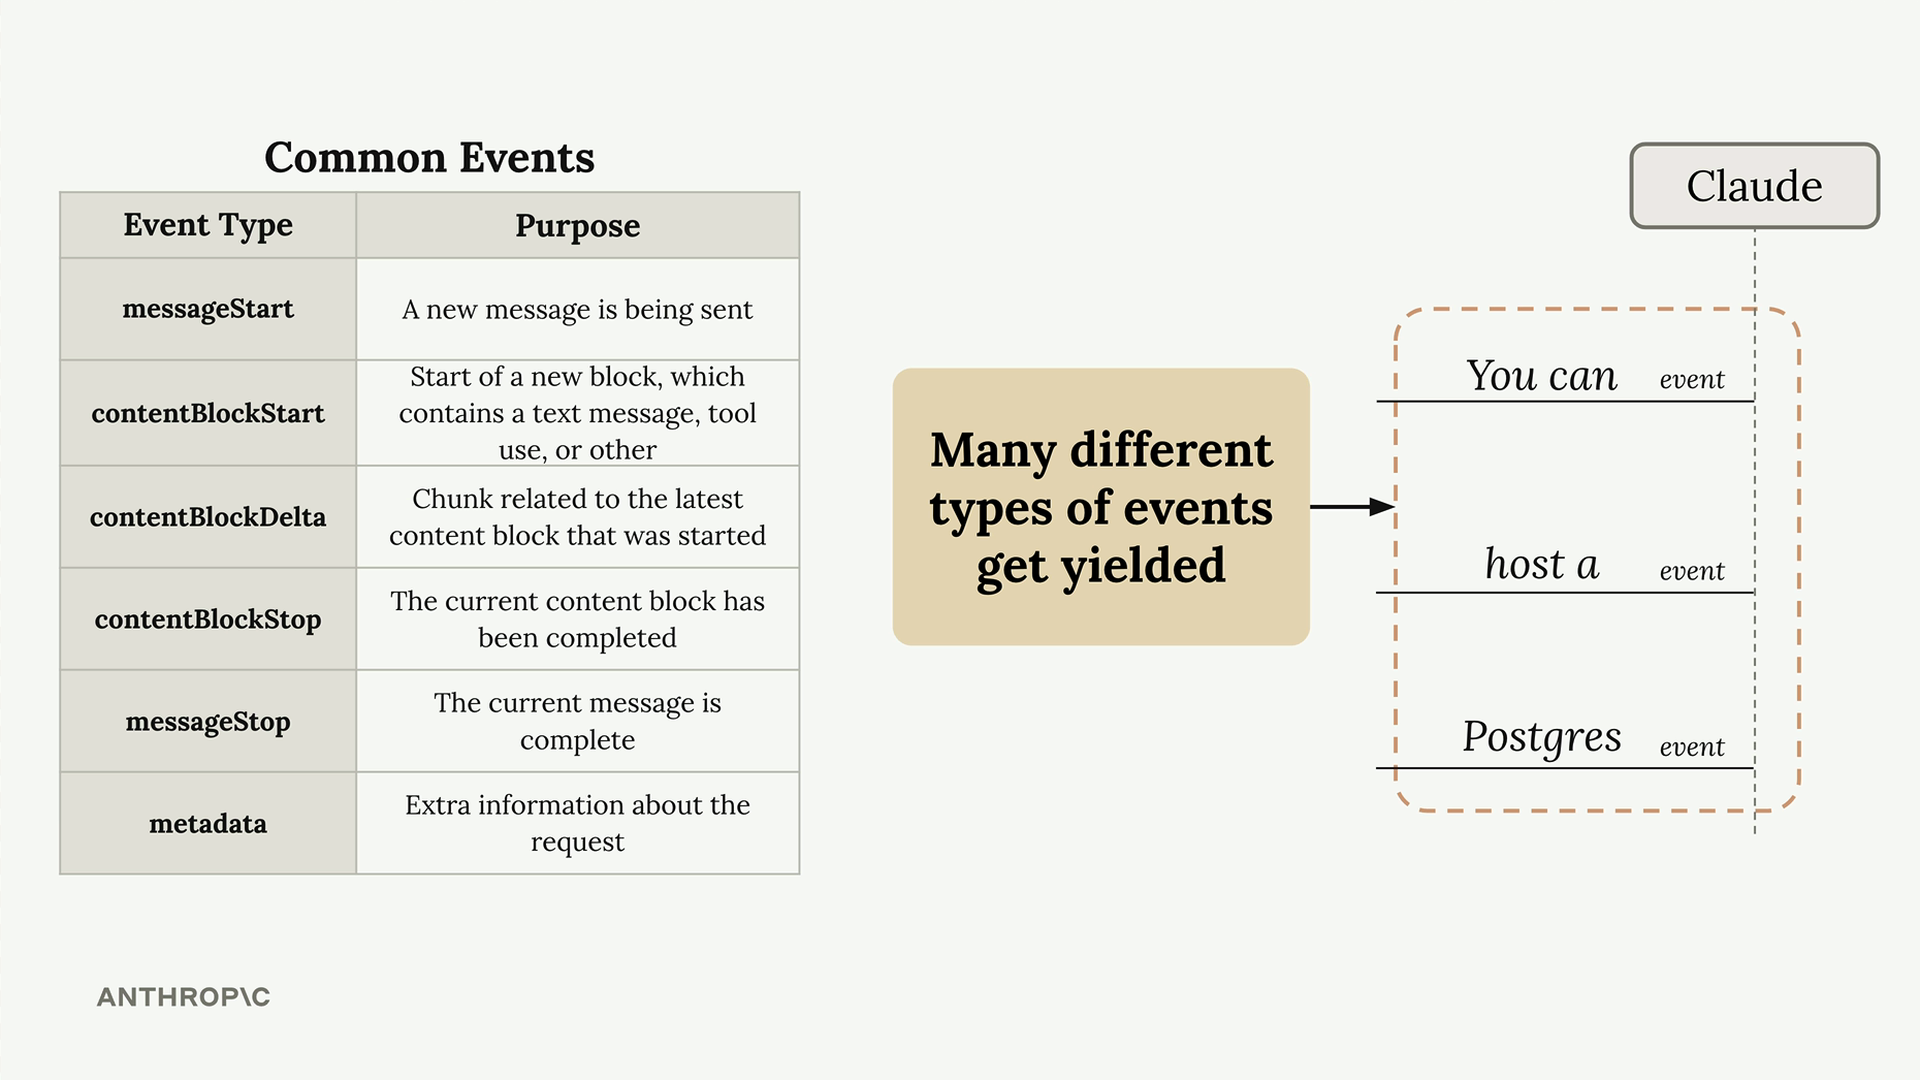
Für die grundlegende Textgenerierung musst du dich nur um contentBlockDelta-Events kümmern. Diese enthalten die tatsächlich generierten Textabschnitte, die du den Nutzern anzeigen möchtest.
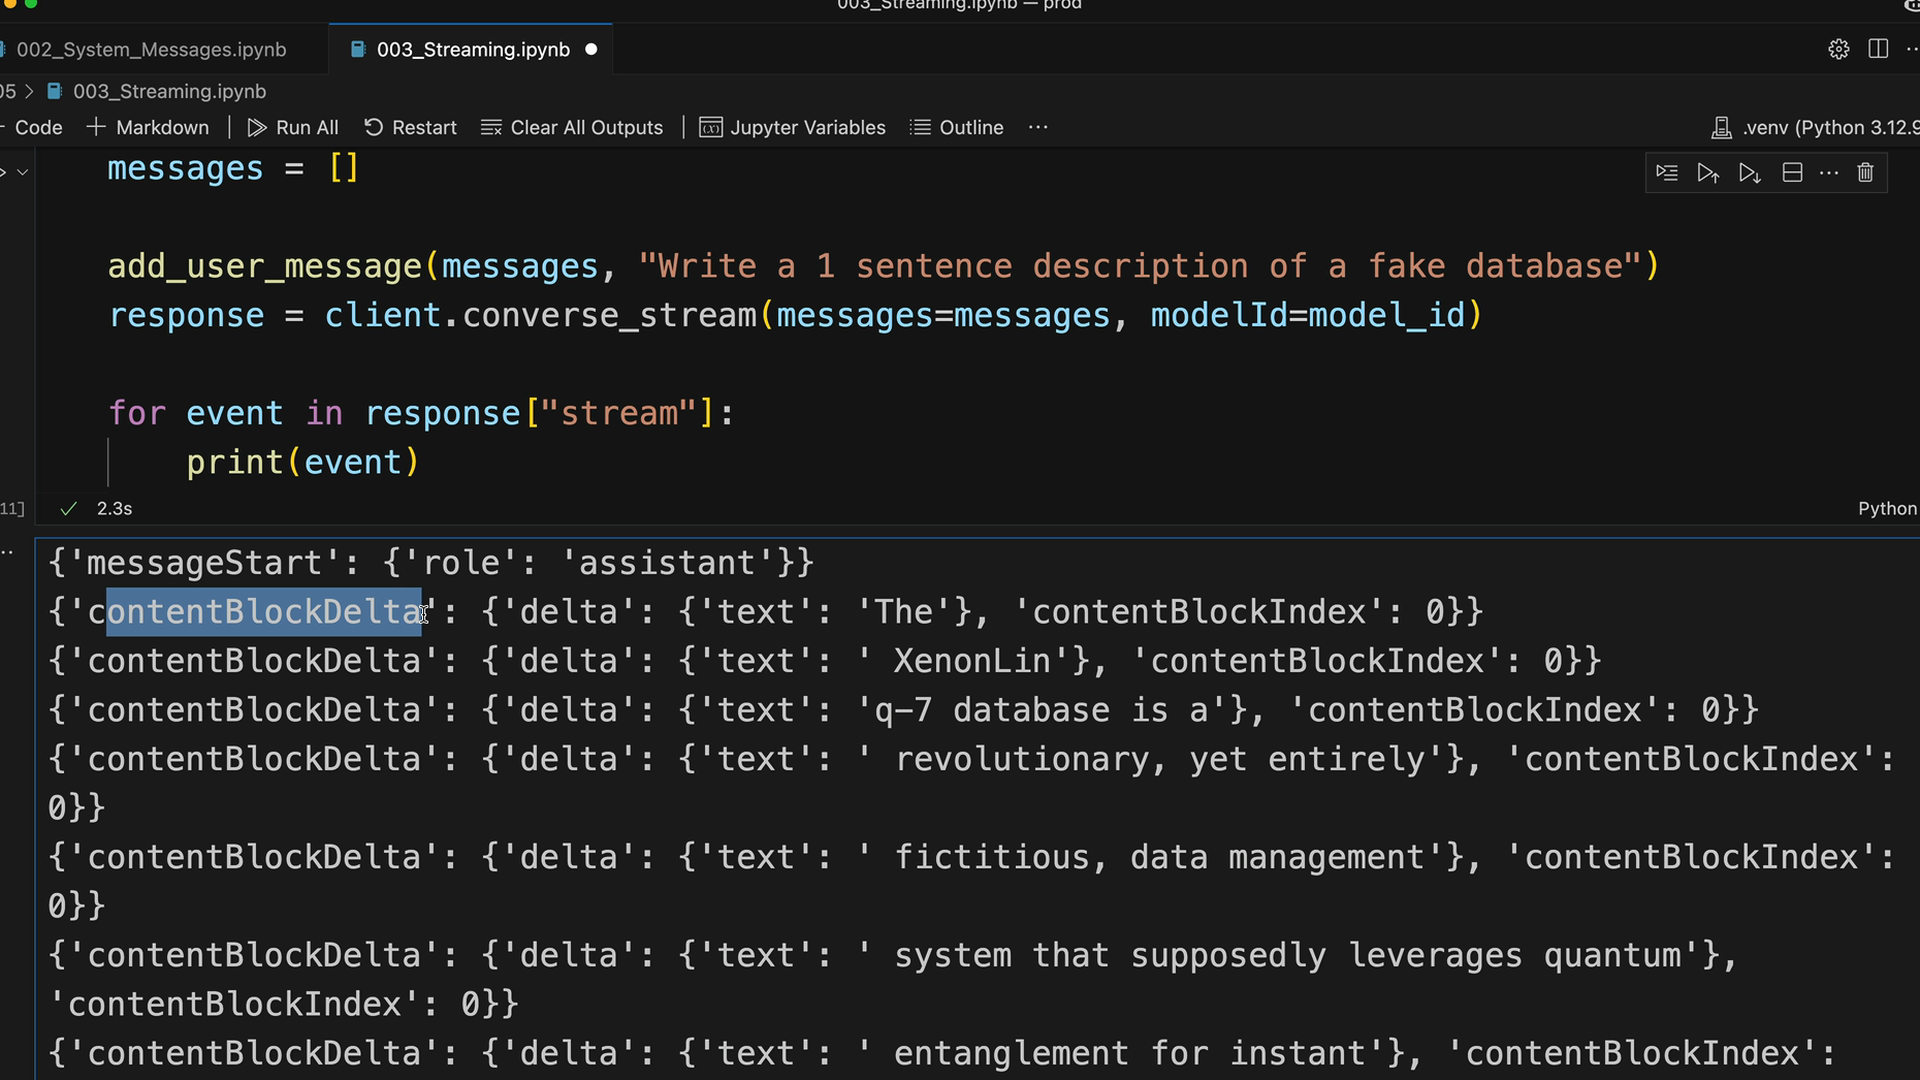
Die Events treffen immer in einer vorhersehbaren Reihenfolge ein: messageStart, mehrere contentBlockDelta-Events mit deinem Text, dann contentBlockStop, messageStop und schließlich metadata.
Den Text extrahieren
Um nur den generierten Text aus jedem Abschnitt zu erhalten, filtere nach contentBlockDelta-Events und extrahiere den Text:
text = ""
for event in response["stream"]:
    if "contentBlockDelta" in event:
        chunk = event["contentBlockDelta"]["delta"]["text"]
        print(chunk, end="")
        text += chunk

print("\n\nTotal Message:\n" + text)
Der Parameter end="" entfernt den automatischen Zeilenumbruch, den die print-Funktion von Python hinzufügt, wodurch der gestreamte Text natürlicher erscheint.
Praktische Anwendungen
In einer echten Anwendung würdest du, anstatt jeden Abschnitt auszugeben, typischerweise:
- Jeden Abschnitt über WebSockets oder Server-Sent Events an dein Frontend senden
- Die Benutzeroberfläche aktualisieren, um die wachsende Antwort in Echtzeit anzuzeigen
- Die vollständige Nachricht speichern, sobald das Streaming abgeschlossen ist
- Etwaige Fehler behandeln, die während des Streamings auftreten können
Dieser Streaming-Ansatz verwandelt die Nutzererfahrung von „absenden und warten" in „absenden und beobachten, wie die Antwort erscheint", wodurch sich deine KI-gestützten Anwendungen deutlich reaktionsschneller und ansprechender anfühlen.