Wenn du möchtest, dass Claude strukturierte Daten wie JSON, Python-Code oder Aufzählungslisten generiert, stößt du oft auf ein häufiges Problem: Claude möchte hilfreich sein und fügt erklärenden Text, Überschriften oder Markdown-Formatierung um deinen Inhalt hinzu. Dieser zusätzliche Kommentar stört die Nutzererfahrung, wenn du nur die reinen Daten benötigst.
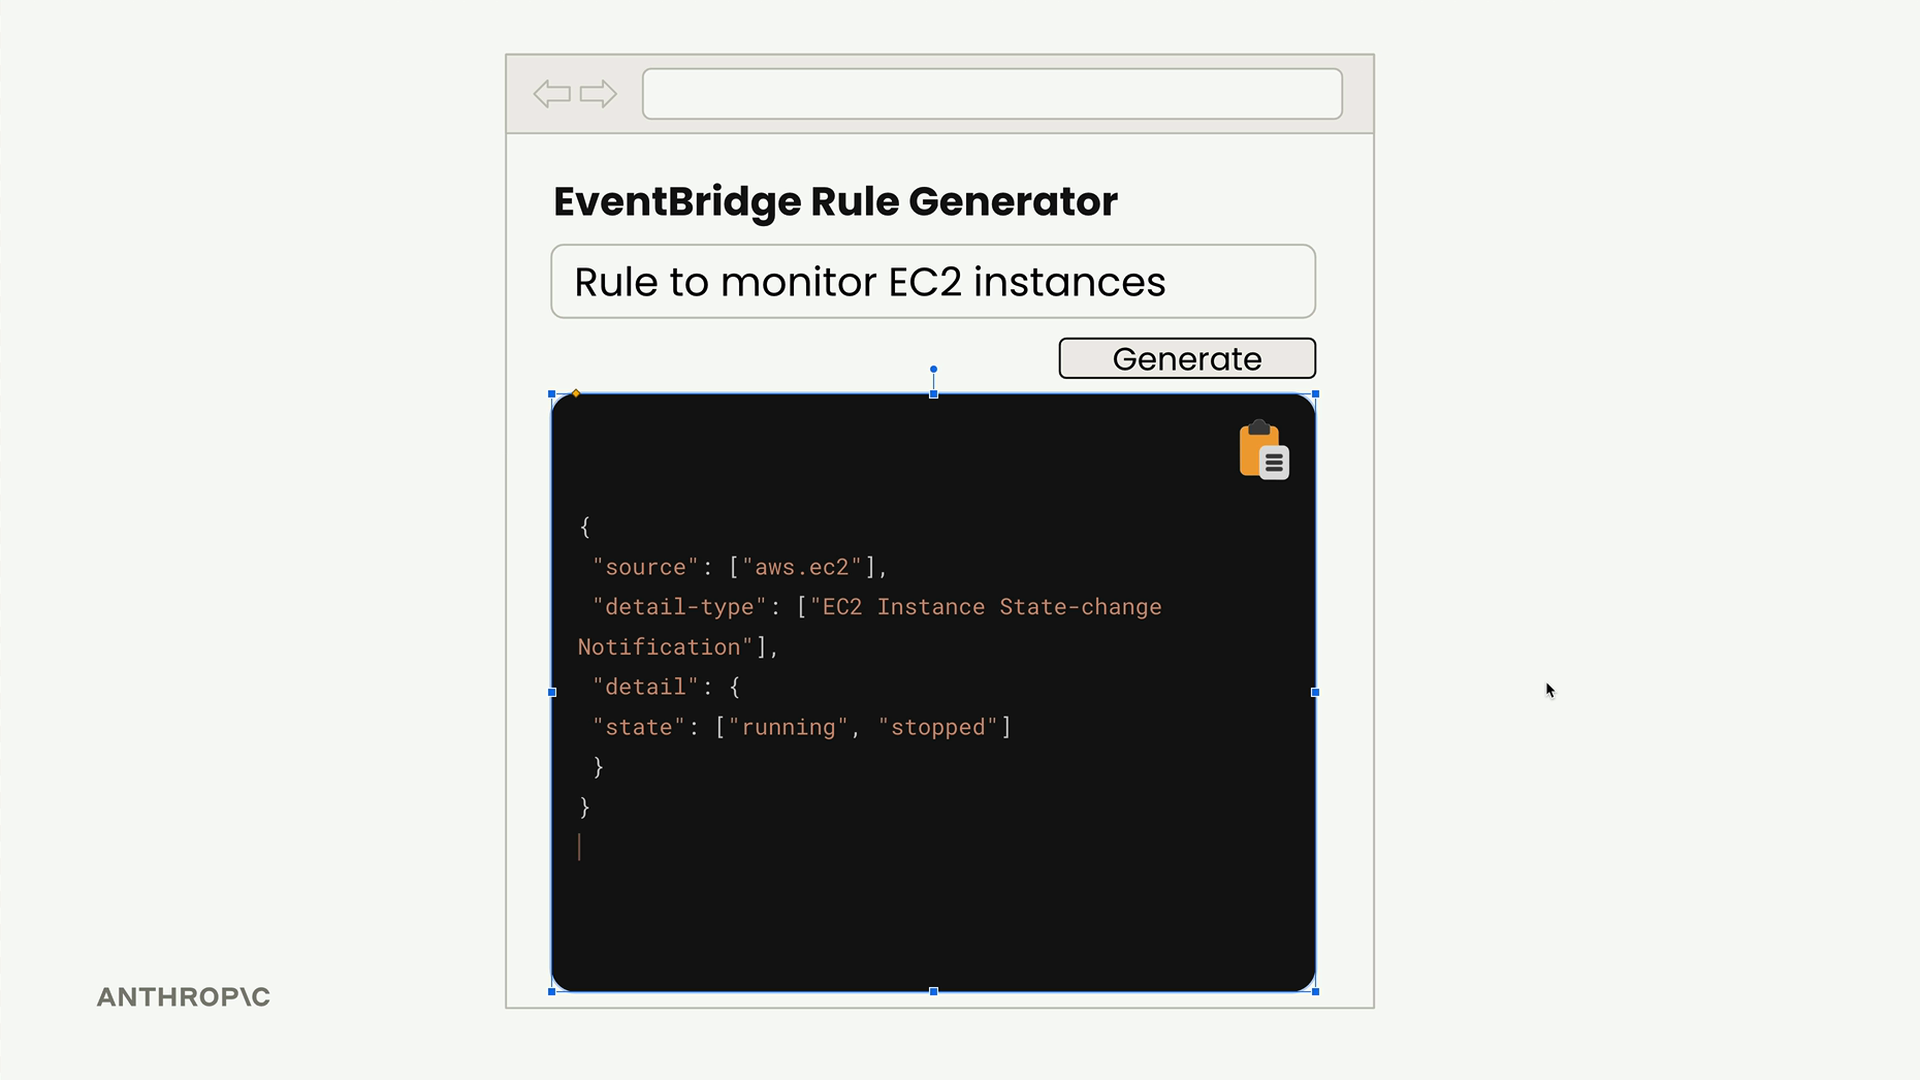
Stell dir vor, du baust eine Web-App, die AWS EventBridge-Regeln generiert. Nutzer geben eine Beschreibung ein, klicken auf „Generieren" und erwarten, sauberes JSON zu sehen, das sie sofort kopieren und verwenden können. Wenn Claude das JSON in Markdown-Codeblöcke mit erklärendem Text eingebettet zurückgibt, können Nutzer nicht einfach die gesamte Antwort kopieren - sie müssen manuell nur den JSON-Teil auswählen.
Das Problem mit Standardantworten
Standardmäßig formatiert Claude strukturierte Ausgaben tendenziell so:
# EventBridge Rule
```json
\{
  "source": ["aws.ec2"],
  "detail-type": ["EC2 Instance State-change Notification"],
  "detail": \{"state": ["running"]\}
\}
```
This rule captures EC2 instance state changes when instances start running or stop.
Während dies für Dokumentation großartig ist, ist es problematisch, wenn du nur das JSON für die programmatische Nutzung benötigst.
Die Lösung: Assistant-Message-Prefilling + Stop-Sequenzen
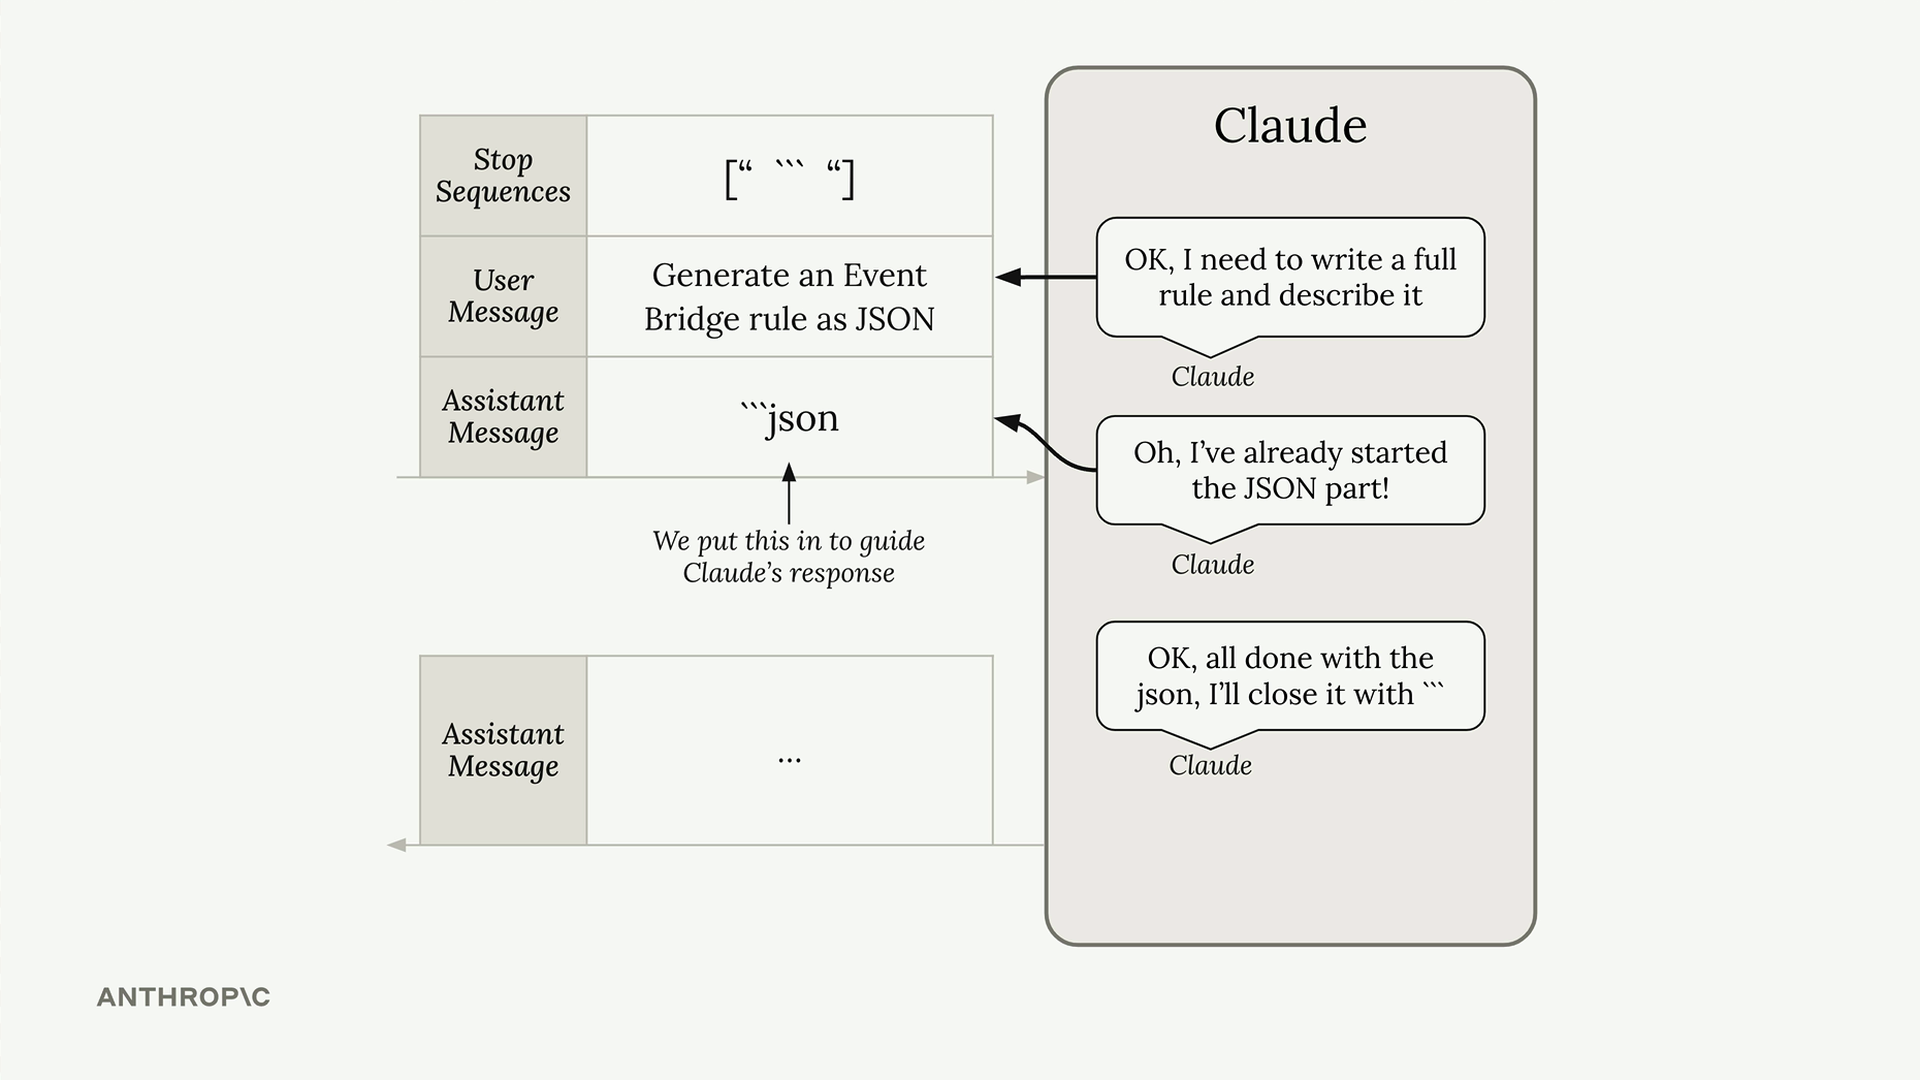
Du kannst Assistant-Message-Prefilling mit Stop-Sequenzen kombinieren, um genau den Inhalt zu erhalten, den du möchtest. So funktioniert es:
messages = []
add_user_message(messages, "Generate a very short event bridge rule as json")
add_assistant_message(messages, "```json")

text = chat(messages, stop_sequences=["```"])
Diese Technik funktioniert folgendermaßen:
- Die Assistant-Message wird mit dem öffnenden Markdown-Begrenzer vorausgefüllt
- Eine Stop-Sequenz wird gesetzt, um die Generierung zu stoppen, wenn Claude versucht, den Codeblock zu schließen
- Nur der Inhalt zwischen diesen Begrenzern wird erfasst
Wie es im Hintergrund funktioniert
Wenn Claude deine Anfrage erhält, sieht es die vorausgefüllte Assistant-Message und geht davon aus, dass es bereits begonnen hat, den JSON-Codeblock zu schreiben. Anstatt eine eigene Überschrift und einen öffnenden Begrenzer hinzuzufügen, springt Claude direkt zur Generierung des eigentlichen JSON-Inhalts.
Wenn Claude mit dem JSON fertig ist und auf natürliche Weise den Markdown-Codeblock mit ``` schließen möchte, stoppt die Stop-Sequenz sofort die Generierung und gibt die Antwort zurück. Du erhältst nur den JSON-Inhalt ohne zusätzliche Formatierung.
Verarbeitung der Ergebnisse
Der zurückgegebene Text könnte einige Zeilenumbruchzeichen enthalten, aber du kannst das leicht bereinigen:
import json

# Als JSON parsen, um zu validieren und zu formatieren
parsed_data = json.loads(text.strip())

# Oder bei anderen Datentypen einfach Leerzeichen entfernen
clean_text = text.strip()
Über JSON hinaus
Diese Technik ist nicht auf die JSON-Generierung beschränkt. Du kannst sie für jede strukturierte Daten verwenden, bei denen du nur den Inhalt ohne Claudes natürliche Tendenz, erklärenden Text hinzuzufügen, möchtest:
- Python-Code-Snippets
- Aufzählungslisten
- CSV-Daten
- Konfigurationsdateien
- Jedes Format, bei dem saubere, kopierbare Ausgabe wichtig ist
Der Schlüssel liegt darin, zu identifizieren, welche Begrenzer Claude natürlicherweise um deinen Inhaltstyp verwenden würde, und dann den öffnenden Begrenzer vorauszufüllen und beim schließenden zu stoppen. Dies gibt dir präzise Kontrolle über das Ausgabeformat, während du Claudes natürliche Formatierungsinstinkte nutzt.