Der Aufbau von Multi-Turn-Konversationen mit Tool-Nutzung erfordert die Handhabung unterschiedlicher Antworttypen von Claude. Wenn Claude antwortet, muss es möglicherweise ein Tool verwenden, oder es liefert eine direkte Antwort. Dein Code muss beide Szenarien elegant behandeln können.
Das Problem mit einfacher Tool-Integration
Wenn du einfach jeder Konversation Tool-Ergebnisse hinzufügst, wirst du auf Probleme stoßen. Wenn Claude eine einfache Frage wie „Was ist 1+1?" beantwortet, benötigt es keine Tools. Aber wenn dein Code immer versucht, Tool-Ergebnisse zu verarbeiten, fügst du am Ende leere Nachrichten zu deinem Konversationsverlauf hinzu.
Die Lösung besteht darin, den stop_reason zu überprüfen, der mit jeder Claude-Antwort zurückkommt. Dieser sagt dir, warum Claude die Generierung gestoppt hat – ob es auf natürliche Weise fertig war oder weil es ein Tool verwenden möchte.
Stop-Gründe
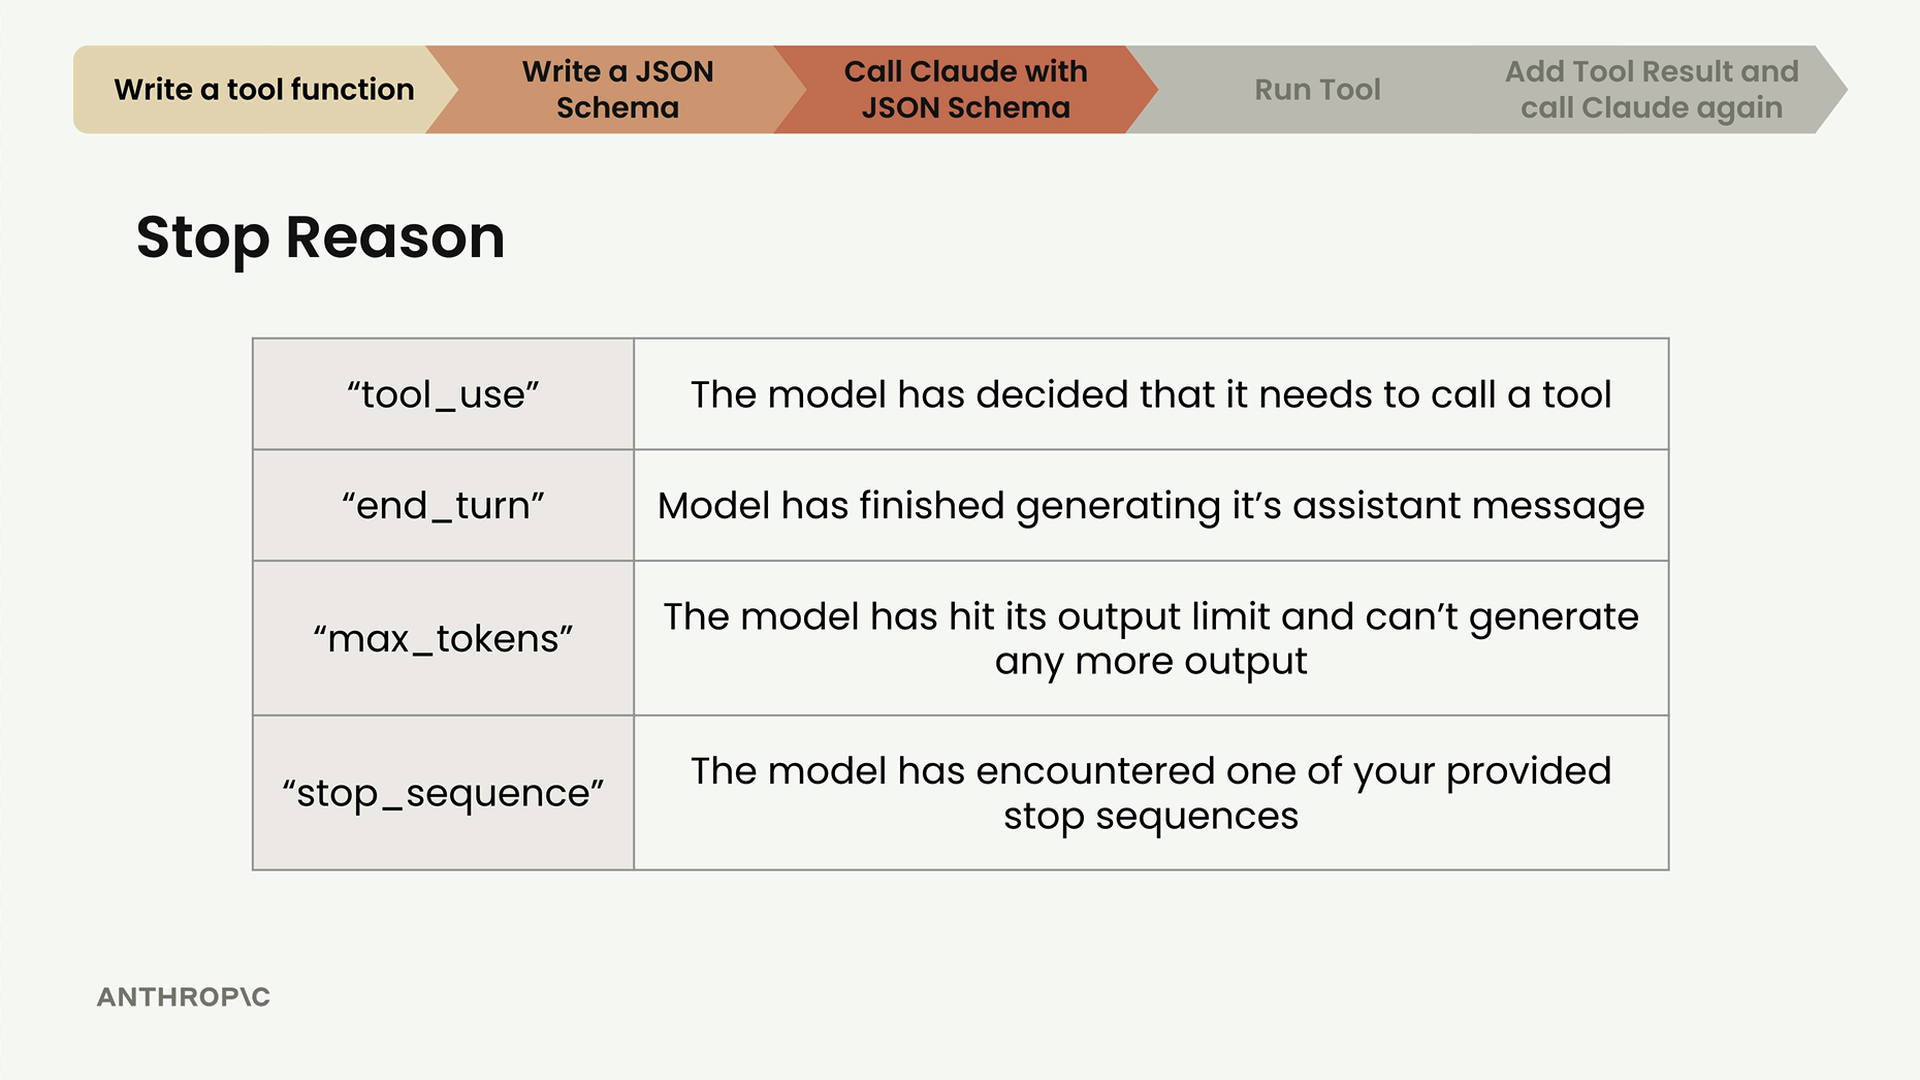
Claude kann aus mehreren Gründen stoppen:
"tool_use"- Das Modell möchte ein Tool aufrufen"end_turn"- Das Modell hat die Generierung seiner Antwort abgeschlossen"max_tokens"- Das Ausgabelimit wurde erreicht"stop_sequence"- Eine von dir angegebene Stop-Sequenz wurde erkannt
Verbesserung der Chat-Funktion
Aktualisiere zunächst deine Chat-Funktion, um mehr Informationen zurückzugeben. Anstatt nur Text und Teile getrennt zurückzugeben, gib ein Dictionary mit allem zurück, was du benötigst:
def chat(messages, tools=None, system=None, **kwargs):
    # ... bestehender Code ...

    return {
        "parts": parts,
        "stop_reason": response["stopReason"],
        "text": "\n".join([p["text"] for p in parts if "text" in p])
    }
Dieser Ansatz extrahiert den gesamten Textinhalt aus den Antwortteilen, was robuster ist, als anzunehmen, dass der erste Teil immer Text ist.
Aufbau einer Konversationsschleife
Erstelle eine Funktion, die den gesamten Konversationsablauf handhabt:
def run_conversation(messages):
    while True:
        result = chat(messages, tools=[get_current_datetime_schema])

        add_assistant_message(messages, result["parts"])
        print(result["text"])

        if result["stop_reason"] != "tool_use":
            break

        tool_result_parts = run_tools(result["parts"])
        add_user_message(messages, tool_result_parts)

    return messages
Diese Schleife läuft weiter, bis Claude aus einem anderen Grund als Tool-Nutzung stoppt. Jede Iteration:
- Sendet die aktuellen Nachrichten an Claude
- Fügt Claudes Antwort zum Nachrichtenverlauf hinzu
- Prüft, ob Claude ein Tool verwenden möchte
- Falls ja, führt die Tools aus und fügt die Ergebnisse wieder der Konversation hinzu
- Falls nicht, beendet die Schleife
Testen der Implementierung
Dieser Ansatz behandelt sowohl Fragen, die Tools erfordern, als auch einfache Fragen:
# Frage, die ein Tool erfordert
messages = []
add_user_message(messages, "What time is it?")
run_conversation(messages)

# Einfache Frage
messages = []
add_user_message(messages, "What is 1+1?")
run_conversation(messages)
Bei Zeitfragen wird Claude das Datetime-Tool verwenden. Bei Mathefragen antwortet es direkt, ohne Tool-Aufrufe. Die Konversationsschleife passt sich automatisch basierend auf Claudes Stop-Grund an.
Dieses Muster skaliert gut, wenn du weitere Tools hinzufügst – dieselbe Schleife handhabt jede Kombination aus Tool-Nutzung und direkten Antworten, was deine konversationelle KI robuster und natürlicher macht.