Wenn du sowohl semantische Suche (Vektor-Embeddings) als auch lexikalische Suche (BM25) unabhängig voneinander funktionierend hast, ist der nächste Schritt, sie zu einer einheitlichen Such-Pipeline zu kombinieren. Dieser hybride Ansatz nutzt die Stärken beider Methoden, um genauere Ergebnisse zu liefern.
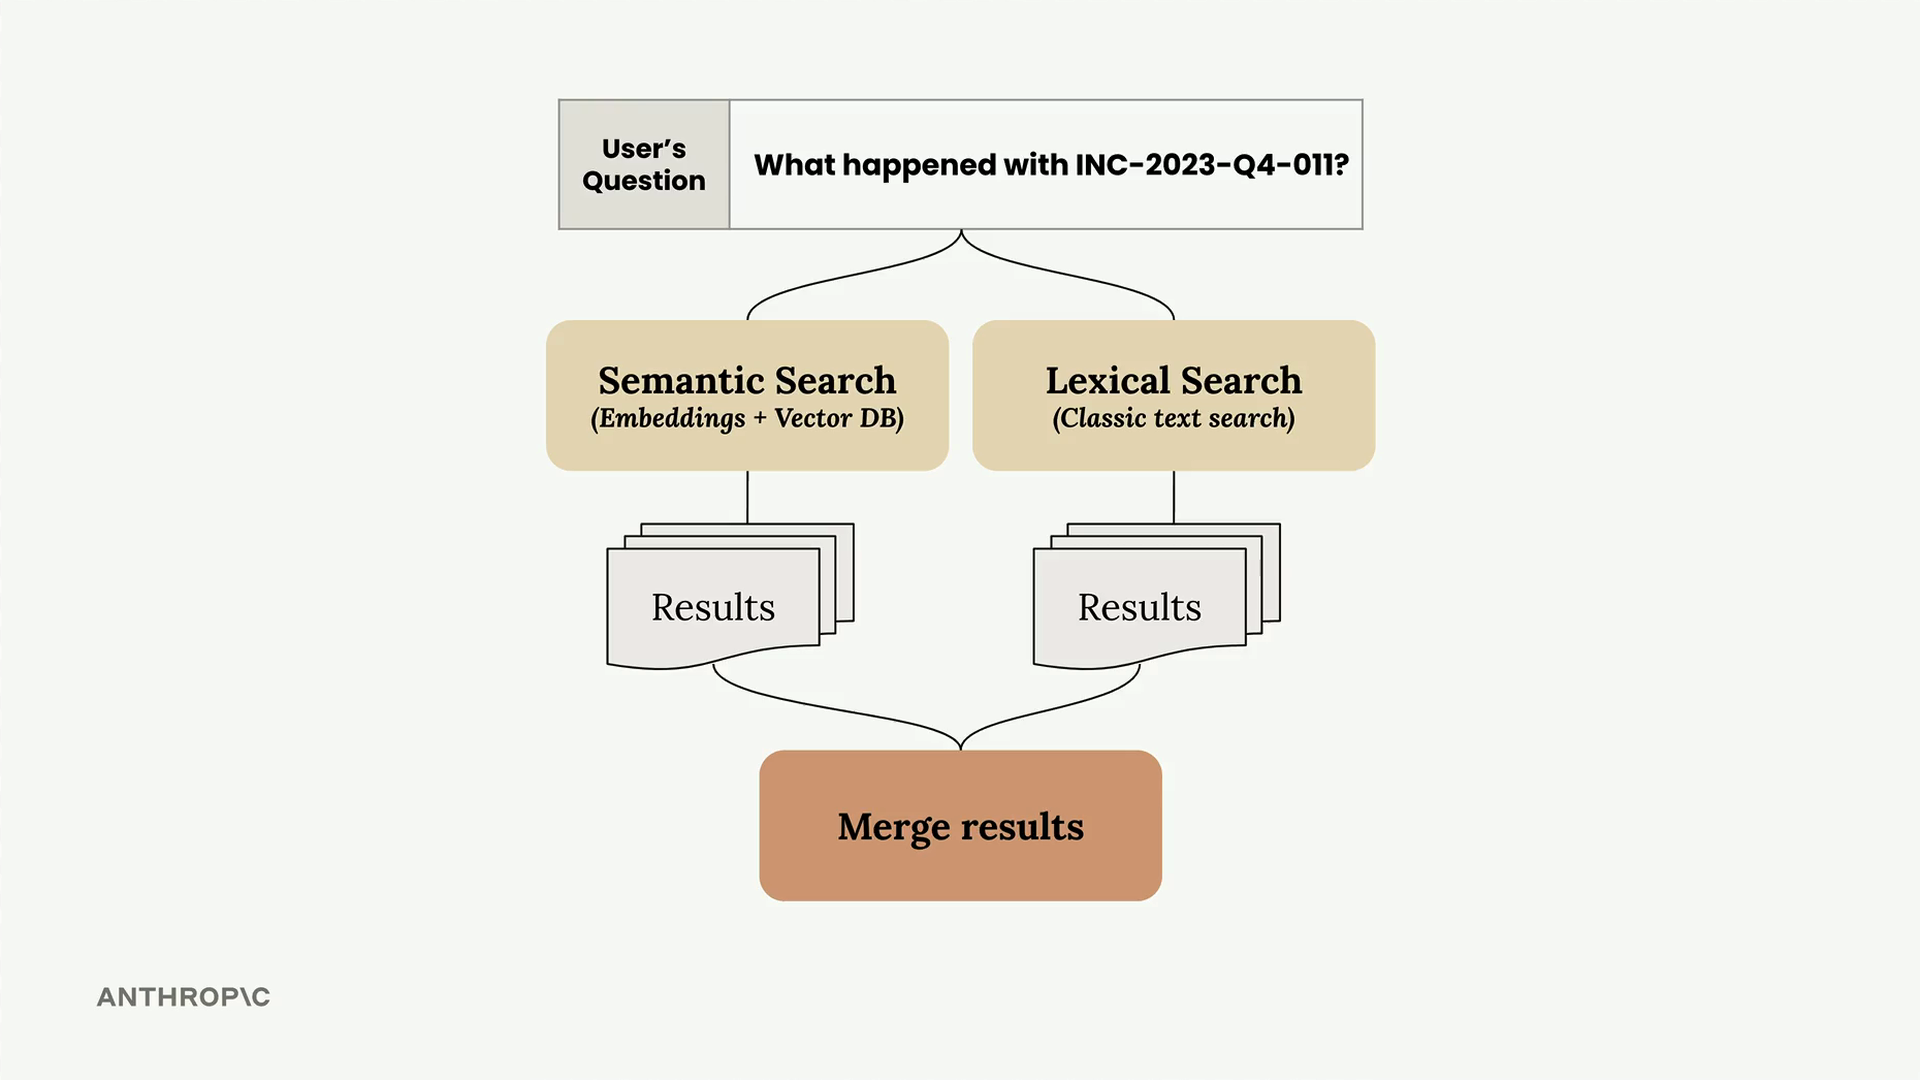
Aufbau einer einheitlichen Schnittstelle
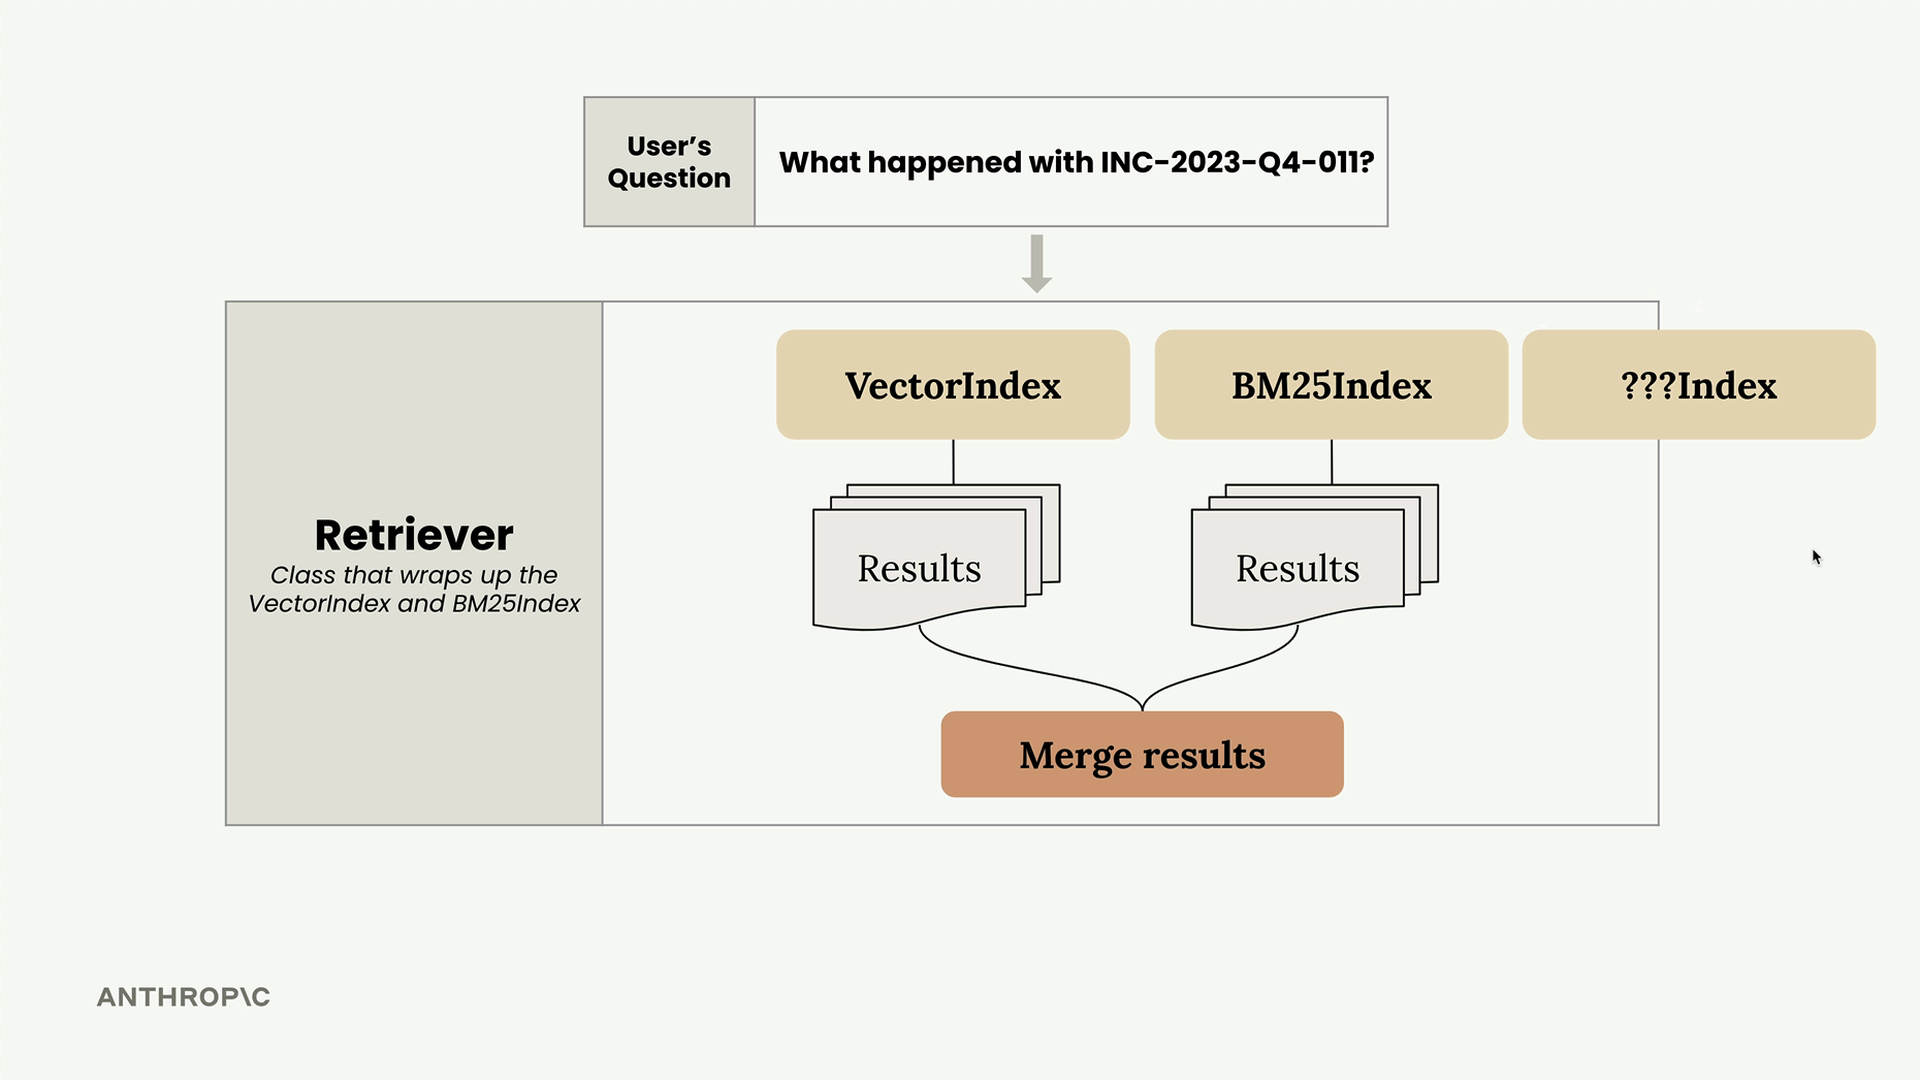
Beide Suchimplementierungen teilen sich nahezu identische APIs - beide verfügen über die Methoden add_document() und search(). Diese Konsistenz macht es einfach, sie in einer einzigen Retriever-Klasse zu kapseln, die zwischen den beiden Ansätzen koordiniert.
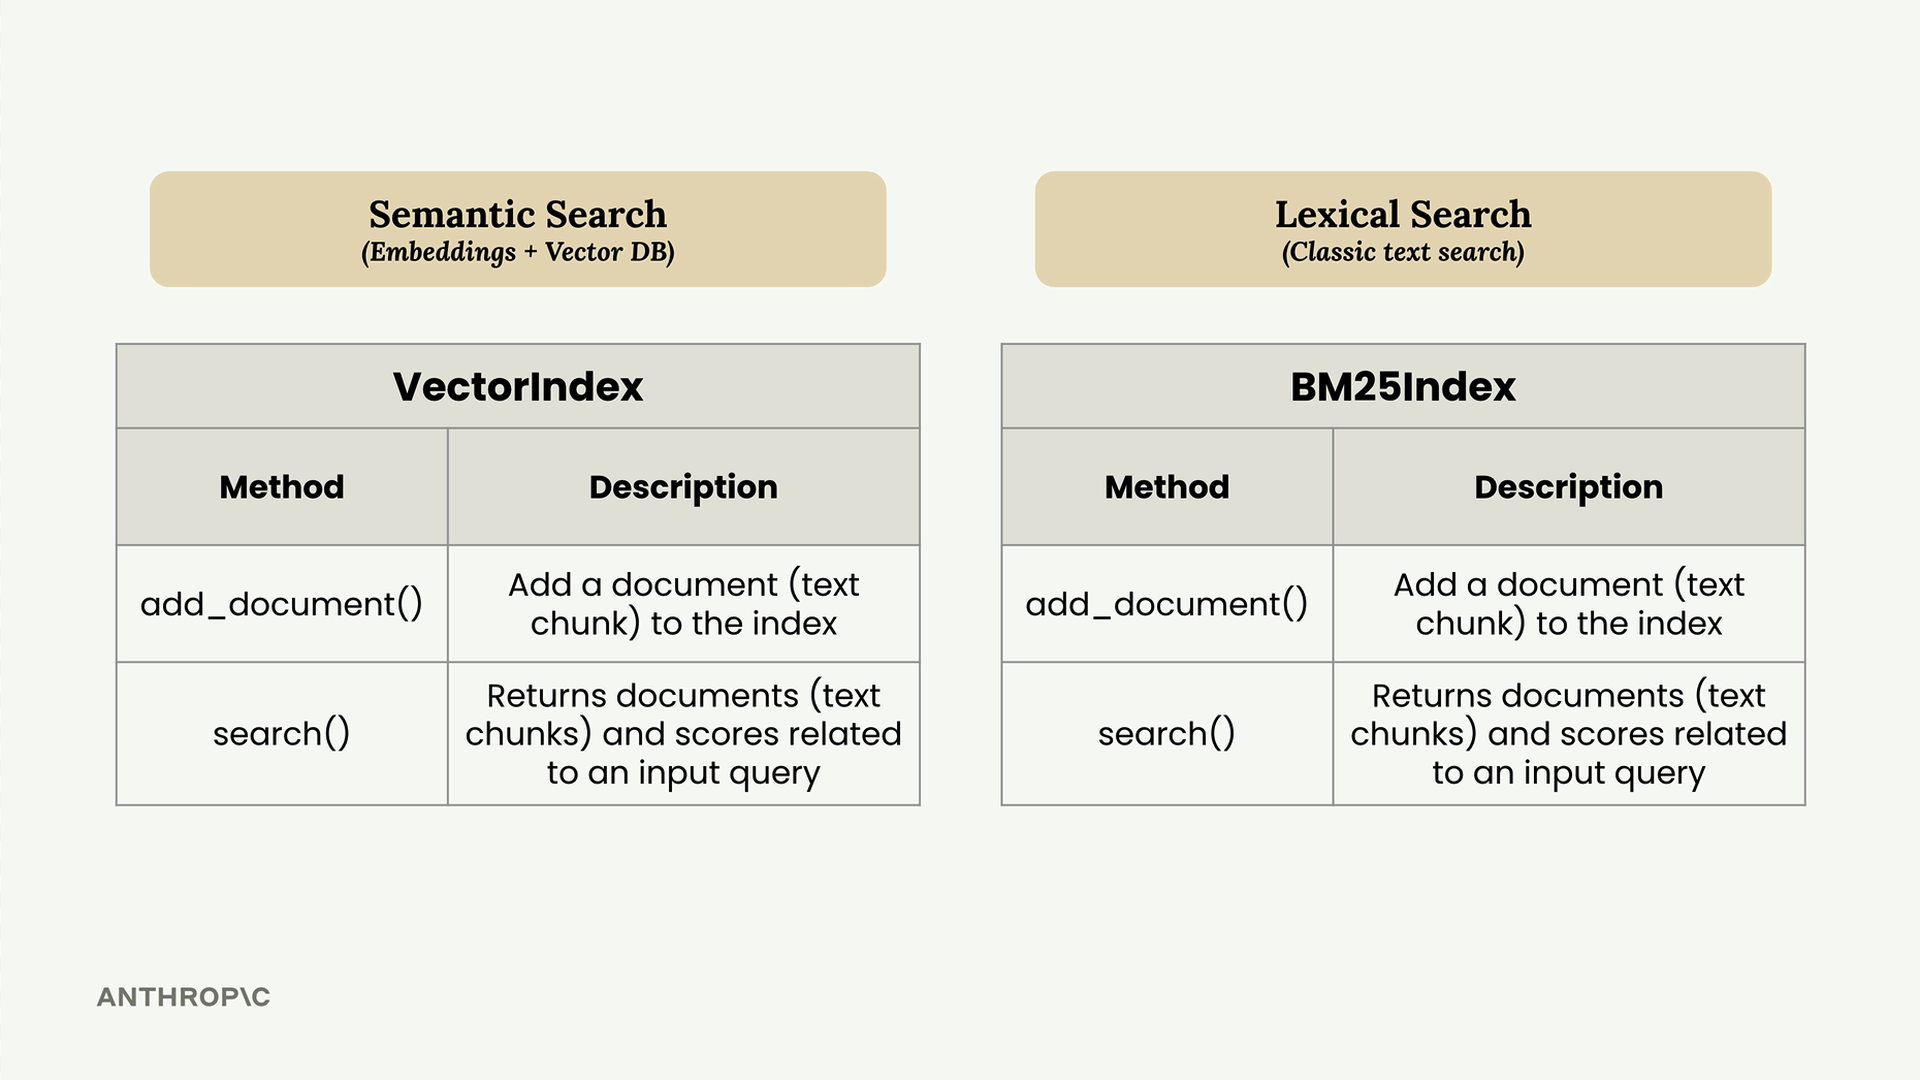
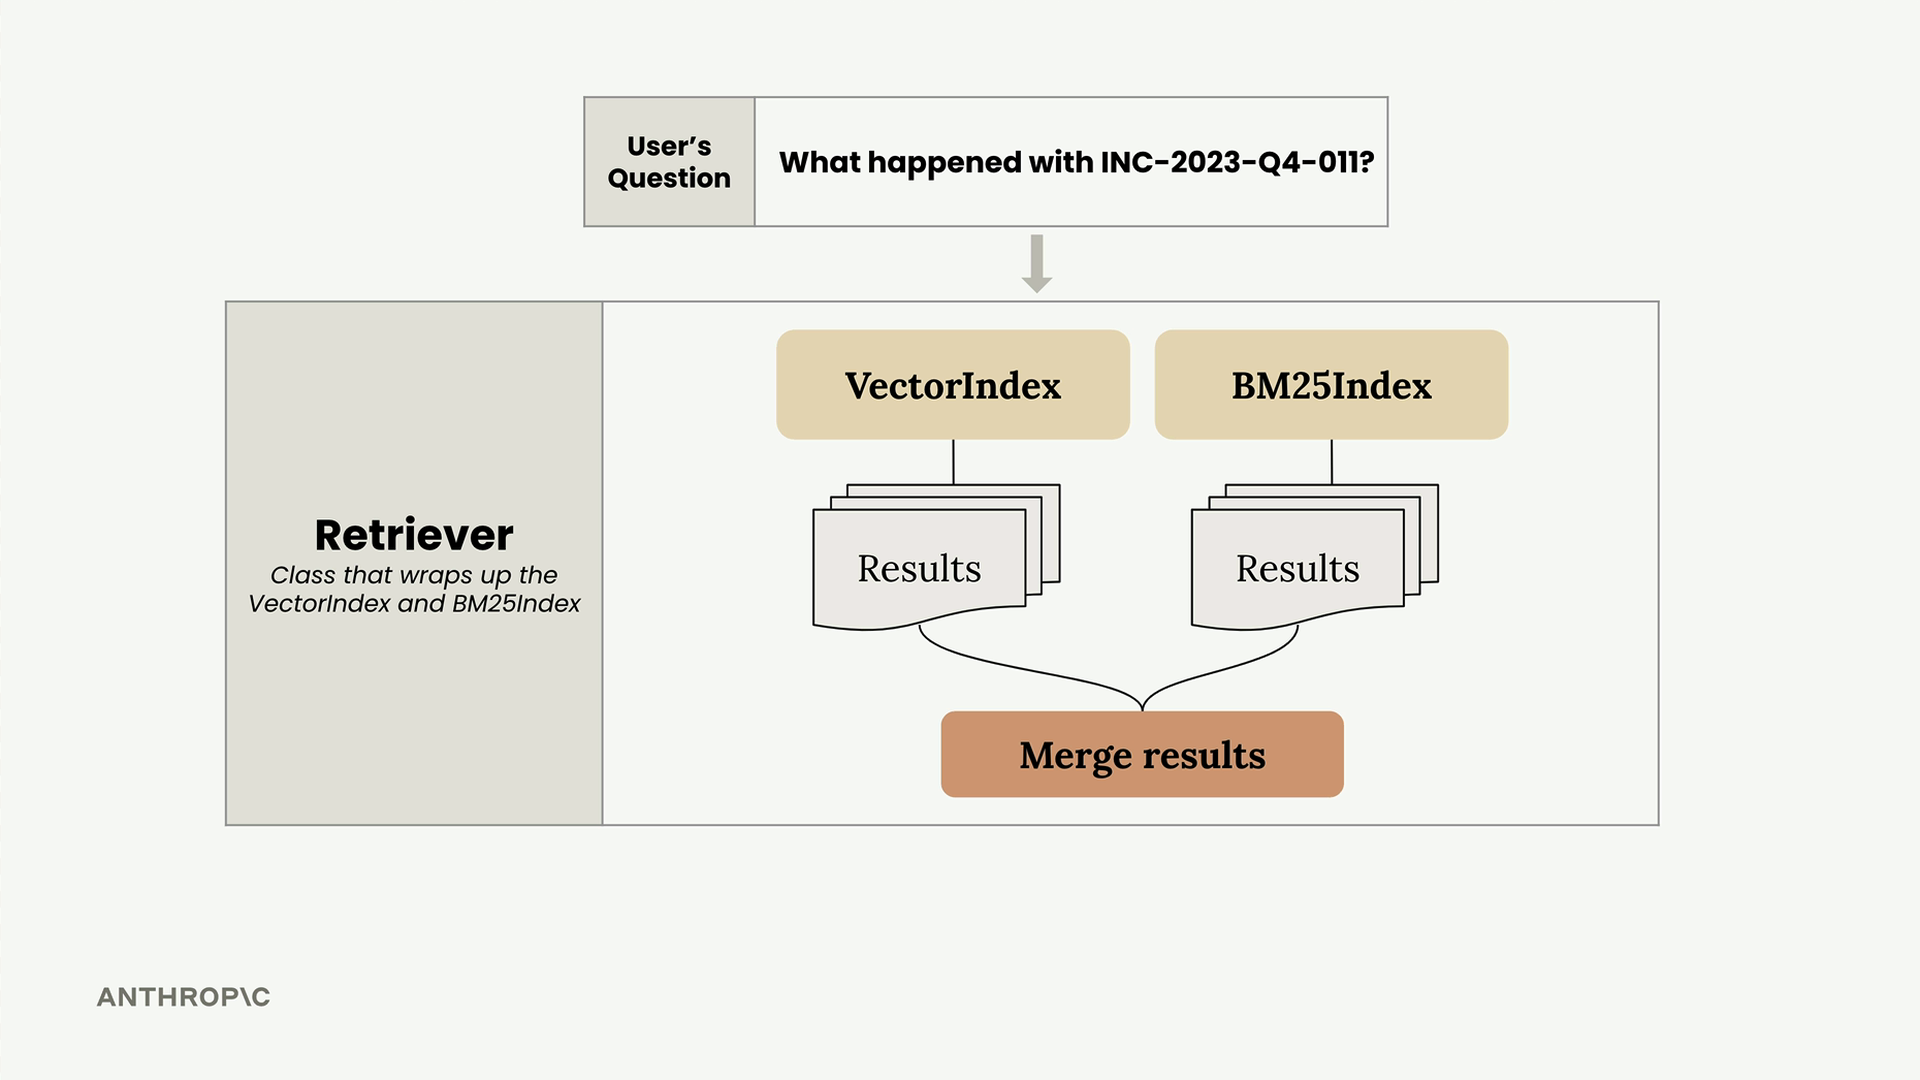
Der Retriever fungiert als Koordinator, der:
- Die Frage eines Nutzers empfängt
- Sie an den VectorIndex und den BM25Index weiterleitet
- Ergebnisse von beiden Systemen sammelt
- Die Ergebnisse mithilfe eines Ranking-Algorithmus zusammenführt
Reciprocal Rank Fusion
Die Herausforderung liegt im Zusammenführen von Ergebnissen aus unterschiedlichen Suchmethoden. Jedes System liefert Ergebnisse mit unterschiedlichen Bewertungsmechanismen, sodass du die Scores nicht einfach direkt kombinieren kannst. Stattdessen verwenden wir eine Technik namens Reciprocal Rank Fusion (RRF).
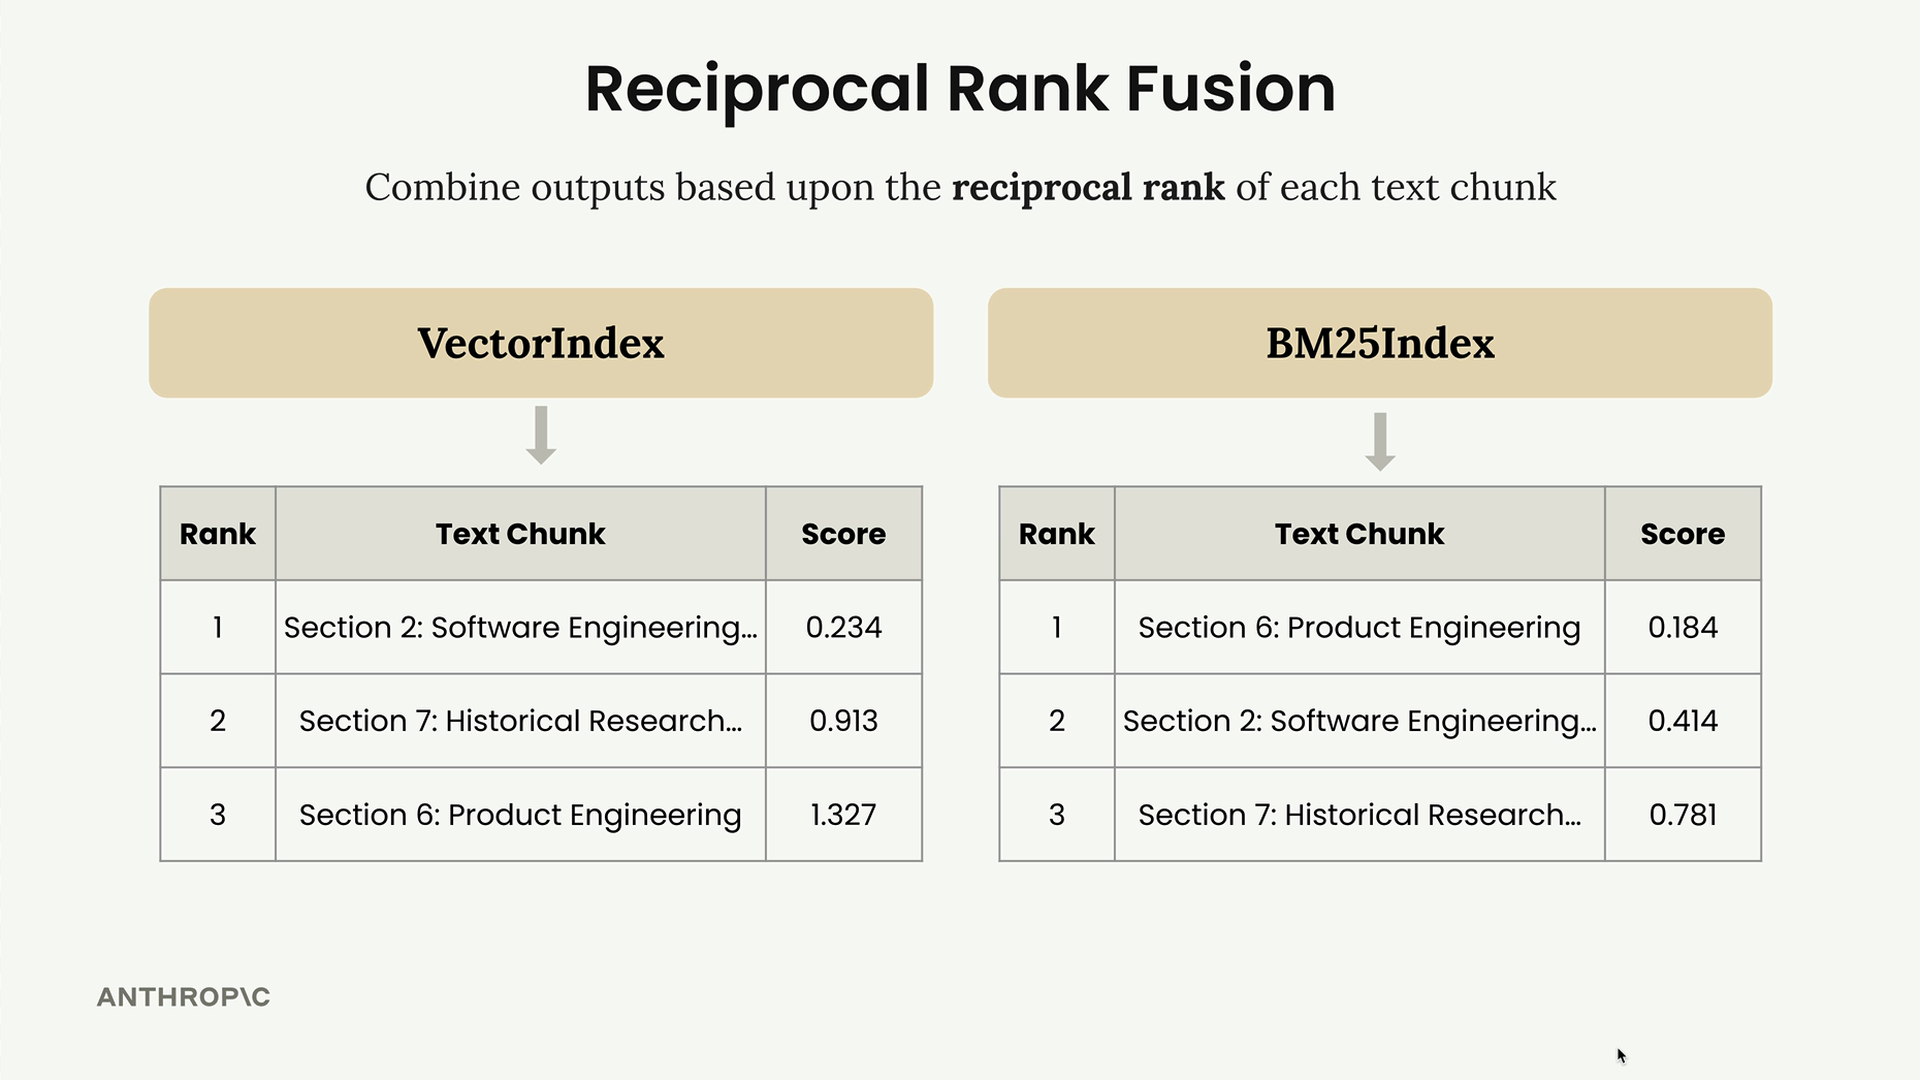
So funktioniert RRF anhand eines praktischen Beispiels. Angenommen, dein VectorIndex liefert Ergebnisse in folgender Rangfolge: Abschnitt 2, Abschnitt 7, Abschnitt 6. Dein BM25Index liefert hingegen: Abschnitt 6, Abschnitt 2, Abschnitt 7.
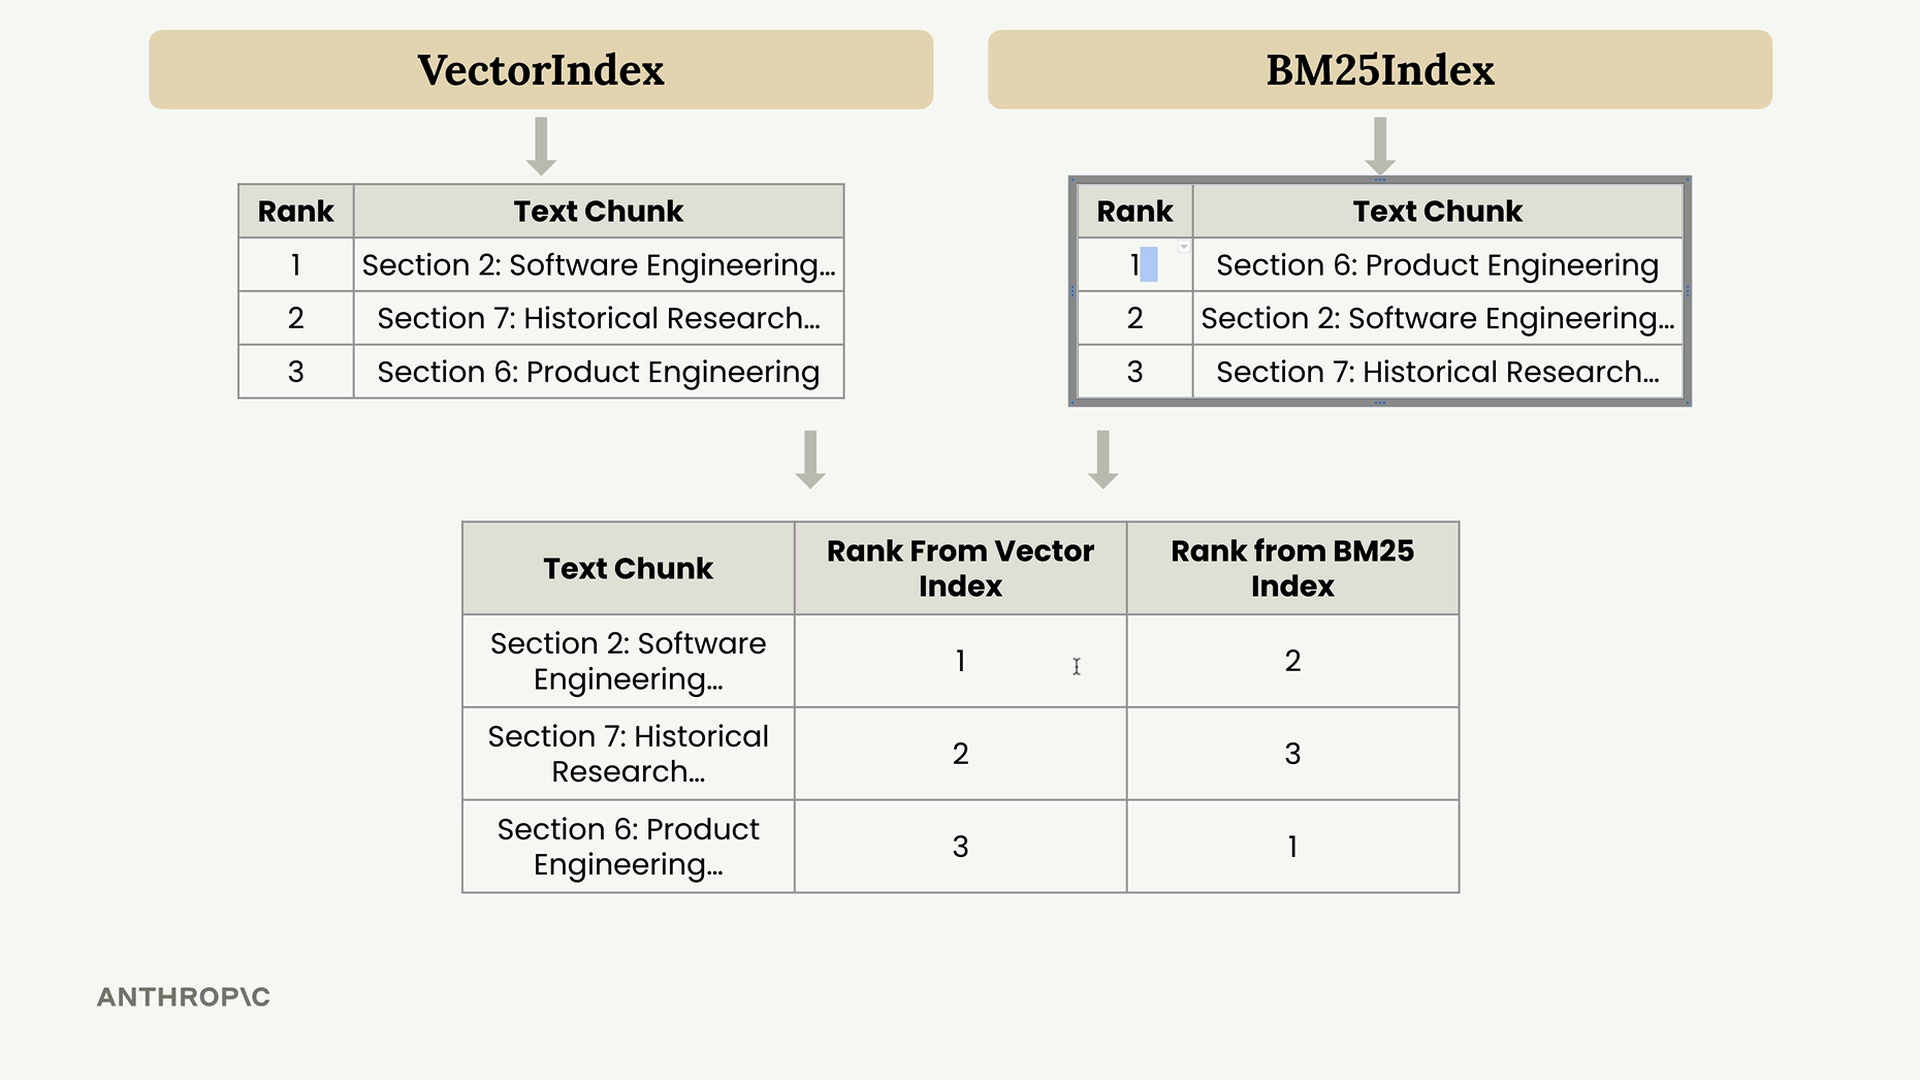
Um diese Ergebnisse zusammenzuführen, erstellst du eine kombinierte Tabelle, die den Rang jedes Textabschnitts in beiden Systemen zeigt:
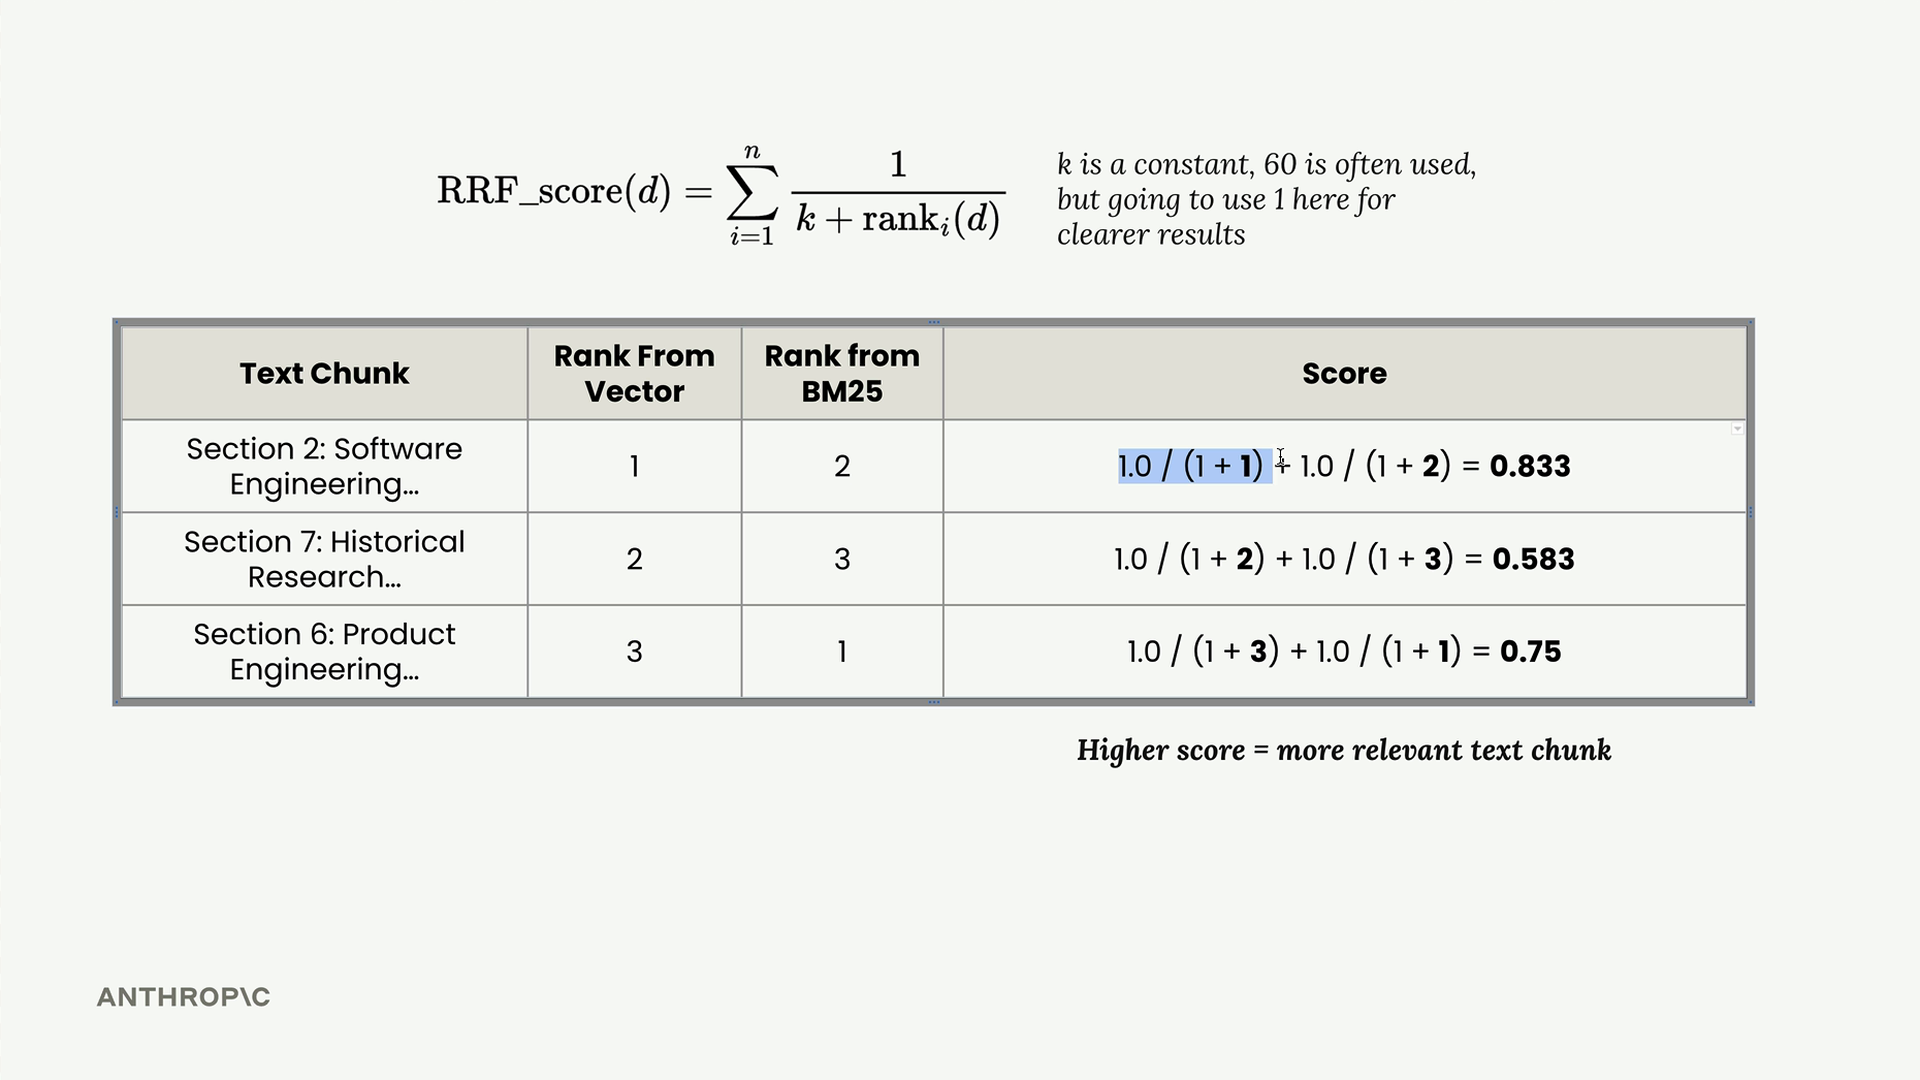
Die RRF-Formel berechnet einen Score für jedes Dokument:
RRF_score(d) = Σ(1 / (k + rank_i(d)))Dabei ist k eine Konstante (typischerweise 60, obwohl 1 für klarere Ergebnisse gut funktioniert) und rank_i(d) der Rang des Dokuments d im i-ten Ranking-System.
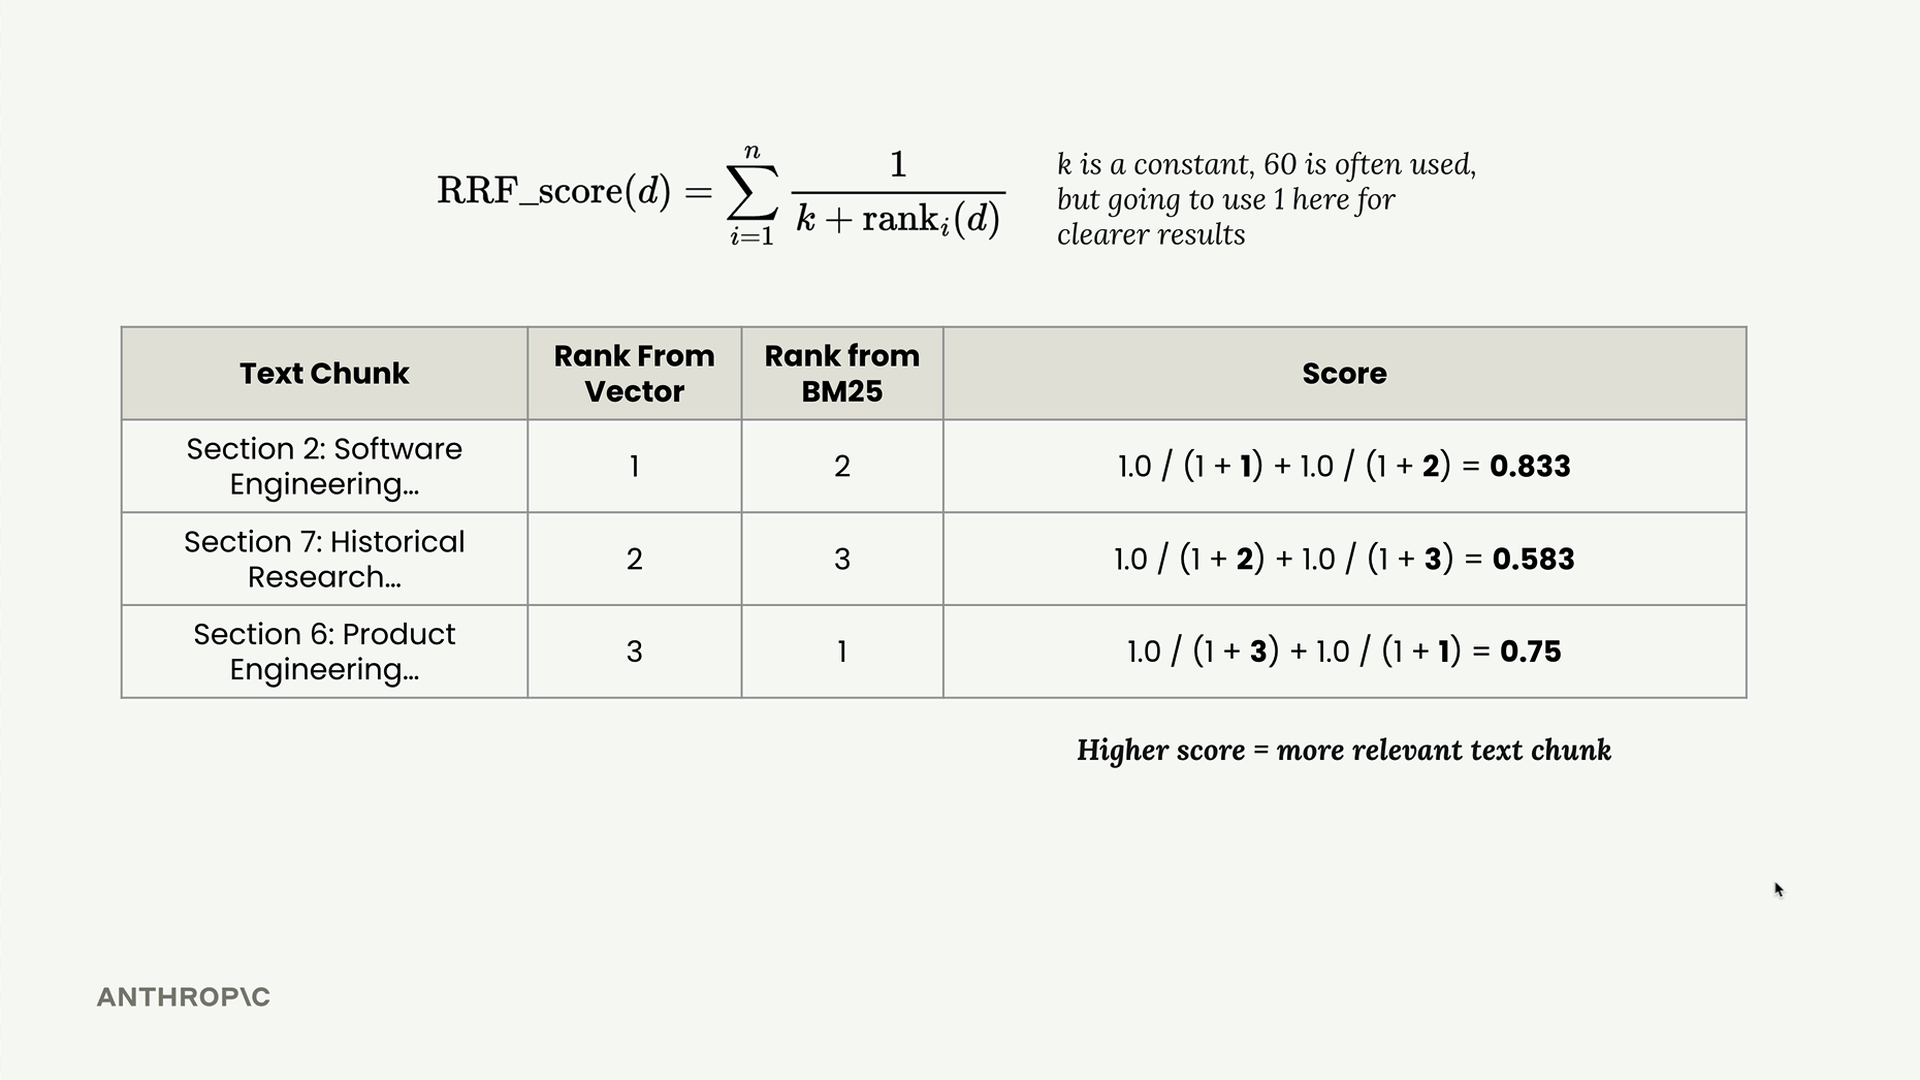
Für jeden Textabschnitt berechnest du:
- Abschnitt 2: 1,0/(1+1) + 1,0/(1+2) = 0,833
- Abschnitt 7: 1,0/(1+2) + 1,0/(1+3) = 0,583
- Abschnitt 6: 1,0/(1+3) + 1,0/(1+1) = 0,75
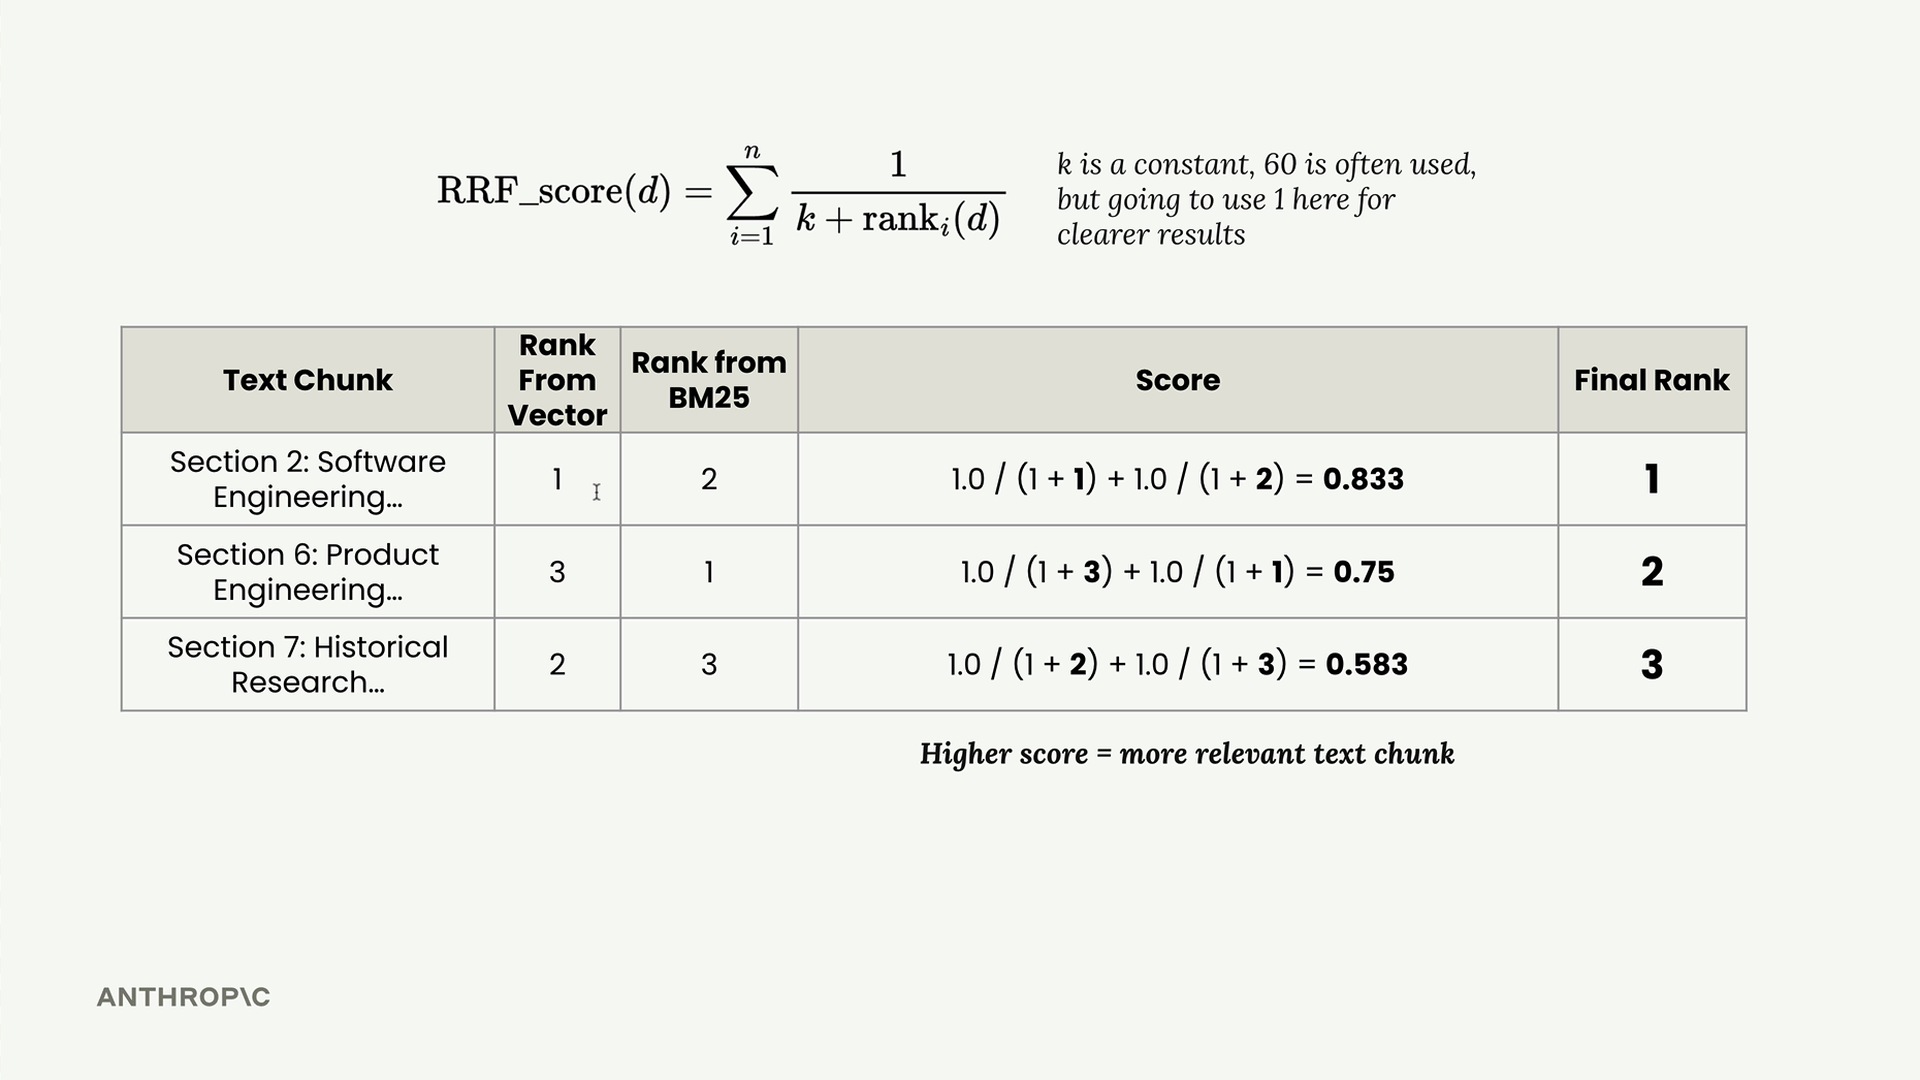
Nach dem Sortieren nach Score ergibt sich die endgültige Rangfolge: Abschnitt 2 (erster Platz), Abschnitt 6 (zweiter Platz), Abschnitt 7 (dritter Platz).
Implementierung
Die Implementierung der Retriever-Klasse ist unkompliziert:
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # Ergebnisse aus allen Indizes abrufen
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # Dokumentrang über Systeme hinweg verfolgen
                # RRF-Formel anwenden
                # Zusammengeführte, sortierte Ergebnisse zurückgeben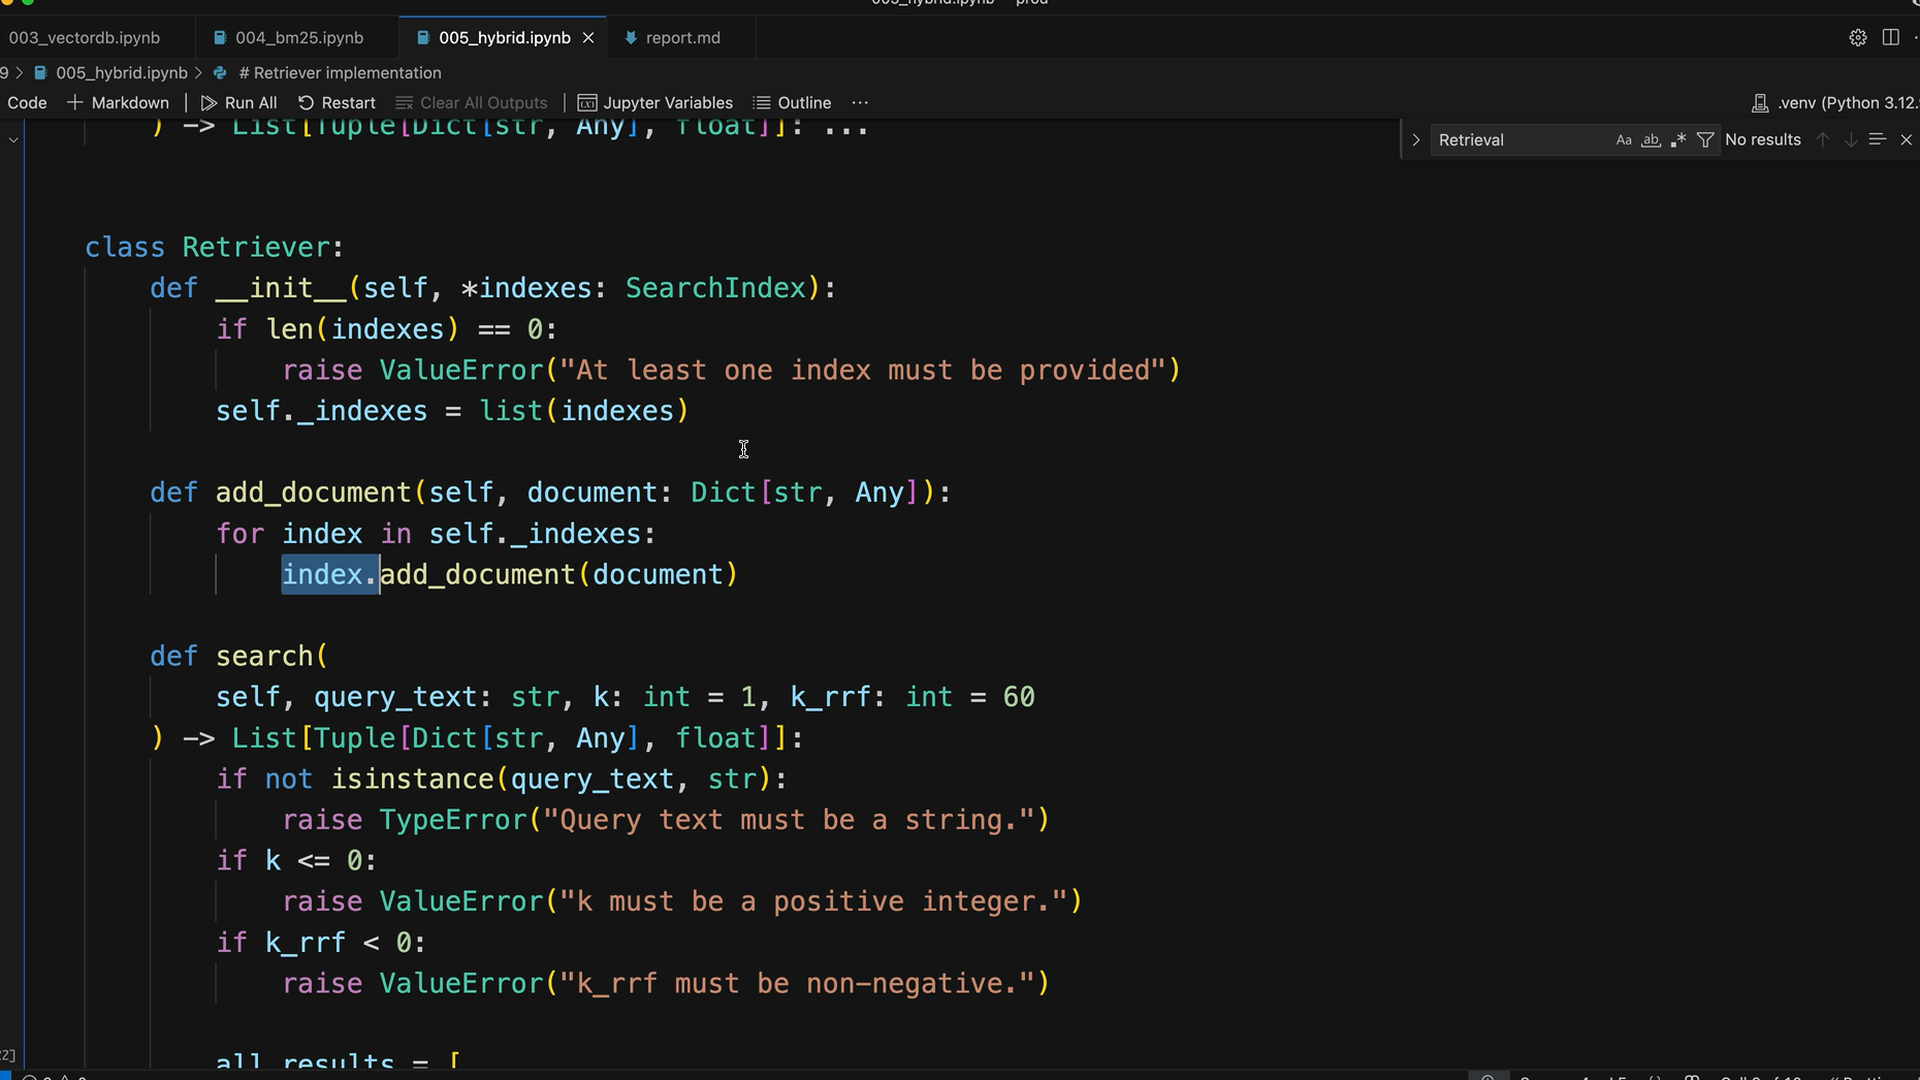
Die zentrale Erkenntnis ist, dass der RRF-Algorithmus ein einheitliches Ranking erzeugt, indem er berücksichtigt, wie gut jedes Dokument über alle Suchsysteme hinweg abschneidet, anstatt sich auf eine einzelne Bewertungsmethode zu verlassen.
Testen des hybriden Ansatzes
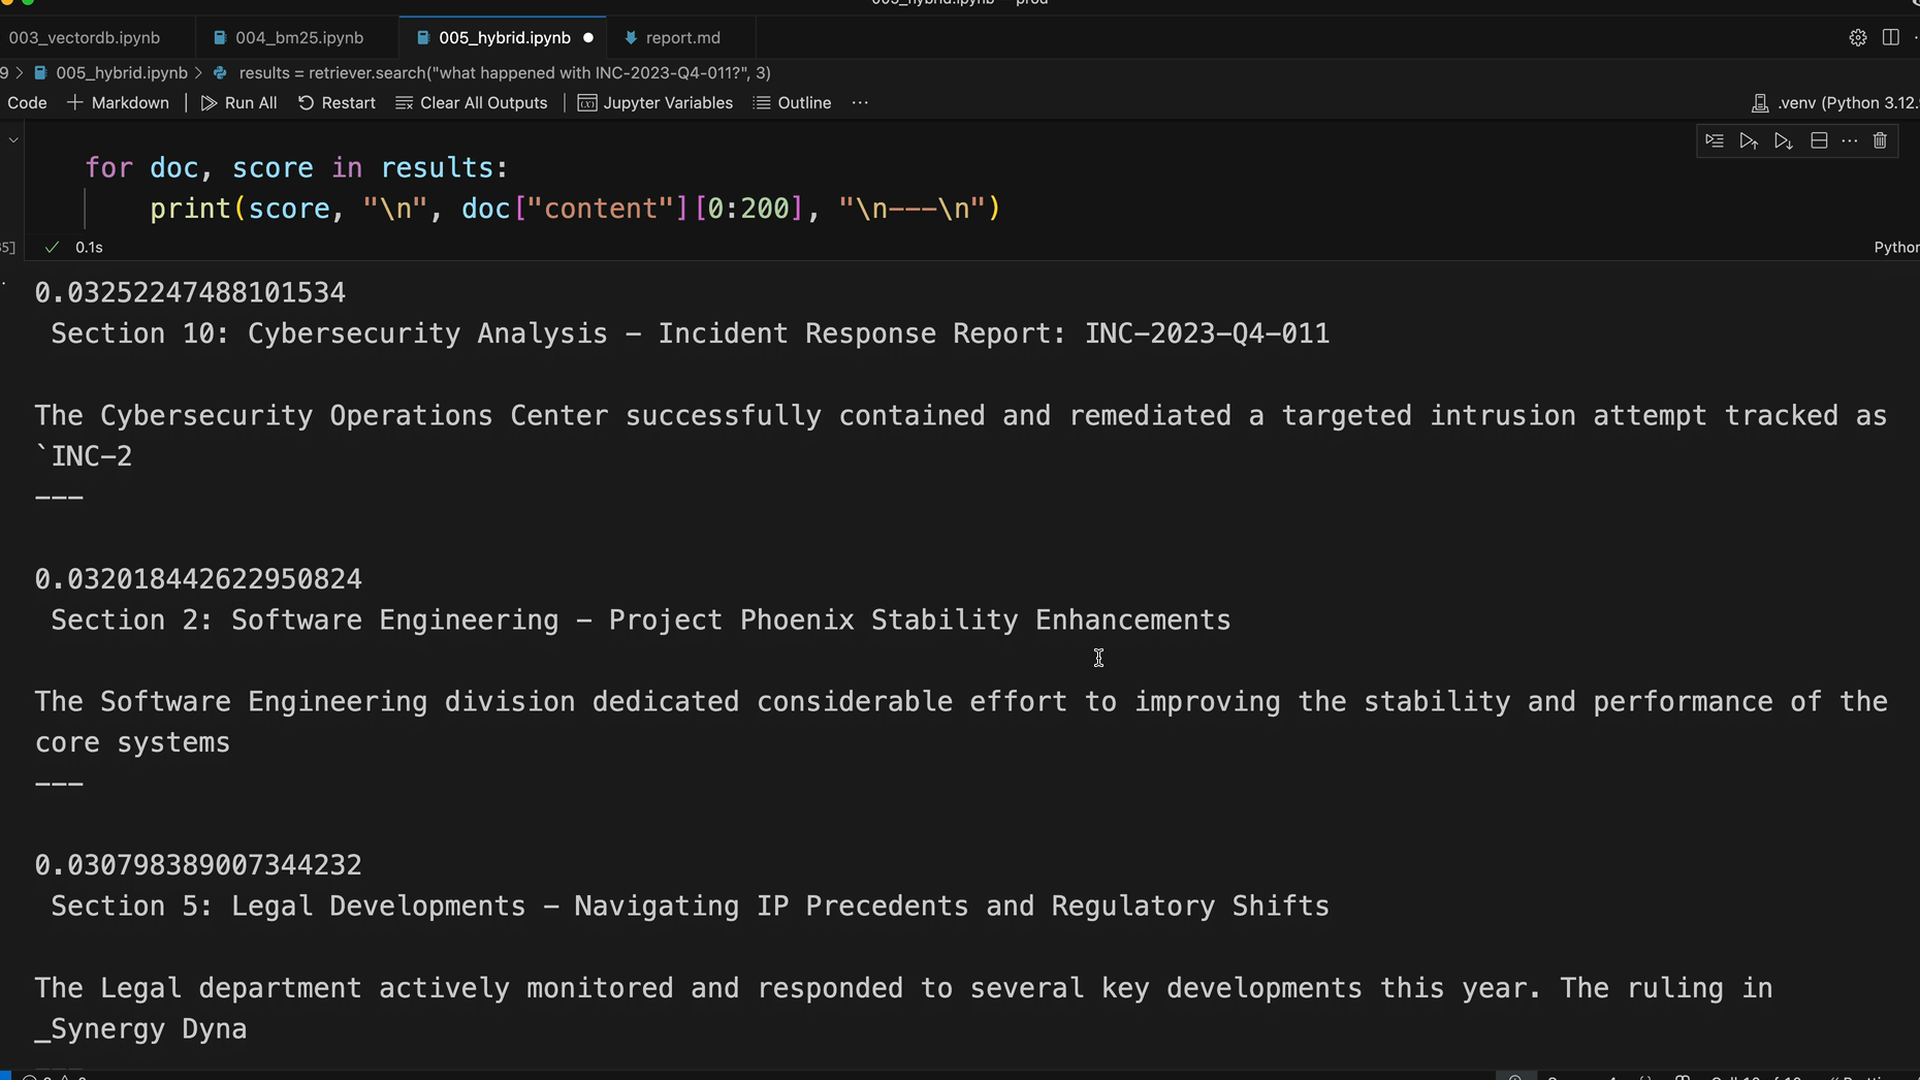
Beim Testen mit einer Anfrage wie „Was ist mit INC-2023-Q4-011 passiert?" liefert der hybride Ansatz deutlich bessere Ergebnisse als jede Methode allein. Statt unerwarteter Ergebnisse aus der reinen Vektorsuche erhältst du nun zuerst den relevantesten Cybersicherheits-Vorfallbericht, gefolgt von verwandten Inhalten zur Softwareentwicklung.
Erweiterbarkeit
Das Schöne an diesem Design ist seine Modularität. Da jeder Suchindex dieselbe Schnittstelle implementiert (add_document() und search()), kannst du dem System problemlos neue Suchmethoden hinzufügen. Egal ob es sich um ein anderes Embedding-Modell, eine spezialisierte Domänensuche oder eine andere Retrieval-Technik handelt - solange sie der etablierten API folgt, lässt sie sich nahtlos in die hybride Pipeline integrieren.
Dieser hybride Suchansatz stellt eine deutliche Verbesserung der Retrieval-Genauigkeit dar, indem er das semantische Verständnis der Vektorsuche mit dem präzisen Keyword-Matching der lexikalischen Suche kombiniert, alles vereint durch den mathematisch fundierten RRF-Ranking-Algorithmus.