Codebasierte Bewertung fügt deinen Prompt-Evaluierungen eine zusätzliche Validierungsebene hinzu, indem geprüft wird, ob die Ausgabe des Modells dem korrekten Format entspricht und eine gültige Syntax aufweist. Dies ist besonders nützlich, wenn du Modelle bittest, Code, JSON oder reguläre Ausdrücke zu generieren.
Wie die Code-Bewertung funktioniert
Der Code-Grader bewertet zwei Hauptkriterien:
- Formatkonformität - Enthält die Ausgabe nur das angeforderte Format (Python, JSON oder Regex) ohne Erklärungen?
- Gültige Syntax - Kann die Ausgabe tatsächlich erfolgreich geparst oder kompiliert werden?
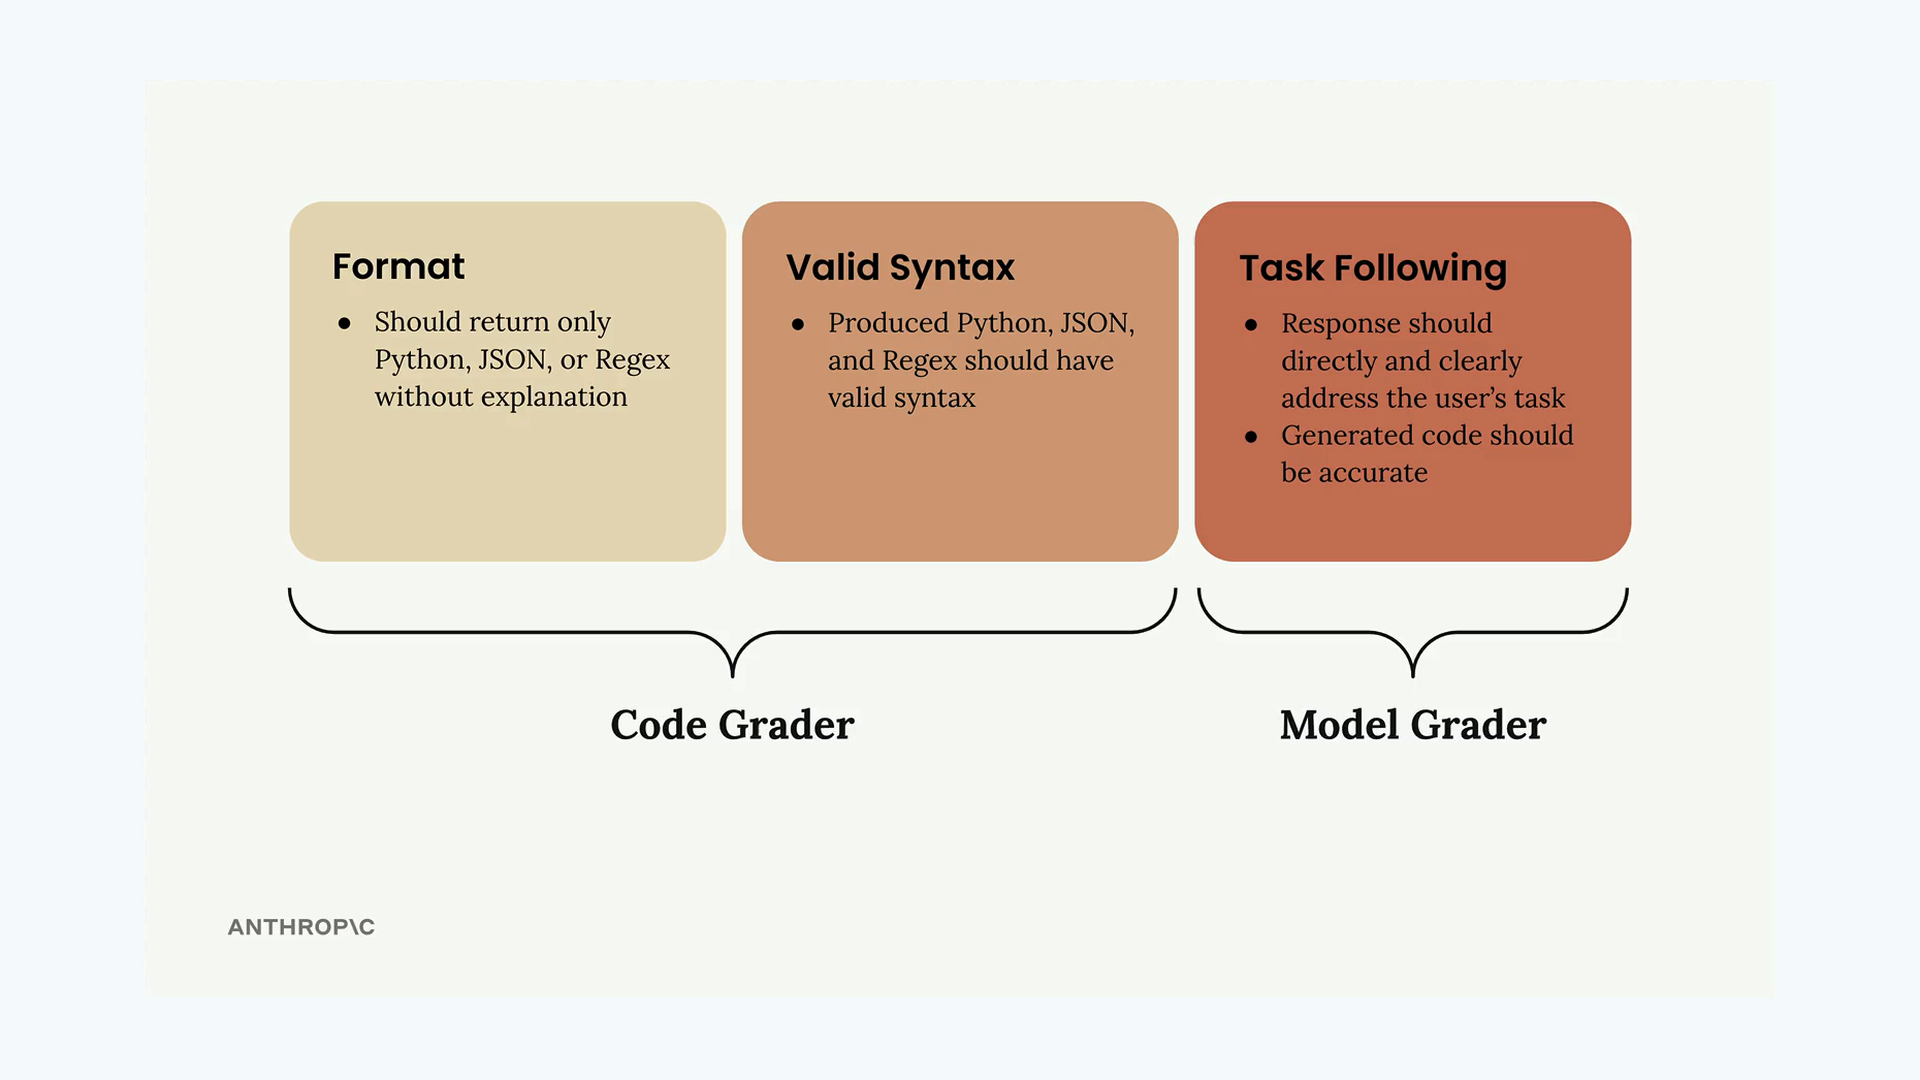
Das System verwendet separate Validierungsfunktionen für jeden Formattyp. Wenn der Code erfolgreich geparst wird, erhält er eine perfekte Punktzahl von 10. Wenn das Parsen mit einem Fehler fehlschlägt, erhält er eine Punktzahl von 0.
Einrichten von Validierungsfunktionen
Du benötigst drei Hilfsfunktionen, um verschiedene Ausgabetypen zu validieren:
def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
Diese Funktionen nutzen die integrierten Parsing-Fähigkeiten von Python, um die Syntaxgültigkeit zu prüfen. Die Funktion json.loads() validiert JSON, ast.parse() erstellt einen abstrakten Python-Syntaxbaum, und re.compile() validiert reguläre Ausdrücke.
Hinzufügen von Formatinformationen zu Testfällen
Dein Testdatensatz muss das erwartete Ausgabeformat für jede Aufgabe angeben. Aktualisiere deinen Prompt zur Datensatzgenerierung, um ein Format-Feld einzuschließen:
{
    "task": "Description of task",
    "format": "python"
}
Das Format-Feld sollte "json", "python" oder "regex" enthalten, je nachdem, welchen Ausgabetyp du von dieser bestimmten Aufgabe erwartest.
Verbessern deines Prompts
Um bessere Ergebnisse vom Code-Grader zu erhalten, mache deine Prompt-Anweisungen spezifischer:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationDu kannst auch eine vorausgefüllte Assistant-Nachricht mit Codeblöcken und Stop-Sequenzen verwenden, um eine saubere Ausgabeformatierung sicherzustellen.
Kombinieren von Punktzahlen
Der letzte Schritt ist das Zusammenführen deiner Modell-Grader-Punktzahl mit der Syntax-Grader-Punktzahl. Ein einfacher Ansatz besteht darin, den Durchschnitt beider Punktzahlen zu nehmen:
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
Dies gewichtet sowohl die inhaltliche Qualität (vom Modell-Grader) als auch die technische Korrektheit (vom Code-Grader) gleich. Du kannst diese Gewichtung anpassen, je nachdem, was für deinen spezifischen Anwendungsfall wichtiger ist.
Interpretieren der Ergebnisse
Sobald du deine Evaluierung durchführst, erhältst du eine kombinierte Punktzahl, die sowohl die semantische Qualität als auch die technische Korrektheit des generierten Codes widerspiegelt. Denke daran, dass eine einzelne Punktzahl isoliert betrachtet nicht viel aussagt - der eigentliche Wert entsteht durch den Vergleich von Punktzahlen, während du dein Prompt-Design iterierst.
Verwende diese Basispunktzahl, um Prompt-Verbesserungen zu testen und zu sehen, ob deine Änderungen tatsächlich zu besserer, zuverlässigerer Codegenerierung führen.