Der Aufbau eines benutzerdefinierten Workflows zur Prompt-Evaluierung beginnt mit der Festlegung eines klaren Ziels und der Generierung von Testdaten. In diesem Fall erstellen wir einen Prompt, der Nutzern hilft, AWS-spezifischen Code zu schreiben – entweder Python-Funktionen, JSON-Konfigurationen oder reguläre Ausdrücke – ohne zusätzliche Erklärungen oder Formatierung.
Das Ziel festlegen
Der Prompt soll die Aufgabenbeschreibung eines Nutzers entgegennehmen und einen von drei Ausgabetypen zurückgeben:
- Python-Code
- JSON-Konfiguration
- Reguläre Ausdrücke
Die zentrale Anforderung ist, dass Antworten nur den angeforderten Code enthalten sollen, ohne Kopfzeilen, Fußzeilen oder Erklärungen.
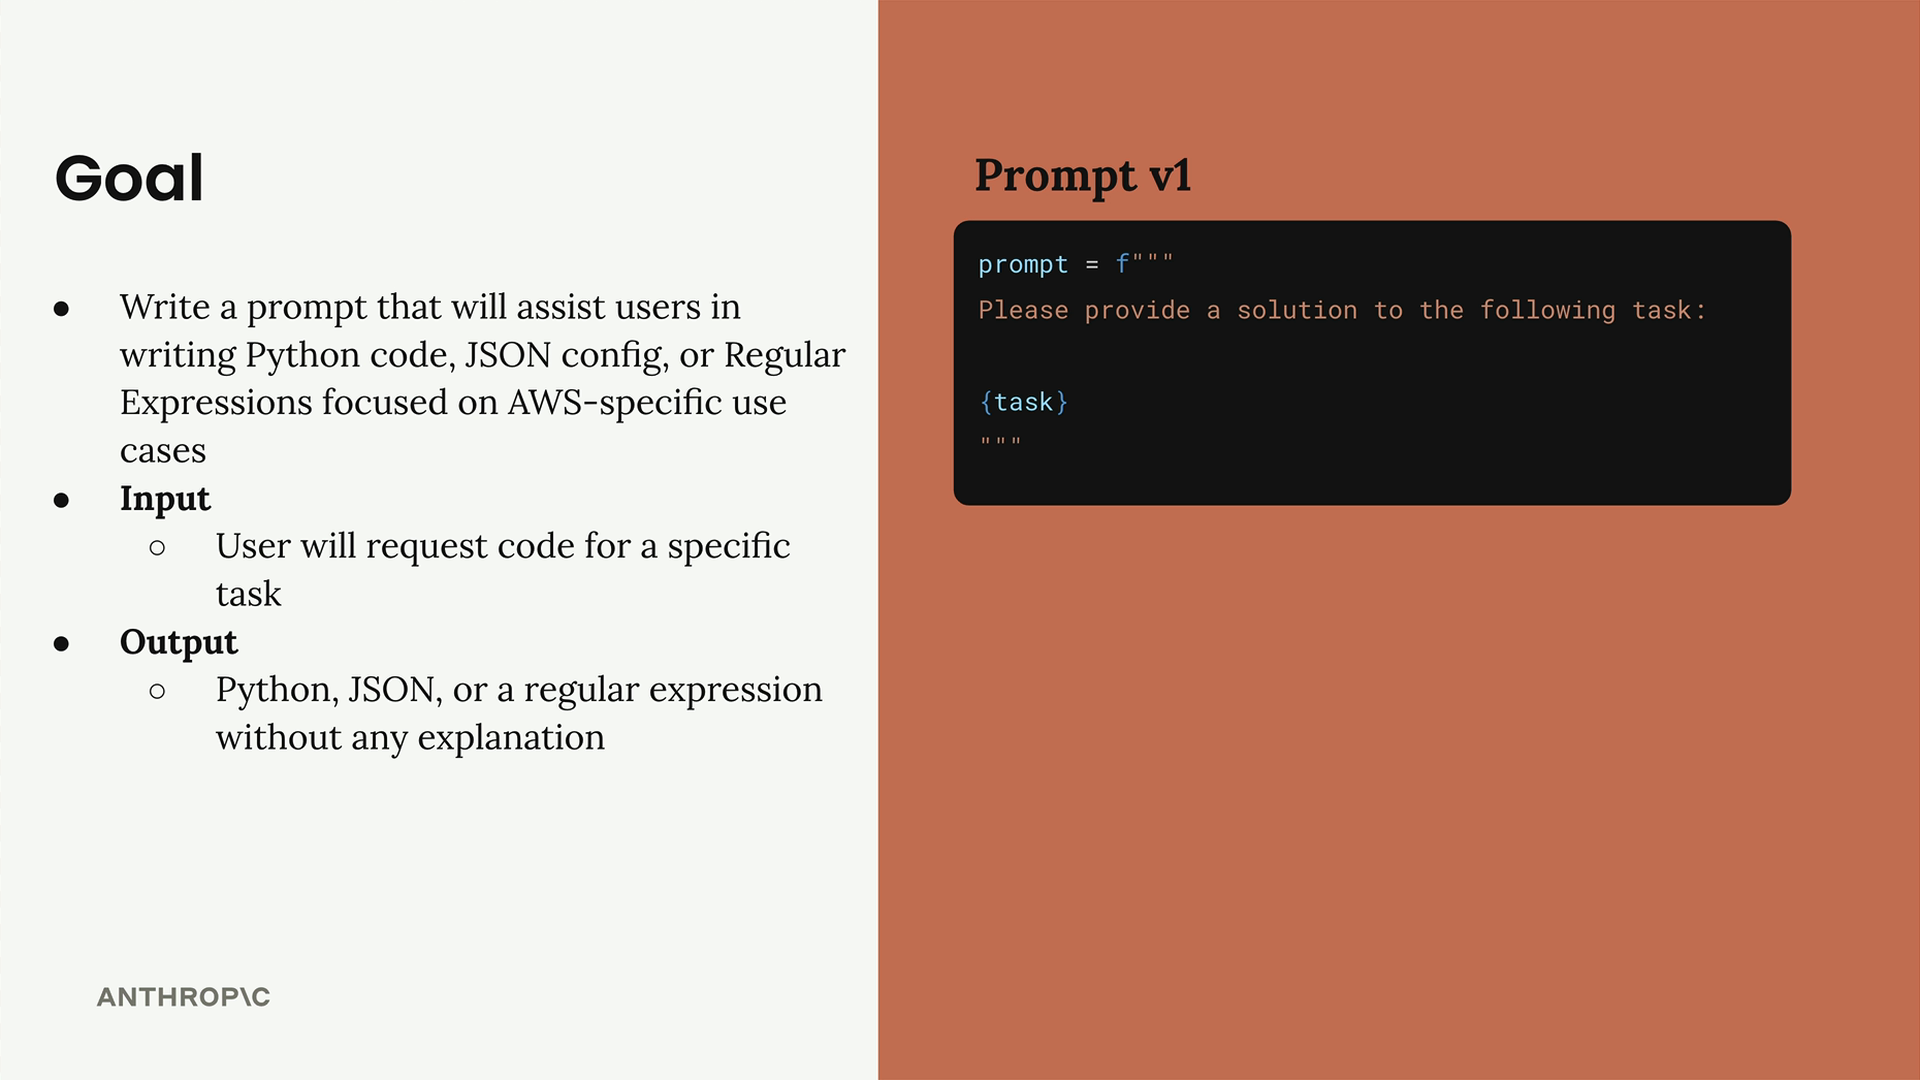
Mit einer einfachen ersten Version zu beginnen, hält die Dinge überschaubar. Die anfängliche Prompt-Vorlage ist unkompliziert: „Bitte liefere eine Lösung für die folgende Aufgabe: {task}"
Evaluierungsdatensätze erstellen
Ein Evaluierungsdatensatz enthält Eingabebeispiele, die du in deinen Prompt einspeist. Jeder Testfall wird mit deinem Prompt kombiniert und an Claude gesendet, sodass du sehen kannst, wie gut der Prompt in verschiedenen Szenarien funktioniert.
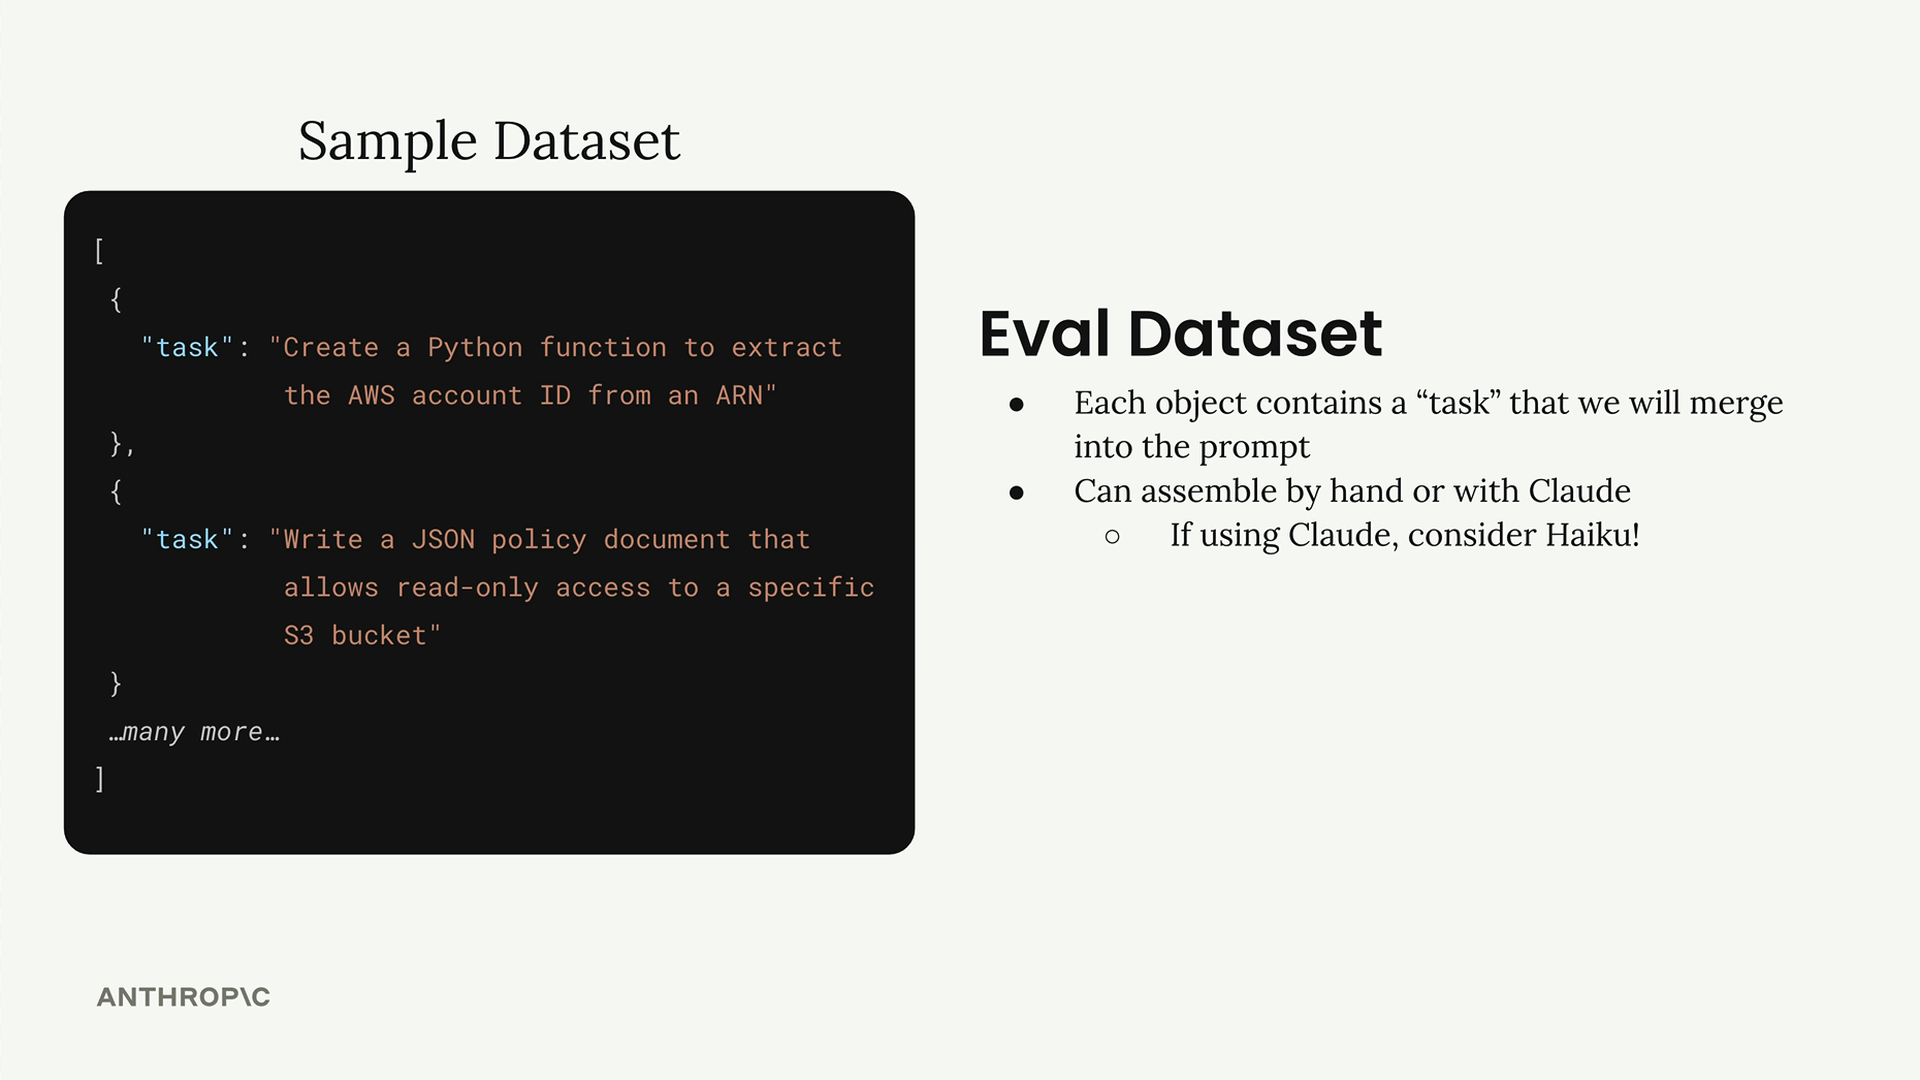
Du kannst Datensätze auf zwei Arten erstellen:
- Testfälle manuell von Hand schreiben
- Sie automatisch mit Claude generieren
Für die automatische Generierung ist die Verwendung eines schnelleren Modells wie Haiku sinnvoll, da du mehrere Testfälle generierst.
Testdaten mit Code generieren
Die Funktion zur Datensatzgenerierung verwendet Claude, um realistische Testszenarien zu erstellen. Hier ist die grundlegende Struktur:
def generate_dataset():
    prompt = """
    Generate 3 AWS-related tasks that require Python, JSON, or Regex solutions.

    Focus on tasks that can be solved by writing a single Python function,
    a single JSON object, or tasks that do not require writing much code.

    Example output:
    [
        {
            "task": "Description of task"
        },
        ...additional
    ]

    Please generate 3 objects.
    """

    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
Dieser Ansatz verwendet die Technik der vorausgefüllten Assistant-Nachricht mit Stop-Sequenzen, um saubere JSON-Antworten zu extrahieren. Die Assistant-Nachricht beginnt mit "```json" und stoppt beim schließenden "```", wodurch sichergestellt wird, dass du ordnungsgemäß formatierte Daten erhältst. ## Deinen Datensatz speichern Nach der Generierung speichere den Datensatz, um eine ständige Neugenerierung zu vermeiden: ``` dataset = generate_dataset() with open("dataset.json", "w") as f: json.dump(dataset, f, indent=2) ``` ` Der generierte Datensatz erstellt realistische AWS-Aufgaben wie das Extrahieren von Account-IDs aus ARNs, das Schreiben von JSON-Schemas für EC2-Konfigurationen und das Erstellen von Regex-Mustern für S3-Bucket-Namen. Während drei Testfälle für die anfängliche Entwicklung funktionieren, würde eine Produktionsevaluierung deutlich mehr Beispiele mit größerer Vielfalt benötigen. Diese Grundlage gibt dir einen wiederholbaren Prozess zum Erstellen von Evaluierungsdatensätzen, die zu deinem spezifischen Anwendungsfall passen, und bereitet die nächsten Schritte vor: das Durchführen von Evaluierungen und das Messen der Prompt-Leistung. `