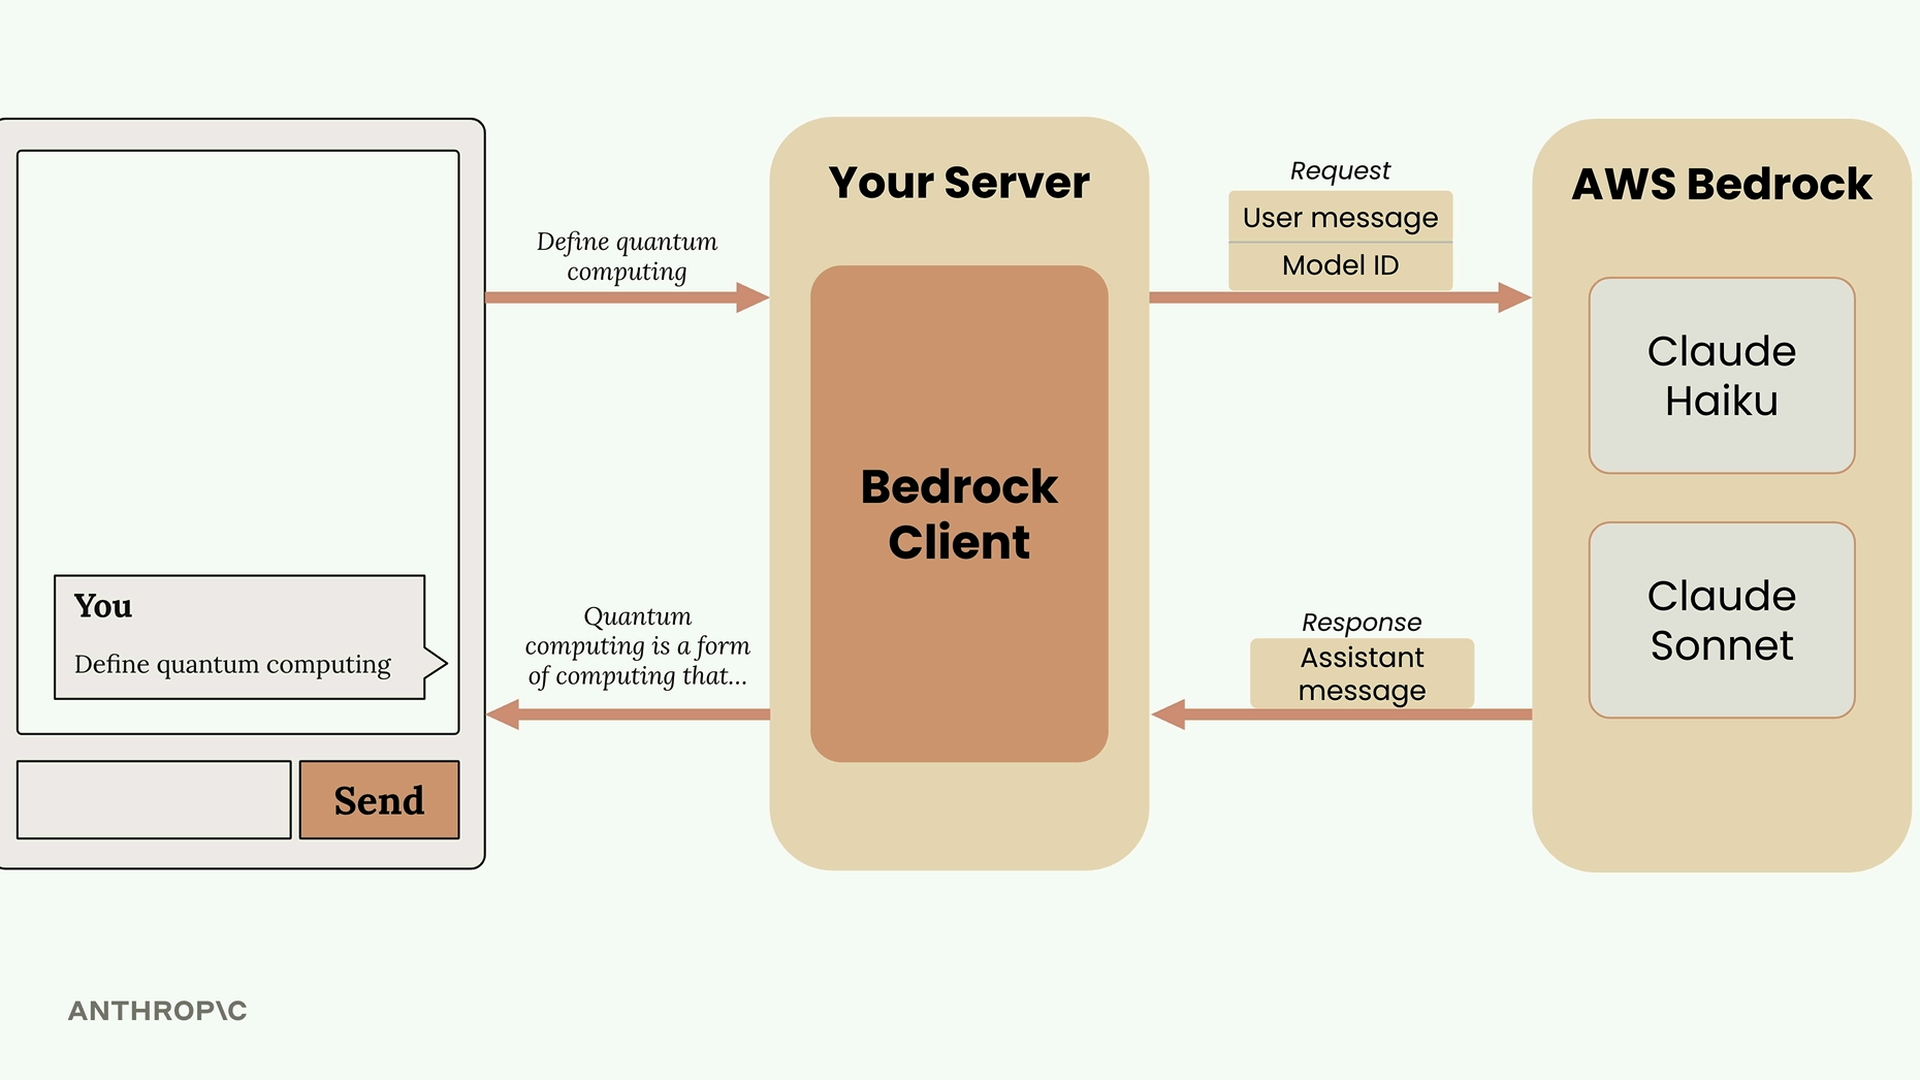
Beim Erstellen von Anwendungen mit KI-Modellen musst du den Datenfluss von der Benutzereingabe bis zur KI-generierten Antwort verstehen. Lass uns durchgehen, wie das mit AWS Bedrock funktioniert, und sehen, was hinter den Kulissen einer typischen Chat-Anwendung passiert.
Wie Chat-Anwendungen funktionieren
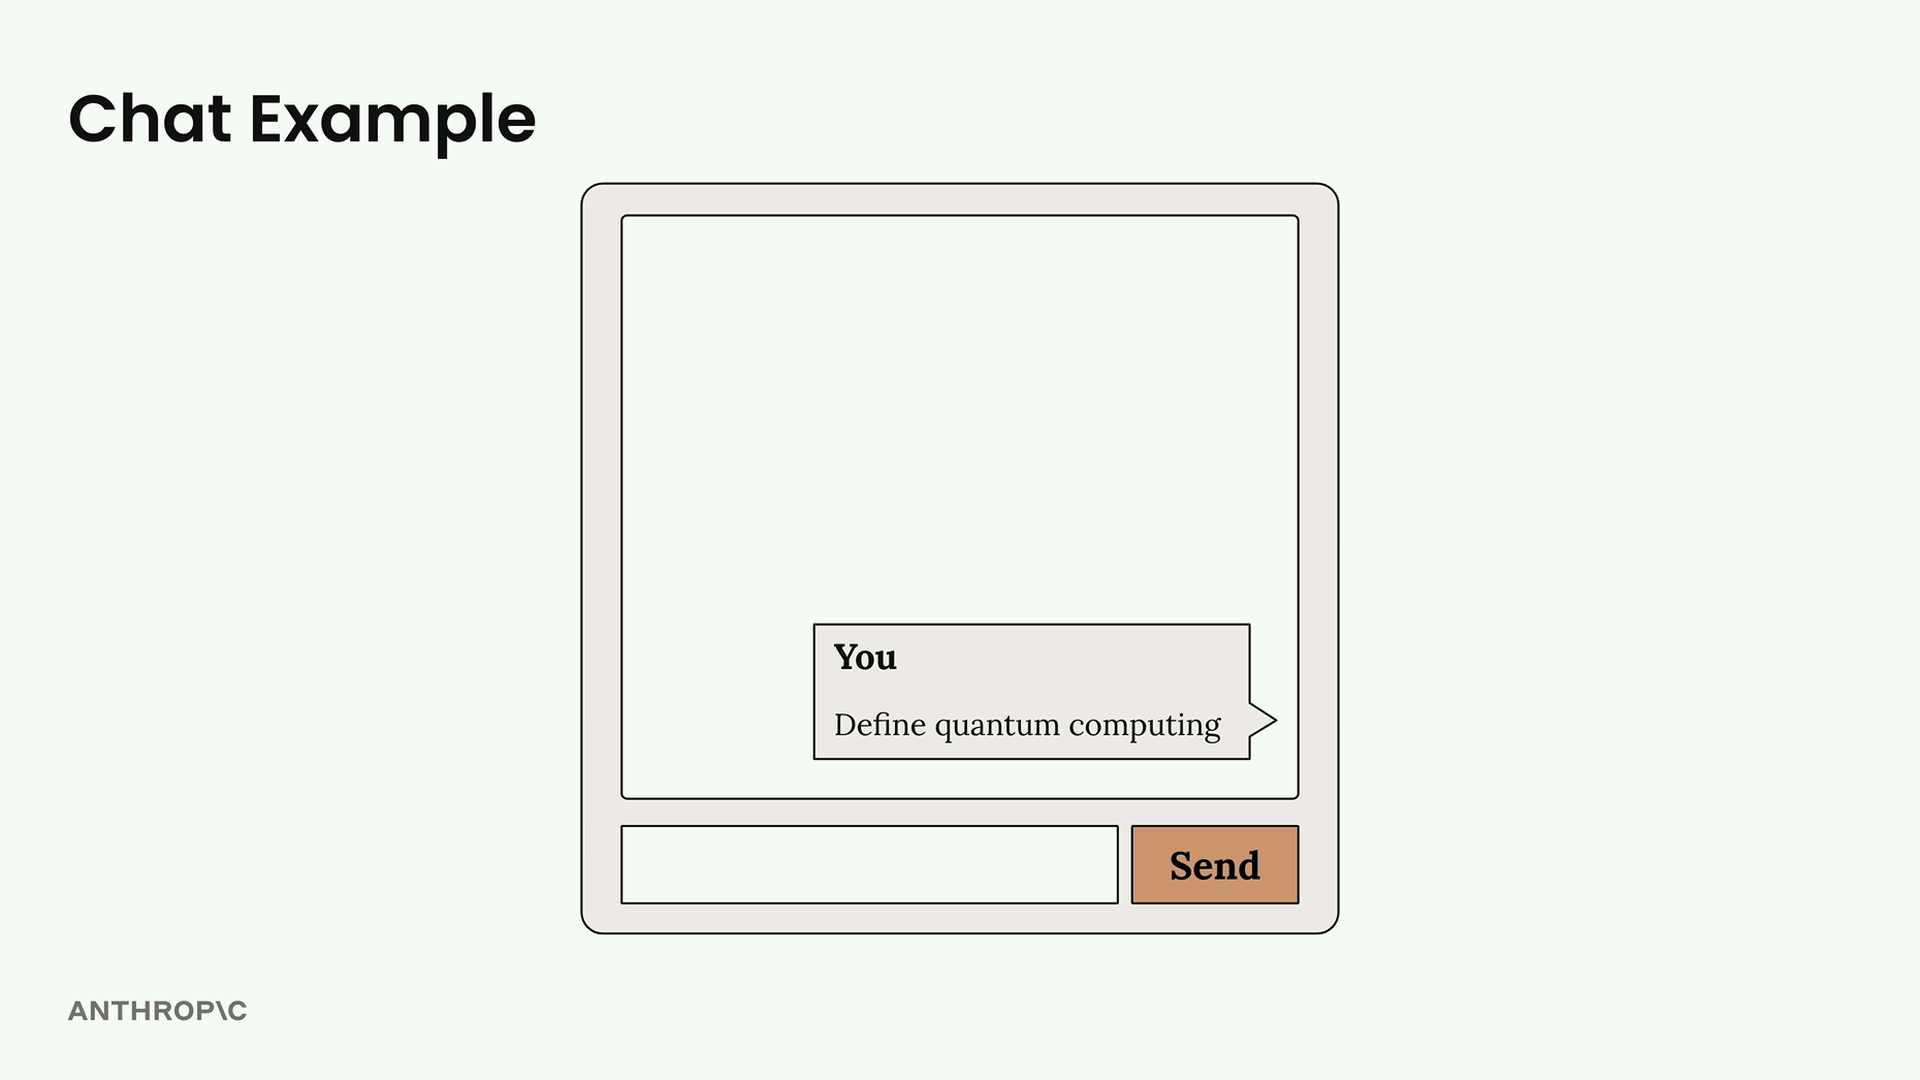
Stell dir vor, du baust eine Web-App mit einer einfachen Chat-Oberfläche. Ein Benutzer tippt „Definiere Quantencomputing" und klickt auf Senden. Hier ist, was tatsächlich passiert:
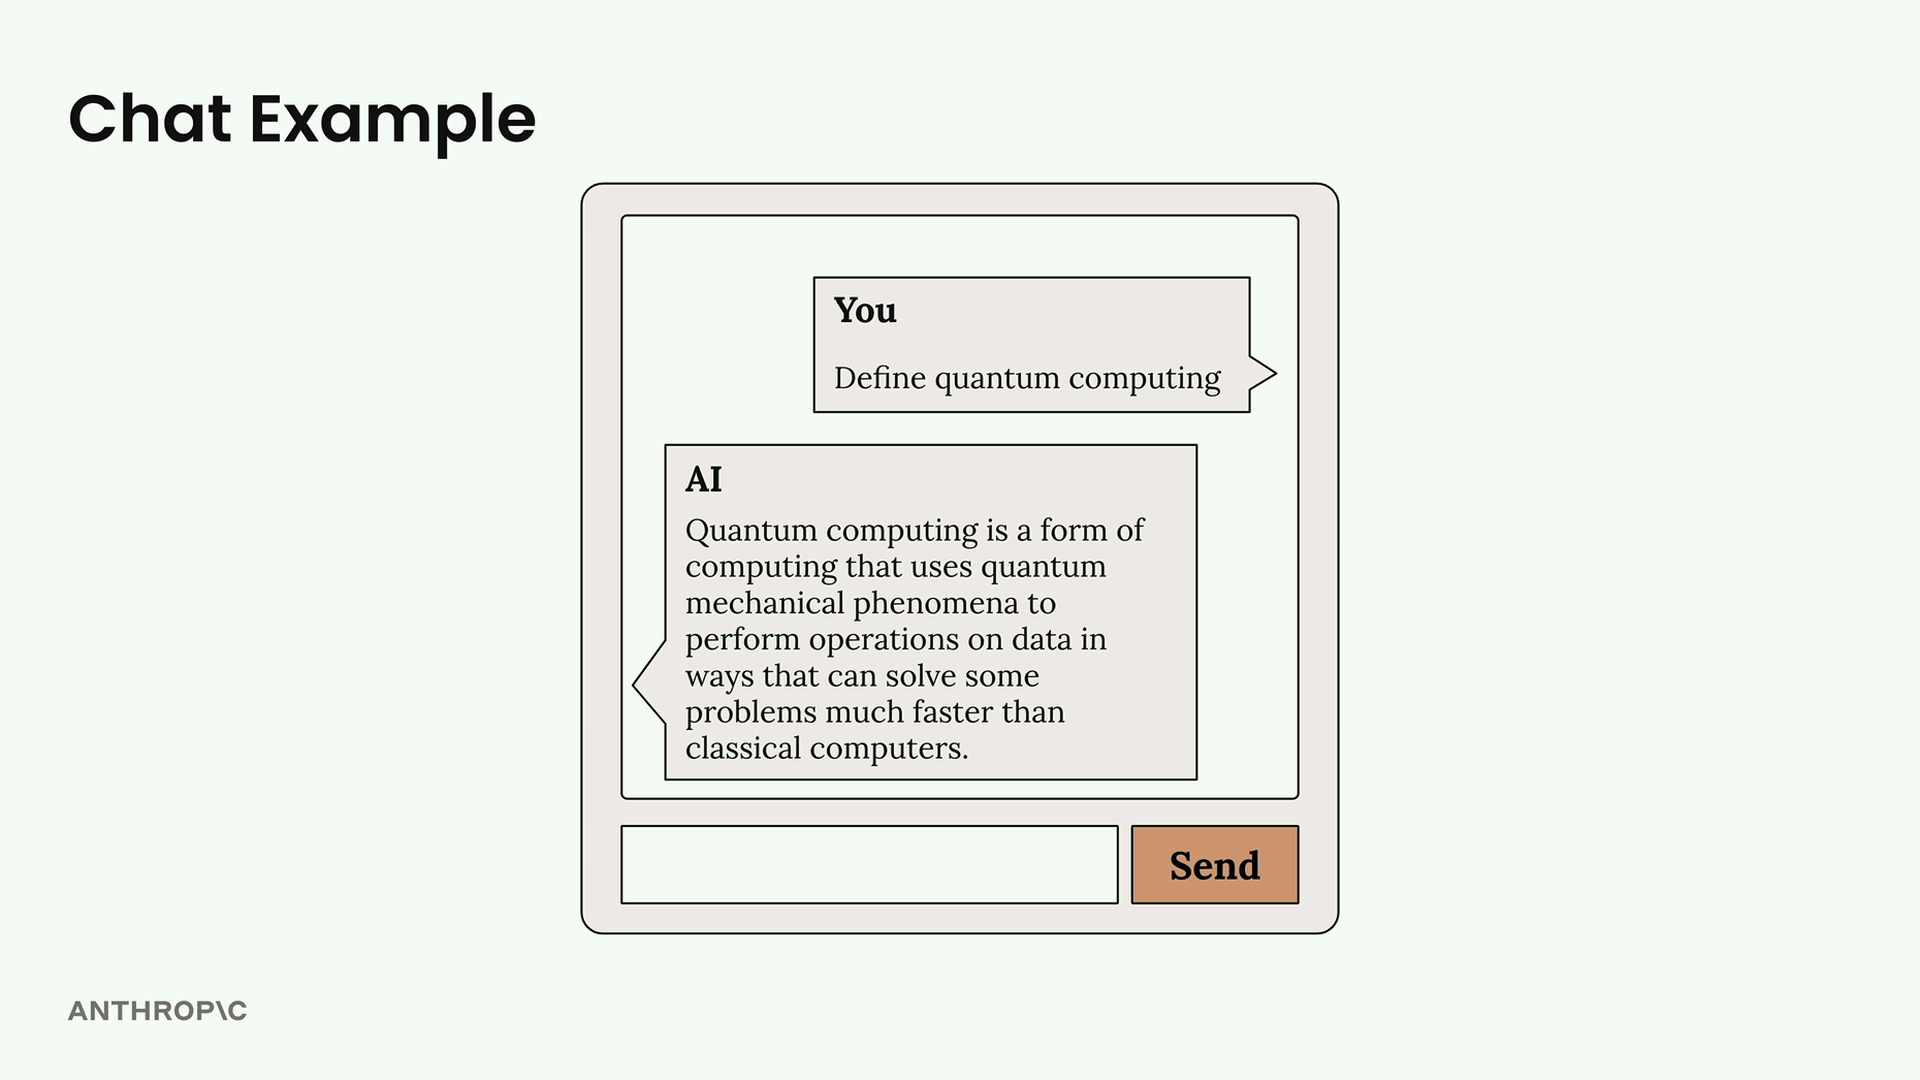
Der Benutzer sieht eine übersichtliche Oberfläche, aber im Hintergrund arbeitet ein ganzes System, um diese Antwort zu generieren.
Der Anfrageablauf
Wenn ein Benutzer Text übermittelt, durchläuft diese Nachricht folgenden Weg:
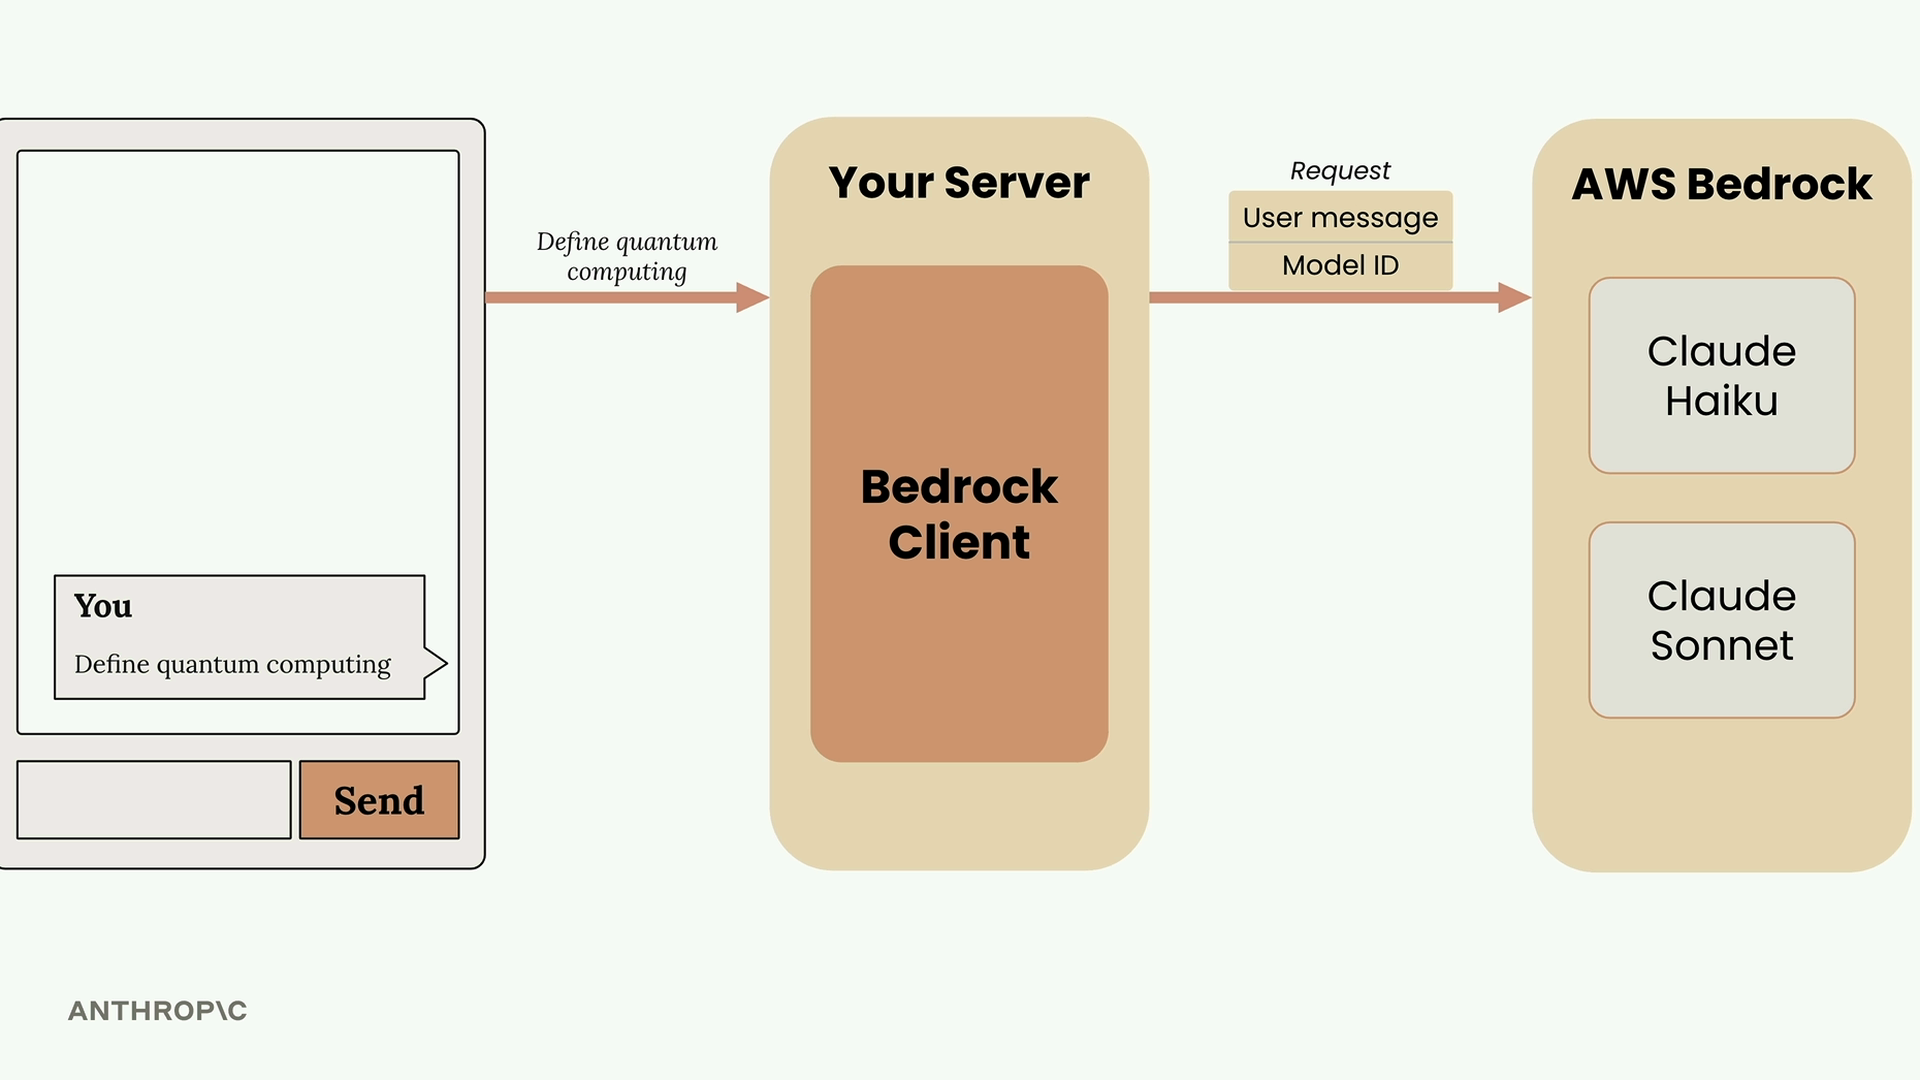
- Der Benutzer übermittelt seine Nachricht über deine Web-Oberfläche
- Dein Server empfängt die Anfrage, die diesen Text enthält
- Dein Server verwendet den Bedrock-Client, um eine Anfrage an AWS Bedrock zu stellen
- Die Anfrage enthält die Benutzernachricht und eine Modell-ID (wie Claude Haiku oder Claude Sonnet)
- Das gewählte Modell verarbeitet die Anfrage und generiert Text
- AWS Bedrock sendet eine Assistentennachricht mit der generierten Antwort zurück
- Dein Server leitet diese Antwort zurück an den Browser des Benutzers weiter