Beim Aufbau einer RAG-Pipeline wirst du schnell feststellen, dass semantische Suche allein nicht immer die besten Ergebnisse liefert. Manchmal benötigst du exakte Schlüsselwort-Übereinstimmungen, die semantische Suche möglicherweise übersieht. Die Lösung besteht darin, semantische Suche mit lexikalischer Suche zu kombinieren, indem du eine Technik namens BM25 verwendest.
Das Problem mit semantischer Suche allein
Angenommen, du suchst in einem Dokument nach einer bestimmten Vorfall-ID wie „INC-2023-Q4-011". Obwohl dieser exakte Begriff mehrfach in relevanten Abschnitten vorkommt, könnte die semantische Suche nicht zusammenhängende Abschnitte zurückgeben, die semantisch ähnlich erscheinen, aber nicht tatsächlich die spezifische Information enthalten, die du benötigst.
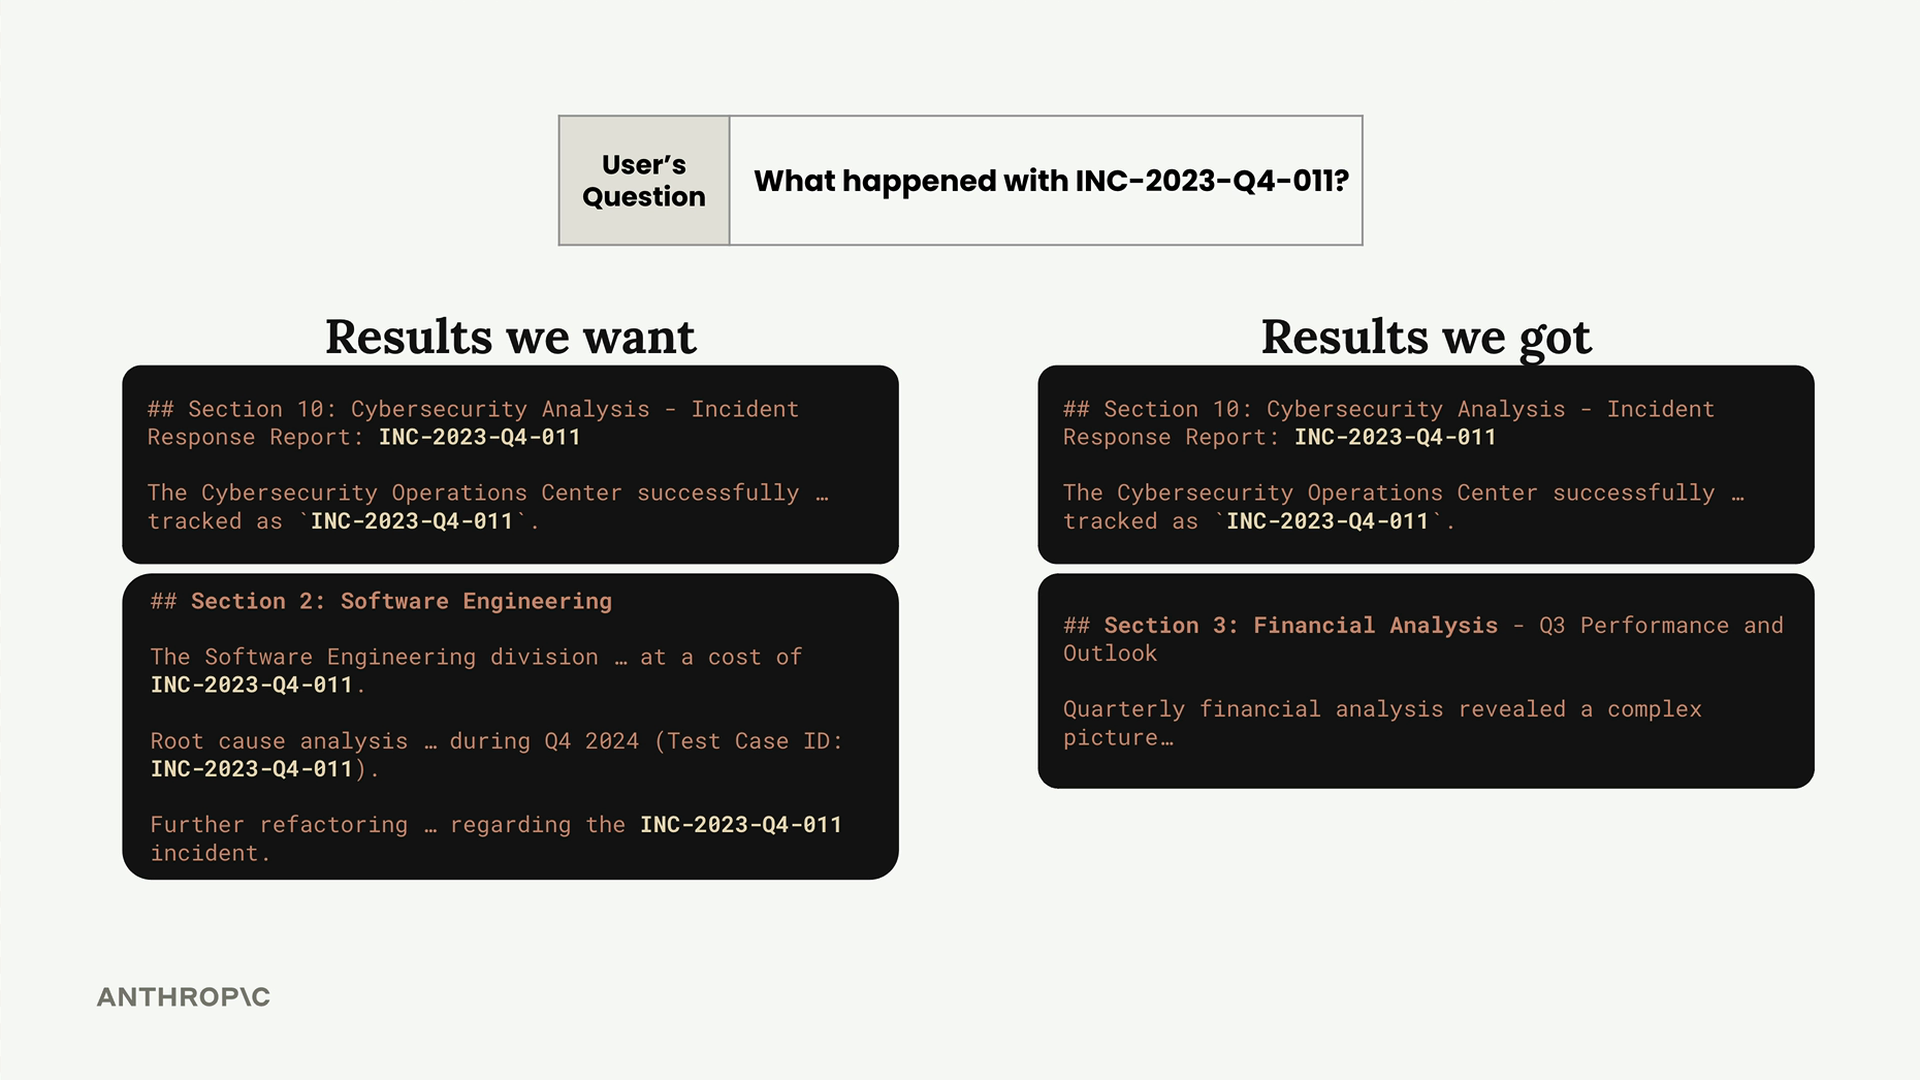
Dies passiert, weil sich semantische Suche auf Bedeutung konzentriert und nicht auf exakte Textübereinstimmungen. Wenn du präzises Schlüsselwort-Matching benötigst, brauchst du einen anderen Ansatz.
Hybride Suchstrategie
Die Lösung besteht darin, sowohl semantische als auch lexikalische Suchen parallel auszuführen und dann die Ergebnisse zusammenzuführen. Das gibt dir das Beste aus beiden Welten:
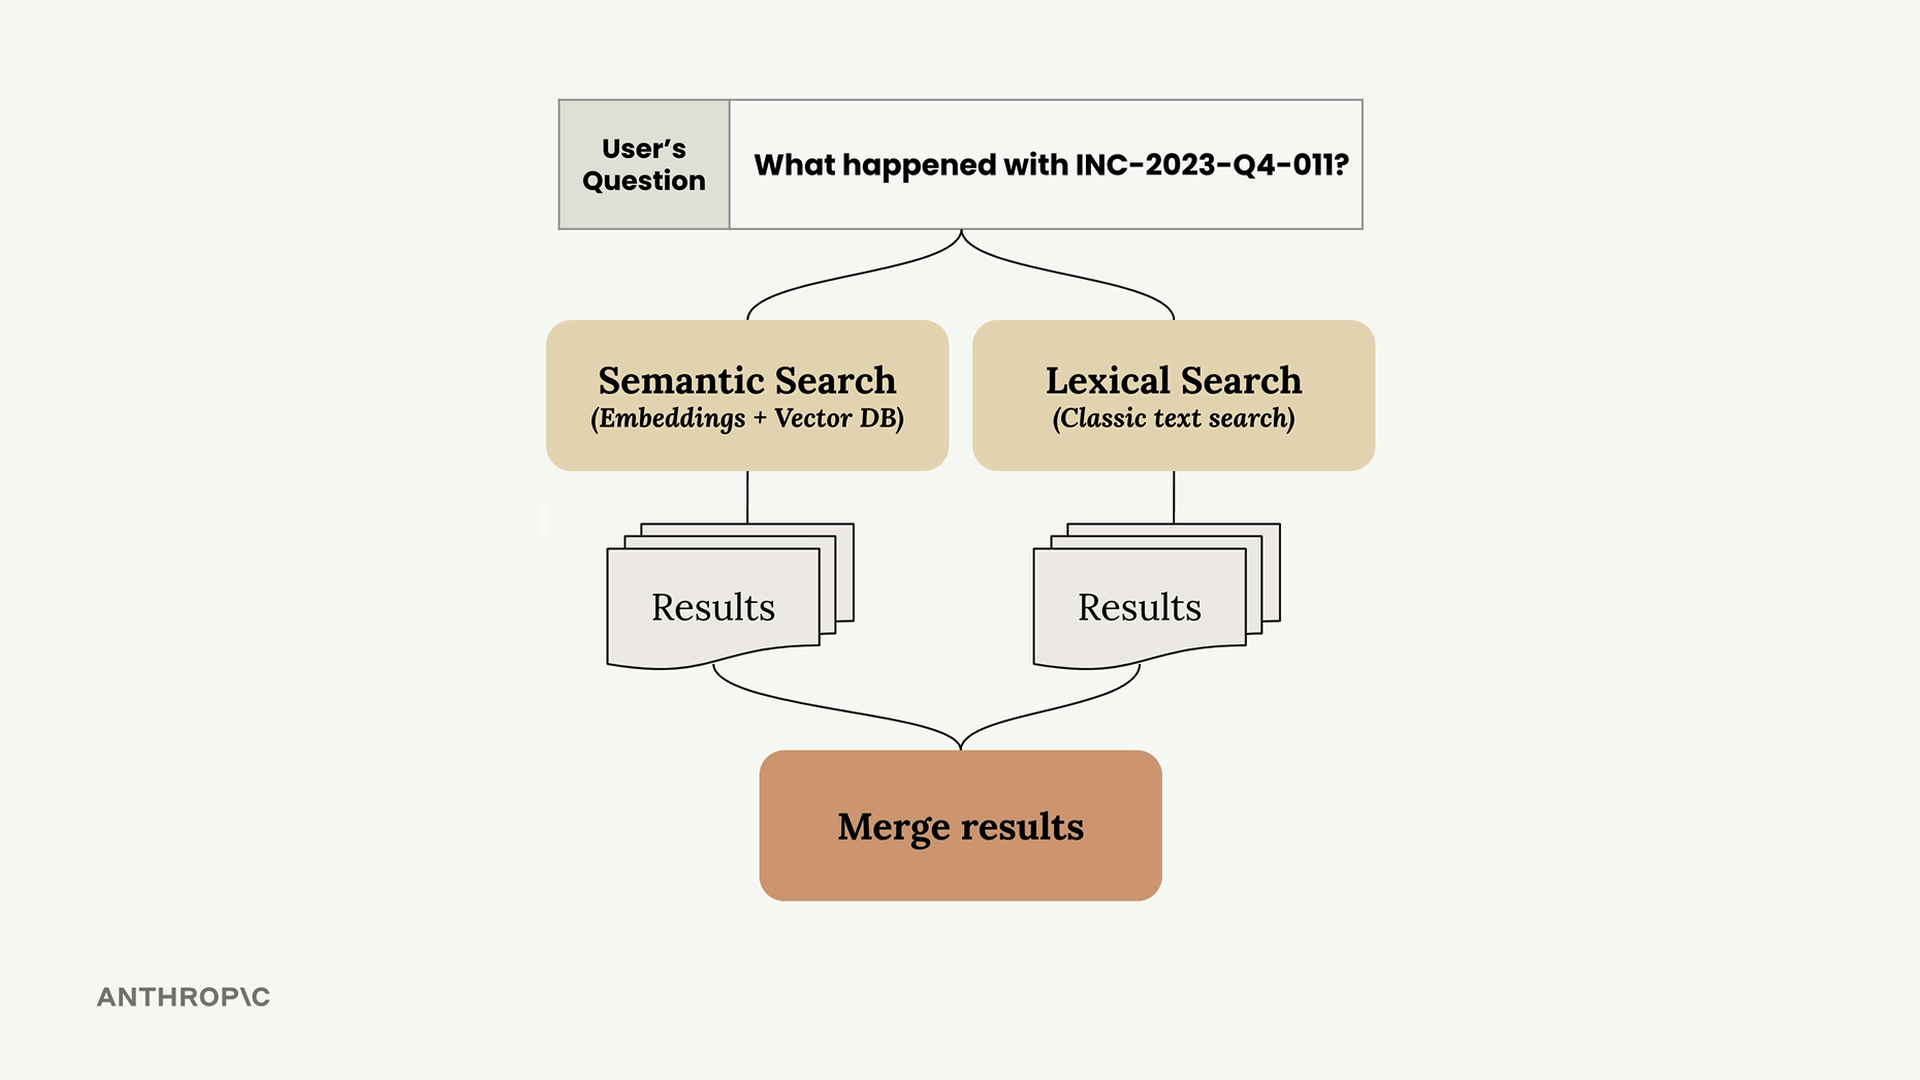
- Semantische Suche - Findet konzeptionell verwandte Inhalte mithilfe von Embeddings
- Lexikalische Suche - Findet exakte Schlüsselwort-Übereinstimmungen mithilfe klassischer Textsuche
- Zusammengeführte Ergebnisse - Kombiniert beide Ansätze für eine bessere Gesamtrelevanz
Wie BM25 funktioniert
BM25 (Best Match 25) ist ein beliebter Algorithmus für lexikalische Suche in RAG-Pipelines. So verarbeitet er eine Suchanfrage:
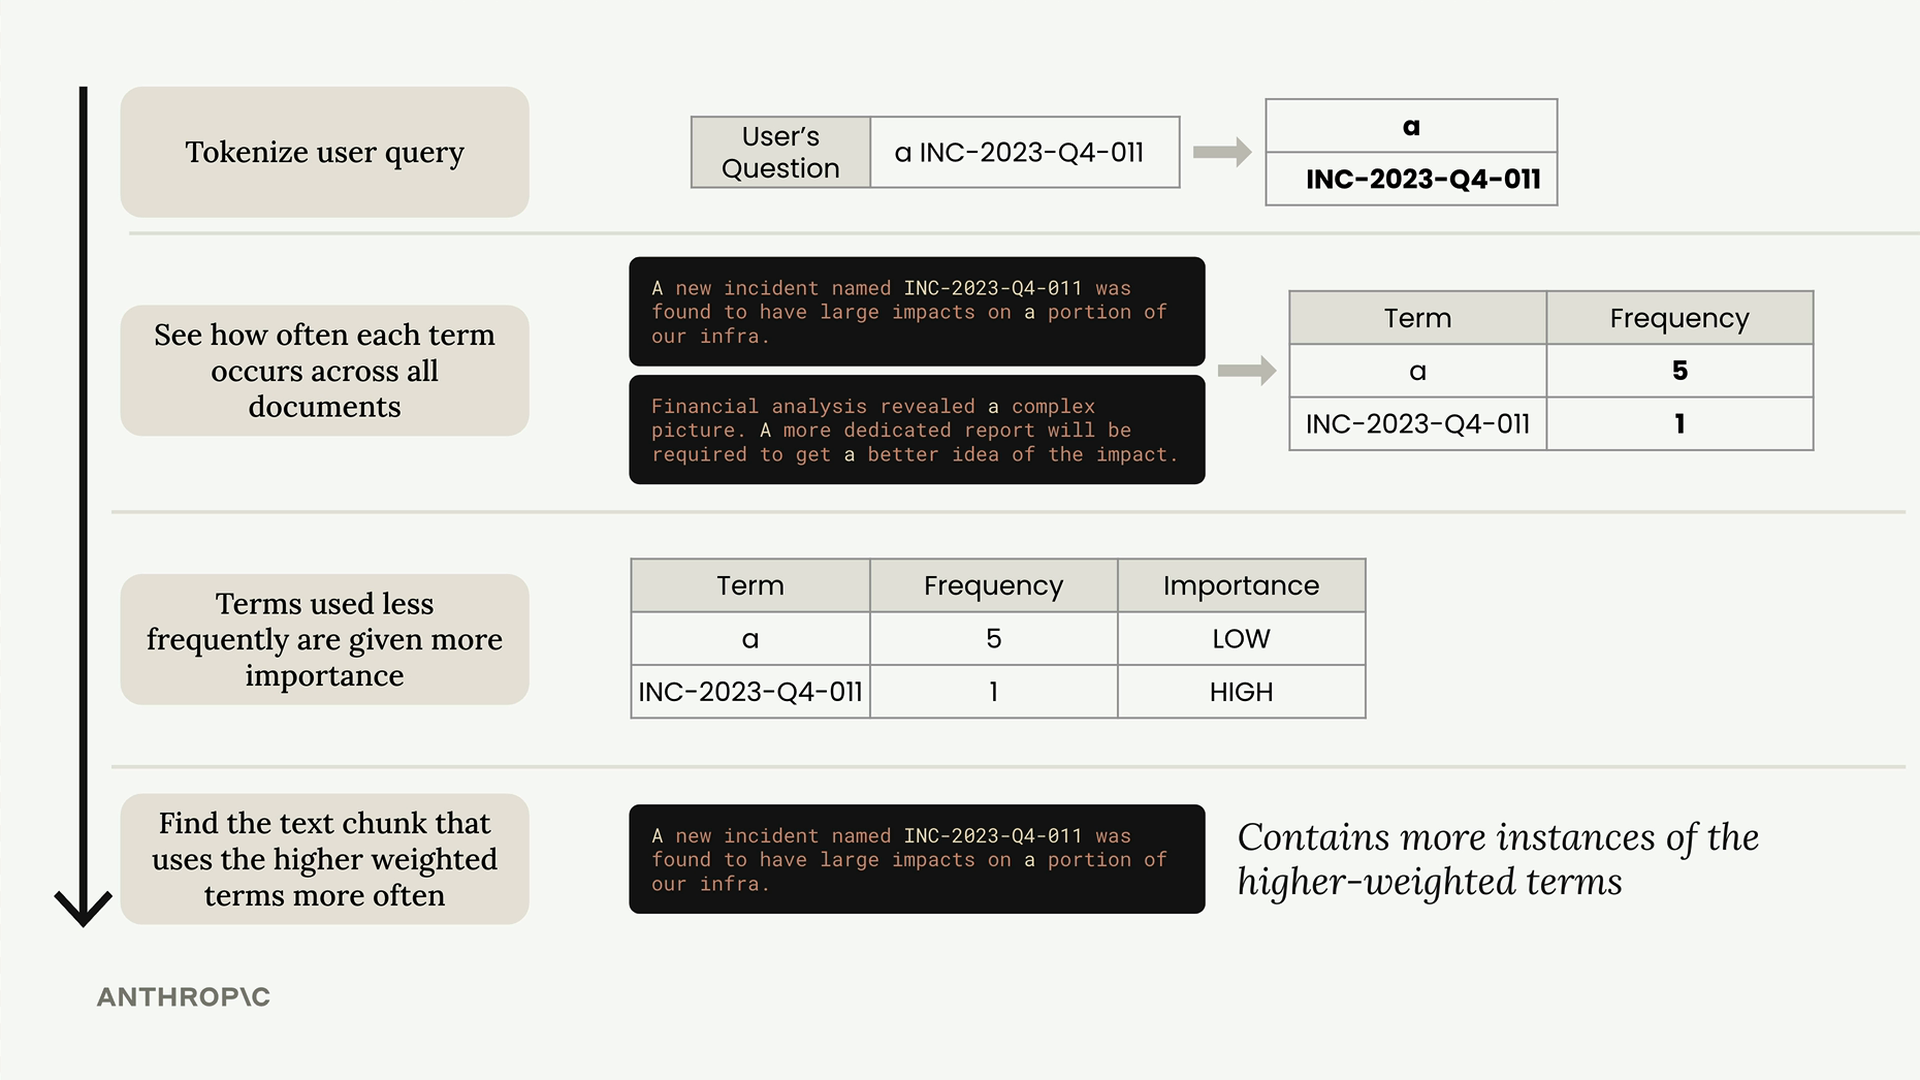
Der Algorithmus folgt diesen wichtigen Schritten:
- Die Anfrage tokenisieren - Die Frage des Nutzers in einzelne Begriffe aufteilen
- Begriffshäufigkeit zählen - Ermitteln, wie oft jeder Begriff in allen Dokumenten vorkommt
- Begriffe nach Seltenheit gewichten - Seltener verwendete Begriffe erhalten höhere Wichtigkeitswerte
- Dokumente bewerten - Textabschnitte finden, die mehr Instanzen der höher gewichteten Begriffe enthalten
Die zentrale Erkenntnis ist, dass seltene Begriffe wie „INC-2023-Q4-011" für die Suchrelevanz viel wichtiger sind als häufige Wörter wie „ein" oder „der".
BM25-Suche implementieren
So richtest du ein BM25-Suchsystem ein:
# Erstelle einen BM25-Store
store = BM25Index()

# Füge Dokumente zum Store hinzu
for chunk in chunks:
    store.add_document({"content": chunk})

# Durchsuche den Store
results = store.search("What happened with INC-2023-Q4-011?", 3)
Die BM25-Implementierung behält eine ähnliche API wie dein Vektorspeicher bei, mit den Methoden add_document() und search(). Diese Konsistenz macht es einfach, beide Systeme zusammen zu verwenden.
Bessere Suchergebnisse
Wenn du dieselbe Anfrage durch BM25 laufen lässt, die mit semantischer Suche allein fehlgeschlagen ist, erhältst du deutlich bessere Ergebnisse. Der Algorithmus priorisiert korrekt Abschnitte, die die exakte Vorfall-ID enthalten, und stuft sie höher ein als Abschnitte, die semantisch verwandt sein könnten, aber nicht den spezifischen Begriff enthalten, nach dem du suchst.
Die Suchergebnisse bringen nun korrekt den Abschnitt Software Engineering und den Abschnitt Cybersecurity zum Vorschein, die tatsächlich den Vorfall behandeln, anstatt nicht zusammenhängende Inhalte wie Financial Analysis zurückzugeben.
Nächste Schritte
Jetzt, wo du sowohl semantische als auch lexikalische Suchsysteme unabhängig voneinander funktionieren hast, besteht der nächste Schritt darin, ihre Ergebnisse zusammenzuführen. Dieser hybride Ansatz gibt dir das semantische Verständnis von Embeddings kombiniert mit der Präzision von Schlüsselwort-Matching und schafft so eine robustere Sucherfahrung für deine RAG-Pipeline.