我們建立的混合檢索方法運作良好,但仍有一些粗糙之處。當我們搜尋「工程團隊對 INC-2023-Q4-011 做了什麼?」時,我們會預期軟體工程(Software Engineering)部分應該排名更高,因為它特別提到了工程團隊和該事件。然而,網路安全(Cybersecurity)部分仍然排在第一位。
這就是重新排序(re-ranking)發揮作用的地方——這是一種後處理技術,可以顯著提升檢索準確度。
重新排序如何運作
重新排序在您的混合搜尋流程之後增加了一個額外步驟。您不是只回傳來自向量索引和 BM25 索引的合併結果,而是將這些結果傳遞給 LLM 進行智慧重新排序。
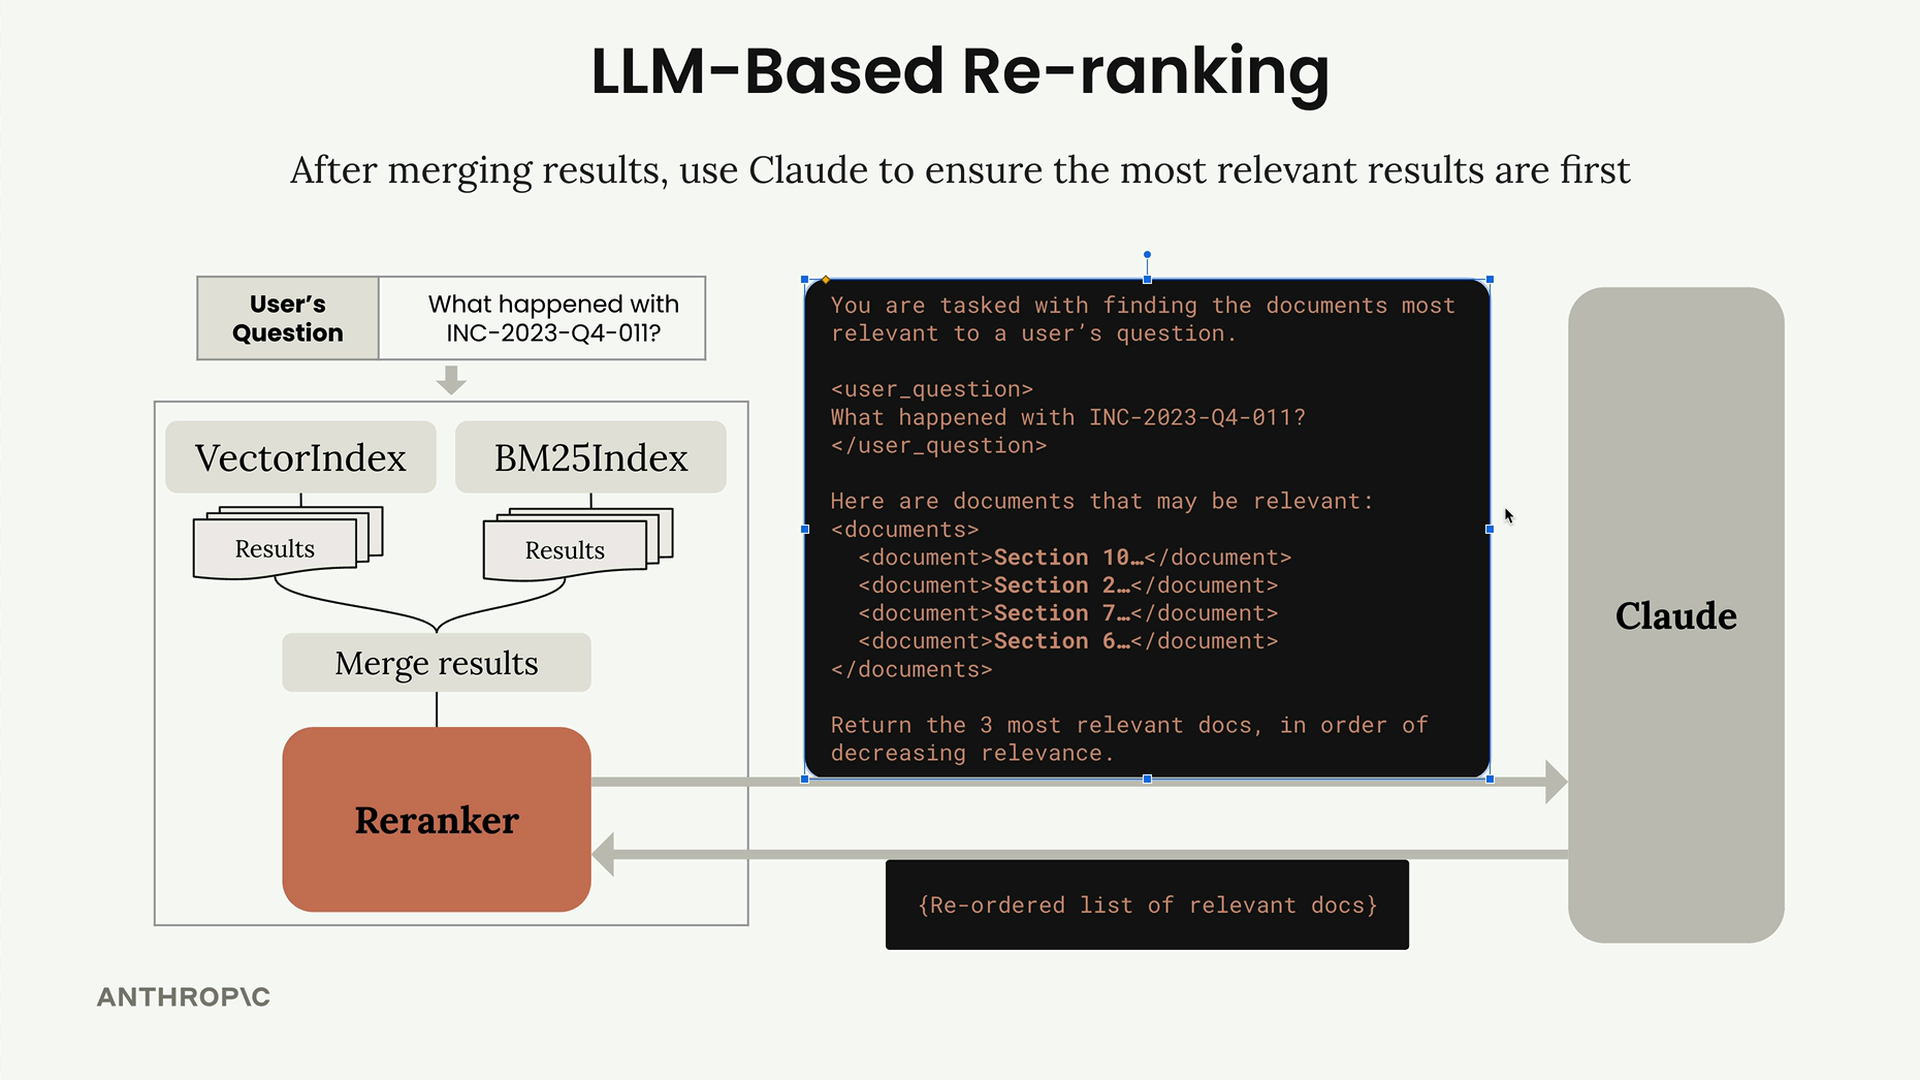
這個流程很直接:
- 執行您現有的混合搜尋(向量 + BM25)
- 如之前一樣合併結果
- 將合併後的結果連同重新排序提示發送給 Claude
- 取回按相關性重新排序的文件清單
重新排序提示
提示結構簡單但有效。您向 Claude 提供使用者的問題以及所有候選文件,然後要求它按相關性遞減的順序回傳最相關的文件。
You are about to be given a set of documents, along with an id of each.
Your task is to select the {k} most relevant documents to answer the user's question.

Here is the user's question:
<question>
{query_text}
</question>

Here are the documents to select from:
<documents>
{joined_docs}
</documents>

Respond in the following format:
```json
\{
  "document_ids": str[] # List document ids, \{k\} elements long, sorted in order of decreasing relevance
\}
```效率考量
一個關鍵的優化是使用文件 ID,而不是要求 Claude 回傳完整的文字區塊。如果您要求 Claude 回傳每個相關文件的完整文字,您會浪費時間等待它複製大量文字。
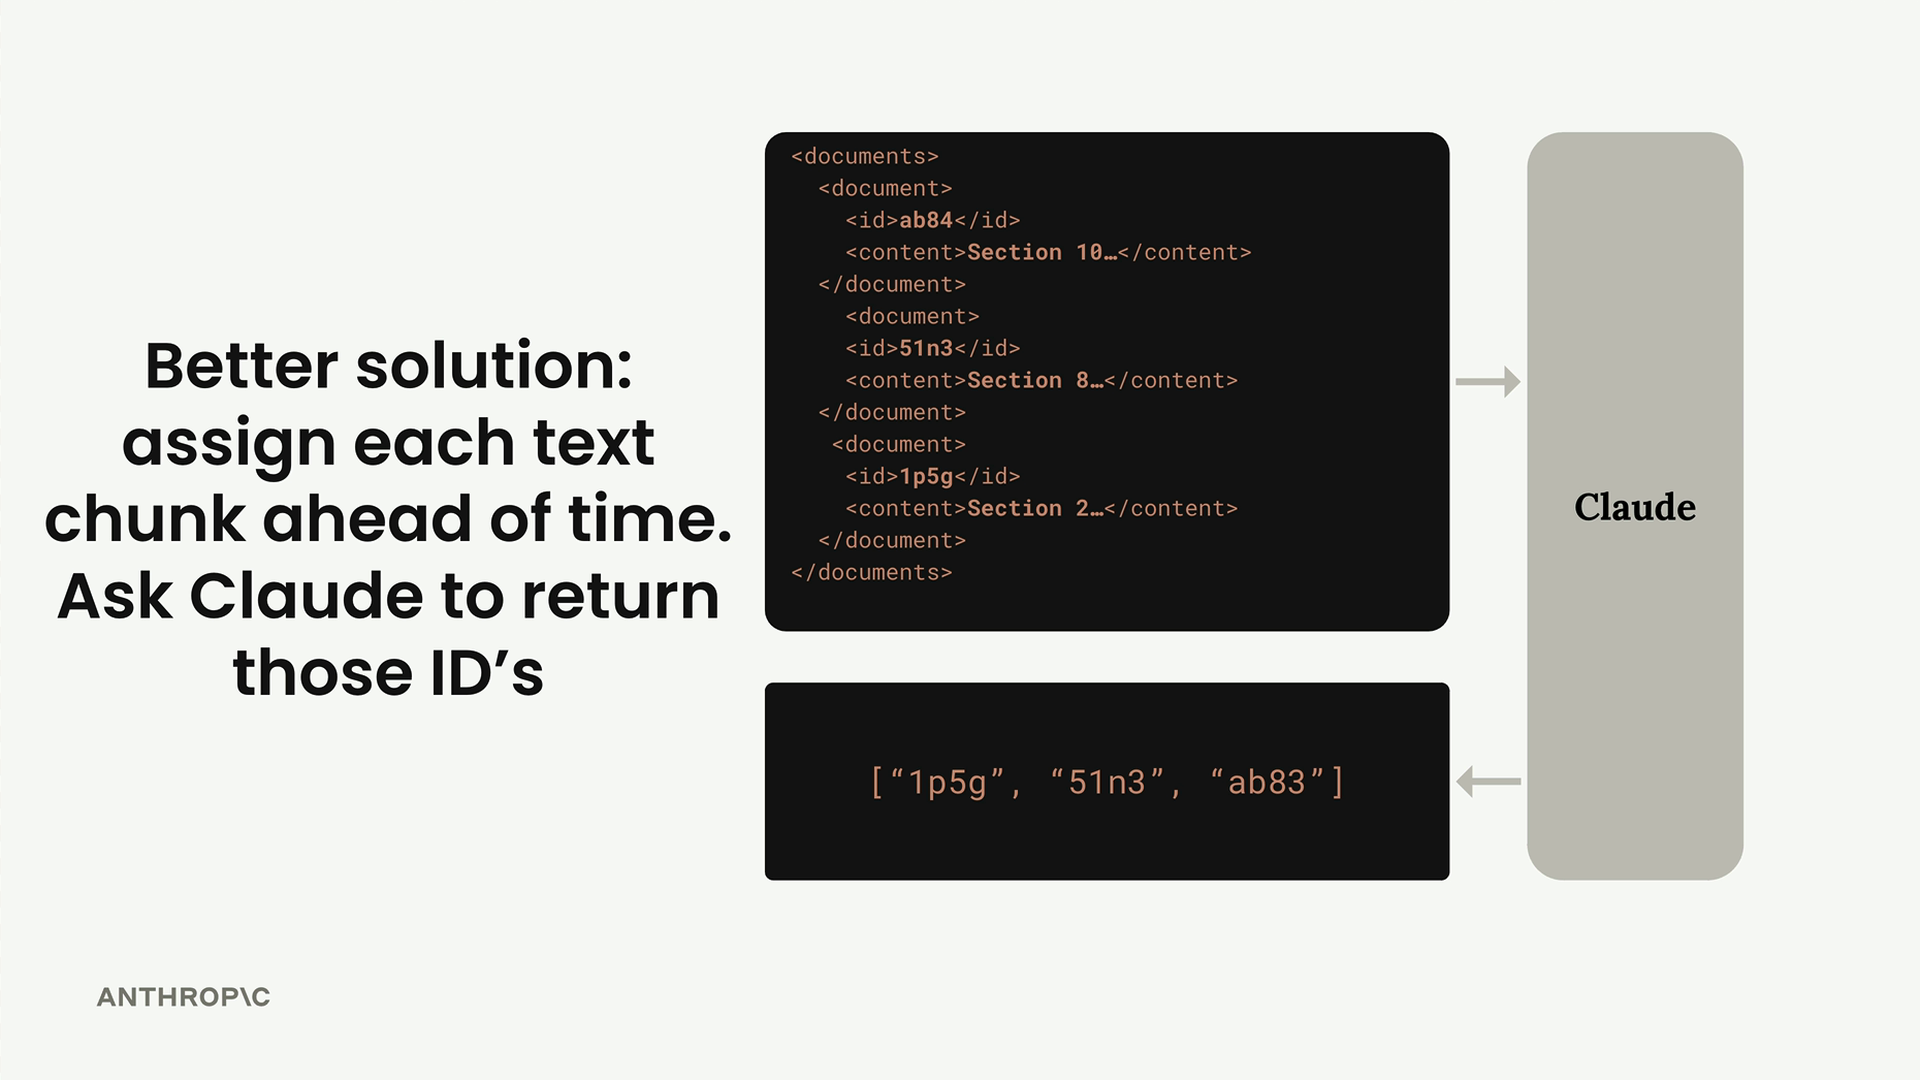
相反地,事先為每個文字區塊指定一個唯一的 ID,然後要求 Claude 只按偏好順序回傳這些 ID。這使得重新排序流程快得多,同時仍能提供您所需的重新排序結果。
實作
重新排序器函式會在您的初始混合搜尋完成後自動被呼叫。以下是基本結構:
def reranker_fn(docs, query_text, k):
    joined_docs = "\n".join([
        f"""
        <document>
        <document_id>{doc["id"]}</document_id>
        <document_content>{doc["content"]}</document_content>
        </document>
        """
        for doc in docs
    ])

    # 使用使用者問題與文件建立提示
    # 以 JSON 回應格式傳送給 Claude
    # 解析並回傳重新排序後的文件 ID
您可以透過將重新排序器函式作為參數傳遞,將其整合到您的檢索器中:
retriever = Retriever(bm25_index, vector_index, reranker_fn=reranker_fn)結果
重新排序方法顯示出明顯的改善。在測試查詢「工程團隊對 INC-2023-Q4-011 做了什麼?」時,軟體工程部分現在正確地排在第一位,領先於網路安全部分。Claude 成功識別出使用者特別詢問的是工程團隊對該事件的參與情況。
權衡
重新排序伴隨著需要考慮的權衡:
- 延遲增加: 您現在需要等待額外的 LLM 呼叫完成
- 準確度提升: LLM 能比純粹的相似度分數更好地理解上下文和意圖
- 成本考量: 每次搜尋現在都需要一次 LLM API 呼叫
對於許多應用程式而言,準確度的提升足以證明額外延遲和成本的合理性,特別是當精確檢索對您的使用案例至關重要時。